论文精读笔记:Breaking the 3D Dataset Bottleneck
1. 核心判断
- 论文:CVF Open Access
- 项目、代码与数据:GenOmni3D
- 核心判断:论文把 dataset creation 本身视为 3D perception 的研究问题,重点不是提出一个新 pose head,而是用生成式 pipeline 同时解决资产收集、canonical alignment、pose annotation 和下游验证。
2. 一句话定位
从类别文本开始,经过图像生成、深度条件 3D 重建、canonical alignment 和 mixed-reality rendering,批量得到可训练类别级 6D pose / grasping / completion 的数据生态。
2.1 论文图表导读
| 图表 | 精读问题 |
|---|
| Figure 1 | depth condition 如何从生成阶段注入 alignment? |
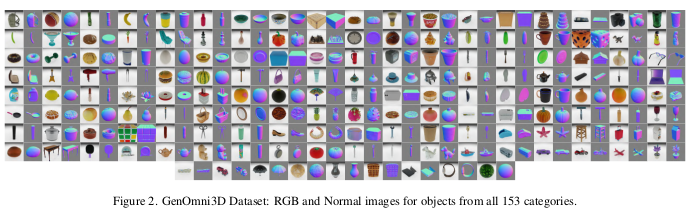
| Figure 2 | 153 类 mesh 的形状与纹理多样性是否足够? |
| Table 1 | 与 ShapeNet、GSO、Objaverse 等数据源相比,规模、质量、时间如何平衡? |
| Table 3 / 4 | 不同资产生成与纹理方式对 pose consistency 的影响是什么? |
| Table 6 / 7 | aligned mesh 是否真正提升 shape completion 与抓取,而不只是 dataset 规模变大? |
 原论文图表中的相关区域:pipeline 通过类别几何 prompt、text-to-image generation 和 depth-conditioned generation 生成 canonical 对齐的 3D assets。来源:项目页 / CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与数据目标
- 类别级 6D pose 需要同一类别实例在共享 canonical frame 下对齐;仅有大量 mesh 不等于可用于 NOCS / pose 学习。
- 论文针对三个瓶颈:资产收集慢、mesh alignment 难、真实 pose annotation 难。
- 目标是从文本类别出发,输出 mesh、normal / texture、canonical transform、RGB-D render 和 6D annotations,并且能用于机器人 grasping。
4. 研究脉络
- ShapeNet 等合成数据规模大但真实感和类别覆盖有限;GSO、OmniObject3D 等扫描数据质量高但采集成本高。
- Objaverse 规模极大,却存在 mesh 质量不一致和类别 coverage 稀疏问题。
- 生成式 3D 工作通常关注单物体质量,未必提供类别级 canonical alignment 和完整 pose annotations。
- 本文把 text-to-image-to-3D、depth-conditioned alignment 与 mixed reality rendering 组合成任务级数据生产管线。
5. 方法详解
5.1 Category prompt 到 aligned mesh
- geometry prompt 描述类别、结构、部件和视角要求。
- text-to-image 生成多样外观的 reference images,再从图像重建 / 生成 3D mesh。
- depth-conditioned generation 通过 canonical depth / normal 约束生成视图保持统一 orientation,得到约 96% pose consistency。
- 每个物体在少于 3 分钟内生成,强调 production throughput。
5.2 大规模 6D pose data
- 资产在混合现实场景中渲染,随机相机、背景、遮挡和物体 arrangement。
- 同步输出 RGB、depth、mask、NOCS / pose 等完整标注。
- 153 个类别每类超过 1000 个实例,得到约 153K aligned meshes;GenOmni6D 提供约 1.2M images。
5.3 下游验证
- 训练类别级 pose estimator,测试 NOCS REAL275 的 zero-shot sim2real transfer。
- 在 SAPIEN 中创建 grasping scenes,比较通用模型、类别专用模型和生成资产的 grasp / shape completion。
- 通过真实物体和真实机器人执行,验证对齐 mesh 的物理可用性。
6. 实验分析
6.1 生成质量与规模
- 96% pose consistency 高于先前约 57% 的对齐率,说明 depth condition 对类别 pose 数据非常关键。
- 单物体少于 3 分钟,相比传统 15–60 分钟扫描实现 5–20 倍提速。
- 发布 153K meshes、1.2M images,显著提高每类实例数量,降低 inter-class transfer 的必要性。
6.2 Pose / completion / grasping
- zero-shot sim2real 在 NOCS benchmark 上具有竞争力,说明生成资产可以支持类别级 pose 学习。
- shape completion 的 IoU 为 0.475,对比 CenterGrasp 的 0.314,说明 aligned shape 与 texture / geometry 多样性对补全有实际帮助。
- grasp success 达约 87.8%;在 36 个真实物体上,类别专用模型比单一通用模型更能利用生成数据。
6.3 需要谨慎解读
- 生成数据的性能提升既来自 alignment,也来自实例数量、场景增强和类别专用训练,不能把所有收益归因给单一模块。
- NOCS 和 grasping 的真实结果要结合 mesh quality、real texture 和 collision setup 阅读。
7. 批判性分析
- 贡献:把数据生产速度、对齐一致性和下游任务效果放入同一评价闭环。
- 风险:生成 3D 的拓扑错误、薄结构缺失、非物理材质和 canonical 偏差可能被大规模复制。
- 规模陷阱:153K mesh 并不自动保证长尾类别覆盖;prompt 分布和生成器 bias 仍需审计。
- 机器人边界:87.8% grasping 依赖特定夹爪、场景和物体集合,跨机器人与复杂接触仍需评测。
8. 对我的研究的启发
- 训练 6D pose foundation model 时,canonical consistency 比单纯增加 mesh 数量更重要。
- 可以将生成资产的 pose consistency、mesh quality 和 uncertainty 作为数据筛选信号。
- 为新类别快速生成 aligned assets,可用于主动 curriculum:先生成高辨识度几何,再加入外观和遮挡变化。
9. 待解决问题
- 如何检测并修复生成 mesh 的 topology / scale / canonical errors?
- 如何把真实扫描、生成 mesh 和机器人触觉反馈混合,形成闭环数据质量评估?
- 如何为非刚性、可动和透明物体生成统一的 6D / articulation annotations?
11. 精读补充:数据生成的每个环节与下游收益
11.1 GenOmni3D pipeline
论文不是简单调用 text-to-3D,而是把类别级 pose 所需的 canonical alignment 当成生成目标:类别 / geometry prompt → text-to-image 外观 → 3D mesh → depth-conditioned alignment → texture variation → mixed-reality render。depth-conditioned generation 用来约束实例之间的朝向和结构,最终再自动生成 RGB-D、NOCS / pose 与机器人抓取数据。
11.2 规模与质量数字
| 指标 | 论文报告 |
|---|
| 类别 | 153 |
| 每类资产 | >1,000 |
| aligned meshes | 约 153,000 |
| 下游 pose 图像 | 约 1.2M |
| pose consistency | 约 96%(此前工作约 57%) |
| 单物体生成时间 | <3 min |
| 相对传统扫描 | 约 5–20× 更快 |
| grasp success | 87.8% |
| shape completion IoU | 0.475 vs CenterGrasp 0.314 |
这些指标应分为三类:资产规模、canonical 质量、下游性能。规模大不等于对齐好;对齐好也不等于真实抓取好。论文将三者放在同一闭环,是它比单纯发布 mesh collection 更有价值的地方。
11.3 下游结果如何解读
- NOCS / category-level pose:aligned mesh 提供类别共享坐标和大量外观变化,验证 sim-to-real transfer;需要同时检查 pose consistency 是否是性能提升的真正来源。
- shape completion:Custom-CG-tex-val-tex 的 IoU 为 0.475,CenterGrasp 为 0.314;这说明完整 mesh 和 texture variation 对形状理解有帮助,但不代表所有薄结构都正确。
- grasping:36 个 unique objects 的 real-world / SAPIEN 评测达到 87.8% success;应注明夹爪、碰撞模型、物体集合和动作策略,避免把它宣传成通用机器人成功率。
11.4 作者声称与我的分析
| 作者声称 | 我的判断 |
|---|
| 从 scratch 快速生成大规模 aligned 3D assets | 153 类、153K mesh、<3 min/object 支持规模与速度。 |
| depth conditioning 改善 canonical consistency | 96% vs 57% 的 pose consistency 直接支撑;仍需按类别、薄件和对称物体拆分。 |
| 资产能提升 pose / completion / grasp | 0.475 IoU 与 87.8% grasp 是下游证据,但生成数据量、材质增强和对齐质量共同贡献。 |
12. 数据质量与复现清单
每个资产应检查 mesh watertightness、scale、up-axis、canonical frame、薄结构、材质物理合理性和 texture leakage。训练时同时保存 pose consistency、render silhouette、depth residual 与下游 success;若生成 mesh 有 systematic canonical bias,应在数据进入 pose trainer 前筛掉。对于 articulated / transparent object,当前 text-to-image-to-3D 仍需新的结构表示与物理校验。
