Reading Notes
粗读 / 精读
已生成 src/paper-notes/capellm-iccv2025/coarse.md
论文粗读笔记
用于快速判断论文定位、问题设定、核心方法、实验结论和是否值得精读。
论文粗读笔记:CapeLLM: Support-Free Category-Agnostic Pose Estimation with Multimodal Large Language Models
1. 基本信息
- 年份 / 会议:2025 / ICCV;阅读模式:粗读。
- 任务:category-agnostic keypoint pose / correspondence,不是 BOP-style object 6D pose。
- 原文:ICCV Open Access;代码:GitHub。
2. 一句话定位
CapeLLM 用 query image 和“目标关键点的文本描述”代替带标注的 support images,把类别无关关键点位置转成 MLLM 的坐标 token generation,并用动态轮次训练改善空间推理。
2.1 论文图表导读
| 图表 | 看点 |
|---|---|
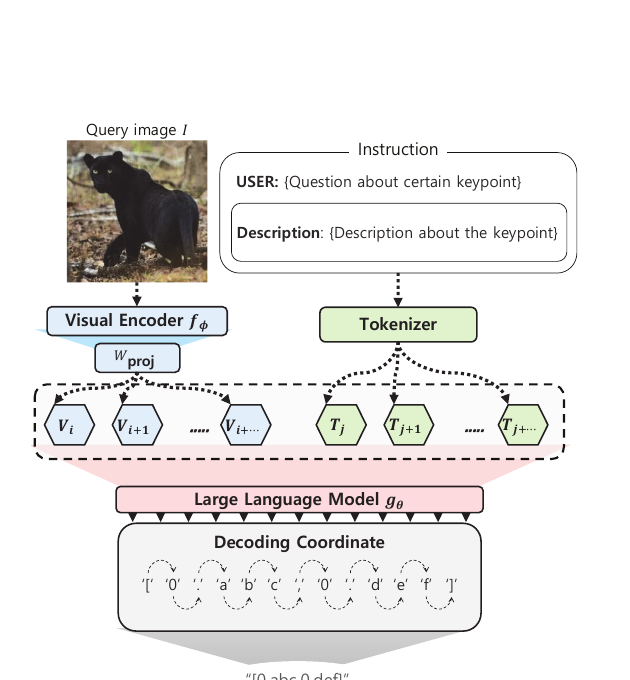
| Figure 2 | DINOv2 visual tokens 与 text instruction 进入 LLaMA decoder、最后生成坐标字符串的方式。 |
3. 方法概览
- DINOv2 visual encoder 抽取 image tokens;keypoint name、描述和问题被 tokenize 后与视觉 token 拼接输入 LLaMA3.1。
- decoder 以文本形式生成量化坐标;训练设计包含 instruction、dynamic round 和对未见 keypoint 的 inference refinement。
- 输出是 2D keypoint pose;它可成为后续几何 pose 的前端,但论文没有完成 CAD/PnP 6D pose 闭环。
4. 实验概览
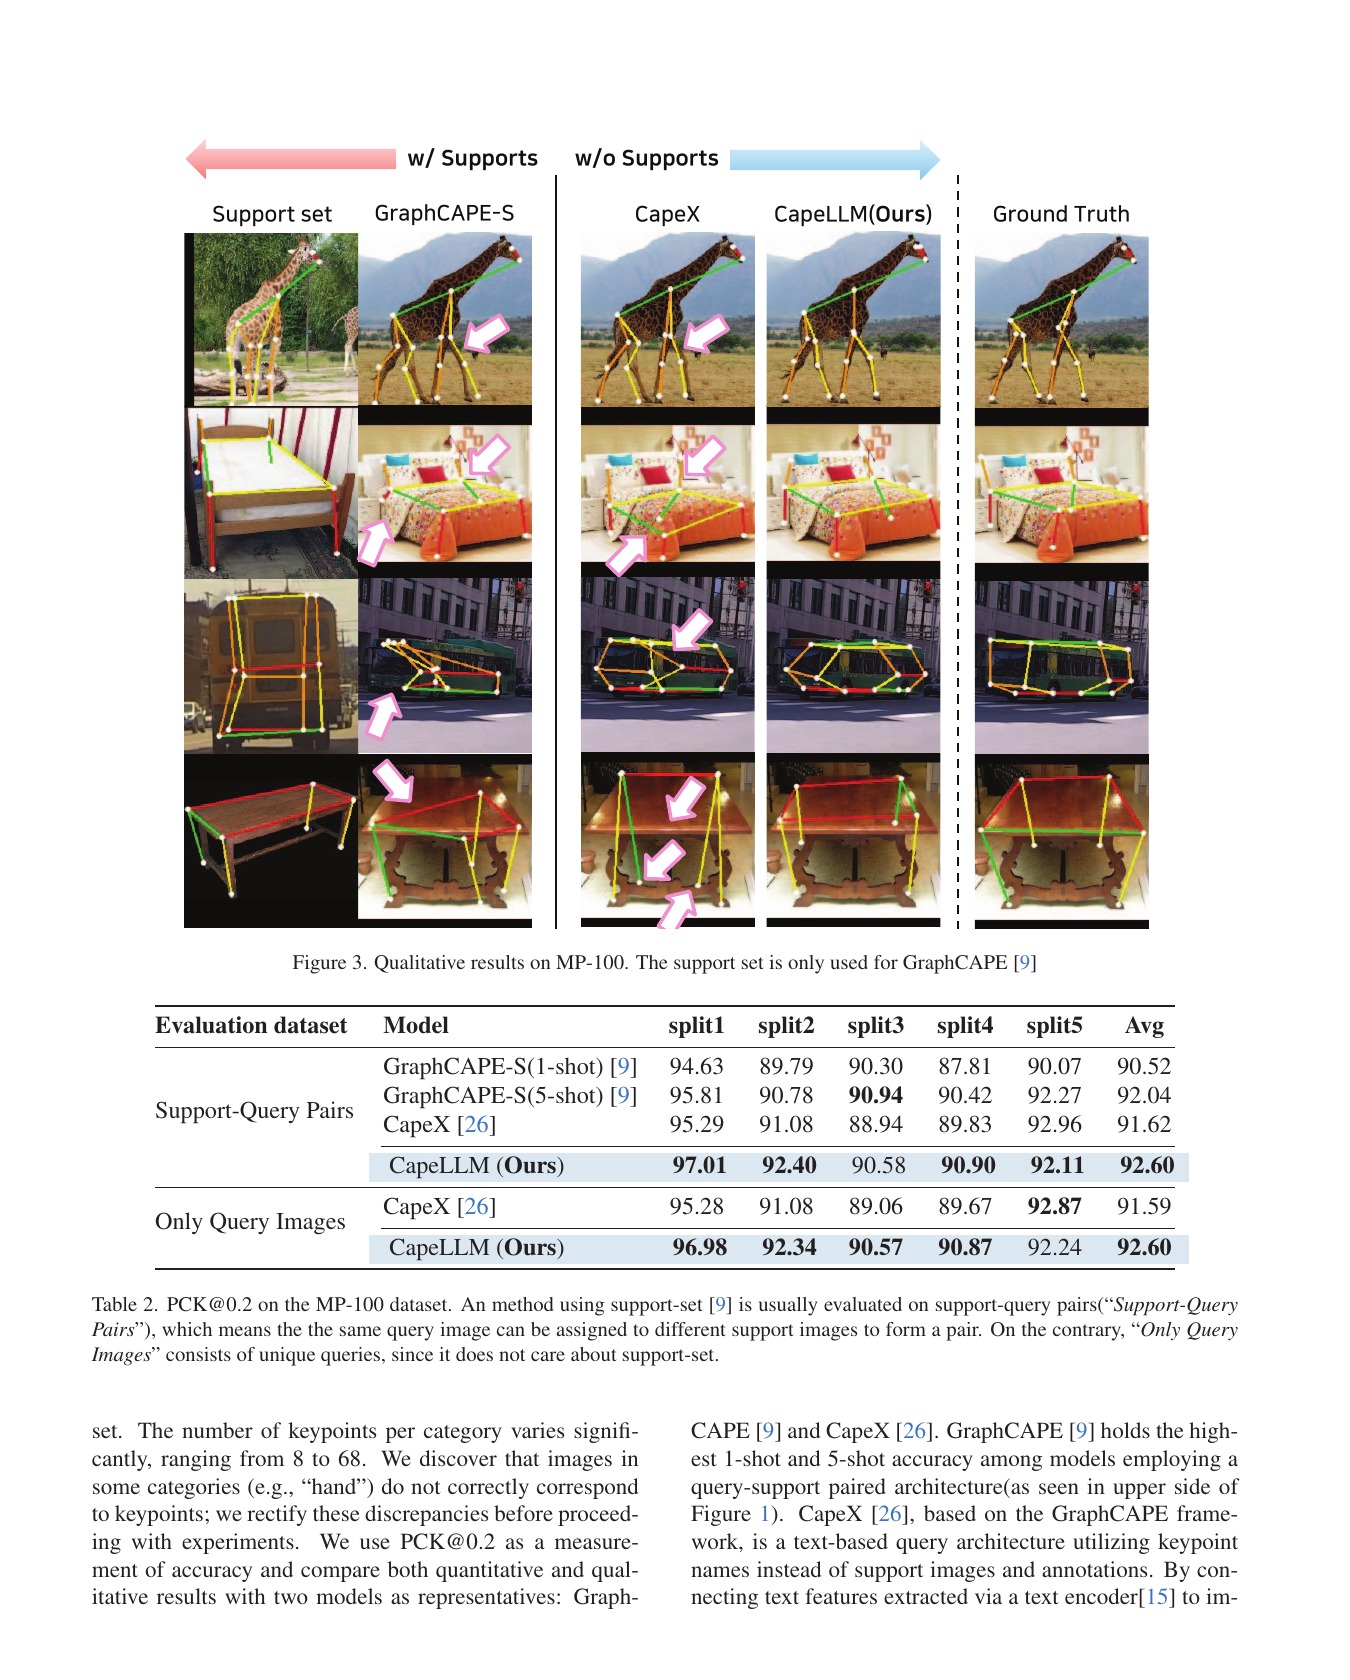
- 数据集:MP-100;用 PCK@0.2 等关键点定位指标比较 1-shot / 5-shot CAPE。
- 作者声称:在 1-shot 甚至 5-shot setting 超过此前 CAPE 方法,同时不需 support images。
- 我的分析:语言描述降低了 support 标注成本,但 description quality、语言歧义、极细粒度部位和遮挡下的 grounding 仍是关键风险。
5. 优缺点与启发
- 优点:清楚地区分“target keypoint 的语义”与“support image 中的示例”,探索开放词汇的 pose entry point。
- 风险:不等同于 6D rigid pose;输出坐标 string 的量化和 LLM hallucination 会限制精度。
- 启发:可将 language 作为 pose pipeline 中对象/关键点 specification,而不是只作为检测 prompt。