
Reading Notes
粗读 / 精读
已生成 src/paper-notes/cipe-icra2025/coarse.md
论文粗读笔记
用于快速判断论文定位、问题设定、核心方法、实验结论和是否值得精读。
论文粗读笔记:A Unified End-to-End Network for Category-Level and Instance-Level Object Pose Estimation from RGB Images
1. 基本信息
- 简称:CIPE
- 作者:Jiale Ren、Hong Liu、Jinfu Liu、Peifeng Jiang
- 会议 / 年份:IEEE ICRA 2025
- 机构:Peking University
- 论文:DOI
- 项目:GitHub(当前仅占位 README,暂无代码)
- 任务:从单张 RGB 统一做 category-level 与 instance-level 6DoF pose
- 公开性:正文非开放获取;作者摘要公开,仓库尚未实质开源
2. 一句话总结
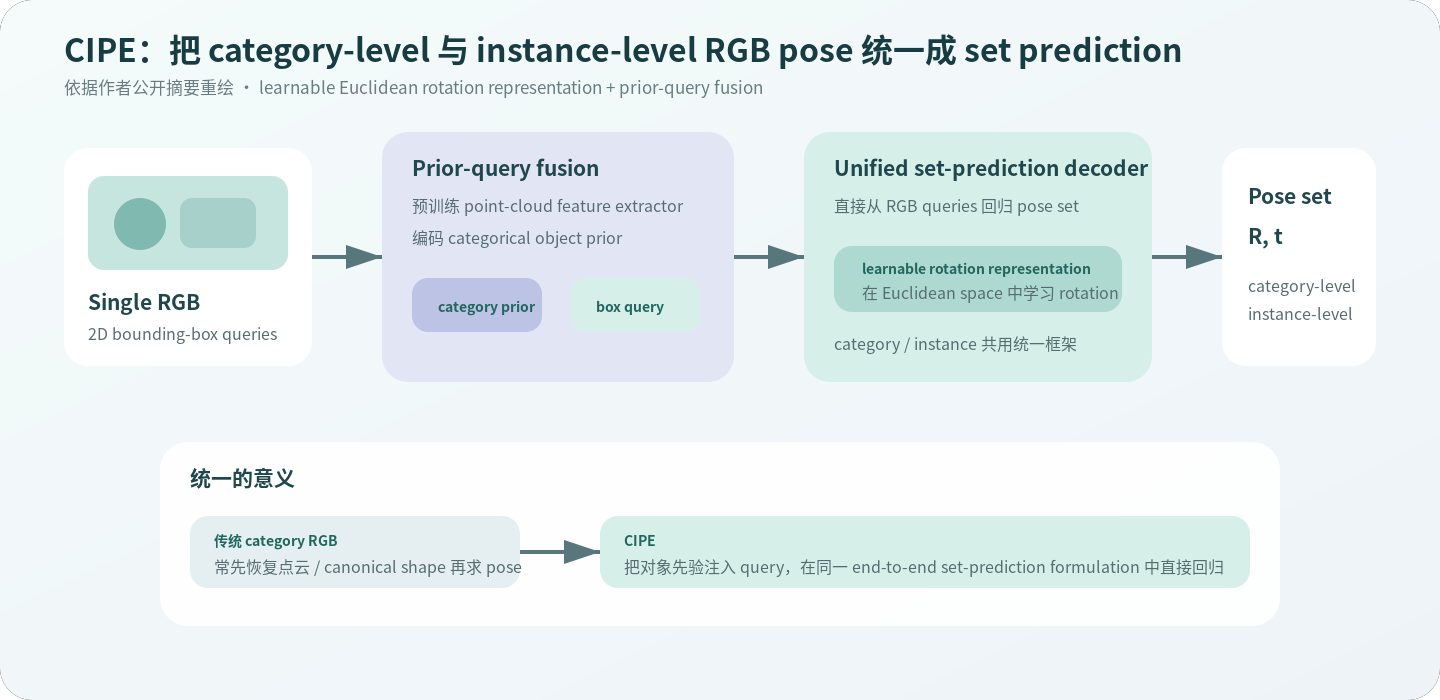
CIPE 把类别级与实例级 RGB pose 都建模为 set prediction,直接回归对象 pose;它引入可在 Euclidean space 学习的 rotation representation,并用 prior-query fusion 将预训练 point-cloud category feature 注入 bounding-box query,减少传统类别级 RGB 方法“先重建点云、再求 pose”的分段流程。
3. 方法主线
- 单张 RGB 与 2D bounding-box queries;
- 预训练 point-cloud extractor 编码 category prior;
- prior-query fusion 将类别几何注入 query;
- unified set decoder 直接输出 category / instance pose;
- learnable rotation representation 缓解 直接回归困难。
4. 结果与开源状态
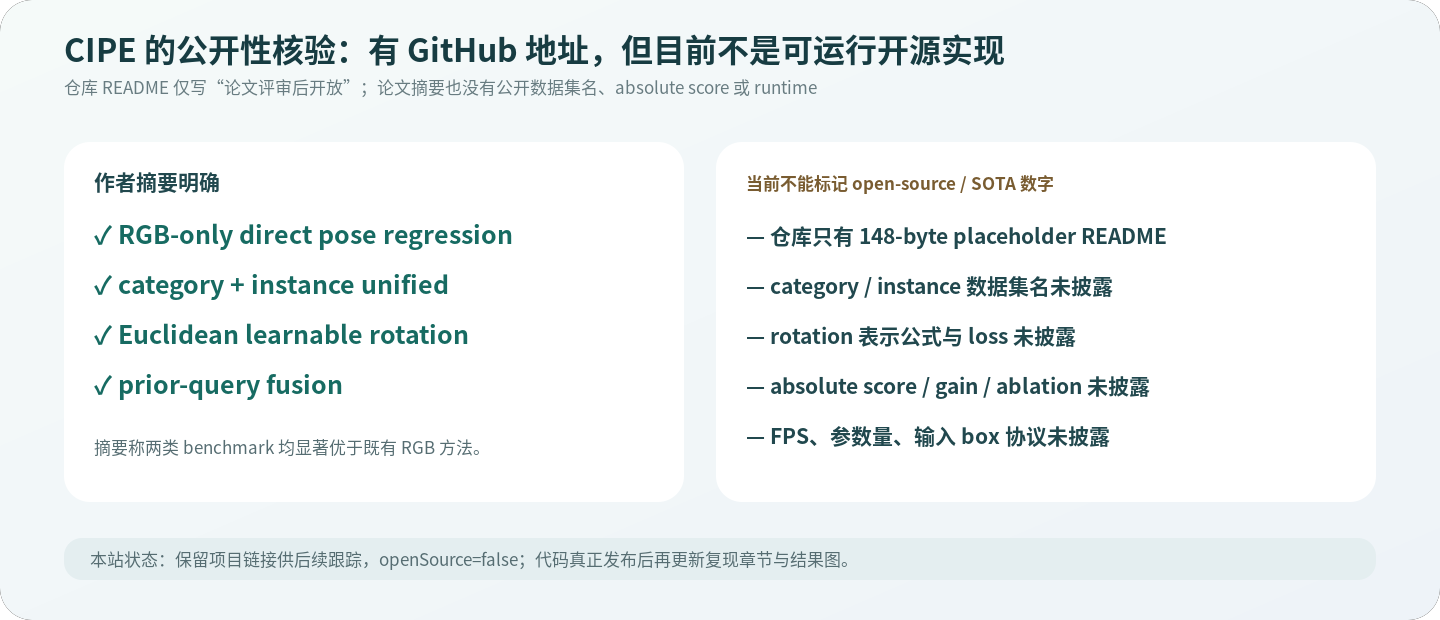
摘要称 CIPE 在 category-level 与 instance-level datasets 上显著优于已有 RGB methods,但没有数据集名、绝对分数或提升量。
公开 GitHub 只有 148-byte README,内容为代码将在论文评审后开放。到本站核验时仍没有实现,因此 metadata 保持 openSource: false。
5. 粗读评价
统一两种 task 的想法有价值:instance-level 依赖对象身份,category-level 依赖类别形状分布,但二者都可视为“query → pose set”。prior-query fusion 让 category branch 获得几何先验,learnable rotation 则针对共同的旋转优化问题。
局限是证据不足:无法确认类别 / 实例 benchmark、对称处理、rotation representation 的连续性、输入是否用 GT boxes、runtime 和代码。当前适合做趋势条目,不适合据此复现或排榜。