论文精读笔记:EgoGaussian: Dynamic Scene Understanding from Egocentric Video with 3D Gaussian Splatting
1. 基本信息
2. 一句话定位
EgoGaussian 用“静态片段初始化 + 动态片段在线更新”的方式,在第一视角 RGB 视频中显式维护背景 Gaussian、可刚体运动的对象 Gaussian 和逐帧对象 pose。它把人的手和身体主要当作需要屏蔽的遮挡源,而不是要共同重建的形体。
2.1 论文图表导读
| 图表 | 内容 | 阅读重点 |
|---|
| Figure 1 | 从 egocentric video 到 background / object / trajectory | 预处理、静态初始化、动态估计是三个有外部依赖的阶段 |
| Figure 2 | 按时间顺序的 dynamic-object modeling | 目标 pose 由上一帧对象状态递推,且随机回访历史帧进行正则 |
| Table 1 | HOI4D、EPIC 的静态 / 动态渲染结果 | 评价对手/身体区域做 mask,不等同于完整场景的 6D pose accuracy |
| Table 2–3 | 大时间步长与全场景 fine-tuning 消融 | 测试 sequential model 的鲁棒性与背景–对象联动必要性 |
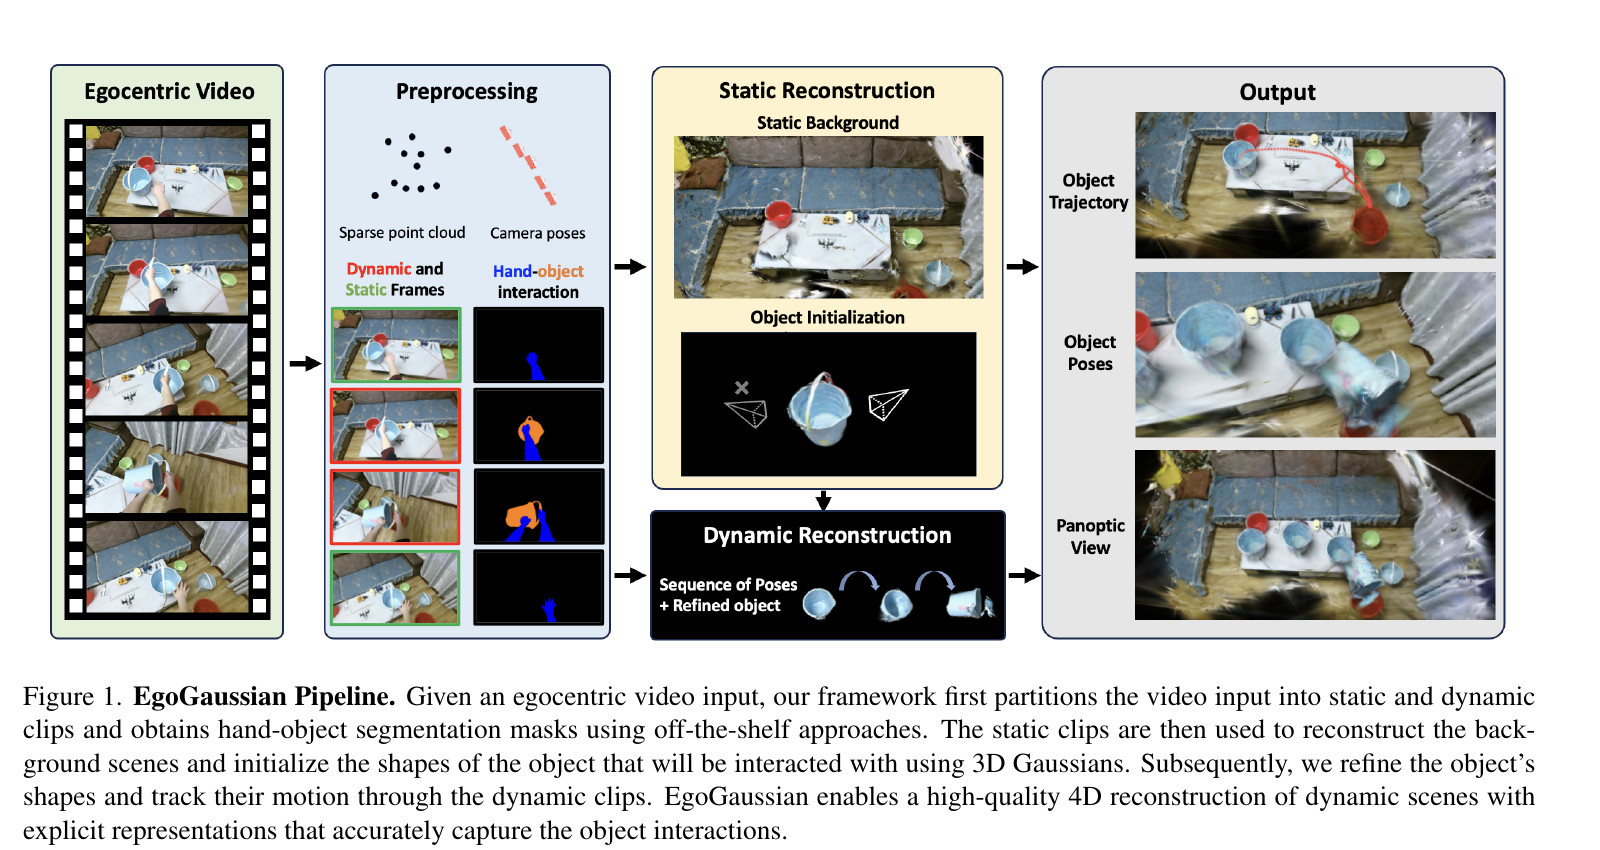 原论文 Figure 1:静态 / 动态片段划分、3D Gaussian 初始化与对象运动输出。来源:arXiv PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
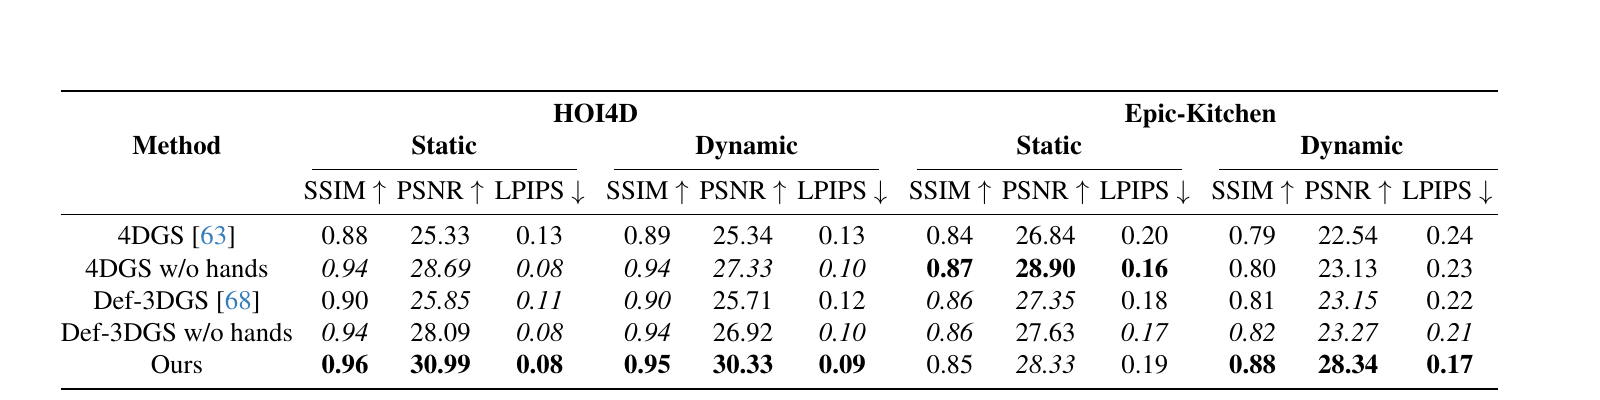 原论文 Table 1:与 4DGS、Deformable 3DGS 的 PSNR / SSIM / LPIPS 对比,分别报告静态与动态帧。来源:arXiv PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与边界
- 输入:第一视角单目 RGB video;预处理还使用相机位姿(COLMAP 或数据集提供)、手–物 / 人体 mask,以及交互 onset / offset。
- 输出:背景 Gbg、对象 Gobj、每帧刚体对象 transform 和可自由视角渲染的动态场景。
- 对象假设:被操作对象在 dynamic clip 内近似刚体;人手和人体通过 mask 不参与 photometric gradient。
- 任务边界:论文的主要 benchmark 是 novel-view reconstruction,object pose 的正确性由可渲染的一致性间接支持;未报告 ADD、rotation error 或 translation error。
4. 动机:为何先找静态片段
第一视角交互里,目标通常被手遮挡、快速运动,单帧很难给出完整物体几何。EgoGaussian 先利用“物体尚未被拿起 / 已放下”的片段建立可见对象 Gaussian 和背景;之后才让动态阶段在较好的对象形状上追踪 rigid motion。
这与直接训练 deformable 4D representation 的差别是:它保持对象形状和姿态的显式可分性。我的分析是,这个设计让 object trajectory 可读、可编辑,但也把最难的问题移到 preprocessing:静态片段、mask 和 camera pose 的错误会使后续获得一个一致但偏移的轨迹。
5. 方法详解
5.1 预处理与静态重建
- 用交互 onset / offset 把视频划为 static clips 与 dynamic clips;静态片段中物体不动,人的身体可动。
- 用 EgoHOS 生成手 mask,Track-Anything 生成对象与人体 mask;论文将 mask 做 2-pixel dilation 以增加遮挡边界鲁棒性。
- 采用 COLMAP 估计相机位姿与 sparse points;若数据集提供相机 pose(如 EPIC Fields),则直接使用。
- 在静态片段训练 3DGS。人体 mask 区域不提供颜色梯度,随后以可训练的 label 将 Gaussian 分为 object / background。
这里的“object initialization”并不是给一帧 2D detection 回归 6D pose,而是获得一组具有对象身份的 3D Gaussians;这正是后面可做刚体 transform 的基础。
5.2 动态阶段:pose 与形状按帧递推
对 dynamic frame ft,论文从邻近的已优化对象 Gaussian Gobj,t−k 出发,估计相对平移 tt 与 6D rotation representation R~t,把整组 Gaussian 的位置、旋转和协方差作同一刚体变换。随后用 object RGB crop 与 alpha mask 的渲染损失优化。
为避免只过拟合当前帧,每次训练以 0.5 概率改用随机历史帧作 regularization;并对由对象移动揭露的背景区域再次训练 Gbg。这形成一个关键闭环:对象在动,不仅更新 object pose,也提供重新观测背景的机会。
| 模块 | 输入 | 输出 | 主要作用 |
|---|
| static reconstruction | 静态帧、camera pose、mask | Gbg、初始 Gobj | 建立可追踪对象的几何 / 外观起点 |
| object pose estimation | 前一状态、当前 object crop | Rt,tt | 预测当前刚体运动 |
| object shape refinement | 当前 RGB / alpha | 更新的 Gobj | 纠正局部几何与可见性 |
| static scene update | 动态帧中揭露的区域 | 更新的 Gbg | 补齐此前被对象遮挡的背景 |
6. 实验分析
6.1 数据与评价口径
- HOI4D:论文使用 4 段约 20 秒视频,480×270、15 fps。
- EPIC-KITCHENS:4 段约 10.43 秒片段,平均 455×256、60 fps。
- 训练时采用隔帧采样;对比 4DGS、Deformable 3DGS 以及去掉手部区域梯度的对应版本。
- 指标为 PSNR↑、SSIM↑、LPIPS↓;作者明确 mask out actor hands / body,减少人体模型差异对 object / scene comparison 的影响。
6.2 Table 1 的核心结论
| 数据 | 帧类型 | EgoGaussian (SSIM / PSNR / LPIPS) | 论文中的主要对照 |
|---|
| HOI4D | static | 0.96 / 30.99 / 0.08 | 4DGS 0.88 / 25.33 / 0.13;Def-3DGS 0.90 / 25.85 / 0.11 |
| HOI4D | dynamic | 0.95 / 30.33 / 0.09 | 4DGS 0.89 / 25.34 / 0.13 |
| EPIC | static | 0.85 / 28.33 / 0.19 | 4DGS w/o hands 0.87 / 28.90 / 0.16 较高 |
| EPIC | dynamic | 0.88 / 28.34 / 0.17 | 4DGS 0.79 / 22.54 / 0.24 |
作者的主要证据是:动态片段下,显式对象 pose / Gaussian 分离比泛化的 deformation field 更能保留交互对象。需要同时看到 EPIC static 的例外:EgoGaussian 并非在所有列都最佳,说明它的强项集中在动态建模与遮挡下的对象状态,而不是对所有静态视图都占优。
6.3 消融如何读
- 较大的 pose estimation time gap 可减少训练量,但 object PSNR 会下降;作者用 Table 2 表明系统仍能产生可用重建,但这不是“对快运动无损”的证据。
- 不进行 full-scene fine-tuning 会显著下降,说明 background 与 object 虽被拆分,训练中仍必须重新耦合。
- 这些消融支持 pipeline 的必要性;但没有直接评测 camera pose 误差、mask corruption 和 onset/offset 标注误差,现实上游噪声仍是主要空白。
7. 局限、失败模式与复现条件
- 依赖预处理:onset / offset、object mask、hand/body mask、camera pose 都不是方法内部从零得到;误差会以隐性先验形式进入所有实验。
- 可观测性:大幅运动、出画再入画、弱纹理和物体长期完全遮挡时,RGB gradient 不能稳定约束 pose。
- 对象假设:整组 Gaussian 使用同一刚体 transform,软物、关节物、可开合物体会违反模型。
- 资源:按帧 sequential optimization 与 densification/pruning 属于离线重建工作流,不能按此结果推断实时 AR / 机器人可用性。
8. 对 object pose 研究的启发
- 若可得到对象的可信显式表示,pose tracking 可转化为“rendered object 与观测的一致性”问题。
- 交互中的人体信息至少应被分为两类:需要屏蔽的遮挡,和可作为 contact / motion prior 的信号;EgoGaussian只处理前者,InterTrack 则尝试利用后者。
- 后续值得补上直接的 6D pose metric、前端 mask / camera pose 扰动实验,以及 uncertainty-aware 的丢帧 / 重初始化策略。
