论文精读笔记:6-DoF Object Tracking with Event-based Optical Flow and Frames
1. 核心判断
论文解决的是一个明确的传感器失配问题:高速对象会让普通相机产生 motion blur,并在相邻帧之间形成过大的 pose jump;事件相机不等待完整曝光,因此更适合提供高频运动观测,但事件本身又缺少稳定外观,不适合直接承担已知物体的全局 6D pose recognition。
作者的分工是:
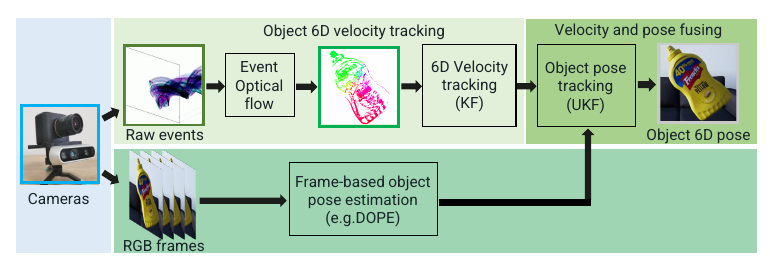
事件流负责局部速度 :逐事件 optical flow → 6D object velocity;RGB 帧负责全局锚点 :DOPE 以 5 Hz 给 absolute 6D pose;深度负责 2D–3D 连接 :interaction matrix 用 pixel depth 把 6D velocity 投影到 2D flow;两个滤波器负责时序融合 :KF 跟踪 velocity,quaternion UKF 跟踪 pose。
因此,方法真正的新意不是“从事件直接预测 6D pose”,而是把先前 1-DoF 事件生成模型替换为信息量更高的 2-DoF optical-flow residual,并将其嵌入经典状态估计框架。
2. 系统输入与边界
原论文 Figure 1。图中虽然主要画出 event camera 与 RGB frames,但方法章节明确输入同步 depth images;深度被 interaction matrix 用于 6D velocity measurement。来源:作者公开稿 ;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
完整输入是:
RGB frames { I i } \{I_i\} { I i }
synchronized depth images { D i } \{D_i\} { D i }
high-temporal-resolution event stream { E q } \{E_q\} { E q }
已标定的相机内参和 event / RGB-D 外参;
已知对象及其 DOPE estimator;可视化也使用 object mesh。
论文没有把前景 event segmentation / object ROI 的产生方式完整写成独立模块。事件流中哪些观测属于目标对象会直接影响速度估计,在多物体、相机自运动和背景边缘较强时尤其关键;现有实验主要是单对象受控轨迹,尚未覆盖这一层难度。
3. 逐事件 optical flow
假设小图像区域内短时间运动近似匀速。三个相邻事件
e i = ( x i , t i ) , e j = ( x j , t j ) , e k = ( x k , t k ) e_i=(x_i,t_i),\quad e_j=(x_j,t_j),\quad e_k=(x_k,t_k) e i = ( x i , t i ) , e j = ( x j , t j ) , e k = ( x k , t k ) 若满足
x j − x i t j − t i ≈ x k − x j t k − t j + ξ , \frac{x_j-x_i}{t_j-t_i}
\approx
\frac{x_k-x_j}{t_k-t_j+\xi}, t j − t i x j − x i ≈ t k − t j + ξ x k − x j , 就为事件 e i e_i e i
F ( x i ) = x k − x i t k − t i . F(x_i)=\frac{x_k-x_i}{t_k-t_i}. F ( x i ) = t k − t i x k − x i . 单个事件可能找到多组三元组,错误匹配会直接污染后续 6D velocity。作者将图像划为小 RoI,在区域内候选集合 M M M M i M_i M i
F ⋆ = arg min F ′ ∈ M ∑ i = 1 n min F i c ′ ∈ M i ∥ F ′ − F i c ′ ∥ . F^\star
=
\arg\min_{F'\in M}
\sum_{i=1}^{n}
\min_{F_{ic}'\in M_i}
\left\lVert F'-F_{ic}'\right\rVert. F ⋆ = arg F ′ ∈ M min i = 1 ∑ n F i c ′ ∈ M i min ∥ F ′ − F i c ′ ∥ . 这近似一个 medoid 式稳健聚合:不会平均多个互相冲突的 flow,而是选择对所有事件候选都相对一致的已有向量。它计算轻量,但局部匀速、足够 event density 和正确 RoI 仍是隐含条件。
4. 为什么 2-DoF 观测比 1-DoF 更适合对象
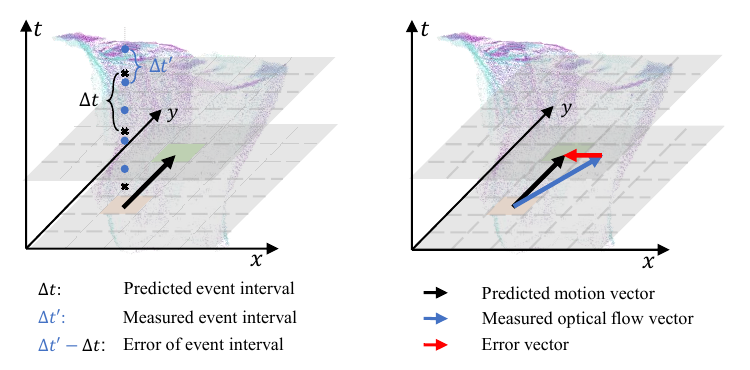
原论文 Figure 2:先前方法只比较同一 pixel 的事件时间间隔;本文直接比较二维 measured / predicted motion vector,同时观察方向和幅度。来源:作者公开稿 ;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
先前 Hybrid Object Tracking with Events and Frames 使用 brightness-change timing 的 1-DoF residual。对于全画面 camera motion,大量事件可提供足够约束;但 object motion 只占局部区域,还伴随 self-occlusion,沿多轴同时运动时容易出现 observability 不足。
本文的 measured flow F ( u , v ) F(u,v) F ( u , v ) Ours (GE) 就是先前 1D generative-event 版本;Ours (OF) 在 fast sequences 上总体更稳,支持“二维观测提高局部对象运动可观性”的论点。
5. 从 2D flow 到 6D velocity
velocity state 定义为
V i = [ v o i , ω i ] , V_i=[v_{o_i},\omega_i], V i = [ v o i , ω i ] , 其中 v o ∈ R 3 v_o\in\mathbb{R}^3 v o ∈ R 3 ω ∈ R 3 \omega\in\mathbb{R}^3 ω ∈ R 3
运动模型采用衰减速度:
V i + 1 = α V i + w , α = 0.5. V_{i+1}=\alpha V_i+w,\qquad \alpha=0.5. V i + 1 = α V i + w , α = 0.5. 事件只在亮度变化时产生;若对象停下,就没有 measurement correction。令 α < 1 \alpha<1 α < 1
对像素 ( u , v ) (u,v) ( u , v )
F ^ ( u , v ) = J ( u , v ) V i Δ T , \hat F(u,v)=J(u,v)V_i\Delta T, F ^ ( u , v ) = J ( u , v ) V i Δ T , 其中 J = [ J v o J ω ] J=[J_{v_o}\ J_\omega] J = [ J v o J ω ]
f x d , f y d , u − c x d , v − c y d . \frac{f_x}{d},\quad
\frac{f_y}{d},\quad
\frac{u-c_x}{d},\quad
\frac{v-c_y}{d}. d f x , d f y , d u − c x , d v − c y . 这里的 d d d
6. Normal-flow constraint 与 measurement weighting
事件经常来自物体边缘。局部只有一条边时,aperture problem 使测得 flow 主要约束边缘法向分量,而切向分量不可观。作者不直接令 F − F ^ F-\hat F F − F ^
r k = F k ⋅ F ^ k ∥ F k ∥ ∥ F ^ k ∥ F k − F ^ k . r_k=
\frac{F_k\cdot\hat F_k}
{\lVert F_k\rVert\lVert\hat F_k\rVert}
F_k-\hat F_k. r k = ∥ F k ∥ ∥ F ^ k ∥ F k ⋅ F ^ k F k − F ^ k . 这使不完整的 normal-flow measurement 仍可约束与其可观方向一致的预测量。
随后对 residual 集合按其偏离中位数 M M M
L k = max ( 1 2 b exp [ − ∣ r k − M ∣ b ] , 10 − 6 ) . L_k=
\max\left(
\frac{1}{2b}
\exp\left[-\frac{|r_k-M|}{b}\right],
10^{-6}
\right). L k = max ( 2 b 1 exp [ − b ∣ r k − M ∣ ] , 1 0 − 6 ) . 它相当于让远离 residual median 的事件 flow 少参与更新。Table III 显示:
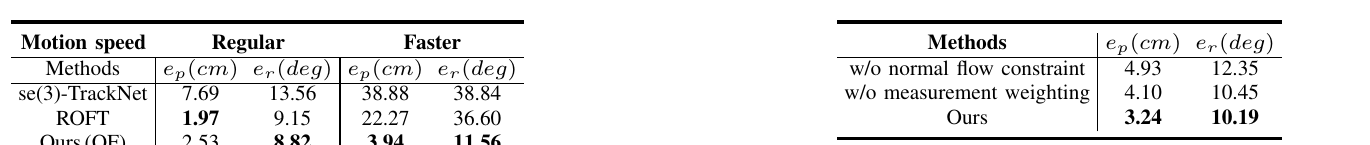
版本 平移 RMSE cm ↓ 旋转 RMSE ° ↓ w/o normal-flow constraint 4.93 12.35 w/o measurement weighting 4.10 10.45 完整模型 3.24 10.19
normal-flow constraint 对平移与旋转都更关键;weighting 的平移收益明显,旋转只小幅改善。论文没有报告网格大小、事件窗口、Laplacian b b b
7. KF 与 quaternion UKF
第一层标准 Kalman filter 以 decaying velocity model 做 prediction,以累积的 event optical flow residual 做 correction,输出高频 V i V_i V i
第二层 pose state 为
x i = [ t i , q i ] T , x_i=[t_i,q_i]^T, x i = [ t i , q i ] T , 其中 q i q_i q i V i V_i V i T i T_i T i p ( T i ) p(T_i) p ( T i ) q ( T i ) q(T_i) q ( T i )
作者将 DOPE 人为限制为 5 Hz,模拟低功耗 / 小型 GPU;论文提到高端 GPU 上 DOPE 可运行到 30 Hz,但没有给出本系统所在硬件、真实事件吞吐量、滤波更新频率或 5 Hz 条件下的端到端能耗。
8. 数据生成与指标
合成实验使用 Unreal Engine 与四个 YCB 对象:
003 cracker box;
005 tomato soup can;
006 mustard bottle;
010 potted meat can。
每个对象分别生成 regular 与 faster 随机 6DoF trajectory。RGB 首先以 500 FPS 生成并送入 event-camera model;再在固定时间窗内平均为 60 FPS,以主动制造 motion blur。模拟器直接提供 object pose 和 6D velocity ground truth。
位置误差是相对 GT translation 的 Euclidean RMSE,旋转误差是 se(3) rotation-vector degree RMSE。这里不是 BOP ADD(-S) / AR,也没有跨对象 symmetry-aware surface metric。
真实系统由 calibrated RealSense D415 与事件相机组成,二者均为 640×480;RealSense 为 60 FPS,事件相机异步输出。人工尽可能快速移动 cracker box 和 mustard bottle。真实序列没有 pose ground truth,只能检查 CAD render 与图像的视觉重叠。
9. 主结果
原论文 Table II / III。常速下本文并非所有指标最优;优势集中在 faster motion,符合它针对 motion blur 与大帧间运动的设计目标。来源:作者公开稿 ;表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
四对象平均结果:
方法 Regular 平移 cm ↓ Regular 旋转 ° ↓ Faster 平移 cm ↓ Faster 旋转 ° ↓ se(3)-TrackNet 7.69 13.56 38.88 38.84 ROFT 1.97 9.15 22.27 36.60 Ours (OF) 2.53 8.82 3.94 11.56
正确解读是:
regular motion 下,ROFT 的平均 translation 更好,本文 rotation 略好;
faster motion 下,两个 frame-based baseline 大幅退化,本文只从 2.53 / 8.82 增至 3.94 / 11.56;
se(3)-TrackNet 在部分单序列常速条件非常准,但高速样本可完全失效;
ROFT 与本文共享 5 Hz DOPE,差异更能反映 frame optical flow 与 event optical flow 在模糊条件下的稳定性。
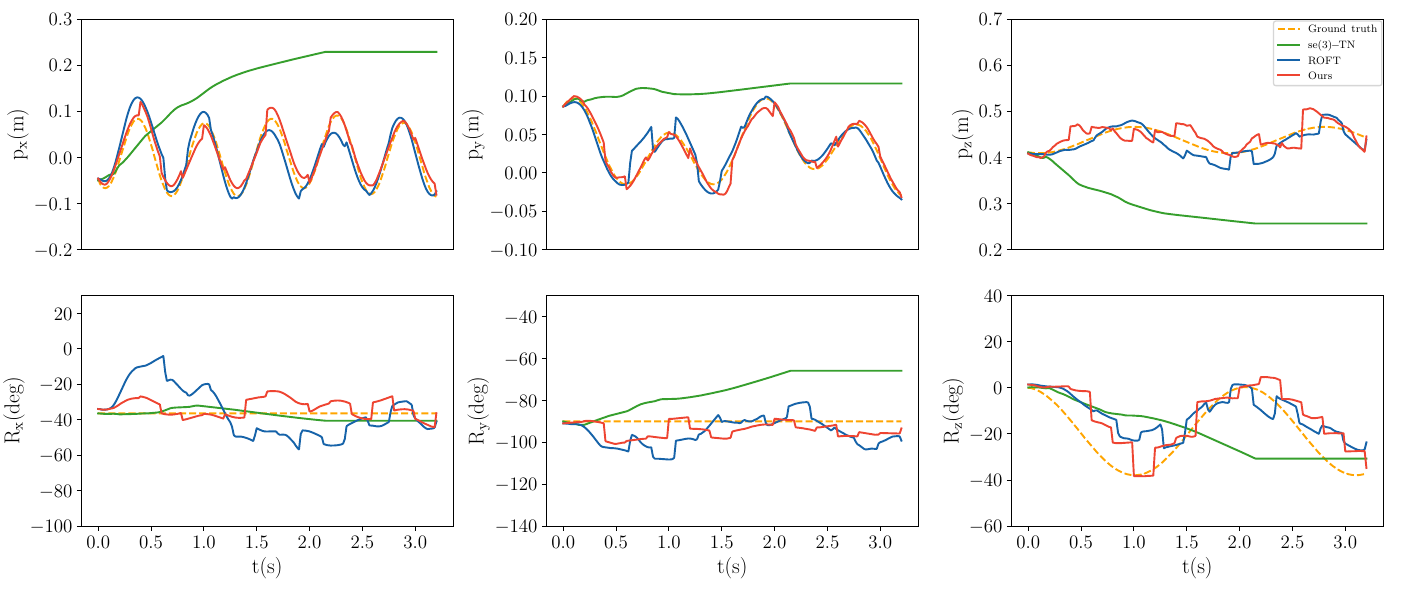
原论文 Figure 6:005 faster trajectory 的三个平移与三个旋转分量。se(3)-TrackNet 多个轴出现持续漂移,ROFT 有较大阶跃;本文轨迹总体更接近虚线 GT,但旋转仍存在误差。来源:作者公开稿 ;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
10. 真实实验能证明什么
真实序列观察到:
se(3)-TrackNet 在部分高速位移 / 旋转中失败且难以恢复;
ROFT 可借助周期性 global pose 恢复,但 motion blur 下叠加误差明显;
本文在平移片段的 CAD overlay 更贴近目标;
旋转片段的误差仍明显,作者归因于 sparse events 下 rotation 不易观测。
由于没有 GT,这些只能支持“系统在真实传感器上可离线运行”和“视觉上呈现合理趋势”,不能支持厘米 / 角度精度,也不能把合成数据的 Faster 平均值外推到真实机器人场景。
11. 实时性与复现
论文使用“event-by-event”“lightweight”“scalable to real-time”描述事件光流,并把 DOPE 限为 5 Hz,但实验明确是 offline 。作者只表示 optical flow 和 Kalman filters 应能实时运行,未来还要测试 live latency 与 stability。
复现至少需要核对:
event / RGB-D 时钟同步与空间标定;
depth 对 event pixels 的配准、空洞和噪声处理;
object RoI 与前景 event selection;
event triplet 搜索半径、时间容差 ξ \xi ξ
每次 KF correction 累积多少 events;
α = 0.5 \alpha=0.5 α = 0.5 Q v , Q ω , R F Q_v,Q_\omega,R_F Q v , Q ω , R F normal-flow residual 的具体向量实现;
Laplacian 系数 b b b
UKF 的 Q t , Q q , R t , R q Q_t,Q_q,R_t,R_q Q t , Q q , R t , R q
DOPE 5 Hz 调度与输出延迟;
模拟 events、曝光平均和真实相机 contrast threshold 的 domain gap。
截至本站收录时没有找到官方代码 / 数据仓库,且论文没有给足上述所有实现参数,因此复现难度高于“经典滤波结构”给人的第一印象。
12. 局限
依赖同步 RGB-D depth,尚未形成 fully event-based pipeline;
低频 absolute pose 仍依赖已知对象 DOPE;
合成定量只有四个 YCB 对象,场景和运动生成较受控;
真实数据只有两个对象,无 ground truth;
所有实验离线,没有端到端实时测量;
sparse event measurements 下 rotation observability 较弱;
object event segmentation / RoI 获取没有系统分析;
未评估相机自身高速运动、多物体、遮挡、背景事件和跨传感器 misalignment;
未与学习式 event optical flow / event pose 网络做同协议对比;
指标是 pose-vector RMSE,不处理对象对称性。
13. 最终评价
这篇论文最有价值的结论是:对于高速对象跟踪,事件流不必承担完整的全局识别任务;只要把二维运动测量做得可观、稳健,再用低频 frame-based pose 消除积分漂移,就能显著扩大传统 tracker 的速度工作区间。Faster 合成序列从 ROFT 的 22.27 cm / 36.60° 降到 3.94 cm / 11.56°,是相当清楚的机制证据。
但“事件相机带来高速 6D tracking”必须连同三个条件一起陈述:需要同步深度、需要 5 Hz 已知对象 DOPE、真实实验没有定量真值。它更适合作为事件 / 帧 / 深度异步融合的研究原型,而不是已经验证完备的实时事件位姿系统。