论文精读笔记:Learning 6D Object Pose Estimation With Event Cameras Using Synthetic Data and Domain Randomization
1. 核心判断
论文:IEEE RA-L
核心问题:真实 event pose 数据很少,传统 event tracker 依赖初始 pose、清晰模型边缘和手调参数;能否只用普通 CAD / synthetic RGB render 训练一个从单张 event representation 直接初始化 pose 的学习方法?
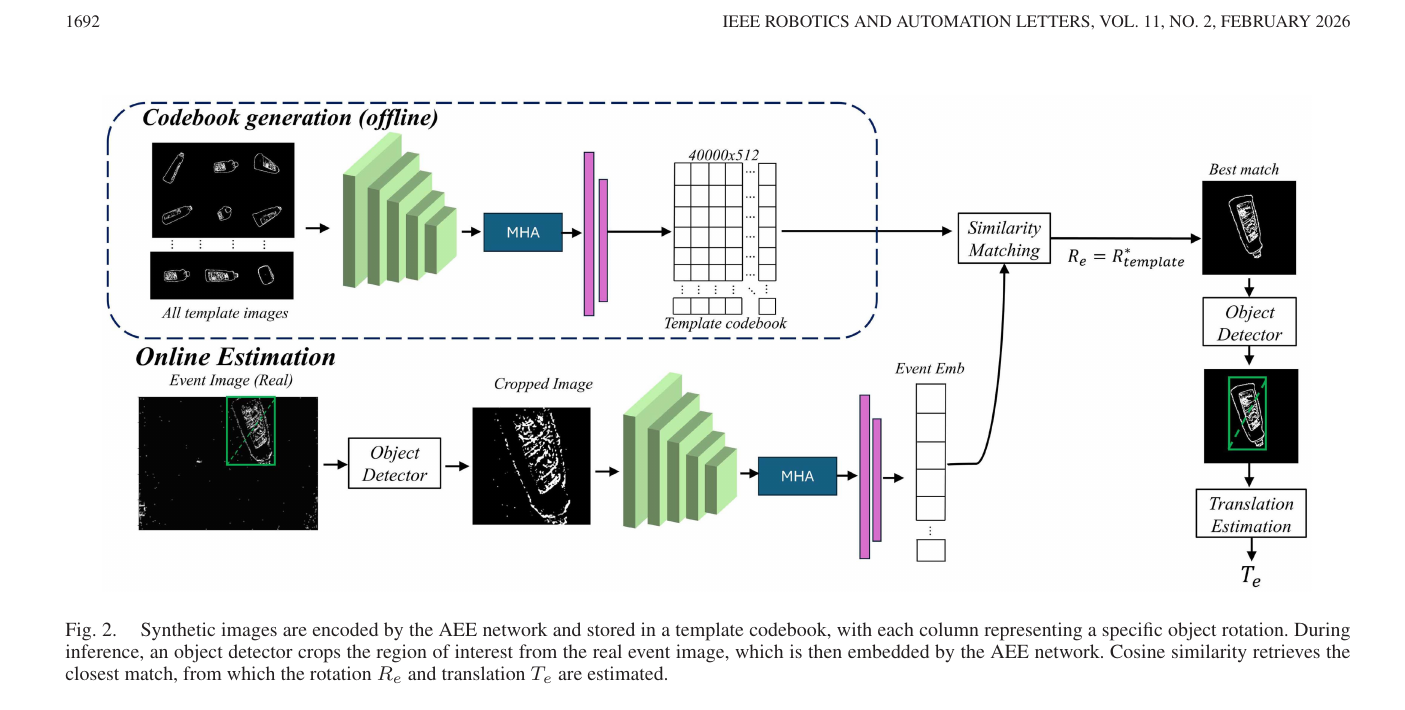
核心回答:将 synthetic RGB 模板随机转换成事件式稀疏边缘,用 augmented autoencoder 学 rotation-discriminative latent;真实事件图只需检索最相似模板,translation 再通过模板 / query 检测框尺度关系恢复。
我的判断:AEE 证明 synthetic-to-event orientation retrieval 可行,特别适合高速运动;但“完整 6D”由两个质量很不对称的模块组成——rotation latent 很强,translation 是对 box 中心和尺度极敏感的解析近似。它更像强 event orientation initializer,而不是已成熟的毫米级 6D estimator。
2. 一句话定位
AEE 用 domain-randomized edge reconstruction 把 40k synthetic rotations 压成 512D codebook,让真实事件帧在约 5 ms 内检索 orientation;translation 则由 bounding-box apparent scale 和相机内参补全。
2.1 图表导读
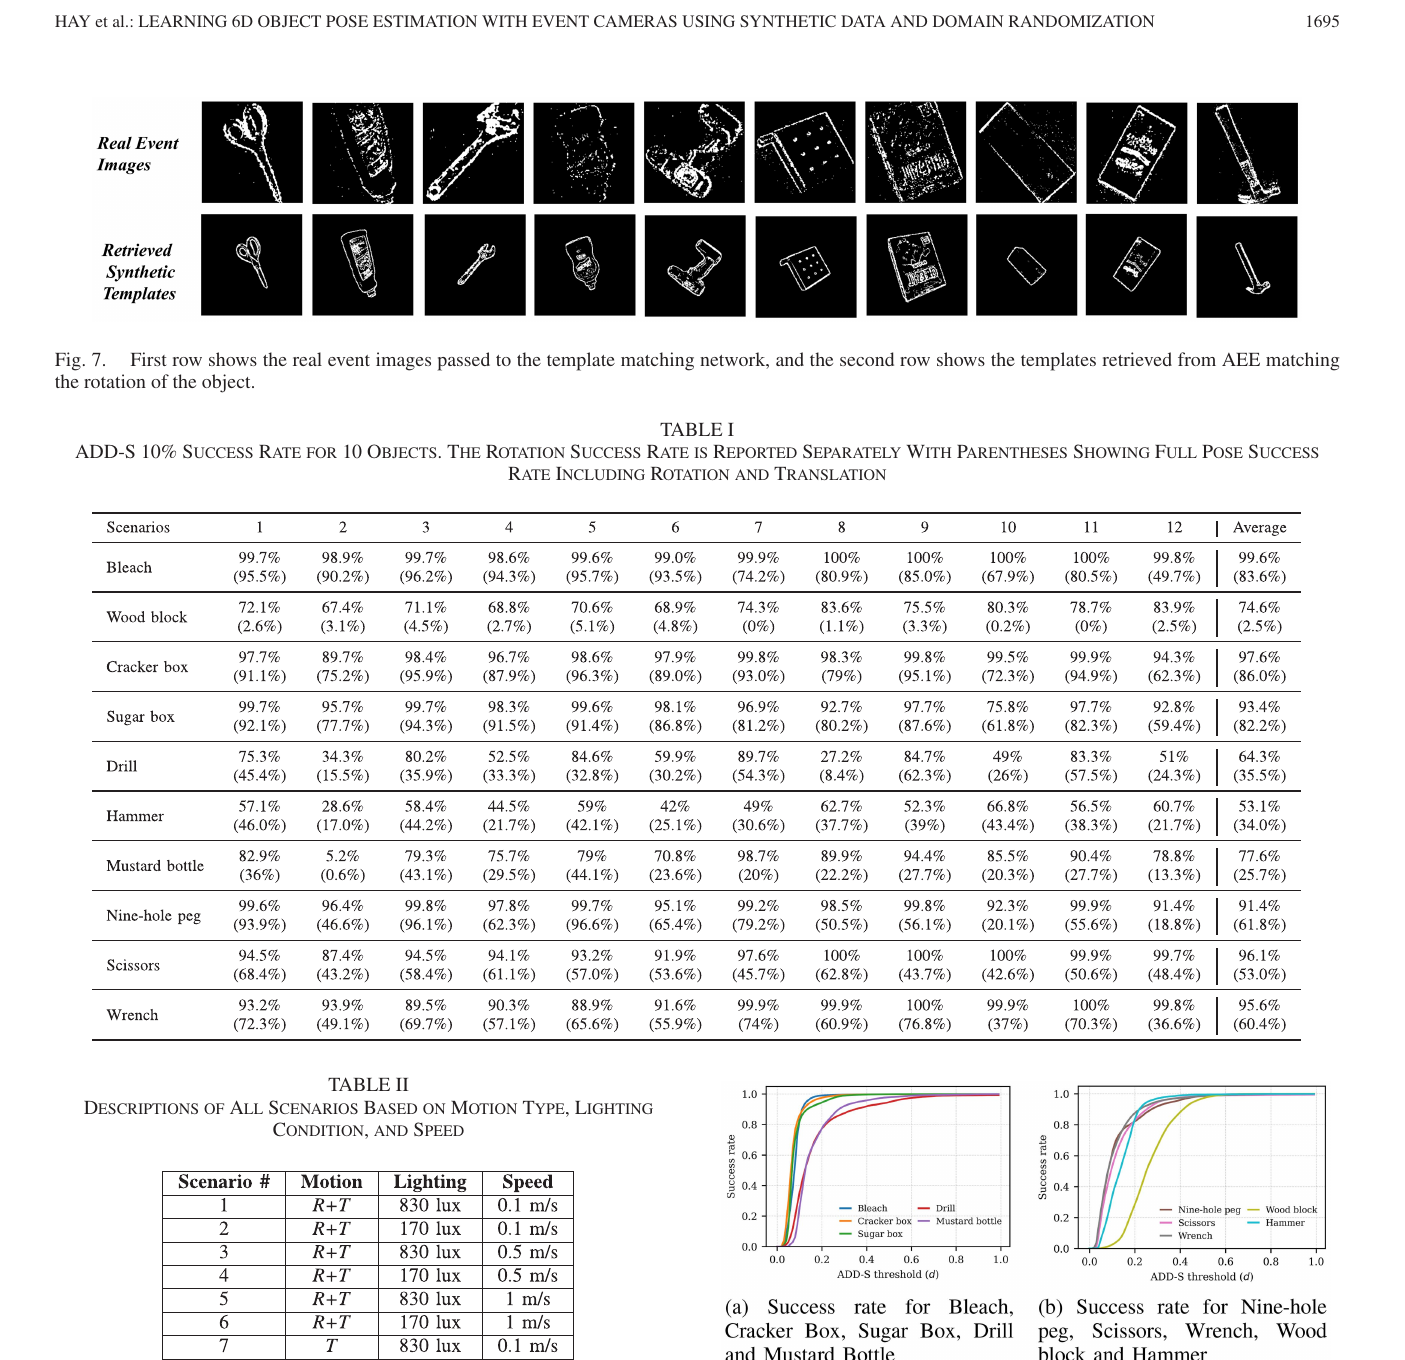
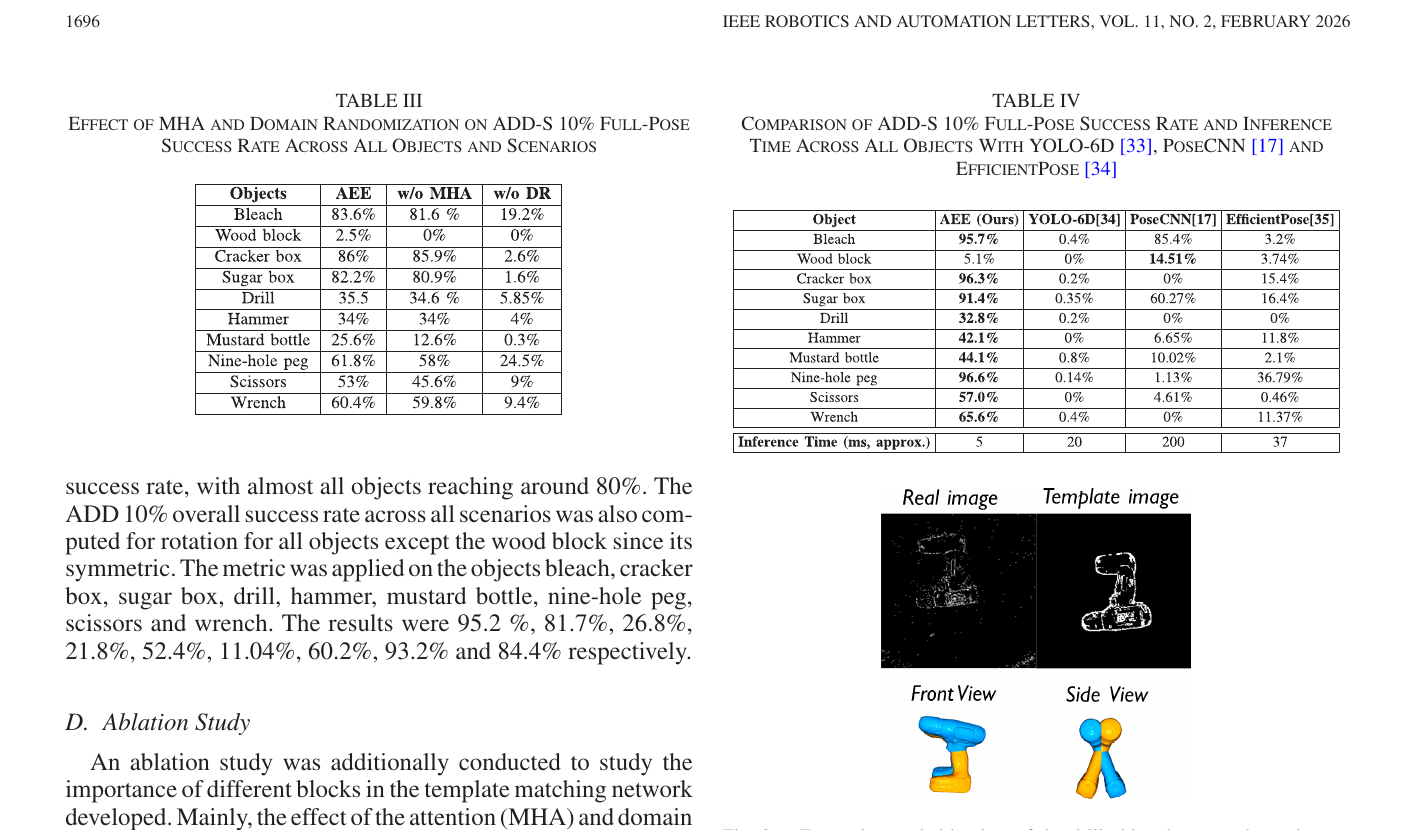
图表 应该看什么 Figure 2–4 RGB template 变成 event-like edge 的方式,以及 codebook / query 是否共享处理。 Table I 外层百分比是 rotation-only、括号是 full pose,二者不能混读。 Table II 12 个场景交替改变运动、光照和速度。 Table III domain randomization 是主要收益,MHA 是次要增益。 Figure 9–10 roll ambiguity 与运动平行边缘缺失,是 event representation 的结构性失败。
原论文 Figure 2–4:40,000 个带 pose synthetic templates 经过边缘化与随机破坏,encoder 输出 codebook;真实 event frame 通过同一 encoder 检索最近 rotation。来源:原论文 。论文采用 CC BY 4.0,图片版权归作者所有,本站仅作学术解读展示。
3. 任务设定
测试对象的 CAD、对象类别和相机内参已知。每个对象离线独立训练网络 / codebook;在线输入是由一定数量 events 累积成的 frame-like binary image,YOLOv11 先检测对象。输出 rotation R R R T T T
这解决的是:
无 pose 初始化 :不像许多 event tracker 需要首帧人工对齐;synthetic-only pose training :不使用真实 event pose 标签训练 AEE;known-instance adaptation :不是一次模型处理任意新 CAD;每个对象需 40k templates 和 200 epochs 训练。
4. Synthetic template 与 domain randomization
4.1 rotation coverage
用 Fibonacci sampling 在上半球取 4,000 个近均匀 viewpoint,每个加 10 个面内 rotation,共 40,000 pose。限制半球是 tabletop 假设,减少 codebook,但不能覆盖任意球面观察。
4.2 从 RGB render 模拟事件外观
真实 event camera 响应 log intensity change,而静态 CAD render 没有时间维。作者没有完整物理仿真连续事件,而采用 appearance randomization:
RGB render 经过 Sobel 得到 edge;
每次随机 threshold,使部分弱边消失;
随机 mask / patch 制造边缘不连续;
叠加 background noise,模拟低 signal-to-noise;
随机 scale / translation,降低对检测框位置和大小的依赖;
目标 reconstruction 是未增强的规范 binary edge template。
这个设计把问题从“精确模拟 event generation”改为“让网络学会从一组可能缺失 / 污染的边缘恢复 pose-specific clean structure”。它便宜、可扩展,但没有显式 polarity 与微秒 timing。
5. Augmented Event Encoder
输入为 256×256 binary image。encoder 有 5 个 convolution layers,之后加入 multi-head attention(MHA),再由两层 linear 得到 512D embedding;decoder 用 5 个 deconvolution layers 重建 clean template,loss 为 MSE。
autoencoder 并不直接监督 quaternion / Euler angle。不同 pose 的 clean edge pattern迫使 latent 保留 orientation;同一 pose 的不同随机破坏被拉到能重建同一模板的区域。训练每对象 200 epochs、batch 32、RTX 3070,学习率 2 × 10 − 4 2\times10^{-4} 2 × 1 0 − 4
训练完成后,所有 clean templates 经 encoder + MHA,embedding 与 rotation 一起存入 codebook。在线 event query 经 YOLO crop / resize 后编码,与 40k vectors 做 cosine similarity,最近模板的 rotation 作为 R e R_e R e
论文称 encoder + retrieval 约 5 ms、接近 200 Hz。这个数字是 network inference / lookup,不应自动视为事件流端到端更新率:event frame 还要积累 5,000 events(500-event sliding window)、YOLO detector 也有成本。
6. Translation 是怎样补出来的
匹配模板有已知深度 t template , z t_{\text{template},z} t template , z f template f_{\text{template}} f template ∥ b b template ∥ \|bb_{\text{template}}\| ∥ b b template ∥ f / z f/z f / z
z ^ event = t template , z ∥ b b template ∥ ∥ b b event ∥ f event f template . \hat z_{\text{event}}
=t_{\text{template},z}
\frac{\|bb_{\text{template}}\|}{\|bb_{\text{event}}\|}
\frac{f_{\text{event}}}{f_{\text{template}}}. z ^ event = t template , z ∥ b b event ∥ ∥ b b template ∥ f template f event . 再用两个框中心经内参反投影的差得到 x , y x,y x , y
检测框紧贴对象,且不同 rotation 下框大小可由匹配模板正确解释;
object center 与 bbox center 的投影关系近似一致;
CAD metric scale 已知;
相机内参准确;
没有严重 crop / occlusion。
因此 detector 1 pixel error 在 346×260、1 m 条件下可对应约 3 mm,几像素就变成厘米级平移误差。论文自己将 rotation-only 与 full-pose 分开,正是为了揭示这一弱点。
7. 数据与评测
E-POSE 中选 10 个对象,构造 12 种 scenario:
motion 包括 rotation + translation 或单 translation;
亮度 830 lux 与 170 lux;
速度 0.1 / 0.5 / 1 m/s。
event representation 每帧累计 5,000 events,滑窗步长 500。评价使用 ADD-S 10% object diameter:
rotation-only :预测 R R R T T T full-pose :预测 R , T R,T R , T
对 wood block 的 symmetry,另行解释 rotation metric;同时还报告不同 d d d
8. 主结果
原论文 Figure 7、Table I–II:每个 Table I 单元格主数值为 rotation-only,括号为包含估计 translation 的 full-pose;两个指标差距是阅读重点。来源:原论文 。论文采用 CC BY 4.0,图片版权归作者所有,本站仅作学术解读展示。
跨 12 场景平均:
对象 rotation-only full pose bleach 99.6 83.6 wood block 74.6 2.5 cracker box 97.6 86.0 sugar box 93.4 82.2 drill 64.3 35.5 hammer 53.1 34.0 mustard bottle 77.6 25.7 nine-hole peg 91.4 61.8 scissors 61.5 53.0 wrench 95.6 60.4
rotation retrieval 对 bleach / cracker / sugar / wrench 很强,说明 distinctive edge shape 在 domain gap 下可保留;wood block、drill、mustard 的 full pose 大幅掉落,主要来自均匀纹理 / 形状、框中心偏差和 translation。
低光 scenario 有轻微下降,作者归因于 SNR;提高运动速度没有系统性恶化,支持 event camera 的高速优势。不过事件帧按 event count 而非固定时间累积,高速时达到 5,000 events 更快,这也改变了有效 temporal window,解读时应考虑。
9. 消融与 baseline
原论文 Table III–IV:移除 domain randomization 的降幅远大于移除 MHA;AEE benchmark 使用 event-domain fine-tuned RGB pose 网络,但对象与训练协议需逐项核对。来源:原论文 。论文采用 CC BY 4.0,图片版权归作者所有,本站仅作学术解读展示。
Table III 的 full-pose 消融显示:
bleach:AEE 83.6、无 MHA 81.6、无 DR 19.2;
cracker box:86.0、85.9、2.6;
sugar box:82.2、80.9、1.6;
scissors:53.0、45.6、9.0;
wrench:60.4、59.8、9.4。
domain randomization 是跨 RGB render → real event 的决定性因素;MHA 通常只有少量收益。wood block 在 Table III 的 AEE 为 2.5%,去掉 MHA 或 DR 后均为 0%;Table IV 的 AEE 为 5.1%,应区分这两处评测口径。缺少可区分边缘时,结构设计无法凭空恢复信息。
Table IV 将 YOLO-6D、PoseCNN、EfficientPose fine-tune 到 event data。AEE 对多数对象的 full-pose success 更高,且表中 inference 约 5 ms,对照约 20 / 200 / 37 ms。不过这些网络原本为 RGB 直接回归设计,适配和检测 / codebook 口径并不完全同构;它证明 AEE 在该 E-POSE protocol 上合适,不足以宣布对所有事件方法 SOTA。
10. 失败机制
out-of-plane / roll :drill 正面与侧面模板对 yaw / pitch 相近,但事件过稀,难区分 roll 小变化。motion-parallel edges :相机沿某条边方向运动时,该边亮度变化弱,几乎不触发 events;剩余边缘描述的是残缺 rotation。检测框 bias :drill 的对象中心与框中心持续偏移,translation 产生系统误差。固定 event count :低光事件少、噪声比例高;不同速度下 frame 的时间跨度不同。半球模板 :超出 tabletop viewing sphere 时没有覆盖。
11. 作者声称与我的判断
作者声称 我的判断 首个 learning-based event 6D object pose 方法 在作者定义的单 event image、无初始化 setting 中有合理依据;需注意它是 object-specific template learning。 synthetic-only 可迁移真实 event 主结果和 DR 消融强支持。 约 200 Hz 适用于 AEE inference + retrieval;不含 event accumulation 与 detector 的完整端到端口径。 full 6D pose robust rotation 很强,full-pose 对 bbox translation 明显脆弱,不能用 rotation 数字代表 6D。
12. 复现清单与研究启发
明确 40k 模板的 hemisphere orientation、面内角顺序与对象坐标。
保存每项 DR 的随机参数,分别消融 Sobel threshold、edge dropout、noise、scale / translation。
使用与真实 event frame 相同的 polarity合并、时间 / event-count window。
分开测 encoder、40k nearest-neighbor、YOLO 和 event accumulation latency。
报告 detector GT / predicted box 两种 translation,上限与实际性能分开。
未来可用 learned keypoint / depth uncertainty 或 event–RGB stereo 替代框尺度 translation;也可用 product quantization / ANN 扩展多对象 codebook。
论文未给可核验官方代码,精确 DR 配方和训练细节需以全文为主复现。
AEE 的核心贡献很清楚:事件视觉缺少大规模标注时,与其逼真模拟每个 event,不如训练网络对“边缘可能怎样缺失”保持不变。它已经很好解决 orientation;下一步真正决定能否用于操作的是更可靠的 metric translation 与统一端到端时延。