论文精读笔记:Fast-WAM
1. 基本信息
- 完整标题:Fast-WAM: Do World Action Models Need Test-time Future Imagination?
- 作者 / 机构:Tianyuan Yuan、Zibin Dong、Yicheng Liu、Hang Zhao;清华大学交叉信息研究院(IIIS)、Galaxea AI
- 出版信息:arXiv 2026 预印本;本文解读 v2(2026-03-23),不将未核实的录用信息写入元数据
- 一手来源:arXiv 摘要、v2 全文、官方项目页、官方代码
- 阅读模式:精读;论文实验与 2026-09-12 核对到的仓库更新分开记录
2. 一句话定位
Fast-WAM 的核心贡献是把 WAM 的两种潜在收益来源拆开检验:未来视频预测可以是塑造当前观测表征的训练目标,而不必是每次生成动作前都执行的推理步骤。
论文提供的是一种更经济的策略参数化,以及一组支持该设计的实验;不是对“未来想象永远无用”的理论证明。
方法输入与输出
| 项目 | 内容(本站整理) |
|---|
| 推理输入 | 当前多相机 RGB 和语言指令;先得到当前观测条件缓存,再以随机动作噪声启动动作专家。默认路径不接收真实未来帧,也不采样未来视频 latent。 |
| 最终输出 | 长度为 32 的连续 action chunk,由机器人控制接口执行 / 重规划;不是物体 pose、分割或未来 RGB 画面。 |
| 训练输入 | 示教中的当前图像、语言、未来视频和对应动作;当前视觉 token 保持干净,未来视频与动作加噪。注意力掩码禁止动作分支读取未来视频。 |
| 训练目标 | 分别预测视频与动作的 flow-matching 流场,联合优化 Lact+λLvid。未来视频只通过训练目标改善表征,不成为部署时的动作前提。 |
| 输出细节 | 中间输出是动作流场,默认经过 10 步动作去噪后成为 32 步动作序列。单步维数、关节 / 末端坐标、单位和归一化取决于 benchmark;正文没有统一规格,不能概括成固定的 6D 物体变换。 |
| 必要条件 | 需要视频预训练权重与机器人示教训练;不要求显式 CAD / depth / mask / intrinsics。具体本体状态接入需核对实现,不能由“多相机”推断存在几何三角化。 |
2.1 论文图表导读
| 图表 | 证据作用(本站整理) | 需防止的误读 |
|---|
| Figure 1 | 定义 Joint、IDM、Fast-WAM 的条件依赖 | 只跳过 RGB 解码不等于跳过未来 latent 去噪 |
| Figure 2(a) | 展示视频 / 动作专家的结构 | 共用上下文不意味着所有 tokens 任意互相可见 |
| Figure 2(b) | 明确训练和部署的可见性掩码 | 当前帧不能先读未来再间接泄漏给动作 |
| Table 1 | RoboTwin Clean / Rand. 主结果及消融 | 缺失 Rand. 的单项不能当成完整双设置均值比较 |
| Table 2 | LIBERO 四套任务及消融 | 平均高分会掩盖 Spatial / Long 上的落差 |
| Figure 3 | 真实双臂毛巾折叠平台 | 不是多种真实操作任务的大规模评测 |
| Figure 4 | 成功率、完成时间与 GPU 延迟 | 更快并不意味着所有真实任务质量指标都更好 |
本页图像为作者项目页的对应原图;所有 Markdown 表格均为本站整理,非原论文表格截图。
3. 问题设定与任务边界
3.1 输出的是策略,不是物体位姿
令 o 为当前视觉观测,l 为语言指令,a1:H 为长度 H 的动作块。普通视觉运动策略学习:
p(a1:H∣o,l).
引入未来视频 v1:T 后,先想象后执行的策略可写为原文 Eq. (2):
p(a1:H∣o,l)=∫p(v1:T∣o,l)p(a1:H∣o,l,v1:T)dv1:T.
这表示未来是动作生成的中间变量,不是在说系统精确计算了这个积分。实际方法使用生成样本或联合去噪实现策略。论文为控制比较聚焦于单个 action chunk,省略部分先前方法的外层自回归 rollout。
Fast-WAM 改为:
pθ(a1:H∣o,l)=pθ(a1:H∣z(o,l)),
其中 z(o,l) 是对当前上下文单次编码得到的潜在表征,不是采样出来的未来视频。上述公式是策略建模形式,不意味着有限容量模型对真实动作分布的精确等价。
3.2 训练与测试的资产边界
| 项目 | 训练 | 推理 |
|---|
| 当前相机观测与语言 | 输入条件 | 输入条件 |
| 未来视频 | 示教序列中的监督目标,加噪后参与训练 | 默认 Fast-WAM 完全不生成 |
| 动作块 | 有监督目标及其加噪版本 | 从噪声恢复连续动作块 |
| 通用视频模型先验 | Wan2.2-5B、视频 VAE、T5 | 保留编码和条件计算 |
| 额外大规模具身预训练 | 本文模型不使用 | 不等于零样本策略 |
| CAD / depth / object mask / intrinsics | 方法未列为必要模型输入 | 不需要显式几何求解链 |
多相机图像会先拼接后送入 VAE。本文没有定义物体 canonical frame、输出 R,t、尺寸恢复或对称姿态等价类,也没有使用 PnP / ICP。不要将“多相机”自动解释成显式标定三角化。论文正文对具体动作坐标、维数、归一化以及本体状态接入没有给出足够统一的说明,复现应以对应 benchmark 配置为准。
4. 研究脉络
以下对应原文 Related Work 的归纳,不构成对整个 WAM 文献的优先权判断。
| 路线 | 原文讨论的代表 | 与本文关系 |
|---|
| VLA 直接策略 | OpenVLA、π0、π0.5 | 部署接口相近,但基础表征和训练目标不同 |
| 视频与动作联合生成 | Motus、Unified World Models 等 | Fast-WAM-Joint 模拟这类强耦合生成路径 |
| 先未来视频、后动作 | LingBot-VA、Vidar 等 | Fast-WAM-IDM 先得到未来条件,再预测动作 |
| 减少测试时视频计算 | VPP、UVA | 本文不是首个探索绕过完整视频合成的工作 |
VPP 利用视频扩散模型的预测视觉表征;UVA 联合建模视频与动作,并省略测试时视频解码。Fast-WAM 更聚焦于:在共同框架内比较训练视频监督与测试未来生成的相对作用。尤其需要区分 VAE 解码得到可见视频,与视频 latent 本身的多步生成成本。
5. 研究动机
直观上,机器人如果能看到未来就更容易选动作,但这没有回答两个工程问题:
- 视频预测训练是否已经把有用的时序信息写入当前观测的特征中?
- 如果每次执行前仍生成未来,这部分成本是否换来了足够大的控制收益?
作者采用一个直接检验思路:训练时保留视频监督,但让动作从一开始就不读取未来 tokens;测试时删去未来分支,观察质量与延迟怎样变化。这样减少的是部署时的生成依赖,没有删除视频预训练、下游示教或动作去噪本身。
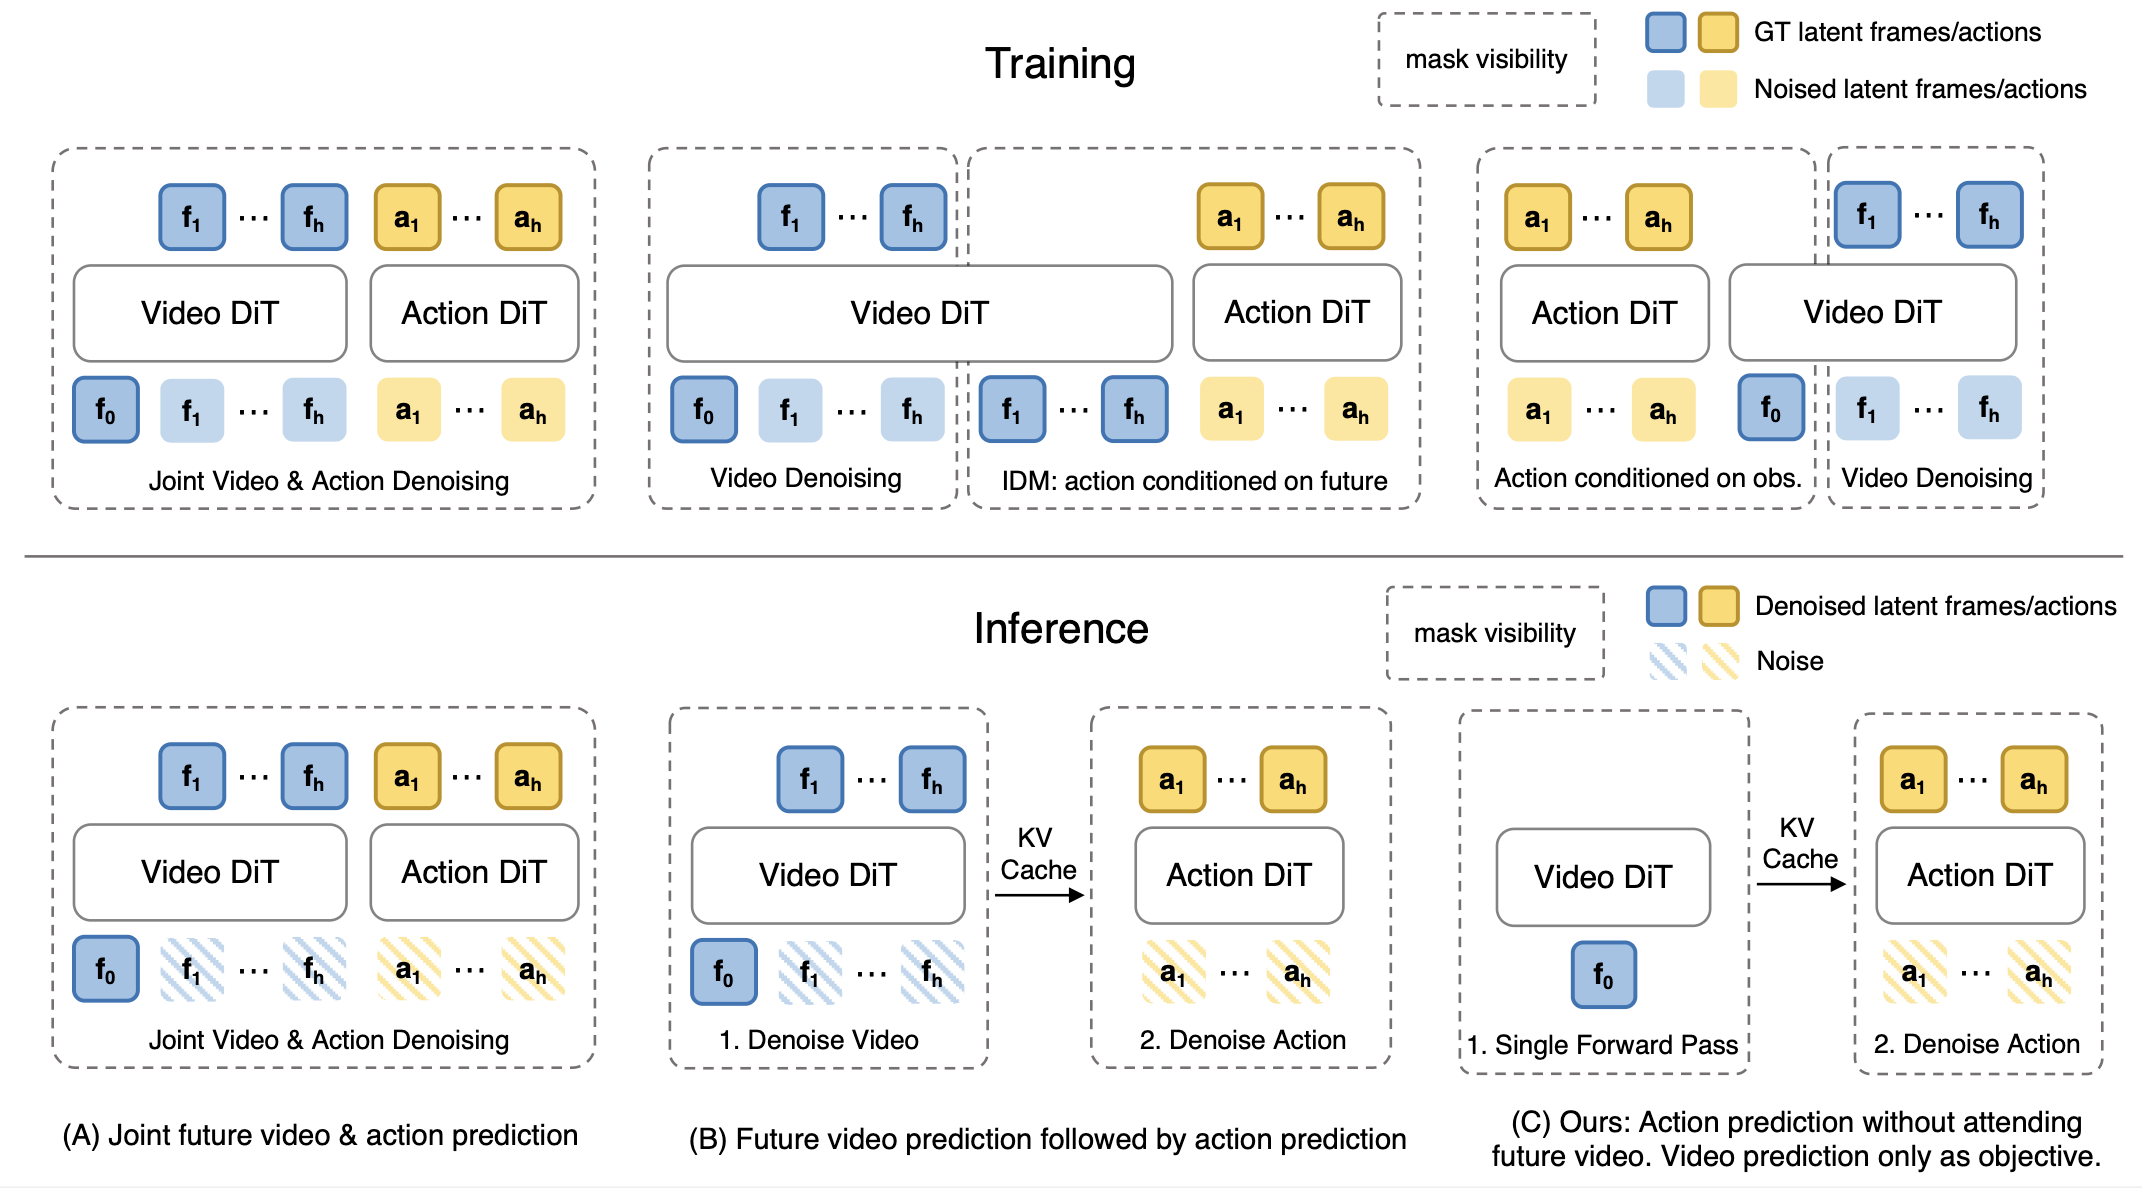 原论文 Figure 1:Joint 同时去噪视频和动作,IDM 先生成视频再预测动作,Fast-WAM 只对当前视觉上下文编码一次,再去噪动作。来源:作者官方项目页。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
6. 方法详解
6.1 总体结构
Fast-WAM 采用 Mixture-of-Transformer(MoT):视频 DiT 与动作专家保留各自的分支,通过共享注意力机制交互,不是按 token 选择少数专家的稀疏 MoE 路由。
| 模块 | 输入 | 输出 / 作用 |
|---|
| T5 文本编码器 | 任务指令 | 供各 token 组 cross-attention 使用的语言条件 |
| 预训练视频 VAE | 拼接后的多相机图像 / 视频 | 当前帧与未来帧 latent tokens |
| Wan2.2-5B 视频 DiT | 当前干净帧、训练时的未来噪声帧 | 训练视频预测;部署时编码当前上下文 |
| 1B 动作专家 DiT | 动作噪声、当前帧特征、语言 | 动作流场预测,生成连续 action chunk |
| 结构化注意力掩码 | 三组 tokens | 限制依赖,使动作条件不包含未来信息 |
动作专家沿用视频 DiT 的结构但将隐藏维度缩减至 1024;论文给出的主体规模为 5B 视频模型加 1B 动作专家,总计约 6B。不要把它理解为全部辅助编码器、运行缓存和优化器状态的完整内存账单。
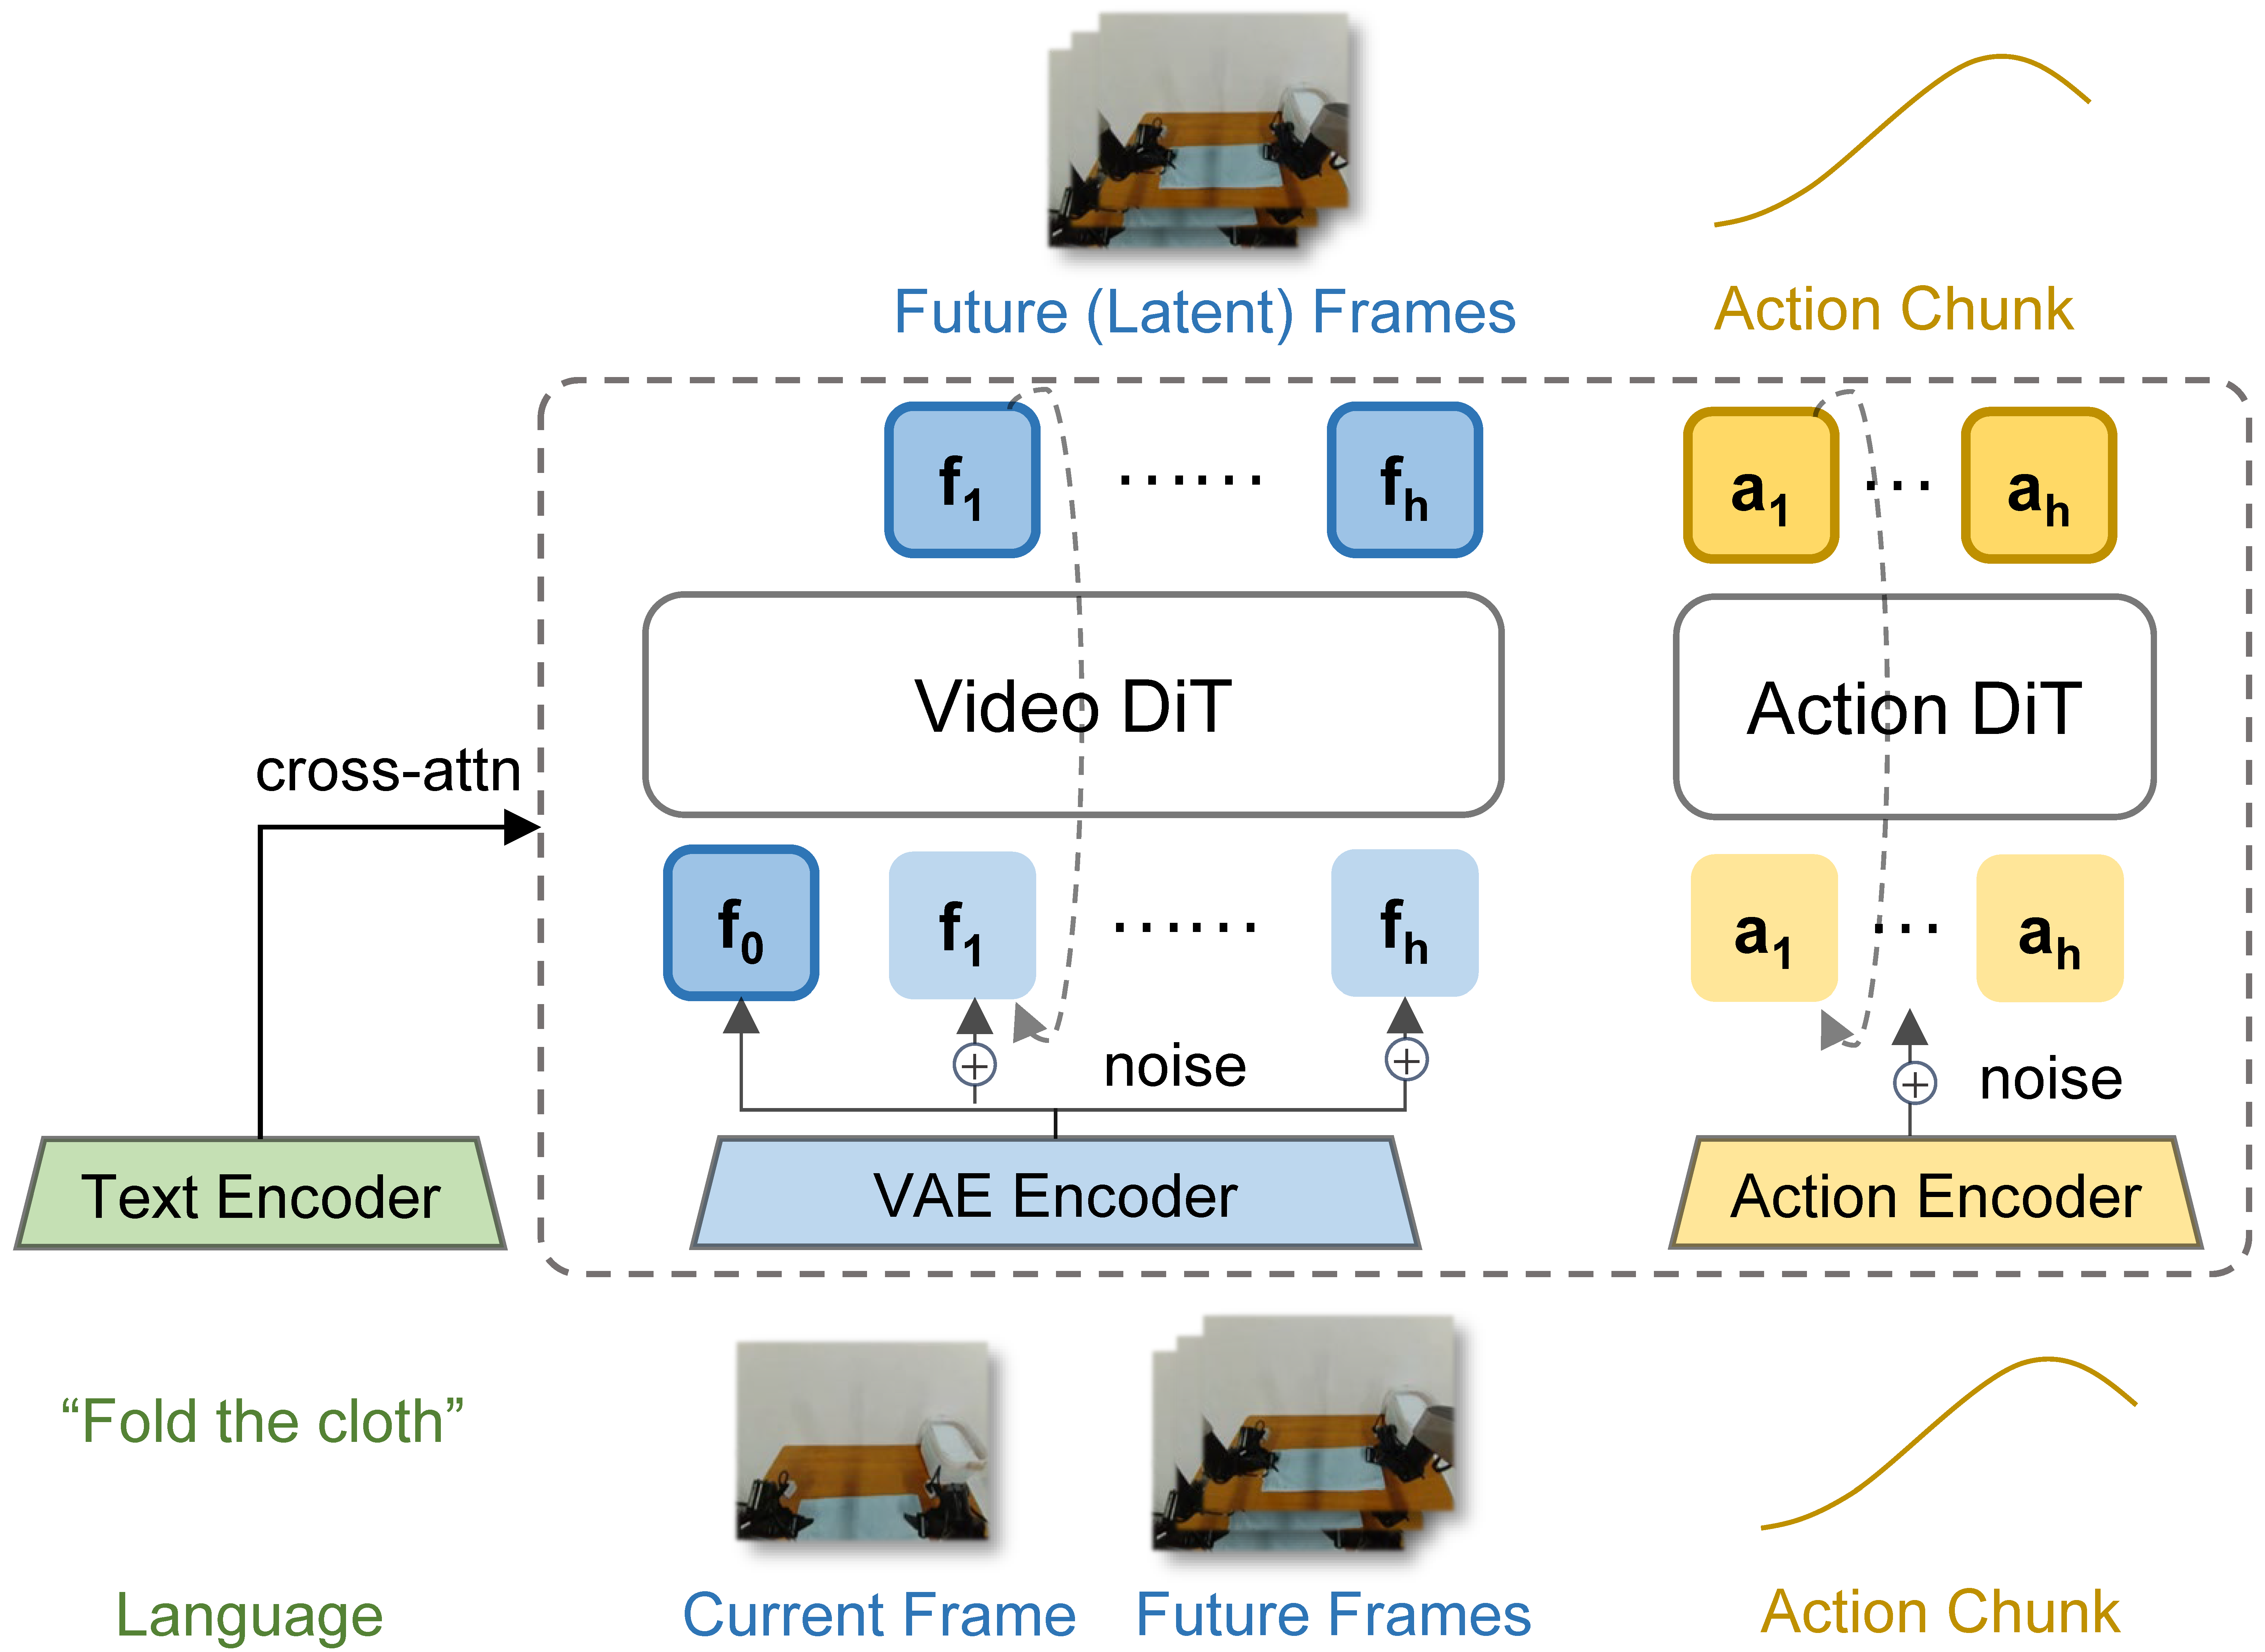 原论文 Figure 2(a):训练时存在未来视频分支,动作和视频分别接受 flow-matching 监督;下一节的掩码决定实际信息流。来源:作者官方项目页。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
6.2 注意力掩码:为什么没有未来泄漏
记当前干净帧为 C,未来视频 tokens 为 F,动作 tokens 为 A。以下可见性表根据 Figure 2(b) 由本站整理,行是 query,列是可读取的 key/value;“可见”表示该组内部对应 block 允许注意力。
| Query / Key-Value | 当前帧 C | 未来视频 F | 动作 A |
|---|
| 当前帧 C | 可见 | 不可见 | 不可见 |
| 未来视频 F | 可见 | 组内双向可见 | 不可见 |
| 动作 A | 可见 | 不可见 | 组内双向可见 |
所有组另可读取文本条件。注意两层保障:
- A 不能直接读取 F。
- C 也不能读取 F,因此不存在 F→C→A 的间接未来泄漏。
推理时删除 F 行列即可,剩余的 C/A 依赖保持不变。C 不依赖动作噪声,所以其分层特征 / KV 可以在一次前向后复用,而无需随每步动作去噪重复运行视频骨干。
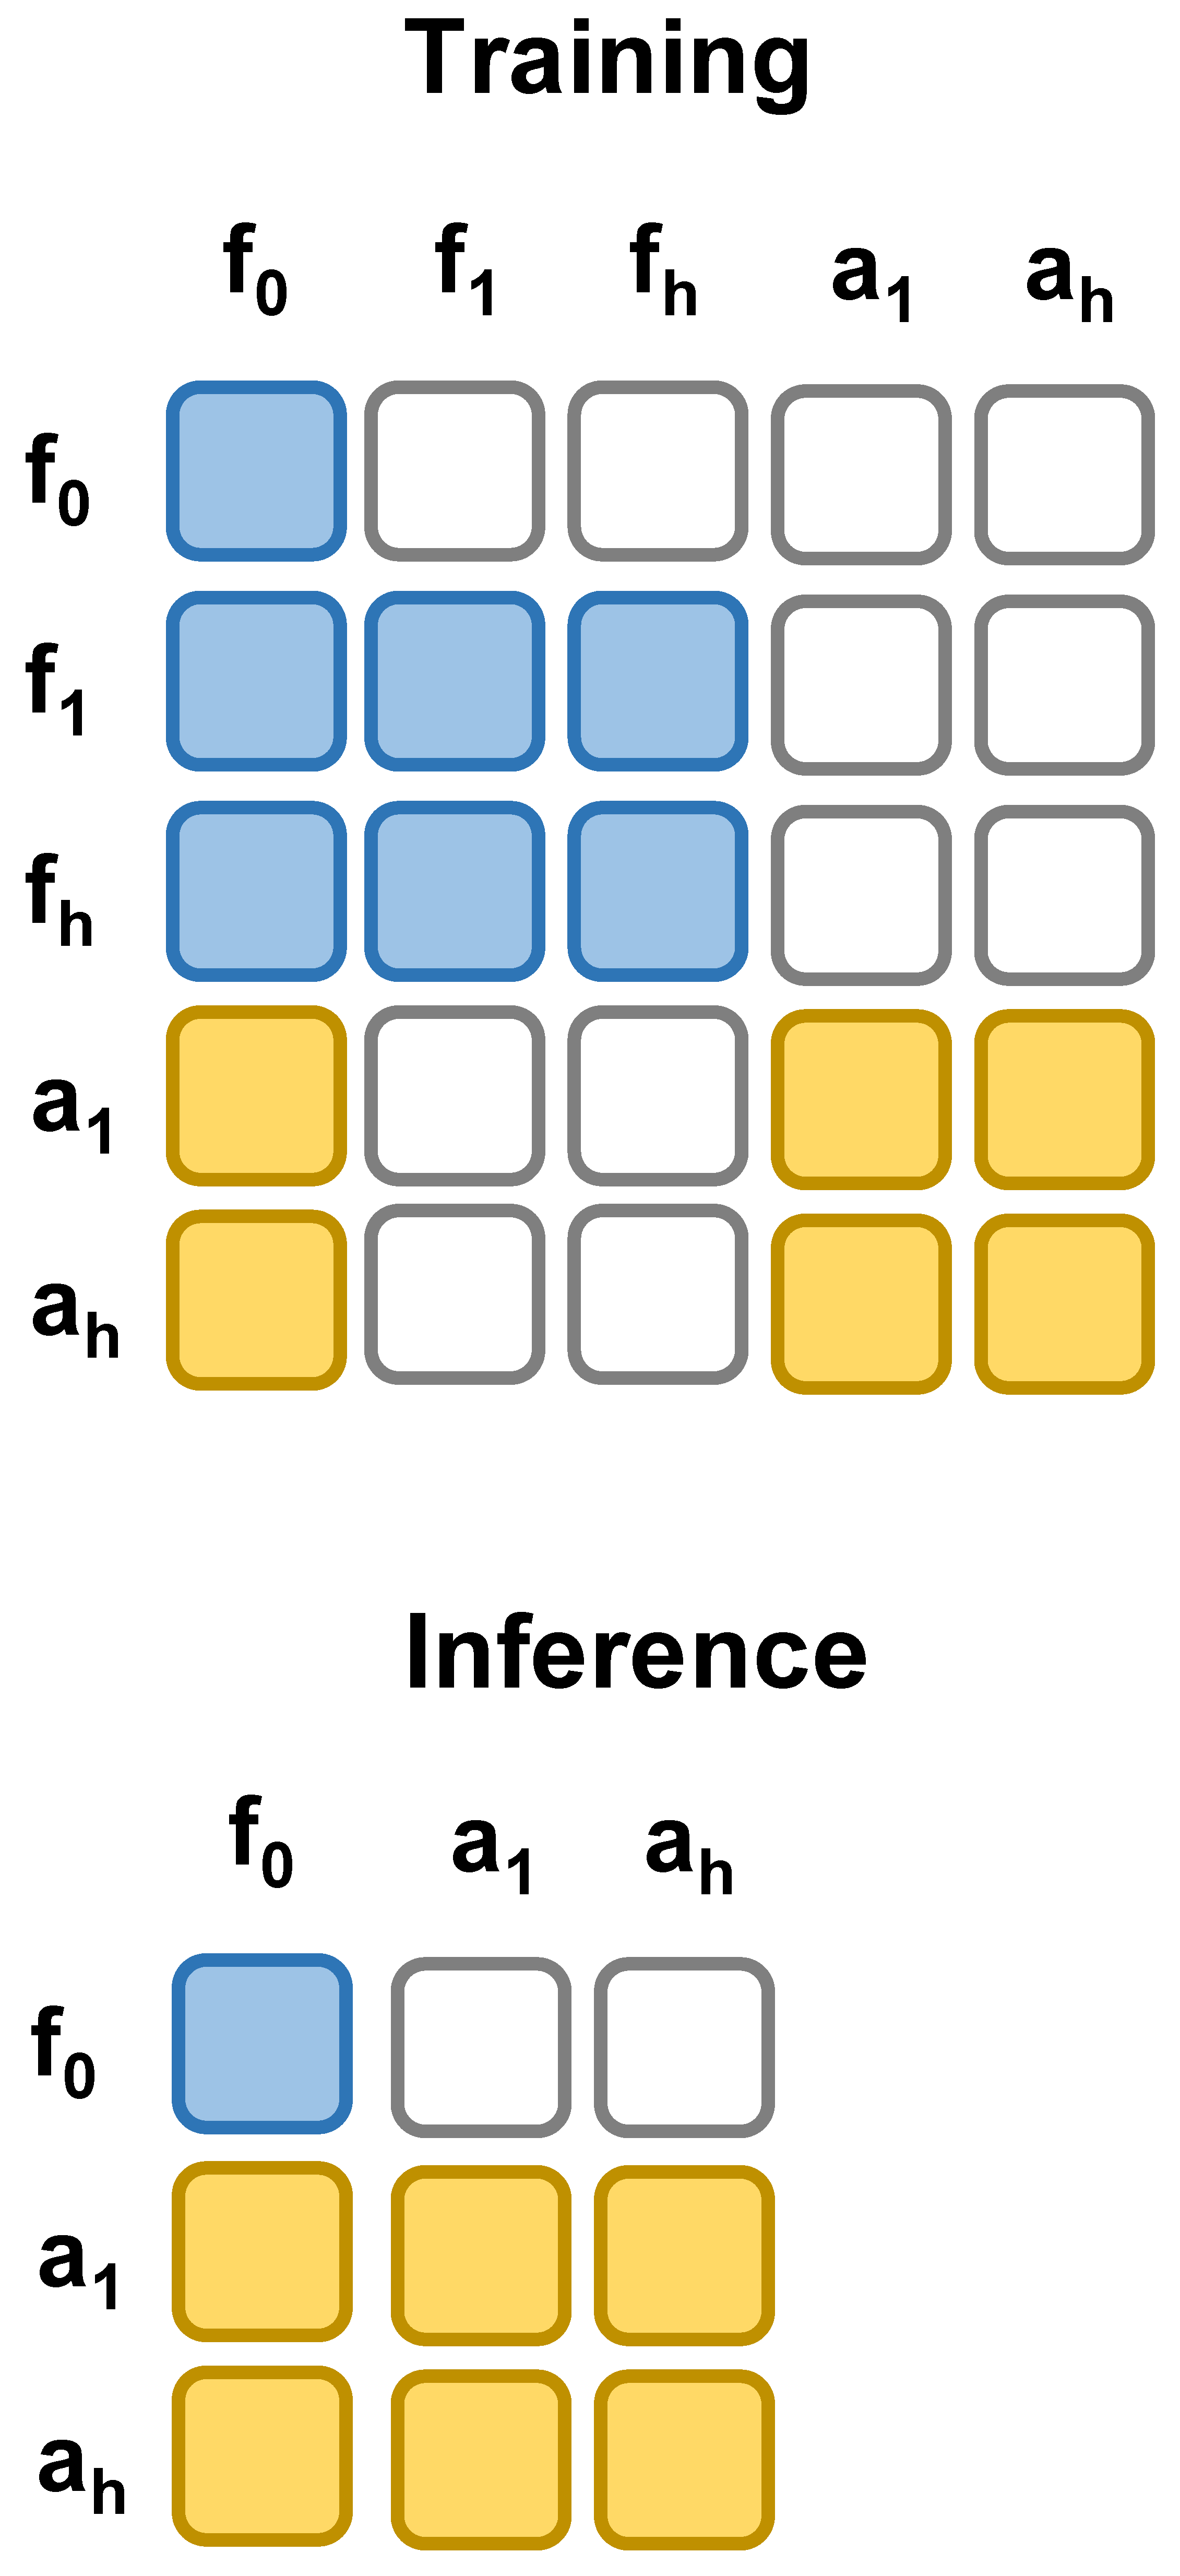 原论文 Figure 2(b):蓝色表示视频组可见区域,黄色表示动作组可见区域;空白 block 被屏蔽。当前帧只看自身,是可缓存且不泄漏未来信息的关键。来源:作者官方项目页。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
为什么看不到未来,视频监督仍能帮动作?我的分析: 视频预测与当前帧编码使用共享的视频骨干参数,未来预测损失能够改变这套参数及上下文表征。训练梯度携带监督,与测试时在单次前向中读取未来样本,是不同的信息通路。掩码禁止的是后者,并不切断参数学习。
6.3 联合 flow matching
对动作块或未来视频 latent 目标 y,采样高斯噪声 ϵ∼N(0,I) 和时间 t∈(0,1),按原文 Eqs. (5)–(9):
yt=(1−t)y+tϵ,
LFM(y)=Ey,ϵ,t[∥fθ(yt,t,o,l)−(ϵ−y)∥22],
Lact=LFM(a1:H),Lvid=LFM(z1:T),L=Lact+λLvid.
这里 z1:T 是未来视频监督 latent,与前文表示当前上下文的 z(o,l) 含义不同。按这组插值定义,t=0 为数据、t=1 为噪声,速度目标为 ϵ−y;生成时沿噪声到数据的方向求解,不能照搬反向时间约定却不修改符号。
联合损失并不直接优化任务成功率:监督是示教动作与视频上的流场误差,最终评价则是闭环执行结果。论文正文引入了 λ,但没有在所列实现参数中给出其数值;实际权重和归一化细节需查固定版本配置。
6.4 三组对照变体
| 变体 | 视频训练目标 | 训练 / 推理依赖 | 检验什么 |
|---|
| Fast-WAM | 保留 | 动作只看当前上下文;测试不生成未来 | 默认设计 |
| Fast-WAM-Joint | 保留 | 放开视频与动作注意力交互;测试联合去噪 | 联合未来想象是否必要 |
| Fast-WAM-IDM | 保留 | 动作依赖未来;测试先生成未来视频 | 两阶段先想象后执行是否更有效 |
| w.o. video co-train | 删除 | 架构和默认推理路径不变 | 视频预测训练本身是否重要 |
IDM 训练对真实视频 tokens 以 p=0.5 的概率加噪增强,用于缓解训练真实未来与测试生成未来的差异。因变体改变了注意力依赖和部分训练处理,不能称其为除“开关”之外所有因素完全相同的严格析因实验;但它比直接比较不同规模、不同数据的外部 WAM 更有解释力。
尤其重要的是,无视频联合训练变体仍保留 Wan 视频预训练初始化。它检验的是下游视频监督的额外作用,不是“视频预训练是否有用”。
6.5 实现与推理成本
| 项目 | 论文设置(本站整理) |
|---|
| 动作 horizon | 32 |
| 视频采样 | 时间下采样 4 倍,每个 chunk 对应 9 帧视频 |
| 动作专家隐藏维度 | 1024 |
| 噪声安排 | logit-normal 时间分布 |
| 推理去噪 | 10 步;CFG scale 1.0 |
| 优化器 | AdamW,学习率 10−4,weight decay 0.01 |
| 训练稳定性 | cosine schedule、mixed precision、gradient clipping 1.0 |
| 测速硬件 | 单张 NVIDIA RTX 5090D V2 32GB |
部署流程可概括为:编码语言和当前图像,单次运行视频 DiT 获取当前条件缓存,初始化动作噪声,执行动作专家的 10 步去噪,输出 action chunk,再由具体机器人执行和重规划。
Single-pass world encoder 不等于 single-step policy。 不生成未来视频也不等于不使用视频模型。论文报告的是特定硬件上的推理延迟,没有提供完整的传感器采集、通信、安全控制与执行调度分项账单。
7. 实验分析
7.1 数据与协议
| 环境 | 训练数据 / 步数 | 评价协议 |
|---|
| LIBERO | 四个 suite,每套 10 任务、500 条示教;训练 20k steps | 40 任务合计 2000 次评测,报告各 suite 成功率 |
| RoboTwin 2.0 | 2500 条 Clean + 25000 条随机化示教;训练 30k steps | Clean / Rand. 各每任务 100 次;附录列出 50 个任务 |
| 真实毛巾折叠 | R1 Lite 上 60 小时遥操作示教;训练 30k steps | 成功率及平均完成时间;另测推理延迟 |
RoboTwin 正文使用“超过 50 个任务”的概述,附录明细为 50 个任务;本页不据此虚构更多任务。训练步数指本文实验设置,不应套用于所有外部 baseline 的历史训练。
7.2 RoboTwin:读平均分,也读缺失项
下表由原文 Table 1 本站整理,单位 %。Embodied PT 指额外具身预训练,不包括通用 Wan 视频预训练;Average 保留原文显示精度。
| 方法 | Embodied PT | Clean | Rand. | Average |
|---|
| π0 | 是 | 65.92 | 58.40 | 62.2 |
| π0.5 | 是 | 82.74 | 76.76 | 79.8 |
| Motus | 是 | 88.66 | 87.02 | 87.8 |
| Motus from Wan2.2 | 否 | 77.56 | 77.00 | 77.3 |
| LingBot-VA | 是 | 92.90 | 91.50 | 92.2 |
| LingBot-VA from Wan2.2 | 否 | 80.60 | 未报告 | 80.6 |
| Fast-WAM | 否 | 91.88 | 91.78 | 91.8 |
| Fast-WAM-Joint | 否 | 90.84 | 90.32 | 90.6 |
| Fast-WAM-IDM | 否 | 91.16 | 91.34 | 91.3 |
| Fast-WAM w.o. video co-train | 否 | 82.76 | 84.80 | 83.8 |
需要特别注意:LingBot-VA from Wan2.2 没有 Rand. 数值,其 Average 栏 80.6 只对应已报告的 Clean。不能把它和 Fast-WAM 的双设置均值当作严格同口径差值。可以比较 Clean 的 91.88 与 80.60,也可以对 Rand. 数据完整的方法比较均值。
Fast-WAM 对 Joint / IDM 的均值优势为 1.2 / 0.5 个百分点;删除视频联合训练则下降 8.0 个百分点。这个消融量级关系比“超过哪些外部模型”更贴近论文要回答的问题。
7.3 LIBERO:显式未来仍可能有小幅收益
下表由原文 Table 2 本站整理,单位 %,均值保留论文精度。
| 方法 | Embodied PT | Spatial | Object | Goal | Long | Average |
|---|
| OpenVLA | 是 | 84.7 | 88.4 | 79.2 | 53.7 | 76.5 |
| π0 | 是 | 96.8 | 98.8 | 95.8 | 85.2 | 94.1 |
| π0.5 | 是 | 98.8 | 98.2 | 98.0 | 92.4 | 96.9 |
| LingBot-VA | 是 | 98.5 | 99.6 | 97.2 | 98.5 | 98.5 |
| Motus | 是 | 96.8 | 99.8 | 96.6 | 97.6 | 97.7 |
| Fast-WAM | 否 | 98.2 | 100.0 | 97.0 | 95.2 | 97.6 |
| Fast-WAM-Joint | 否 | 99.6 | 99.4 | 98.2 | 96.8 | 98.5 |
| Fast-WAM-IDM | 否 | 98.8 | 97.8 | 97.8 | 97.6 | 98.0 |
| Fast-WAM w.o. video co-train | 否 | 89.2 | 99.2 | 95.4 | 90.0 | 93.5 |
Fast-WAM 比 Joint / IDM 低 0.9 / 0.4 个百分点,说明省去测试时未来生成不是严格无损。另一方面,删除视频训练导致平均下降 4.1 个百分点,Spatial 从 98.2 降至 89.2,Long 从 95.2 降至 90.0,方向仍与 RoboTwin 一致。
我的分析:这支持“训练视频监督贡献更大”的相对判断。论文未给出这些差异对应的跨独立训练重复方差或显著性检验,不宜将亚百分点差值当成稳定优劣,也不能从满分 Object suite 推断开放物体泛化已经解决。
7.4 真实实验:延迟优势与质量代价并存
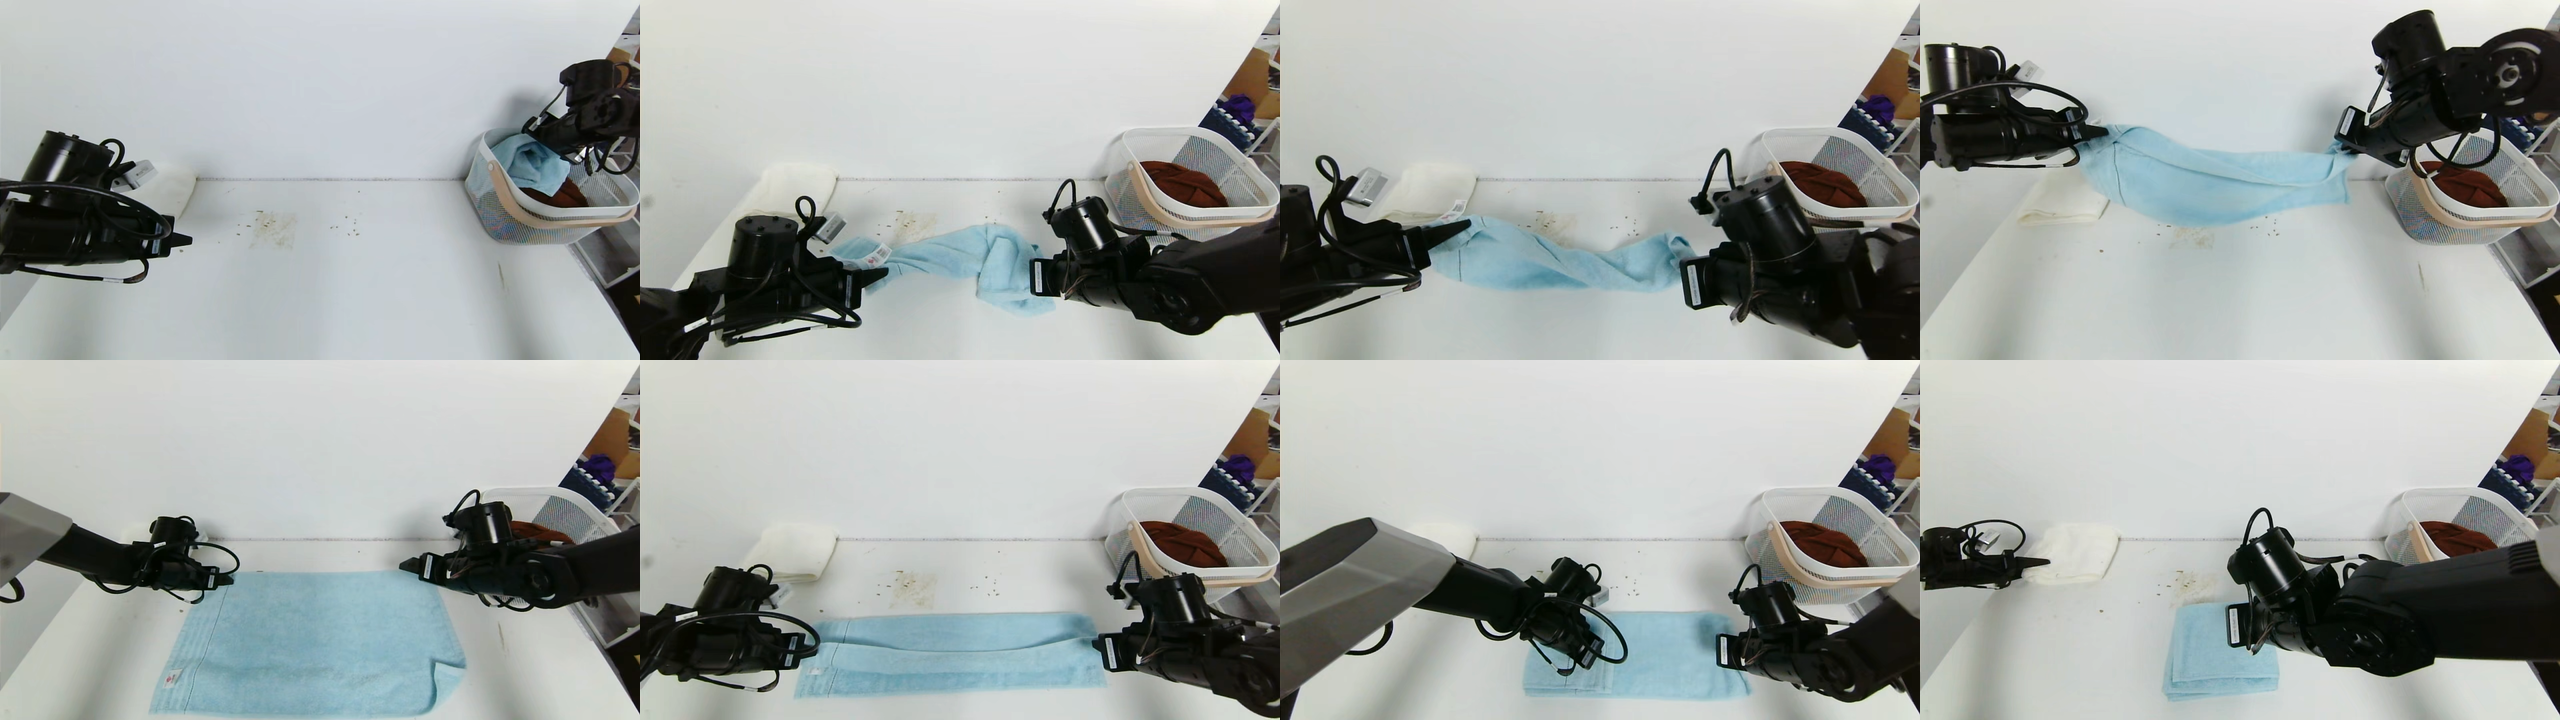 原论文 Figure 3:真实毛巾折叠任务,包含可变形物体和长程双臂交互;训练数据为 60 小时遥操作示教。来源:作者官方项目页。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
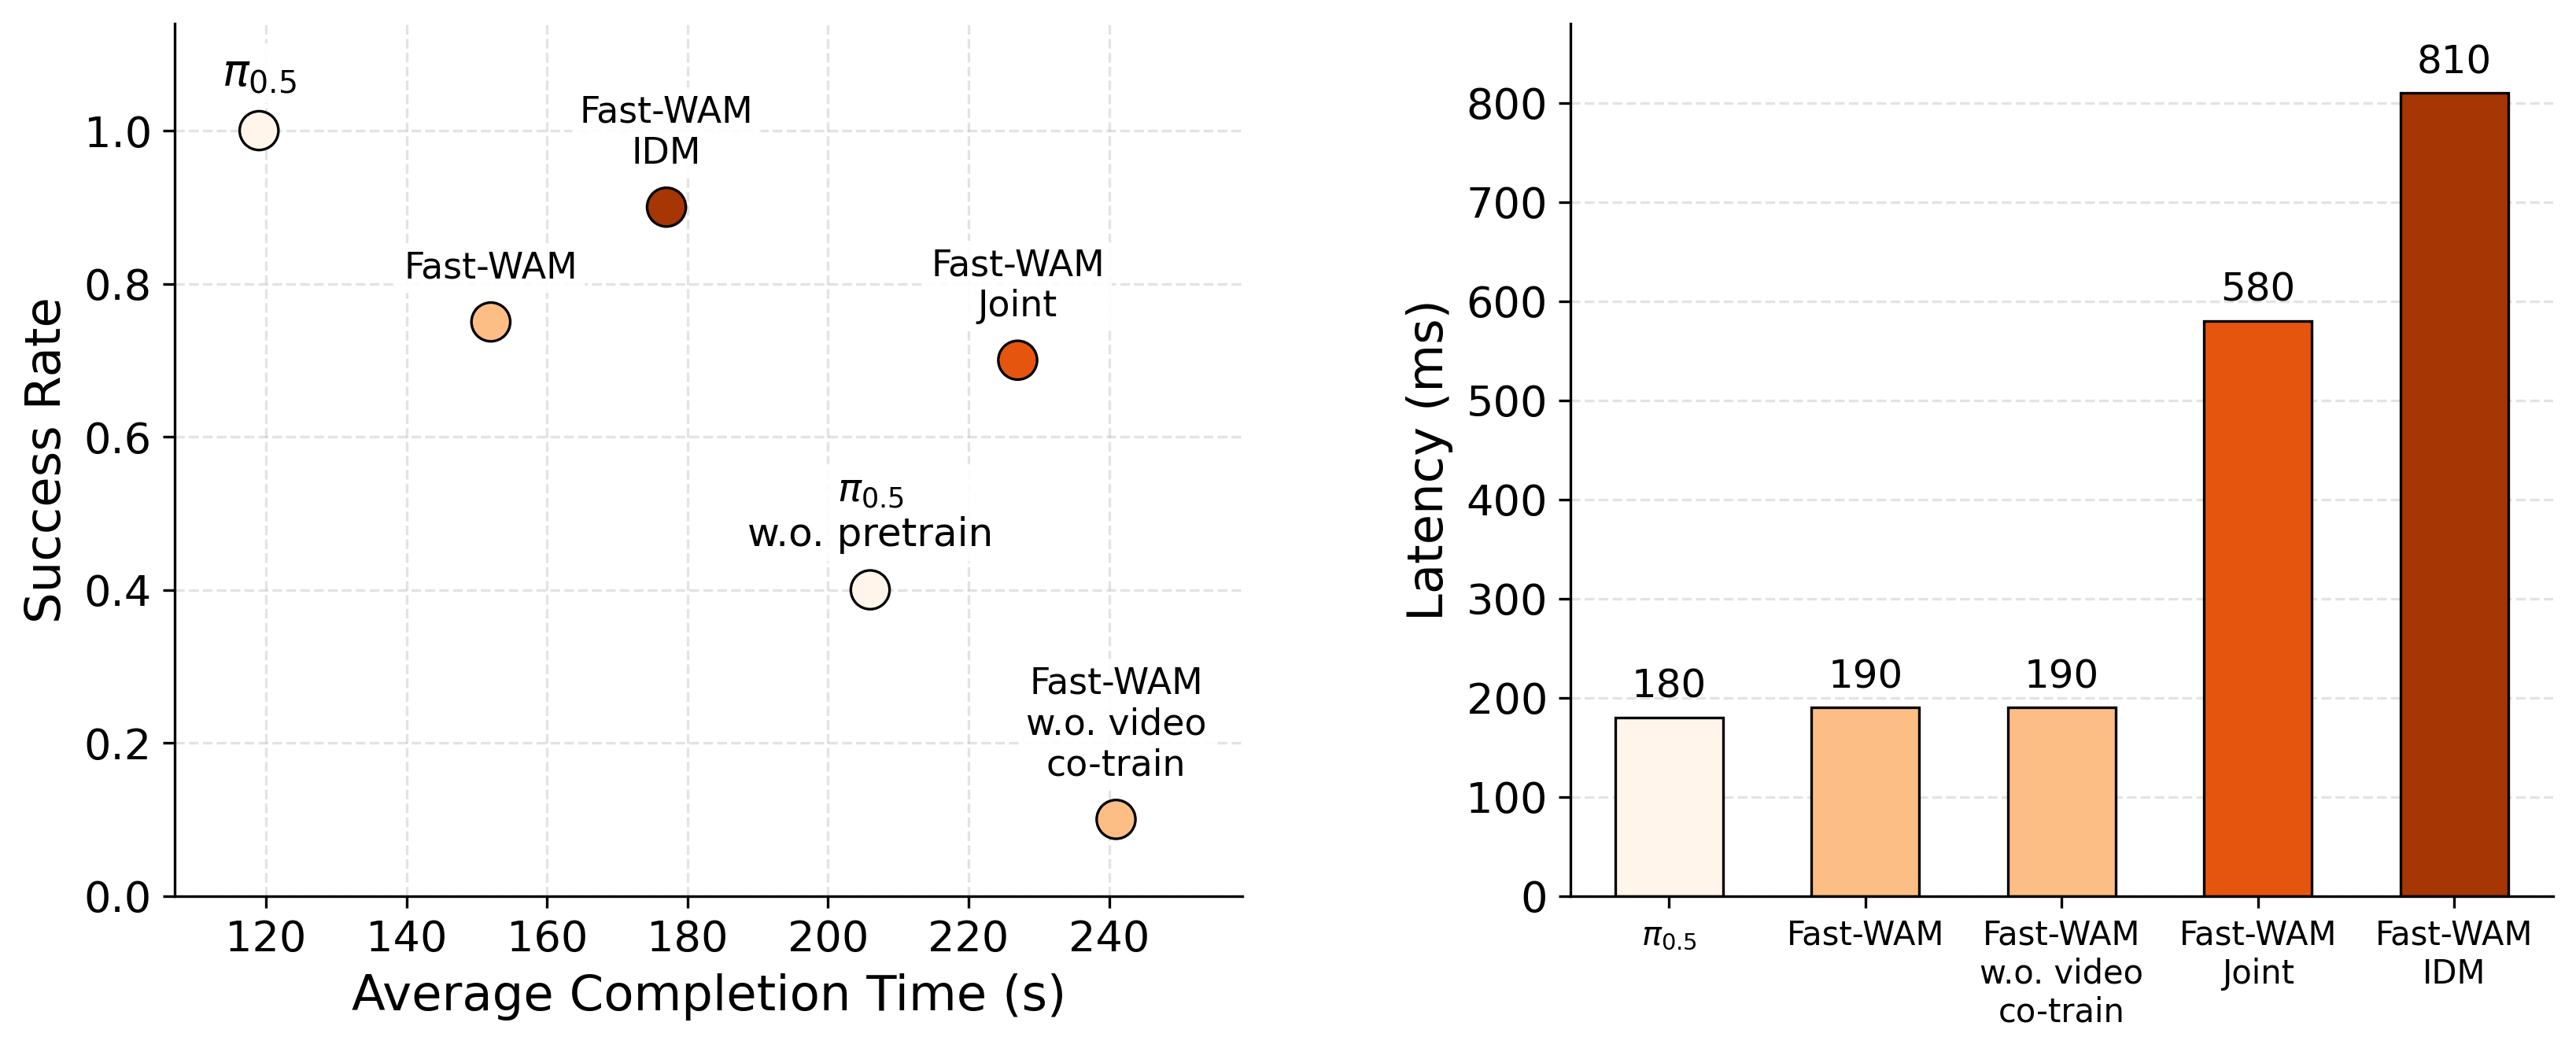 原论文 Figure 4:左侧为策略质量与任务时间的权衡,右侧为相同测速硬件上的模型延迟。来源:作者官方项目页。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
以下为 Figure 4 图上读数的本站整理。成功率及完成时间来自散点坐标,只给约值;延迟取柱形图明确标注。无视频训练的 10% 成功率也有正文明确陈述。
| 方法 | 成功率(约) | 平均完成时间(约,秒) | 推理延迟(ms) |
|---|
| 预训练 π0.5 | 100% | 120 | 180 |
| π0.5 w.o. pretrain | 40% | 206 | 未单列 |
| Fast-WAM | 75% | 152 | 190 |
| Fast-WAM-Joint | 70% | 227 | 580 |
| Fast-WAM-IDM | 90% | 177 | 810 |
| Fast-WAM w.o. video co-train | 10% | 241 | 190 |
这张图不能只读“快 4 倍”:
- 810 / 190 约为 4.26,适用于 IDM 对照;580 / 190 约为 3.05,适用于 Joint 对照。
- Fast-WAM 与无视频联合训练模型的延迟相同,质量却差距很大,支持保留训练目标的价值。
- IDM 在真实成功率上仍高于 Fast-WAM;Fast-WAM 则有更短完成时间和模型延迟。
- 预训练 π0.5 在此任务的成功率、完成时间和推理延迟均有优势;不能宣传成 Fast-WAM 全面优于 VLA。
成功率衡量充分时间内能否完成,完成时间反映效率。但论文没有在正文中充分说明失败轨迹如何参与平均完成时间、真实评测次数及置信区间,这些都会影响图中差异的解释。
7.5 主张与证据
| 作者声称 | 证据 | 我的判断 |
|---|
| 无测试时未来生成也能维持强策略性能 | 两套仿真及真实任务的 Fast-WAM / Joint / IDM 对照 | 基本支持,但不意味着逐任务无损 |
| 视频联合训练比测试时未来生成更关键 | 去掉视频目标在三类实验中均显著退化 | 当前训练配方下证据较强,不自动推广到所有模型规模 |
| 推理更适合实时部署 | 190 ms,相比 Joint / IDM 更快 | 支持降低模型延迟,尚非完整实时控制系统证明 |
| 世界表征得到改善 | 下游成功率和消融 | 是合理解释,缺少直接表征 / 物理预测能力诊断 |
| 不依赖具身预训练仍具竞争力 | 与具身预训练基线同表比较 | 不等于数据预算、计算预算和预训练知识完全公平 |
7.6 鲁棒性与失败边界
RoboTwin Rand. 测试了场景随机化下的表现,真实折叠测试了可变形对象操作。但论文没有给出按遮挡比例、光照、无纹理物体、相机位移或新对象难度分层的完整实验,也未系统分析错误轨迹为何失败。
对称物体的 pose 等价、深度噪声或 mask 误差并不是本文直接评测的变量。没有使用这些输入不能被写成“已证明对这些误差鲁棒”。部分可观测环境中,仅当前帧是否足够,也是本文尚未充分覆盖的边界。
8. 批判性分析
8.1 值得肯定的设计
论文把“训练需要什么”与“部署需要什么”作为两个问题处理。结构化掩码不仅用于消融,也真正使当前帧表征可缓存,因此概念判断与工程优化相互对应。双基准加真实任务让结论不完全依赖某个仿真 suite。
8.2 不能过度外推的结论
第一,无法证明显式规划无用。 本文没有系统研究分支搜索、反事实动作比较或高风险场景的多候选评估。生成一个未来视频与利用世界模型进行规划不是同义词。
第二,没有完整拆分视频先验的各个来源。 去掉下游视频训练的消融仍使用预训练 Wan,未建立“无视频预训练 / 有视频预训练”与“无下游视频目标 / 有下游视频目标”的完整对照。
第三,所谓数据效率缺少完整 scaling 曲线。 模型不使用额外具身预训练,但 RoboTwin 仍使用 27500 条示教,真实折叠使用 60 小时数据。实验说明这种配方可行,不能证明在任意少样本预算下都最优。
第四,基准高分不等于可靠部署。 LIBERO 接近饱和,真实任务较单一,未测长时间累计失败、安全接触或跨机器人迁移。32GB 卡上的 190 ms 也不代表边缘硬件可直接承载。
9. 复现与仓库版本
9.1 已公开内容
截至 2026-09-12 核对到的官方仓库包含训练、LIBERO / RoboTwin 评测和配置,提供权重、LIBERO 数据与 RoboTwin 数据入口。本站已确认资源入口存在,没有执行模型训练或 benchmark 复现。
建议按以下顺序准备,而不是只加载一个策略权重文件:
- 固定代码 commit、模型版本、任务配置和模拟器版本,记录精度、去噪步数及测速范围。
- 根据 README 准备 Wan 组件与动作 DiT backbone,再准备目标任务 checkpoint 和匹配的 dataset statistics。
- 保持 LIBERO 数据与 MuJoCo 版本一致;RoboTwin 还需要仿真环境、场景资产和 policy 接口。
- 先用少量任务检查相机顺序、动作归一化和成功终止条件,再进行完整评测。
- 重做受控比较时保持数据、训练预算和 rollout 协议一致,并报告多次训练的方差。
9.2 当前代码与原论文不可混用的地方
官方 README 已增加编译推理加速、LeRobot 3.0 和 Optional IDM 等更新。Optional IDM 可在同一个新模型中选择先想象或直接使用当前帧,不是原论文四行消融表中的同一组 checkpoint。
仓库提示原始发布权重评测需要 EVALUATION.sigma_shift=5.0,而新默认 action scheduler shift 已改为 1.0。运行最新默认配置不必然复现旧权重的原始数值。
仓库还提示 RoboTwin 使用 unseen instructions,而所比较 LingBot-VA 的指令设置不同。语言指令是否未见与物体是否未见是两种划分,不能把前者解读成 novel-object pose 泛化。严格横比应先统一协议。以上均为官方 README 的工程补充,与论文 v2 主结果分开理解。
9.3 仍需核实
- 与论文原始结果对应的精确代码 commit、训练超参数及 loss 权重。
- 每个 benchmark 的动作表示、归一化、本体状态接入和重规划执行步数。
- 真实实验的试验次数、初始化分布、失败超时及完成时间统计规则。
- 延迟是否包含文本编码、VAE 编码、预处理与传输,以及首次编译 / warm-up 成本。
- 峰值显存、训练 GPU 时、跨 seed 方差,不能由单个参数量或测速值推算出来。
10. 对 6D 感知与具身研究的启发
以下是我的分析与研究建议,不是论文实验结论。
- 几何作为训练监督:可以检验未来物体 pose、接触状态或可供性预测是否同样能塑造低延迟策略,而不强制部署时输出这些中间结果。
- 自适应计算:默认使用快速当前帧路径,在遮挡、歧义或任务失败风险升高时才启用未来生成;需同时评价触发质量和总任务成本。
- 表征诊断:对同一骨干进行 pose / depth / motion probe,检查收益来自几何动态信息还是一般多任务正则化。
- 公平对照:若将 Fast-WAM 与 Pose-VLA 比较,应统一机器人示教、动作头、预算与任务划分;二者分别强调视频时序监督和显式空间监督,现有跨论文平均分不能隔离原因。
11. 总结
Fast-WAM 给出的有价值结论是:在本文测试的配方与任务中,保留未来视频训练目标,比在测试时真的生成未来视频更重要。 结构化注意力让这个结论转化为可部署的单次视觉编码路径,但动作仍需多步生成,真实成功率仍存在取舍,推广到复杂规划与开放环境还需要进一步证据。
