论文精读笔记:GeniWorld
1. 基本信息
标题 :GeniWorld: A Generalizable Interactive World Model for Robotic Manipulation via Visual Actions作者 :Chenghao Gu、Hanyang Yu、Jingbo Zhang、Haitao Lin、Wenyao Zhang、Jinghe Wang、Hanglei Jin、Shuzhao Xie、Jingyan Jiang、Zhi Wang机构 :清华大学深圳国际研究生院、Tencent Robotics X、香港科技大学、深圳技术大学论文版本 :arXiv:2608.06332v1,2026-08-06;按预印本收录一手来源 :摘要与版本信息 、全文及附录 、官方项目页 开源状态 :2026-09-12 核对时,官方项目页代码栏为 Coming soon;项目页源码不是模型实现阅读模式 :精读。以下区分论文报告、本站整理和我的分析,未执行模型训练或实验复现
2. 一句话定位
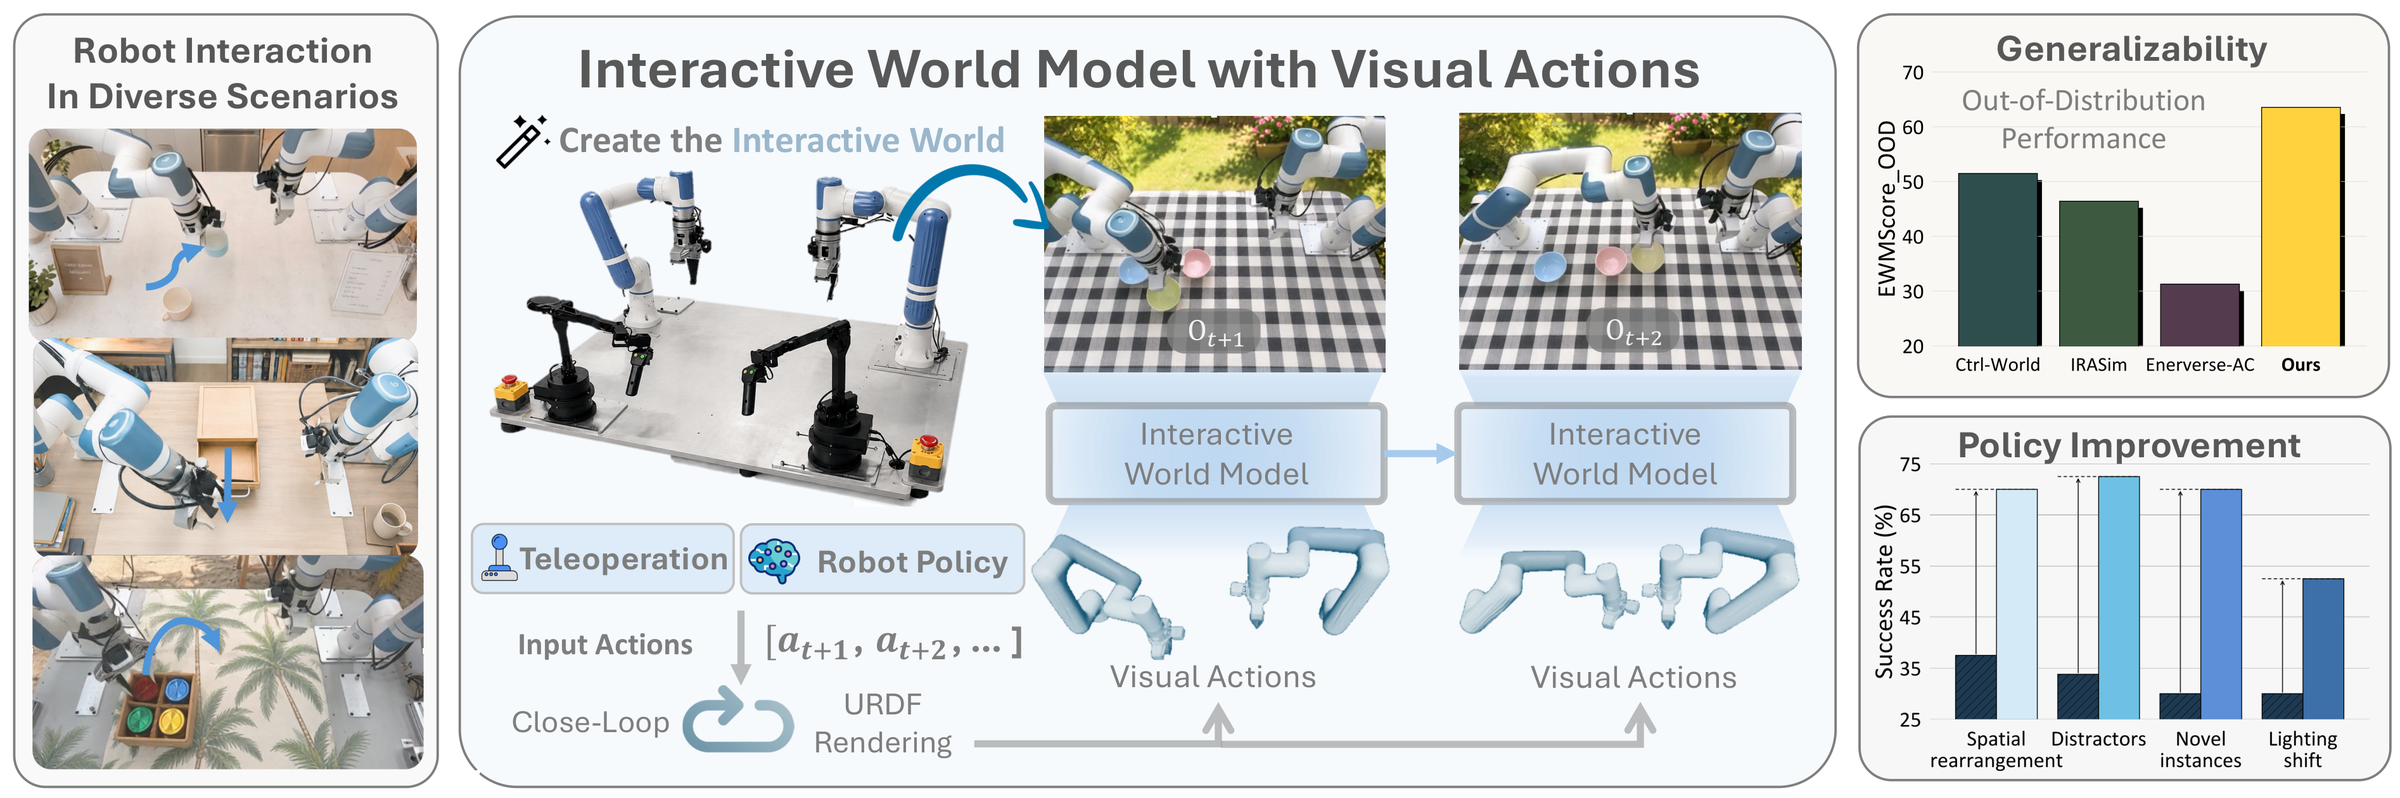
GeniWorld 将可由机器人几何和运动学直接计算的运动变成像素对齐条件,让预训练视频模型集中学习这种运动导致的环境响应,再以自回归生成支持交互式策略评测与数据生产。
最值得讨论的是 数值动作如何进入视频生成器 ,以及这种表示是否真能改善分布外行为建模;不是单纯更换视频骨干。
方法输入与输出
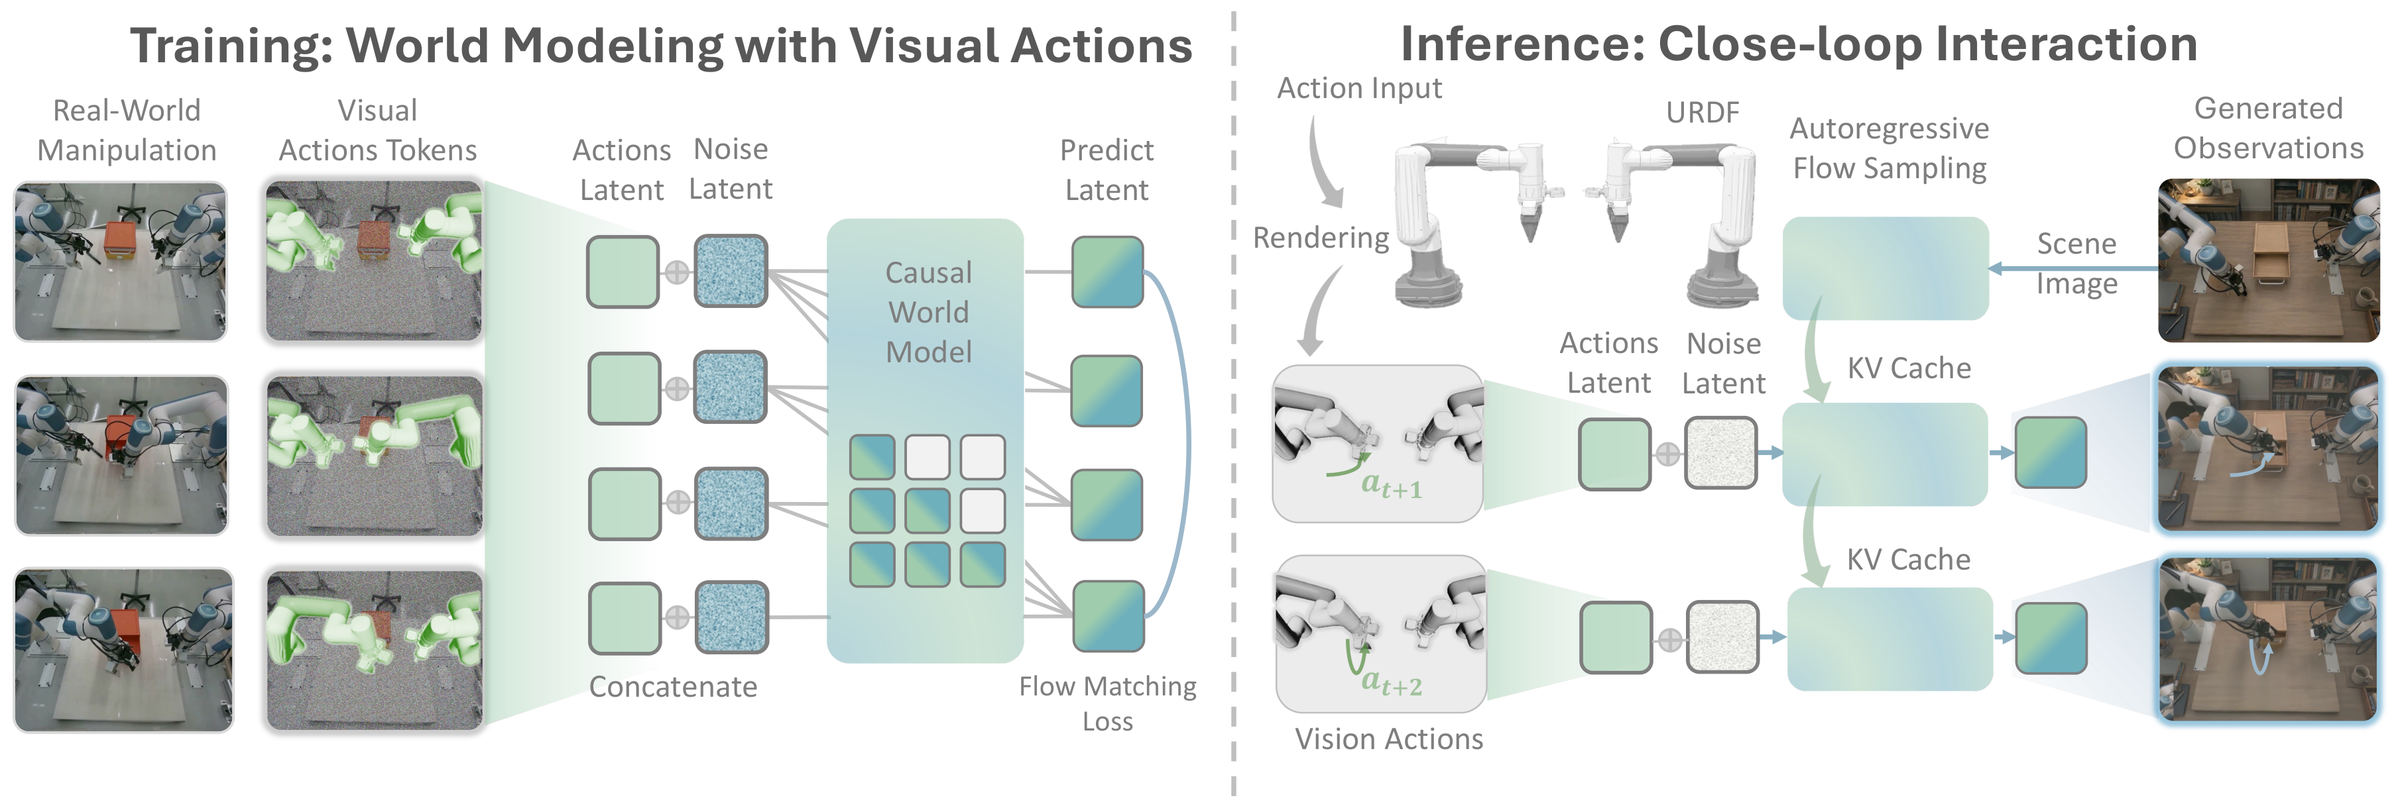
项目 内容(本站整理) 推理输入 初始 RGB / 历史观测上下文、语言和外部给定动作。动作通过机器人 URDF、运动学与标定相机渲染,再由 VAE 编码成干净的 visual-action latent;待生成观测从噪声开始。 最终输出 在给定动作条件下生成的未来 RGB 观测,可逐块自回归滚动。动作是输入而非输出;视频再供外部策略评测、交互或数据增强使用。 训练输入 时间对齐的机器人观测视频、语言和动作轨迹;动作渲染得到视觉条件,真实未来观测作为监督。训练先使用真实历史,再引入生成历史上下文。 训练目标 对观测 latent 加噪并预测其流场;视觉动作 latent 保持干净,不作为待去噪目标。模型学习动作导致的视觉变化,而不是从视频反求动作。 输出细节 observation latent 与 action latent 各 48 通道,拼接为 96 通道输入;最终解码为 480 × 640 480\times640 480 × 640 必要条件 需要机器人 URDF / 几何、正向运动学、renderer、相机内外参 / 手眼对齐;这些是构造条件的资产。物体 CAD、深度、mask 不是必要输入;数值动作到可渲染状态的细节需按机器人接口核对。
2.1 论文图表导读
图表 所在实验 / 模块 解读重点(本站整理) Figure 1 总体用途 世界模型在策略与合成环境之间提供反馈 Figure 2 训练与推理 动作保持干净,观测加噪;因果生成并缓存历史 Figure 3 Clean-to-Random 定性对照 动作错误、无接触抓取和无关物体变化是不同失败类型 Table I 视频质量与动作条件消融 同域 / OOD 分开看,比较六种指标 Figures 4–5 训练收敛和少步采样 更多先验是否减少训练及推理难度 Figure 7 策略评测器 相关性支持但不能保证新策略排名可靠 Figure 9 / Table III 真实策略提升 五设置、四任务、每格 20 次,三套完整数据方案 Table II / Table IV 附录实现及任务协议 3 个 latent 帧一块;Progress 不是成功率
本页本地插图为作者项目页公开原图;Markdown 表格为本站整理,并非原论文表格截图。未本地展示的图表可在原文查看。
3. 问题设定与任务边界
3.1 世界模型与动作策略不是同一个函数
训练集由配对的观测和动作轨迹组成:
D = { τ i } i = 1 N , τ i = { ( o 0 , a 0 ) , … , ( o T , a T ) } . \mathcal D=\{\tau_i\}_{i=1}^{N},\qquad
\tau_i=\{(o_0,a_0),\ldots,(o_T,a_T)\}. D = { τ i } i = 1 N , τ i = {( o 0 , a 0 ) , … , ( o T , a T )} . 给定当前观测和未来动作序列,原文用以下形式描述预测目标:
o t + 1 : t + H = W ( o t , a t + 1 : t + H ) . o_{t+1:t+H}=\mathcal W(o_t,a_{t+1:t+H}). o t + 1 : t + H = W ( o t , a t + 1 : t + H ) . 这是条件生成模型的记号,不表示世界的未来由单幅图像和动作唯一确定。模型以噪声采样产生视频,其潜在不确定性不能从这个简化等式中消失。
在闭环系统中,外部策略先产生动作,世界模型再给出后续画面,然后策略读取新画面继续决策。离线质量评测中可一次提供整条未来动作轨迹,而互动时只需逐段输入可用动作;两种运行协议应区分。
3.2 输入、先验与泛化边界
项目 论文设定 不应推断为 观测 初始 RGB 场景与自回归历史;语言提供任务条件 直接拥有完整物理状态 动作 数值动作经运动学渲染为机器人运动图像 模型自行规划并选择动作 机器人资产 URDF、机器人结构、运动学和渲染器 无模型或无几何先验 相机 渲染视角与真实相机对齐;真实平台执行手眼标定 不需要相机参数和坐标关系 场景资产 不显式重建目标物体及背景的完整几何 已保证所有环境动力学精确 OOD 新外观、新物体实例、新位置与任务相关布局 新机器人、新任务或任意新物理机制均可零样本 输出 未来视觉观测 对象 R , t R,t R , t
它不是实例级 / 类别级物体位姿估计。真实 Novel instances 设置是同一功能类别内替换实例,不能直接写成未见类别泛化。论文也没有显式定义物体 pose 表示或对称姿态处理。
4. 研究脉络
4.1 从数值控制到像素对齐条件
原文讨论 Ctrl-World、IRASim、WorldEval、WorldGym 等动作条件世界模型:将关节或末端动作向量作为条件,让视频网络学习对应的运动和环境变化。
像素对齐路线则使用投影末端轨迹、骨架或机器人 mask / point cloud,降低动作到画面的映射难度。GeniWorld 使用稠密机器人渲染,强调较完整的几何结构有助于精细交互,而不是声称首次把几何条件送入视频生成器。
4.2 与相关路线的区别
路线 条件 / 输出特点 GeniWorld 的位置 数值动作世界模型 低维动作条件,生成未来观测 增加显式运动学与空间对应 EE / skeleton 控制 将少量点或骨架投影到图像 保留更稠密的机器人形状信息 URDF mask / point cloud 控制 提供机器人结构线索 强调渲染运动与视频 latent 的直接对齐 视频外观增强 固定动作轨迹上改变视觉外观 同时支持回放与交互产生新动作轨迹 Fast-WAM 当前观测到动作,部署省去未来生成 GeniWorld 的目标恰是生成动作造成的后果 Pose-VLA 以空间监督改善动作策略 GeniWorld 用已知机器人运动作为视频生成条件
这些路线之间有互补关系,但不能直接把它们的 FVD、策略成功率或推理延迟放到同一排行榜。
5. 研究动机
数值动作缺少显式图像位置。为了生成正确机器人运动,网络可能需要从固定场景中的相关性反推出相机、运动学和接触规律,容易依赖背景捷径。
作者提出将两部分解开:机器人运动由已知运动学产生,场景响应由视频模型学习 。这不是严格的因果可辨识性证明,而是一种结构化归纳偏置。它成立的重要假设是:当前操作视频的主要环境变化由机器人运动驱动,且运动学渲染足够准确。
原论文 Figure 1:URDF 运动渲染是输入接口,外部操作者或策略决定动作,模型产生交互画面。来源:作者官方项目页 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
6. 方法详解
6.1 数值动作到视觉动作
对给定机器人,动作序列经过 URDF 与正向运动学,得到目标相机视角下的机器人渲染序列 m t + 1 : t + H m_{t+1:t+H} m t + 1 : t + H
o t + 1 : t + H = W ( o t , m t + 1 : t + H ) . o_{t+1:t+H}=\mathcal W(o_t,m_{t+1:t+H}). o t + 1 : t + H = W ( o t , m t + 1 : t + H ) . 渲染只提供机器人结构和运动,不提供被操作物体及背景外观。因此它预先解决了一部分“机器人怎么动”,却没有直接提供“物体会怎样被推动、抓住或折叠”的答案。
我的几何解释 :为了使渲染机器人和观测像素对齐,关节状态到机器人表面、机器人到相机的变换、相机投影必须一致。这里的相机参数不是估计目标,而是条件接口的外部依赖。若策略输出的是末端动作而非关节状态,还要明确到可渲染机器人状态的转换;论文未给出所有控制接口的细节。
6.2 同一个 VAE,沿通道拼接
动作渲染与真实观测由相同的因果 3D VAE 编码:
z a , z v ∈ R C × L × H ′ × W ′ , z = [ z v ; z a ] ∈ R 2 C × L × H ′ × W ′ . z_a,z_v\in\mathbb R^{C\times L\times H'\times W'},
\qquad z=[z_v;z_a]\in\mathbb R^{2C\times L\times H'\times W'}. z a , z v ∈ R C × L × H ′ × W ′ , z = [ z v ; z a ] ∈ R 2 C × L × H ′ × W ′ . 其中 L L L H ′ , W ′ H',W' H ′ , W ′ 通道拼接 。它不是把动作和视频当作两段独立序列首尾连接;同一时空位置的两种信息在通道维度直接对应。
附录具体设置为 C = 48 C=48 C = 48 0.1 × 0.1\times 0.1 ×
这样保留原视频生成通路,并以较小初始幅度注入动作条件。架构改动较小不等于训练全部只更新新增输入层;论文没有给出足够的冻结范围细节,不能自行假定为 adapter-only 训练。
原论文 Figure 2:训练学习观测流场,推理将动作连续转换为渲染条件,并使用 KV cache 保留历史。来源:作者官方项目页 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
6.3 Flow matching:只对观测加噪
设 z t + 1 z_{t+1} z t + 1 s ∈ [ 0 , 1 ] s\in[0,1] s ∈ [ 0 , 1 ] ϵ ∼ N ( 0 , I ) \epsilon\sim\mathcal N(0,I) ϵ ∼ N ( 0 , I )
z t + 1 ( s ) = ( 1 − s ) ϵ + s z t + 1 , z ˙ t + 1 ( s ) = z t + 1 − ϵ , z_{t+1}^{(s)}=(1-s)\epsilon+s z_{t+1},
\qquad
\dot z_{t+1}^{(s)}=z_{t+1}-\epsilon, z t + 1 ( s ) = ( 1 − s ) ϵ + s z t + 1 , z ˙ t + 1 ( s ) = z t + 1 − ϵ , L = E [ ∥ v θ ( z t + 1 ( s ) , s , z ≤ t ∣ z a , t + 1 , c ) − ( z t + 1 − ϵ ) ∥ 2 2 ] . \mathcal L=\mathbb E\left[
\left\|v_\theta\left(z_{t+1}^{(s)},s,z_{\leq t}\mid z_{a,t+1},c\right)
-(z_{t+1}-\epsilon)\right\|_2^2
\right]. L = E [ v θ ( z t + 1 ( s ) , s , z ≤ t ∣ z a , t + 1 , c ) − ( z t + 1 − ϵ ) 2 2 ] . z ≤ t z_{\leq t} z ≤ t z a , t + 1 z_{a,t+1} z a , t + 1 c c c 只有观测 latent 被加噪并作为预测目标;视觉动作 latent 始终是干净条件。 这与同时生成未来视频和动作的 WAM 联合目标不同。
这里 s = 0 s=0 s = 0 s = 1 s=1 s = 1
6.4 因果历史与生成反馈
模型开始用真实历史训练,随后将自身预测加入观测上下文,以减少 exposure bias。原文引用 Self Forcing,但没有完整给出阶段切换时间、生成历史占比及梯度策略,不能把引用等同于完全相同的训练实现。
推理采用 块间因果、当前新块内完整注意力 :缓存之前 tokens 的 key/value,生成新块时读取历史。虽然正文有“只能关注先前 tokens”的概括,推理小节明确允许新块内部 self-attention,理解时不能误写成所有像素 tokens 严格逐个串行生成。
121 个原始视频帧经 VAE 压缩成 31 个 latent 帧;首帧单独作为一个 block,后续每次生成 3 个 latent 帧。这里的 latent block、物理动作步和解码视频帧是三个时间粒度,不应混用。
6.5 训练和推理参数
根据附录 A / Table II 本站整理 :
参数 设置 骨干 Wan2.2-TI2V-5B 目标 自回归因果 flow matching 输入通道 视频 48 + 动作 48,共 96 学习率 10 − 5 10^{-5} 1 0 − 5 Global batch size 4 训练硬件 4 张 NVIDIA H20 噪声时间步配置 1000;noise schedule shift 5.0 颜色增强 对 GT 视频及初始帧以 p = 0.5 p=0.5 p = 0.5 输出分辨率 480 × 640 480\times640 480 × 640 时间布局 121 pixel frames / 31 latent frames;每新块 3 个 latent 帧 CFG scale 3.0 比较的采样步数 50、10、5
1000 是噪声过程配置,不是每次推理必须执行 1000 次网络前向。论文没有完整列出总训练步数、优化器细节、精度模式和峰值显存,不能用硬件数推断训练总成本。
6.6 两种交互用途
策略评测 :将待测策略的动作渲染后输入世界模型;模型输出的画面成为策略的下一观测。世界模型不仅要生成成功演示,也应忠实表现策略的错误动作,否则会高估策略能力。
数据生产 :用图像编辑模型改变初始画面,再回放动作或由人类遥操作生成新轨迹。图像编辑器负责起始场景,不负责独立生成每一帧交互;时间一致性与动作响应由 GeniWorld 承担。
真实系统把 Xtrainer URDF 接入 Isaac Sim,并进行手眼标定和相机视角匹配。这里借助仿真器控制和渲染机器人,并非为所有物体建立了可信的物理仿真模型。
7. 实验分析
7.1 三类实验回答不同问题
实验 数据 / 流程 评价对象 世界模型质量 RoboTwin 2.0:50 任务,2250 Clean 训练轨迹,250 Clean / 250 Random 测试轨迹 按给定动作生成的视频 策略评测可靠性 相同 π 0 \pi_0 π 0 两种环境下的成功率关系 数据增强价值 每任务 25 条真实示教,加不同合成轨迹,再训练策略并真实测试 下游策略的最终任务成功率
世界模型 OOD 评测每条序列 121 帧、24 fps,输入初始观测、语言和未来动作。Random 包含外观、实例、物体位置与任务相关布局变化,测试无需适配;“零样本”在此指目标分布没有额外适配,不是世界模型从未见过机器人操作数据。
真实四任务为 Move Bowl、Fold Towel、Place Mug、Open Drawer。收集真实训练数据时桌面保持干净,仅随机改变目标物体姿态。每任务 25 条示教在文中明确用于下游策略训练,不能据此断言真实世界模型的全部训练量也恰为 25 条。
7.2 指标及 FVD 口径提醒
指标 方向 反映什么 / 缺什么 PSNR 高好 像素误差;不能直接度量任务是否完成 SSIM 高好 图像结构相似性;不是接触动力学验证 LPIPS 低好 感知距离,附录使用 AlexNet backbone FID 低好 帧级分布差异,附录使用 Inception-v3 FVD 低好 论文报告的视频级距离,具体提取器和聚合方式需核对 EWMScore 高好 按 WorldArena 协议报告的世界模型分数,不是百分比成功率 真实任务 success rate 高好 完整任务是否满足 Done 条件
复现警告 :附录 B 将其 FVD 描述为对 Inception-v3 特征做时间均值和标准差拼接后计算 Fréchet distance。这一具体描述必须与待发布代码核对,不能只看到指标名称和引用就假定与其他论文完全同实现。本页原样保留论文的 FVD 标签和数值,只做本文同协议内比较。
此外,指标好看仍可能遗漏动作响应错误或物理不合理性。配对 PSNR / LPIPS、分布指标以及真实下游测试应合起来理解,不能以单个视频质量分数代替行为评估。
7.3 主结果:Clean-to-Clean
下表由原文 Table I 本站整理 ,保留论文数值精度。
方法 / 动作条件 LPIPS PSNR SSIM FID FVD EWMScore Ctrl-World 0.165 18.65 0.879 9.62 15.52 58.74 IRASim 0.323 13.26 0.801 42.98 48.98 48.83 EnerVerse-AC 0.378 10.89 0.780 40.35 54.28 52.92 同骨干 + numerical actions 0.3773 11.59 0.7836 42.69 48.03 57.69 同骨干 + EE trajectory 0.1848 17.17 0.8632 12.19 18.35 60.00 同骨干 + skeleton 0.1801 17.38 0.8609 12.49 18.82 60.04 ControlNet-style conditioning 0.094 23.99 0.927 8.82 12.36 59.26 GeniWorld visual actions 0.055 27.57 0.942 5.59 7.59 61.80
7.4 主结果:Clean-to-Random
同样来自 Table I,本站整理 。所有方法使用相同训练划分,OOD 不微调;同划分不意味着所有外部模型的骨干、参数量和计算预算完全一致。
方法 / 动作条件 LPIPS PSNR SSIM FID FVD EWMScore Ctrl-World 0.285 20.41 0.791 21.66 35.85 51.47 IRASim 0.766 8.15 0.476 174.52 191.26 46.41 EnerVerse-AC 0.751 12.25 0.433 74.55 99.14 31.28 同骨干 + numerical actions 0.3659 13.74 0.6961 40.91 53.69 51.49 同骨干 + EE trajectory 0.3000 14.17 0.7158 37.69 45.89 61.36 同骨干 + skeleton 0.2568 18.48 0.7956 31.78 39.88 61.61 ControlNet-style conditioning 0.416 14.51 0.625 40.02 59.95 56.13 GeniWorld visual actions 0.144 22.71 0.873 13.08 20.15 63.54
GeniWorld 在表中两个设置的六项指标均占优;相对 Ctrl-World,OOD FVD 从 35.85 降至 20.15。但这里的结论范围是本文这些模型、数据和协议,不能直接写成当前所有世界模型的通用 SOTA。
7.5 消融与定性证据
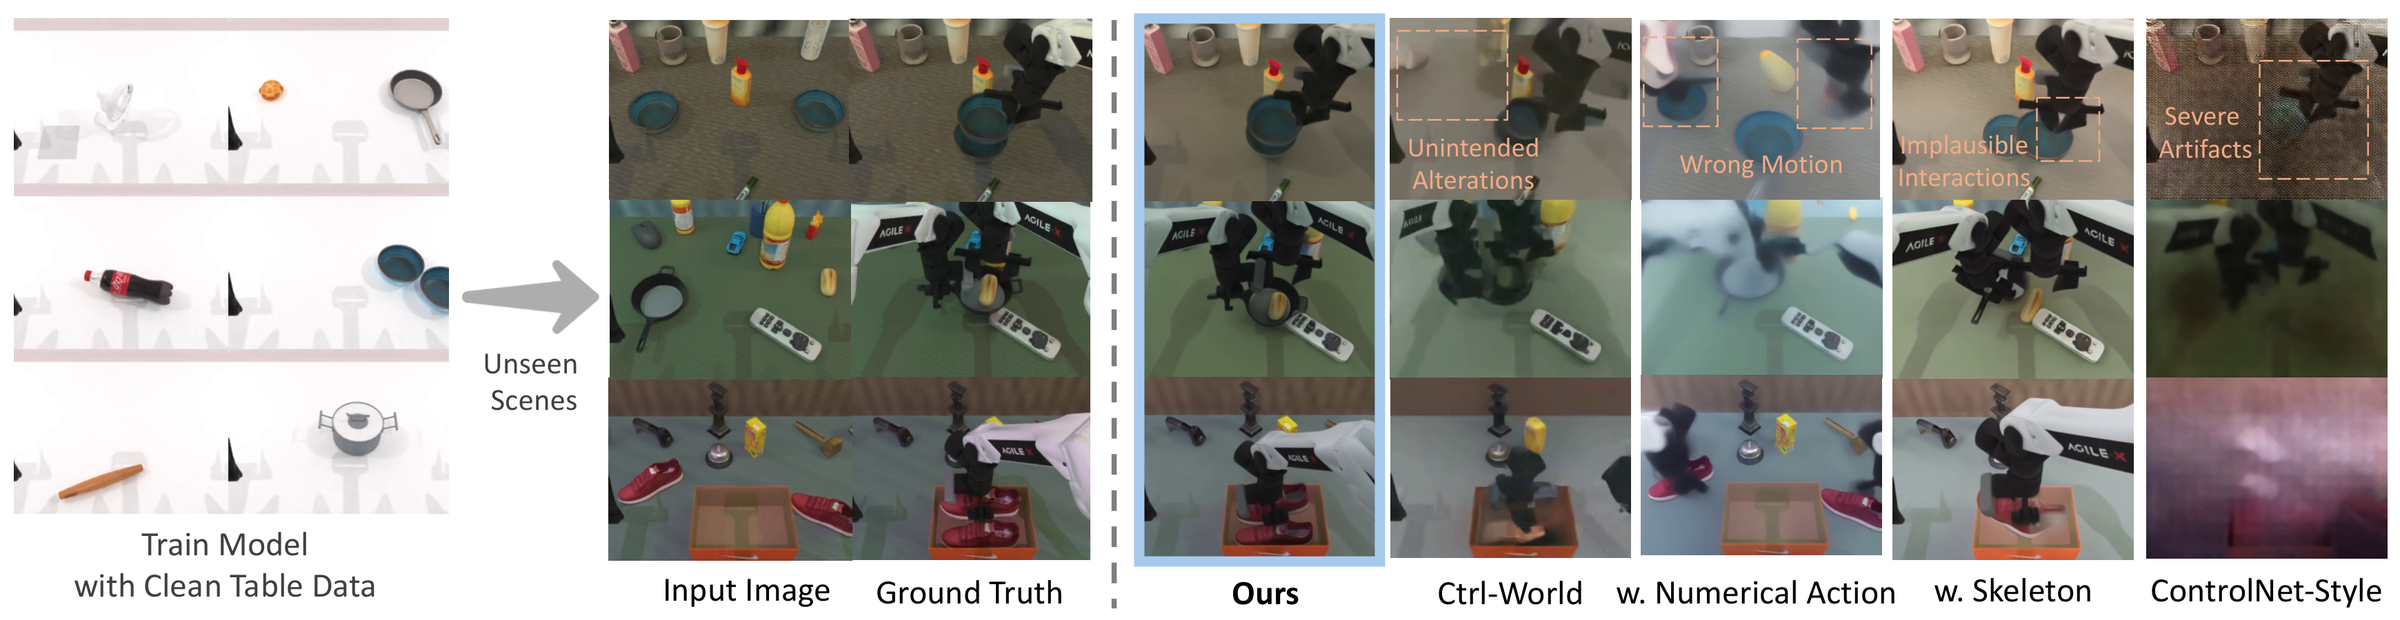
对照 证据 我的判断 数值动作换成视觉动作 OOD FVD 53.69 → 20.15 支持显式空间条件的价值 EE / skeleton 换成稠密渲染 OOD FVD 45.89 / 39.88 → 20.15 支持更完整结构有帮助,但不同表示携带的信息量不同 ControlNet-style 换成直接拼接 OOD FVD 59.95 → 20.15 在该配方下更有效,不证明所有 ControlNet 实现都较差 比较训练收敛 Figure 4 的 1 − L P I P S 1-\mathrm{LPIPS} 1 − LPIPS 支持更快收敛;仍缺完整 GPU 时成本对照 50 / 10 / 5 步采样 Figure 5;作者报告约 10 倍加速、FVD 约 2% 退化 采样更省,但不是任意分辨率、硬件下的端到端加速保证
原论文 Figure 3:蓝框为 GeniWorld;其他列展示作者选择的动作及交互失败例。它是定性对照,不能单凭这些案例推断完整失败频率。来源:作者官方项目页 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
作者报告数值动作在少步采样下的 FVD 退化约 22%,而视觉动作约 2%。这是生成质量相对于各自采样设置的变化,不是机器人成功率下降 2 个百分点。5 步、H20 上约 8 Hz 是交互推理速率;其与每块 latent 数、VAE 解码及底层机器人控制如何对齐,仍需代码和性能分解说明。
7.6 作为策略评测器:支持到什么程度
作者使用同一 π 0 \pi_0 π 0
我的分析 :这提供了有用的可行性证据,但目前不足以宣称“替代真实评测”。应进一步关注预测误差、系统性高估、策略排序相关、失败动作的忠实再现,以及对未参与模型选择的新策略能否保持校准。本文文字没有完整列出相关系数、置信区间和所有检查点对应的逐项数据,本页不编造这些数值。
7.7 合成数据提升真实策略
三种完整可核对的数据方案如下,每个任务单独统计:
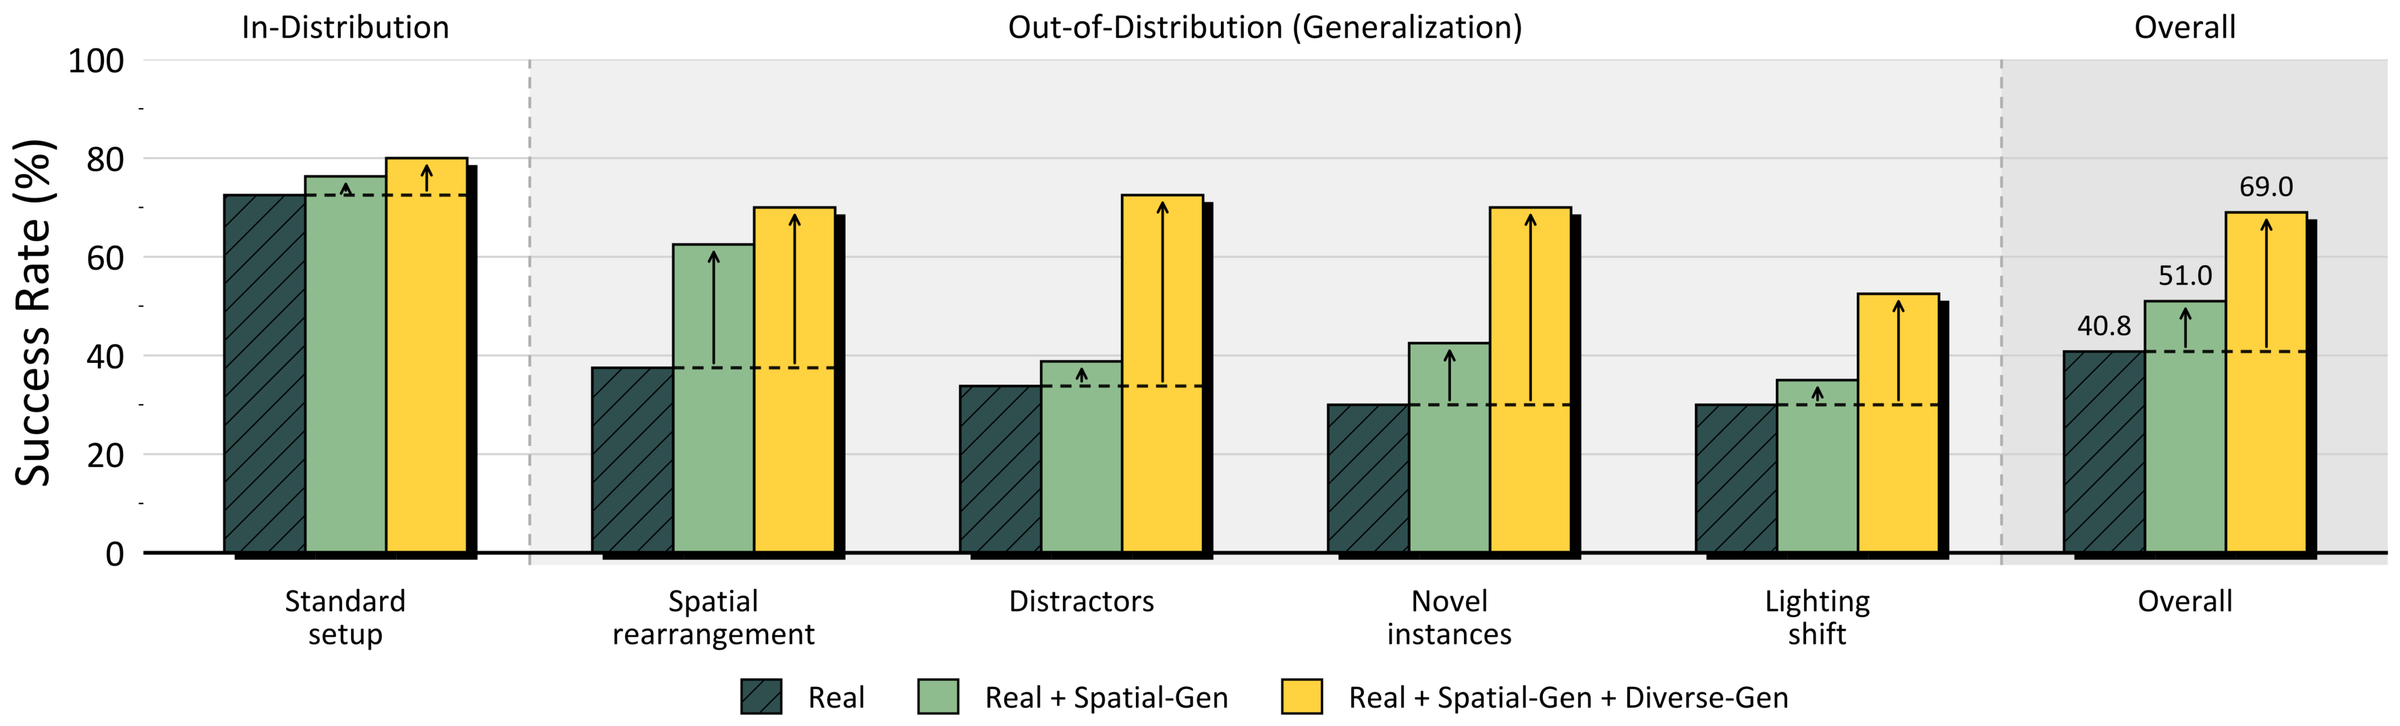
方案 真实轨迹 空间随机化合成 场景多样化合成 合计 Real 25 0 0 25 Real + Spatial-Gen 25 65 0 90 Real + Spatial-Gen + Diverse-Gen 25 65 65 155
Spatial-Gen 重点扩大目标位置覆盖;Diverse-Gen 包含更多场景、实例等变化。图像编辑器生成初始帧,回放或遥操作提供动作。所有策略从同一个公开 π 0 \pi_0 π 0 不要与世界模型每块 3 个 latent 帧混为一谈 。
根据 Table III 均值 本站整理 ,单位 %:
方案 Standard Spatial Distractors Novel inst. Lighting Overall Real 72.5 37.5 33.8 30.0 30.0 40.8 + Spatial-Gen 76.3 62.5 38.8 42.5 35.0 51.0 + Spatial-Gen + Diverse-Gen 80.0 70.0 72.5 70.0 52.5 69.0
原论文 Figure 9:完整增强方案的 Overall 为 69.0%,对应五种评测设置的平均,不是仅 OOD 平均。来源:作者官方项目页 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
每种方案在 4 任务 × 5 设置 × 20 次 = 400 次真实试验 中评估,每次重置环境。Mean 对四任务取平均,Overall 再对五设置平均。由显示值计算,总体提高 28.2 个百分点,光照设置仍只有 52.5%,可见泛化问题并未消失。
再看 Table III 的逐任务 Overall,避免平均数掩盖任务差异:
任务 Real + Spatial-Gen 再 + Diverse-Gen Move Bowl 53 63 83 Fold Towel 32 42 59 Place Mug 43 54 73 Open Drawer 35 45 61
原表中 Fold Towel 的 Standard 在 Spatial-Gen 方案为 70%,完整方案为 65%,因此“完整方案总体最好”不意味着每一个任务和设置都单调改善。每格只有 20 次试验,单次成败就是 5 个百分点,论文未充分报告跨训练随机种子的方差。
原文分组不一致提醒 :正文先写 four data regimes,却只编号列出三项;后文又引用单独 Diverse-Gen 的比较值。Figure 9 与附录 Table III 完整展示的是上面的三方案。因此本页以三方案完整表为主,不补造缺失的 Diverse-Gen 单独分组或每任务数据。
7.8 成功标准与失败分析
Table IV 的 Done 标准由本站摘要整理如下:
任务 完整成功需要满足 Move Bowl 将碗稳定放在指定目标位置 Fold Towel 完成上到下、右到左的两阶段折叠 Place Mug 通过杯柄抓取并将杯子稳定放在目标区域 Open Drawer 打开抽屉、放入 marker,并最终关闭抽屉
Table IV 的 Progress 是成功演示中阶段完成的平均归一化时间位置,不是阶段成功率 。例如 Open Drawer 不只是把抽屉拉开;只完成前段不应算成功。
定性结果覆盖新实例、背景、干扰和光照变化,但缺少按遮挡程度、反光 / 透明材质、相机标定偏差、滑动摩擦或外力干扰的系统失败分层。世界模型中的“看起来抓住了”仍可能是无接触或不合理动力学,需要独立行为证据验证。
8. 批判性分析
8.1 贡献与证据对应
作者主张 对应实验 我的判断 视觉动作改善生成和 OOD 泛化 Table I + Figure 3 + 同骨干条件消融 证据较充分,限于给定场景划分 更有效利用预训练先验 收敛曲线和少步采样 与主张一致,但缺直接表征探针 可作为稳健策略评测器 Figure 7 的真实 / 生成成功率关系 可行性支持,尚需更广的新策略校准 生成数据改善真实策略 Table III,每方案 400 次真实测试 有直接下游证据,但数量、多样性和采集成本尚未完全拆分 可广泛应用不同机器人 运动学条件接口及现有平台实验 不足以证明任意 embodiment 零样本迁移
8.2 优点
利用已知机器人运动学,不让模型从有限场景里重新学习全部几何映射;动作与视频的像素对齐也适合视频骨干原有表征。实验从视频质量走到真实机器人行为,数据增强效果比纯生成展示更有说服力。
8.3 限制与隐含假设
运动学不等于动力学。 URDF 渲染准确描述机器人占据哪里,但接触力、摩擦、柔性变形和物体响应仍由生成模型近似,缺少守恒和接触求解的硬约束。
标定精度是隐藏的成本。 方法的空间对齐依赖真实 / 渲染相机及机器人状态一致;未测相机安装变化和标定误差,不能假定该接口天然鲁棒。
数据增加与表示质量没有完全分离。 25 条真实轨迹变成 155 条混合轨迹,收益同时可能来自数据数量、新场景、新动作和人工闭环修正。缺少相同预算增加真实示教、重复采样或其他合成方法的充分对照。
交互合成仍有人工和外部模型成本。 新行为由操作者参与生成,场景编辑借助额外图像模型;质量过滤、失败保留比例和总操作时长未完整报告。不能把“不搭建新物理场景”写成“零人工成本”。
评测器可能掩盖坏动作。 如果生成先验把不合理动作修饰成合理交互,策略会被高估;如果后续用该模型优化策略,还要防止策略利用模型漏洞。论文当前相关性实验没有完全排除这些风险。
9. 复现与待核实项
官方项目页提供演示和图片,但代码标为 Coming soon。以下是按论文组织的复现检查清单,不是已运行成功的操作指南:
获取模型实现、checkpoint、动作渲染代码及具体 URDF;先核对相机内外参、手眼变换、关节顺序、角度单位和时间戳。
验证同一时刻的视觉动作与观测像素对齐,确认条件不包含目标物体或未来场景的额外信息。
实现 48+48 通道输入与指定权重初始化,并区分干净动作条件和带噪观测。
核对块间因果 mask、块内 attention、VAE 历史状态、KV cache 长度及生成历史训练策略。
固定 2250 Clean 训练与两个 250 测试划分,核对视频采样、预处理和所有指标实现,尤其 FVD 与 EWMScore。
将视频质量、策略评测校准和真实策略提升分开复现;记录人工判定规则、生成失败样本、策略训练种子及真实试验数。
仍未在论文中充分明确的内容包括:真实世界模型训练集的完整规模、总训练时长、优化器与冻结参数范围、自生成历史的调度、相机失配容忍度、合成数据筛选成本、交互 8 Hz 的计时边界以及策略评测的完整相关性统计。
10. 未来工作与研究启发
原文结论强调可泛化想象环境对机器人学习的潜力,没有给出完整后续路线。以下为我的研究建议 :
几何一致性审计 :用物体 pose、接触关系或多视角约束检查生成视频,识别无接触抓取、穿透和对象凭空变化。不确定性条件 :为相机参数、关节状态或机器人轮廓加入可控扰动,研究真实标定误差下的模型可靠性。评测器校准 :保留失败与错误动作,按策略而非仅按任务划分测试集,报告排序相关性及成功率预测误差。拆分数据收益来源 :固定样本数比较新背景、新位置、新实例和新动作,再加入相同人时采集的真实数据基线。扩展交互边界 :测试外力、接触模式变化、长程遮挡和跨机器人迁移,而不只测试视觉分布变化。
对 6D 研究最直接的启发是:几何不仅能作为最终估计量,也能把机器人动作转换成生成模型易于使用的空间条件。但由几何约束生成器,和从图像恢复未知几何,是两个不同问题。
11. 总结
GeniWorld 的价值在于通过 URDF 稠密运动渲染,把动作控制转化为像素对齐的视频条件,并以闭环生成支持评测与真实策略数据增强。Table I 和 Table III 对生成质量与下游收益提供了较清晰证据;对接触物理、评测校准、跨机器人泛化和端到端成本,则应保留边界,不把逼真视频等同于可靠物理模拟器。