论文精读笔记:JENGA
1. 核心判断
标准 6D pose benchmark 默认“所有正确 pose 都有价值”,JENGA 认为堆叠抓取不是这样:一个底层砖块即使 pose 完全正确,也可能被其他砖压住;机械手贸然执行会碰撞或破坏整垛稳定性。因此任务应写成:
G = F ( Π , I , M , α s ) , G=F(\Pi,I,M,\alpha_s), G = F ( Π , I , M , α s ) , 其中 Π \Pi Π G ⊆ Π G\subseteq\Pi G ⊆ Π I I I M M M α s \alpha_s α s
论文的核心并不是新 pose network,而是两个可解释的 candidate filters 与一个同时检查 graspability label / pose error 的评价协议。YOLOv8 和 ZebraPose 都可以替换。
2. 完整输入、输出与系统边界
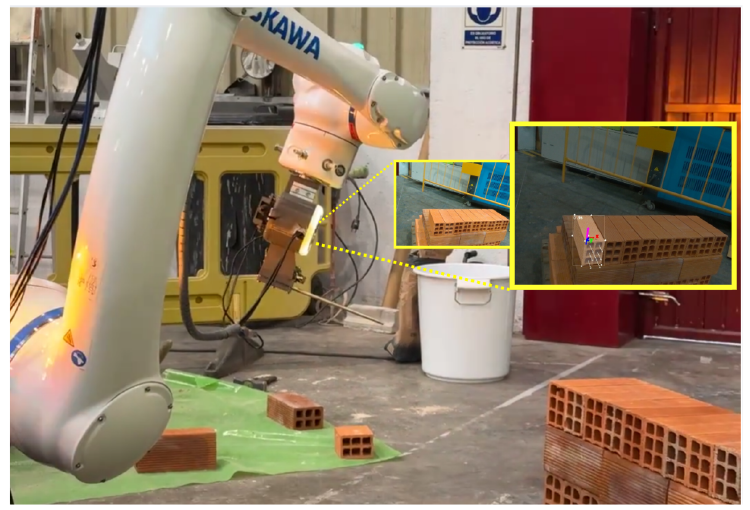
原论文 Figure 1。真实平台是 Yaskawa HC20DTP、双叉 gripper 与法兰上的 RealSense D435i;正文只说明部署和视频演示,没有给出真实抓取统计。来源:作者公开稿 ;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
需要:
known brick instance 与 metric CAD;
YOLOv8 detector;
为该砖训练的 RGB-only ZebraPose;
camera intrinsics;
camera–IMU rigid transform T s c T_{sc} T sc
相机静止或近似无额外线加速度时的 IMU gravity measurement;
pose-based renderer,用于 amodal silhouette;
top-k k k
不需要:
RGB-D depth 输入;
IMU angular velocity;
SLAM / VIO 给出的完整 world pose;
learned grasp network。
虽然 D435i 是 RGB-D 相机、合成数据也保存 depth,方法公式没有使用 depth。专题页将其归为 RGB + IMU + CAD,而不是 RGB-D pose。
3. Pose hypotheses 的生成
YOLOv8 输出每块砖的 bounding box。每个 crop 进入 ZebraPose:
将 CAD surface points 编成 coarse-to-fine binary codes;
网络预测 object pixels 的 surface codes 和 segmentation;
codes 建立 2D pixel–3D model correspondences;
PnP 恢复 T c o i = [ R c o i , o c i ] T^i_{co}=[R^i_{co},o^i_c] T co i = [ R co i , o c i ]
所有结果形成
Π = { T c o 1 , … , T c o n } . \Pi=\{T^1_{co},\ldots,T^n_{co}\}. Π = { T co 1 , … , T co n } . JENGA 不修改 ZebraPose,也不重新优化 pose;若 detector 漏检、mask 串实例或 PnP 落到错误对称解,后端只能筛选,不能修正。
4. 视觉可见性筛选
对于每个估计 pose:
amodal mask M a i M_a^i M a i T c o i T^i_{co} T co i
modal mask M m i M_m^i M m i
定义
r i = ∣ M m i ∣ ∣ M a i ∣ . r_i=\frac{|M_m^i|}{|M_a^i|}. r i = ∣ M a i ∣ ∣ M m i ∣ . 若 r i < ϵ v i s r_i<\epsilon_{\mathrm{vis}} r i < ϵ vis ϵ v i s = 0.80 \epsilon_{\mathrm{vis}}=0.80 ϵ vis = 0.80
优点是可解释:同一个 pose 同时给“理想完整投影”和“实际可见区域”,无需额外 graspability network。风险也很直接:
amodal mask 来自 预测 pose ,pose 错会改变分母;
modal mask 来自 pose estimator,强遮挡时可能漏分或把相邻同类砖合并;
80% 阈值只在合成验证,没有 sensitivity curve;
visibility 高不等于 gripper 两侧有接近空间。
所以该 ratio 更像 pose-conditioned confidence heuristic,而不是独立的物理可抓性测量。
5. IMU 重力高度筛选
对象位置先从 camera frame 转到 sensor frame:
o s i = T s c i o c i . o_s^i=T_{sc}^i o_c^i. o s i = T sc i o c i . IMU 静止时测得
α s = R s g g g l o b a l . \alpha_s=R_{sg}g_{\mathrm{global}}. α s = R s g g global . 作者只需沿 gravity axis 的相对排序,用
o g , z i = α s ⊤ o s i o_{g,z}^i=\alpha_s^\top o_s^i o g , z i = α s ⊤ o s i 为候选打分,再保留最高 top-k k k G h G_h G h α s \alpha_s α s
最终通常先 height filtering,再 visibility filtering:
G = F v ( F h ( Π , I , M , α s ) ) . G=F_v(F_h(\Pi,I,M,\alpha_s)). G = F v ( F h ( Π , I , M , α s )) . 先取 top-k k k
6. 合成数据集
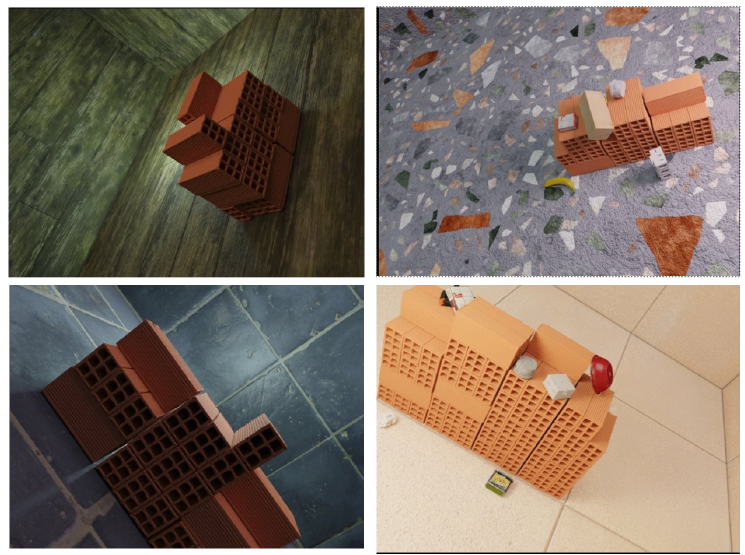
原论文 Figure 3:BlenderProc 生成多种砖垛 topology、camera pose、light、floor / wall texture,并在部分场景加入 clutter objects。来源:作者公开稿 ;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
数据以 scanned brick model 为基础,构造 3×3 units,再程序化形成 regular / irregular stacks。相机从以 stack center 为中心的球壳采样。输出:
RGB;
depth;
modal / amodal masks;
6DoF pose;
binary graspability label;
BOP 与 COCO 格式。
总计 12K images,划分 10K / 1K / 1K。论文没有列出每图砖块数量分布、stack topology 数量、train/test 是否按 topology 隔离、相机半径、照明参数,也没有真实训练 / 合成测试的 domain-gap 分析。
7. Graspability ground truth 是几何启发式
每块砖用 transform 后的八个 model corners 构造 bounding box,以所有中心建立 KD-tree。对当前砖,在 ± X , ± Y , ± Z \pm X,\pm Y,\pm Z ± X , ± Y , ± Z
至少四个方向无邻居 → graspable;
恰好三个方向无邻居时,还要求 + Z +Z + Z
这提供可自动生成的大规模标签,但不等价于真实抓取:
axis-aligned / principal-direction box 近似不刻画砖孔和局部几何;
不考虑 friction、mass、center of gravity;
不考虑 gripper finger thickness、approach direction 和 collision;
不模拟抽出一块后的 stack dynamics;
label 是“周围空且顶部可达”,不是经过 physics simulation 验证的 grasp success。
还有一个文档一致性问题:正文描述了“恰好三个方向”的额外规则,但 Algorithm 1 的伪代码只出现 m ≥ 4 m\ge4 m ≥ 4
8. 联合评价协议
对预测候选 G G G θ \theta θ
P r e c i s i o n = T P T P + F P , A P e = 1 ∣ Θ e ∣ ∑ θ ∈ Θ e P r e c i s i o n ( θ ) . \mathrm{Precision}=
\frac{TP}{TP+FP},
\qquad
AP_e=
\frac{1}{|\Theta_e|}
\sum_{\theta\in\Theta_e}
\mathrm{Precision}(\theta). Precision = T P + F P T P , A P e = ∣ Θ e ∣ 1 θ ∈ Θ e ∑ Precision ( θ ) . 最后将 A P A D D − S AP_{\mathrm{ADD-S}} A P ADD − S A P M S S D AP_{\mathrm{MSSD}} A P MSSD
它与标准 detection AP 不同:
没有按 confidence sweep 得到 precision–recall curve;
是对多个 pose-error thresholds 的 precision 平均;
不报告 recall;
top-k k k
只选择一个“最容易”的砖能取得高分,即使同一垛还有多个可抓砖未返回。
因此结果衡量“返回的少量候选有多可信”,而不是“找全所有可抓对象”或“整垛清空效率”。
9. 主结果与消融
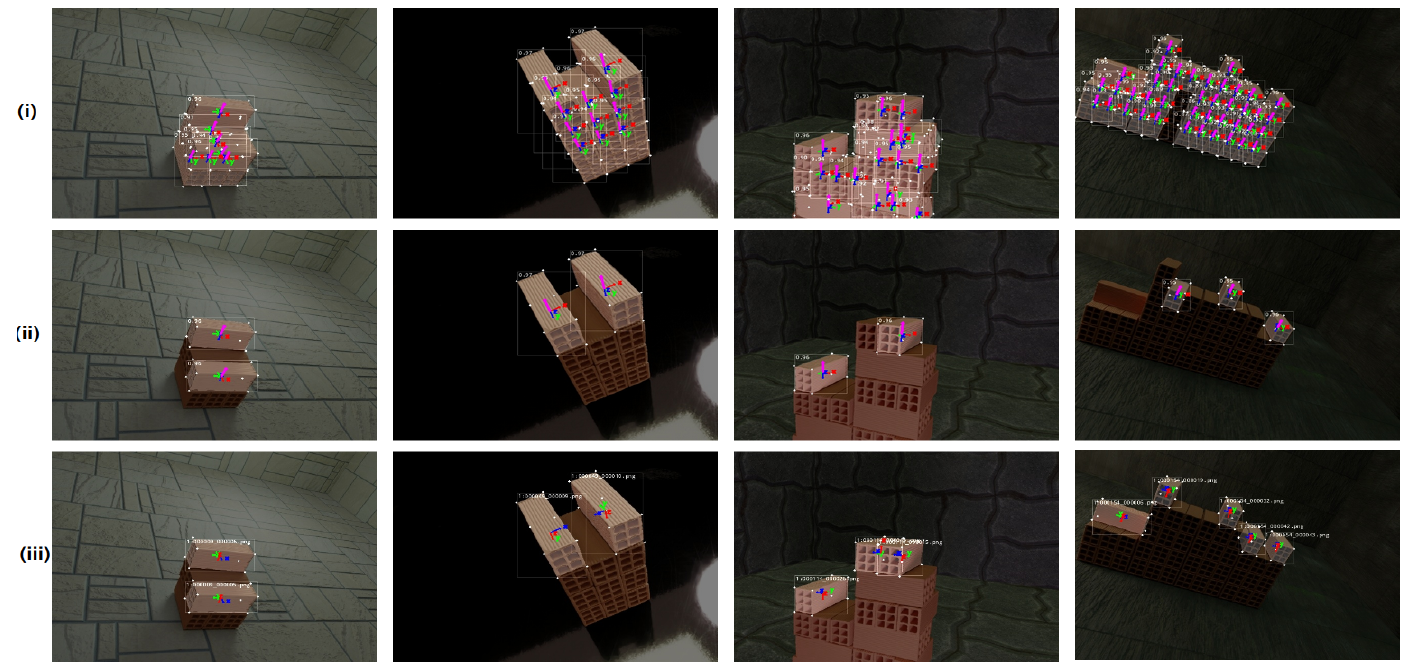
原论文 Figure 4:每列从上到下为全部 pose hypotheses、JENGA 筛选结果和 GT graspable poses。筛选显著减少底层 / 遮挡候选,但仍存在数量与姿态差异。来源:作者公开稿 ;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
输出集合 APADD-S ↑ APMSSD ↑ mAP ↑ all poses 0.19 0.16 0.17 top-1 0.84 0.74 0.79 top-2 0.74 0.66 0.70 top-3 0.68 0.62 0.65
all poses 的低 precision 说明“pose estimator 返回结果”不等于“适合抓的结果”。但 top-1 与 all poses 的输出数量差异很大,这不是单纯算法精度的公平一对一比较。最稳妥的结论是:系统能把最有把握的一块砖排到前面;对第二、第三候选的可靠性明显下降。
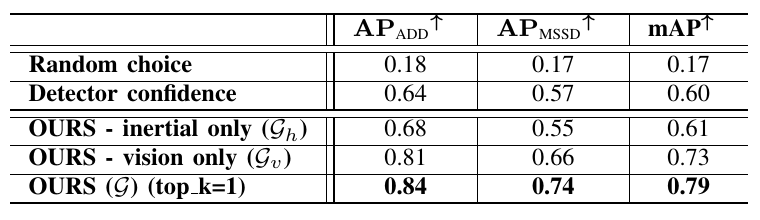
原论文 Table II。vision-only 已从 detector confidence 的 0.60 提升到 0.73;inertial-only 与 detector confidence 接近,组合后再提升 0.06。来源:作者公开稿 ;表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
策略 mAP ↑ Random choice 0.17 Detector confidence 0.60 Inertial only 0.61 Vision only 0.73 Vision + inertial 0.79
主要收益来自 visibility ratio;gravity height 是互补小增益。没有 confidence interval / multiple seeds,也未按规则垛、乱序垛、遮挡比例或 camera tilt 分桶。
10. 真实部署证据
硬件:
Yaskawa HC20DTP six-axis collaborative arm;
horizontal reach 1700 mm、vertical reach 3400 mm、payload 20 kg;
custom two-pronged gripper;
flange-mounted Intel RealSense D435i。
项目页给出真实砖垛与工地抓取视频。论文没有报告:
总抓取次数与 success rate;
selection mistake / pose failure / gripper failure 的拆分;
每次推理与机械动作时间;
抓取后 stack disturbance;
IMU 在运动中的滤波;
sim-to-real pose accuracy。
所以“真实部署”是系统可运行的定性证据,不是对 0.79 synthetic mAP 的现实验证。
11. 开放与复现
官方项目页当前可以访问,也嵌入视频。页面同时保留模板代码按钮 github.com/YOUR REPO HERE,并显示 “Code, Dataset and more details coming soon…”。截至 2026-07-31,尚不能核验可下载的 JENGA dataset 或方法 code。
复现还需作者补充:
YOLOv8 / ZebraPose training config 和 synthetic-real augmentation;
camera–IMU calibration;
gravity normalization / motion rejection;
top-k k k
amodal rendering 的 rasterization / clipping;
threshold sets Θ e \Theta_e Θ e
ground-truth Algorithm 1 与正文 exact-three rule 的一致实现;
real sequence、robot commands 和 grasp success annotations。
12. 局限
单一砖块类别和固定 CAD,不能证明一般 stacked objects;
12K 定量数据完全合成;
graspability GT 是 bounding-box neighbor heuristic,不是物理抓取;
标准化 mAP 命名容易与 detection AP / BOP AP 混淆;
只报告 precision,不报告 recall、coverage 或 throughput;
top-1 相对 all poses 的提升部分来自输出数量减少;
vision ratio 依赖已经正确的 pose 与 segmentation;
IMU height 假设传感器无额外线加速度;
没有 threshold、filter order 或 stack difficulty 敏感性;
真实机器人只有视频,无抓取成功率;
代码和数据仍未公开。
13. 最终评价
JENGA 的贡献是把一个很实际的决策层补到 pose pipeline 后面:在结构化堆叠中,机器人应该优先相信“高、可见”的 pose,而不是把所有检测结果等价地交给 grasp planner。modal / amodal ratio 与 gravity ranking 都很轻量,且消融说明可见性比 detector confidence 更适合排序。
它还没有建立完整的物理 grasp benchmark。更准确的定位是“pose-aware stacked-object candidate selection”:合成环境中能高精度返回一块最可信砖,真实机器人也能运行;至于能否找全可抓砖、长期安全清垛以及跨对象泛化,仍需开放数据、物理标签和大规模真实实验。