论文精读笔记:Joint-Loss Enhanced Self-Supervised Learning for Refinement-Coupled Object 6D Pose Estimation
1. 研究问题与结论
监督式实例级 6D pose estimation 通常需要真实 RGB-D 图像、已知 CAD / mesh,以及逐帧精确的 (R,t) 标签。模型和 RGB-D 相对容易取得,困难的是将真实图像与毫米级对象坐标系对齐。人工标注慢,机器人 / 相机标定误差又会直接成为训练标签噪声。
本文的目标是:不使用人工 6D annotated data,仍训练一个包含 initial estimation 与 refinement 的 RGB-D pose pipeline。 公开摘要给出的组件是:
- Iterative Annotation Resolver(IAR);
- pixelwise weighted dense fusion;
- differentiable renderer;
- joint loss;
- refinement-coupled training。
作者称精度接近监督方法。由于公开摘要没有数据集、指标或绝对数字,本页只能进行方法逻辑精读与证据审计,不能复原论文实验表。
2. 任务设定
输入是无 pose 标签的 RGB-D 观测:
Du={(Ii,Di)}i=1N.
输出是对象相对相机的刚体变换:
Tco=[R0⊤t1]∈SE(3).
根据摘要中 differentiable renderer 的使用,可以确认方法依赖可渲染的对象几何模型;根据 initial pose + refinement 的表述,它属于已知实例 pose pipeline,而不是 category-level shape generalization。
需要区分两个“无标注”概念:
- 无人工 6D pose annotation:本文明确解决;
- 完全无需任何先验 / 标签:本文并未声称。RGB-D、对象模型、相机条件以及 IAR 启动所需信息仍然构成监督来源。
3. Iterative Annotation Resolver 的作用
IAR 的高层功能是把无标注 RGB-D 数据转化为可用于训练初始 pose estimator 的监督信号。用抽象符号表示:
T^(k)=IAR(I,D,θ(k−1)),
θ(k)←argθminLpose(fθ(I,D),T^(k)).
这只是解释“迭代伪标注”的一般闭环,不是论文未公开公式。真正决定系统成败的是:
- 第一轮 pose 从哪里来;
- 哪些预测被接受为伪标签;
- 如何处理低置信度、遮挡和对称;
- 迭代何时停止;
- 是否避免同一模型自我强化错误。
公开摘要没有披露这些规则,因而当前不能把 IAR 等同于某个具体 teacher–student、ICP 或 multi-view label resolver。
4. Pixelwise weighted dense fusion
摘要明确说 initial estimator 基于“novel pixelwise weighted dense fusion architecture”。它的任务是把 RGB appearance 与 depth geometry 在逐像素层面结合,预测初始位姿。
从方法角色上看,这个模块至少要解决:
- 将 RGB feature 与对应深度点建立像素级关联;
- 对前景点、遮挡点、深度缺失和背景噪声分配不同权重;
- 聚合局部预测为对象级 (R,t)。
以上是 dense-fusion 架构通常必须完成的功能,不代表论文具体采用 DenseFusion 的数学形式。当前不能确认权重来自 attention、confidence head、深度有效性还是几何残差,也不能确认最终使用 voting、direct regression 或 correspondence solver。
5. Differentiable renderer 与 joint loss
得到 initial pose 后,方法使用 differentiable renderer 构造 refinement 的联合优化约束。一般的 render-and-compare 结构可写为:
I^r,D^r,M^r=R(M,T,K),
其中 M 是对象模型,K 是相机参数;渲染结果与真实 RGB-D / mask / geometry 的差异可为 pose refinement 提供梯度。
“joint loss”说明监督不只来自单一 photometric term,而是联合若干约束。但作者摘要没有列出分项,因此本页不会把常见的 RGB、depth、silhouette、point matching 或 pose consistency loss 写成本文事实。
高层耦合关系可以确认:
- initial estimator 给 refiner 提供起点;
- renderer 把当前 pose 变成可与观测比较的信号;
- joint loss 训练 refiner修正 pose;
- initial / refined pose 的质量共同影响自监督闭环。
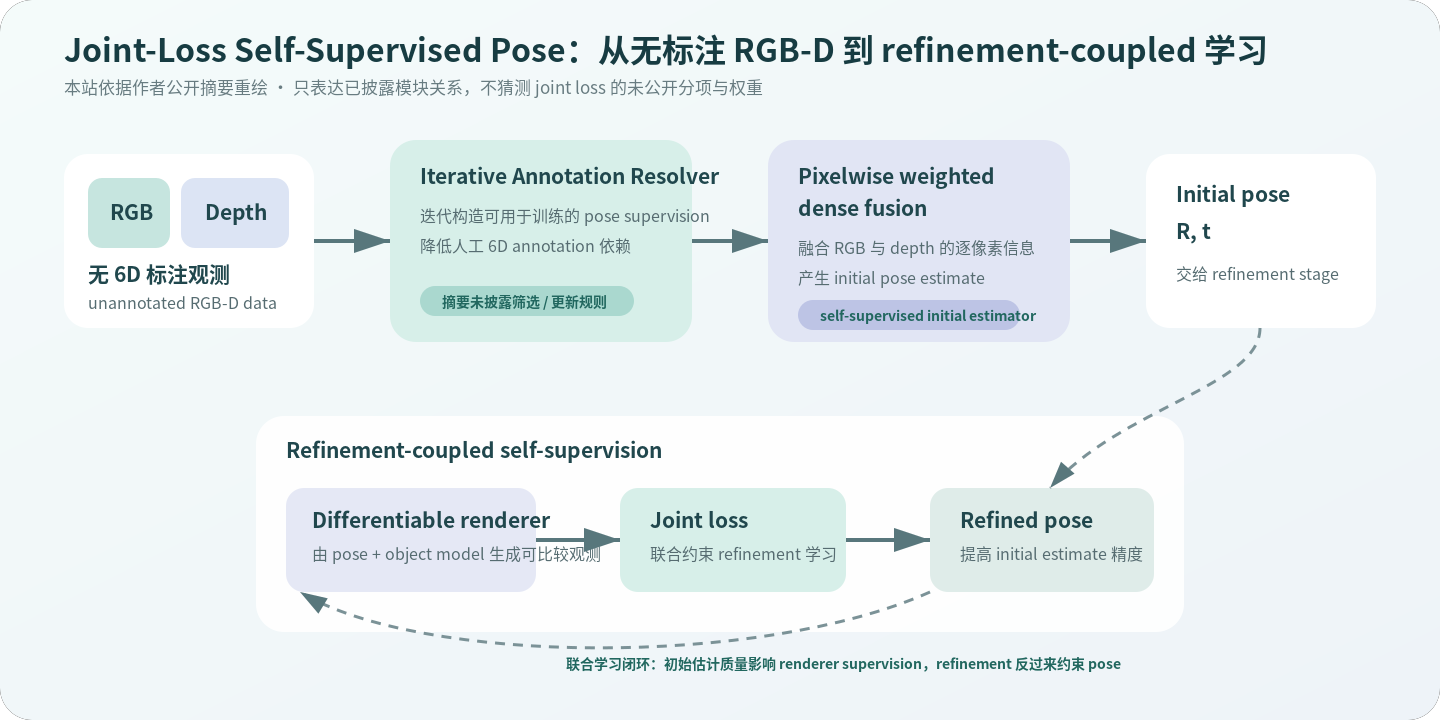 本站依据作者公开摘要重绘,非论文原图。IAR 筛选、renderer 输出和 joint-loss 分项均未在摘要披露,所以图中不添加猜测公式。论文内容版权归原作者,重绘用于学术解读。来源:Joint-Loss Self-Supervised Pose, ICRA 2024。
6. 为什么 refinement-coupled 比独立 refiner 更难?
传统 supervised pipeline 可以用真值 pose 人为扰动,得到大量“初始误差 → 正确修正”的训练对。自监督场景没有真值,refiner 看到的起点来自尚未成熟的 initial estimator。
这会产生三个耦合问题:
6.1 Basin of convergence
可微渲染损失通常只在当前 pose 接近真实 pose 时提供正确梯度。初始误差过大,轮廓、深度与颜色都不对应,梯度可能把对象推向错误局部最优。
6.2 Confirmation bias
IAR 生成的伪标签若错误,initial estimator 会复制错误;renderer 又围绕错误 pose 构造监督,使 refinement 进一步“解释”错误对齐。
6.3 Symmetry
对称对象存在等价姿态集合:
[R,t]∼[RS,t],S∈SM.
如果 loss 强迫模型逼近单一伪标签,即使渲染与观测一致,也可能产生不必要的旋转惩罚。joint constraints 是否 symmetry-aware 是复现时必须核验的关键。
7. 结果证据审计
作者摘要的完整结果层结论是:实验表明方法的 pose accuracy closely rivals supervised methods。
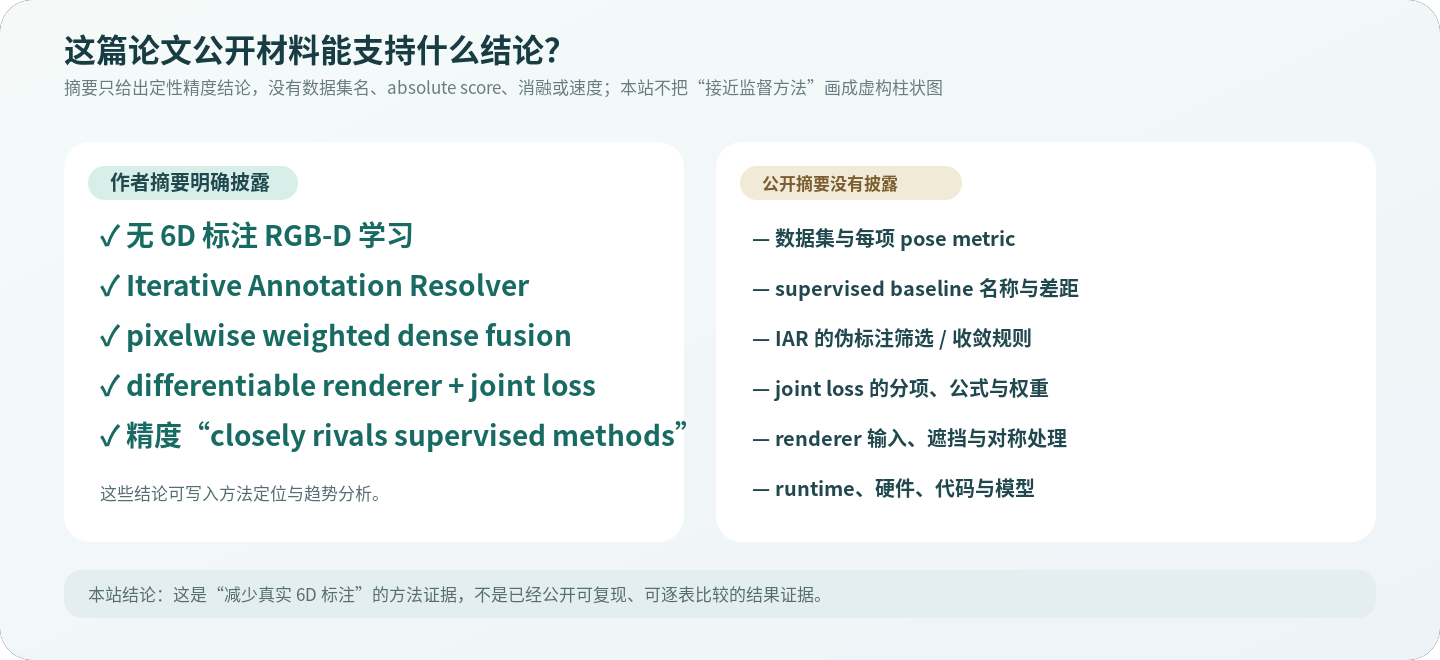 本站依据 DOI 元数据与作者公开摘要整理。没有公开数字时,不用示意柱高替代真实分数;本图展示的是证据覆盖度。来源:论文 DOI。
可以得出的结论
- 作者完成了一个无需人工 6D pose 标签的 RGB-D self-supervised pipeline;
- initial estimation 与 refinement 都被纳入方法;
- 实验中表现具有与监督方法比较的竞争力。
不能得出的结论
- 不能说“与监督方法相差 X%”;
- 不能说在哪个 benchmark 达到某项 SOTA;
- 不能判断提升主要来自 IAR、dense fusion 还是 joint loss;
- 不能判断对真实 / 合成、遮挡 / 非遮挡、对称 / 非对称对象的分别效果;
- 不能评估训练成本是否真正低于人工标注方案。
8. 与相邻自监督路线的比较
| 路线 | 自监督来源 | 典型优势 | 主要风险 |
|---|
| synthetic-only | renderer 直接生成有 GT 训练数据 | 标签免费、规模大 | sim-to-real gap |
| teacher–student pseudo labels | 高置信预测监督 student | 易利用真实无标注数据 | confirmation bias |
| temporal / multi-view consistency | 相邻帧或已知相机运动 | 真实几何约束 | 动态对象与标定误差 |
| render-and-compare refinement | CAD 渲染与观测一致性 | 几何可解释 | 局部收敛、材质差异 |
| 本文公开路线 | IAR + dense fusion + differentiable renderer | 同时覆盖 initial pose 和 refinement | 两阶段误差耦合 |
本文的区别不只是“用可微渲染”,而是把伪标注的 initial estimator 与 render-based refiner 放在统一学习问题中。
9. 潜在失败模式
- 深度空洞和飞点:RGB-D 在反光、透明和边缘处的噪声会污染逐像素 fusion。
- 遮挡:渲染完整 CAD,而真实观测只见局部;若没有 visibility mask,残差会误导 pose。
- 外观建模差异:renderer 的材质、照明和背景不匹配,photometric constraint 可能不可靠。
- 对称与重复纹理:多解问题被压成单一伪标签。
- 初始化偏离:refiner 只在局部收敛域有效。
- 模型误差:CAD 与真实工件尺寸、磨损或装配状态不同。
- 数据相关泄漏:若同一序列的相邻帧同时用于生成和评估伪标签,可能高估泛化。
10. 取得正文后必须补齐的复现信息
- IAR 的初始化、置信度、伪标签筛选和迭代停止条件;
- pixelwise weight 的产生方式及 RGB / depth encoder;
- rotation representation 与 pose aggregation;
- differentiable renderer 的输入、输出、可见性与材质设置;
- joint loss 的每一分项、权重和训练阶段;
- 对称对象的 label / loss 定义;
- 训练数据、测试 benchmark、split 与所有绝对分数;
- supervised baselines 是否使用相同 backbone、训练量和输入;
- initial-only、refinement-only、IAR、joint loss 的消融;
- 训练时长、GPU、推理速度和是否开源。
11. 研究启发
这篇工作的思路可以进一步做成“带不确定性的自监督闭环”:
- IAR 不输出单一 pose,而输出带 covariance 或多假设的伪标签;
- joint loss 根据 renderer consistency 自适应加权,不让高遮挡帧支配训练;
- 对称对象用等价姿态集合求最小损失;
- 低频 multi-view / robot kinematics 约束负责全局纠错,高频 refiner 负责局部精化;
- 单独监控 initial estimator 与 refiner 的 calibration,检测 confirmation bias。
总的来说,本文代表的是 2024 年 ICRA 物体位姿中的一条实用趋势:从“人工精确标注每一帧”转向“利用模型与传感器几何自动构造监督”。它的研究定位清晰,但当前公开证据不足以进行数值型 SOTA 判断或可复现性评价;详情页保留这一边界,比补造一张完整结果表更准确。
