LFM-3D 精读
1. 宽基线为什么需要 3D signal
通用局部 matcher 依赖重复可见纹理与局部外观一致性。对象中心图像在相隔 90°–120° 时,共视表面很少;鞋、相机等对象还会出现自遮挡和近似重复结构。纯 2D 描述子只能从当前 patch 判断身份,而 NOCS 或 depth 给出“这个点可能位于对象哪一侧/离相机多远”的几何条件。
LFM-3D 不要求 3D signal 很精确。论文的假设是:即使 NOCS/depth 有噪声,它们也能缩小匹配候选的几何歧义;图网络可学习何时信任这些信号。
2. 三种设定
- 已知类别 + NOCS:用 Google Scanned Objects 合成渲染训练类特定 NOCS 网络,适合 shoe。
- 已知类别 + monocular depth:使用冻结 DPT,为 camera 等难建统一 NOCS 的类别提供 class-agnostic 深度。
- 未见类别 + monocular depth:在 GSO 全部目录训练 generic matcher,零样本测试 Objectron 的 bike/book/cereal box/chair/laptop。
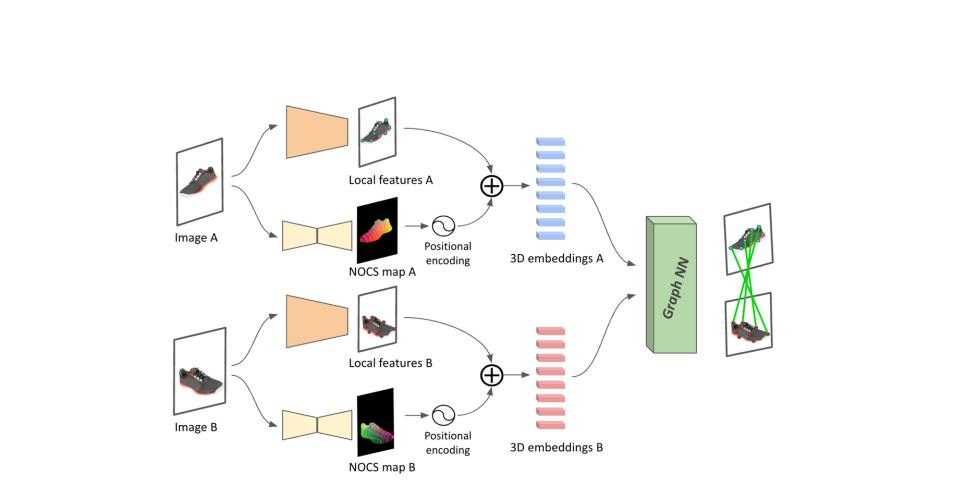 3D positional embedding 与 SuperPoint 外观特征互补;matcher 仍通过 optimal transport 输出离散匹配。来源:原论文 Figure 2;版权归原作者及 3DV 2024 出版方所有,本站仅作学术解读。
3. 训练与几何后端
训练对应来自已知深度/相机:将一幅图关键点反投影并重投影到另一幅图,3 像素阈值内的 mutual nearest neighbors 作为真值。NOCS/depth predictor 在 matcher 训练时冻结。推理得到 correspondences 后,用相机内参估 essential matrix 并恢复 relative rotation,报告角误差在 5°/10°/15° 内的比例。
注意这里没有完整评估 translation;essential matrix 只能恢复平移方向且有尺度不确定性。因此论文与 6D pose 的关系是“为对象中心 sparse-view alignment 提供前端对应”。
4. 实验拆解
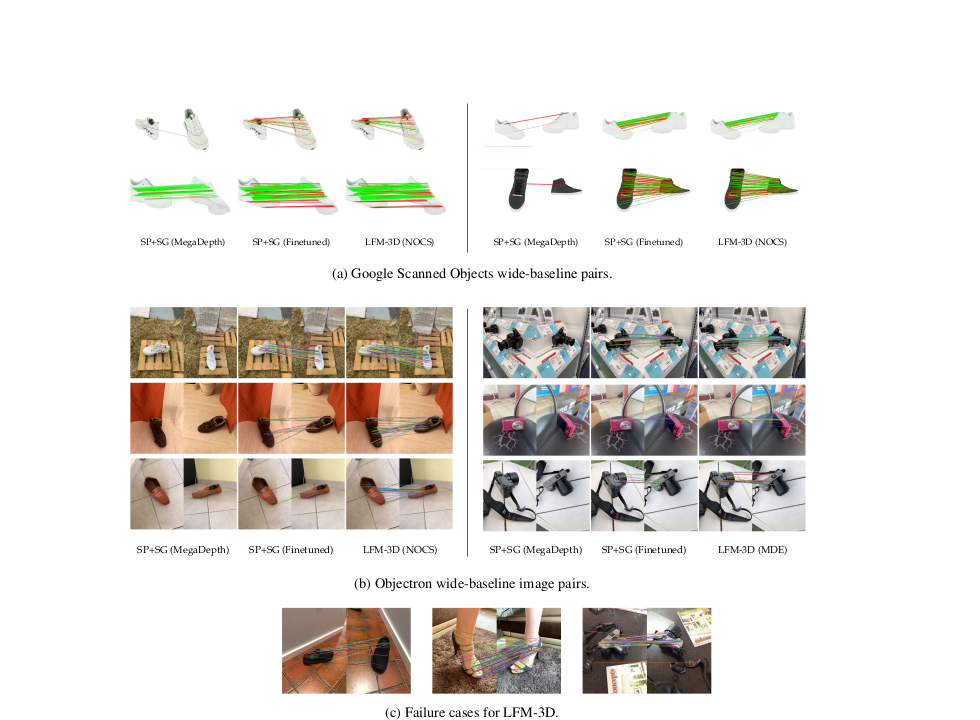 90°–120° 基线下,3D signal 帮助跨越外观变化;图中也展示 long-tail 类别和 NOCS 失败案例。来源:原论文 Figure 5;版权归原作者及 3DV 2024 出版方所有,本站仅作学术解读。
在 shoe 上:
- 2D-only finetuned SuperGlue:11.0/22.2/31.6
- Dense NOCS-PnP:4.2/18.9/34.9
- LFM-3D NOCS:14.3/29.3/40.2
这说明直接把估计 NOCS 当精确坐标做 PnP 不如把它作为软条件注入 matcher;15° 指标比 Dense PnP 高 5.3 点,比 2D matcher 高 8.6 点。
在未见类别上,generic MDE LFM-3D 为 19.1/28.9/34.5,generic finetuned SuperGlue 为 17.7/26.9/32.4,增益约 2 点。它支持 class-agnostic 3D signal 有帮助,但幅度远小于类特定 NOCS。
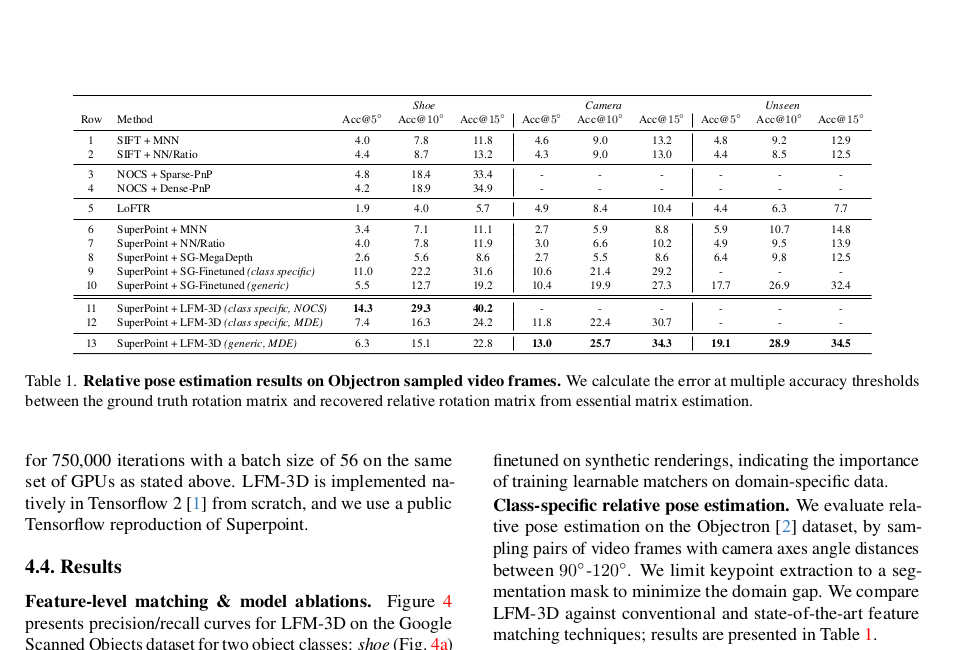 表格应按 shoe/camera/unseen 三个设定分别比较,不能把 NOCS 和 MDE 结果混成一个统一排名。来源:原论文 Table 1;版权归原作者及 3DV 2024 出版方所有,本站仅作学术解读。
5. 局限与复现提醒
- NOCS 网络在 GSO 多为 sneaker,少见鞋型会失败,说明 class-specific 3D prior 有明显数据偏置。
- 单目深度只给相对结构,物体 crop、mask 和尺度变化会影响稳定性。
- 结果依赖 off-the-shelf instance segmentation;mask 错误会改变关键点集合。
- 论文只证明 relative rotation 改善,完整相机 translation、scale 与后续重建质量还需单独验证。
- 训练需要合成模型与相机/深度来产生对应监督,并非完全无 3D 数据。
6. 我的判断
LFM-3D 最重要的结论是“估计 3D 不必直接当答案,可以作为匹配上下文”。当 NOCS/depth 不够准时,软编码后由 matcher 学习使用,往往比硬 PnP 更稳。这个思想可自然延伸到现代深度基础模型、dense correspondence 和对象级 SfM。
