LocPoseNet 精读
1. 为什么“目标位置”值得单独研究
许多 generalizable pose 系统把 query crop 或真值 object center 当作输入,于是论文比较看似集中在 rotation/refinement,真实部署最容易失败的检测与平移却被排除。对于未见类别,训练一个固定类别 detector 也不成立。LocPoseNet 的贡献是把这一隐藏假设显式化,并构造位置噪声测试来回答:参考图只有 32 张、query 尺度和背景都变化时,能否先产生足够好的 location prior?
2. 网络设计
2.1 Reference kernel distribution
从多张参考图抽取局部特征后,论文不是简单 resize query,而是对小尺寸 reference kernels 做双向尺度变换。这样只需一次 query backbone 前向即可得到多尺度相关,计算量明显低于为每个尺度重复编码整张 480×640 query。
双向很重要:只扩大 receptive field 会帮助“大 query、小 reference”,却会进一步破坏“小 query、大 reference”。kernel 同时收缩和扩张,才能覆盖两种尺度错配。
2.2 Cross-reference consistency
不同参考图产生的 correlation maps 需要在 query 中支持同一个目标位置。网络聚合跨参考证据,抑制只在某个模板上偶然匹配的背景区域。
2.3 解耦中心与尺寸
中心预测需要选择尖锐、单峰且位置稳定的相关图,因此 scale-robust head 按相关分布可靠性加权。尺寸预测则需要知道“哪个 kernel 尺度最匹配”,所以 scale-aware head 保留不同尺度通道。预测二维中心 cq 与尺度 sq 后,再结合物体参考尺度、焦距和投影关系恢复三维平移。
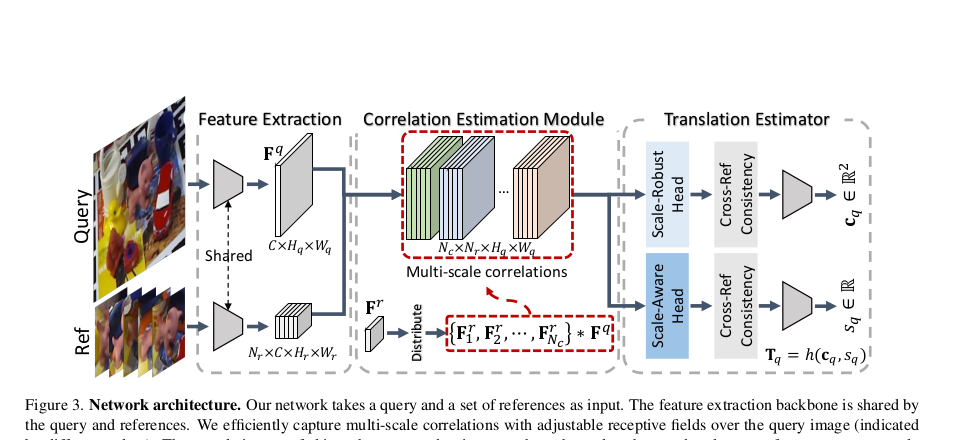 共享 query/reference 特征后,多尺度 correlation 一路进入 scale-robust 中心头,另一路进入 scale-aware 尺寸头。来源:原论文 Figure 3;版权归原作者及 3DV 2024 出版方所有,本站仅作学术解读。
3. 实验与证据
3.1 Localization
LINEMOD 32-reference 上,平均 mAP@[.5:.95]:
- SRPN:12.23
- OSOP:27.86
- Gen6D:60.84
- LocPoseNet:74.35
论文还保留真实 reference、渲染不同尺度/光照/背景的 synthetic query,仅用于测试。所有方法都下降,但 LocPoseNet 至少领先 10.42 点,并在尺度比从 1.0 增至 2.0 时保持更高曲线。这一测试比普通 LINEMOD 更直接支持“尺度鲁棒性”主张。
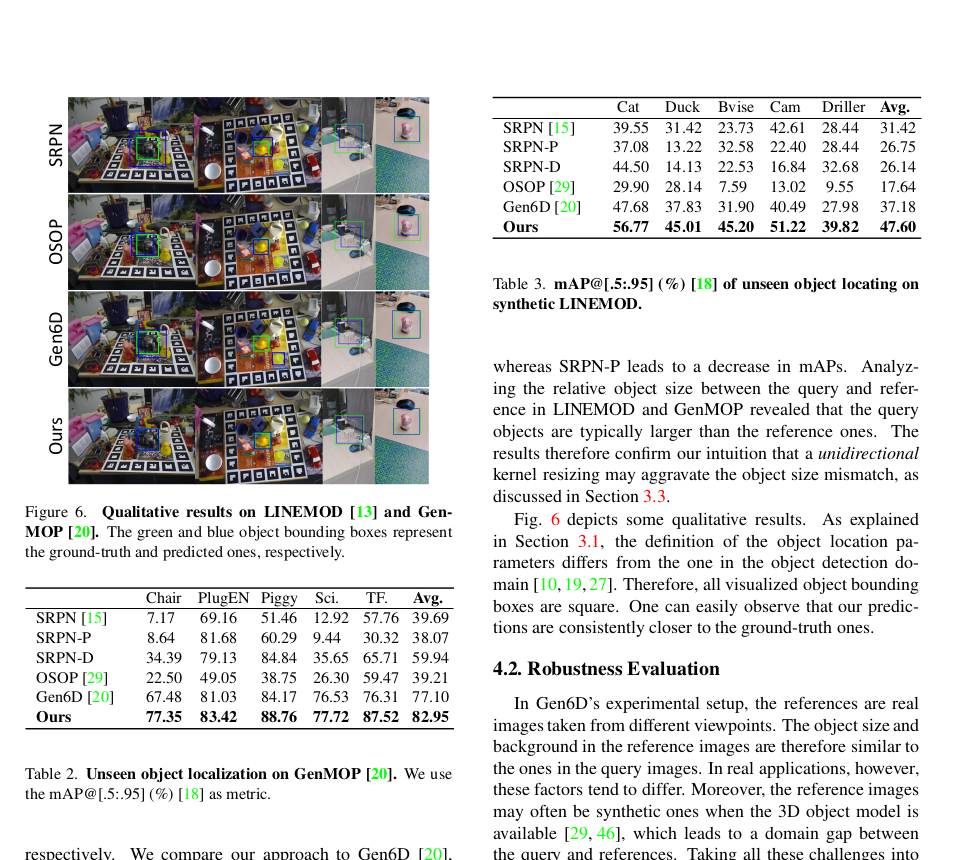 原论文 Figure 6、Table 2–3 所在页面局部:定性图展示 LINEMOD / GenMOP 预测框,两表分别报告 GenMOP 与 synthetic LINEMOD 的 localization;此截图不含最终 6D pose 表。来源:原论文 Figure 6、Table 1–2;版权归原作者及 3DV 2024 出版方所有,本站仅作学术解读。
3.2 最终 6D pose
LocPoseNet 只替换 Gen6D 的位置/平移前端,旋转和最终 refinement 使用相同后端:
- LINEMOD:无 refinement 27.27 vs Gen6D 17.73;同用 Volume 后为 68.58 vs 62.45。
- GenMOP:无 refinement 23.32 vs 17.90;同用 Volume 后为 53.61 vs 50.39。
这类“共享后端”的比较比直接和任意 SOTA 混排更有解释力,因为差值可以主要归因于 location prior。
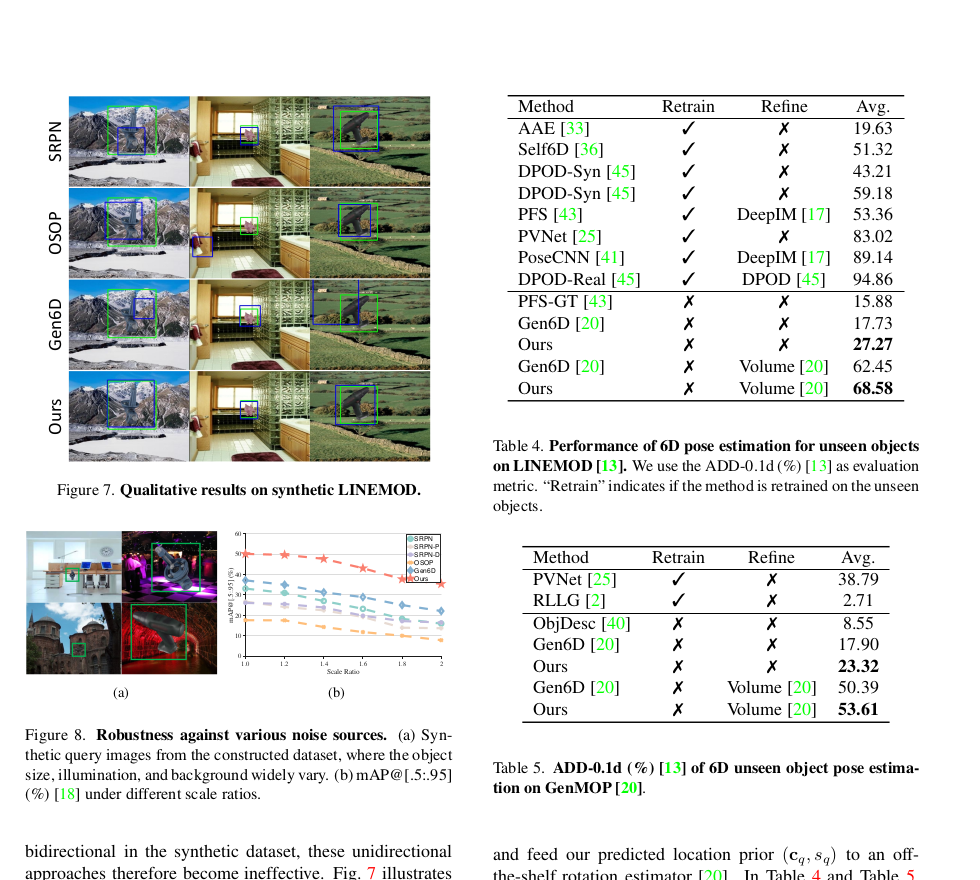 原论文 Figure 7–8、Table 4–5:左侧是 synthetic LINEMOD 定性图与尺度扰动测试;右侧分别报告 LINEMOD 和 GenMOP 的 ADD-0.1d,并区分无 refinement 与共享 Volume refiner。来源:原论文 Figure 7–8、Table 4–5;版权归原作者及 3DV 2024 出版方所有,本站仅作学术解读。
3.3 消融
基础单尺度、无一致性、普通估计器为 34.98 mAP;加入 cross-reference consistency 到 38.41,多尺度 + max 到 52.43,卷积融合到 70.10,完整解耦 estimator 达 74.35。说明主要增益来自多尺度表示,解耦头提供最后约 4.25 点。
4. 局限与复现注意
- reference 图仍需已知 pose/尺度信息,且 32 张模板并非真正 one-shot。
- 最终 rotation 由外部 refiner 提供,不能把全部 ADD 增益解释成网络直接预测了完整 6D。
- synthetic robustness set 使用 LINEMOD CAD 渲染,能控制变量但不完全代表真实传感器域差。
- 对强遮挡、多个相同实例、参考物体与 query 形变明显的场景,相关峰可能仍不唯一。
5. 工程启示
LocPoseNet 最有价值的观点是:translation 不只是一个三维回归向量,它由二维中心、表观尺度、真实尺寸和相机内参共同决定。把中心与尺度分开建模,并对前端单独评测,通常比在最终 ADD 上盲目调 refiner 更容易定位系统瓶颈。
