论文精读笔记:Perception Through Cognitive Emulation — A Second Iteration of NaivPhys4RP
1. 基本信息
2. 论文定位
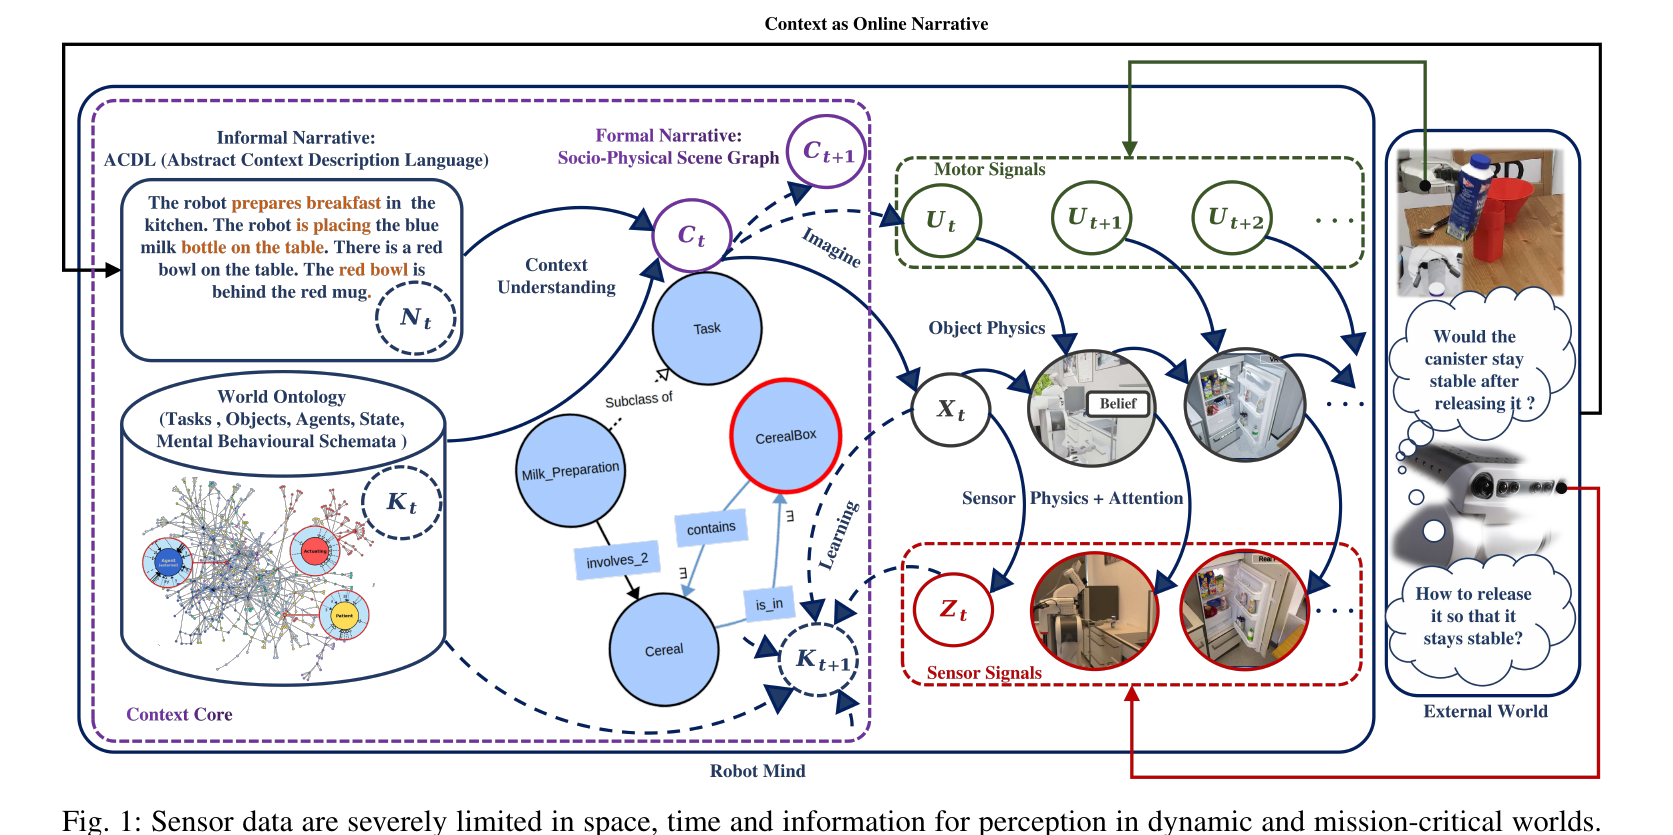
NaivPhys4RP 将 perception 写成“哪个可模拟世界最能造成当前观测”的生成式解释问题。它融合 ontology、语言 context、机器人本体状态、朴素物理和少量 sensor data,并把对象 recognition 与 6D pose 作为隐藏世界状态的一部分推断。
这不是标准 feed-forward pose estimator。论文关心透明 / 遮挡 / poor-depth 场景中的可解释性与安全性,并明确以 learningless white-box system 为目标。
3. 形式化视角
作者把世界看作 situated partially observable hidden Markov process。变量涵盖:
X t X_t X t U t U_t U t Z t Z_t Z t C t C_t C t K t K_t K t N t N_t N t
系统要同时完成 context understanding、state prediction、scene imagination 和 observation explanation。与 discriminative pose network 的 Z t → T Z_t\rightarrow T Z t → T P ( X t ∣ Z 0 : t , C , K , U ) P(X_t\mid Z_{0:t},C,K,U) P ( X t ∣ Z 0 : t , C , K , U )
原论文 Figure 1:系统通过变量依赖、想象、物理推进和观测解释形成闭环,而不是仅从一帧传感数据回归 pose。来源:作者公开 PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
4. 系统流程
4.1 Context understanding
受控自然语言和 SOMA ontology 被解析成 socio-physical graph。系统可利用因果、目的、意图和常识排除“机器人在冰箱里”等不合理叙述,并补全未明确写出的实体关系。这里的解释能力来自显式知识结构,不是大模型隐式表征。
4.2 Scene imagination
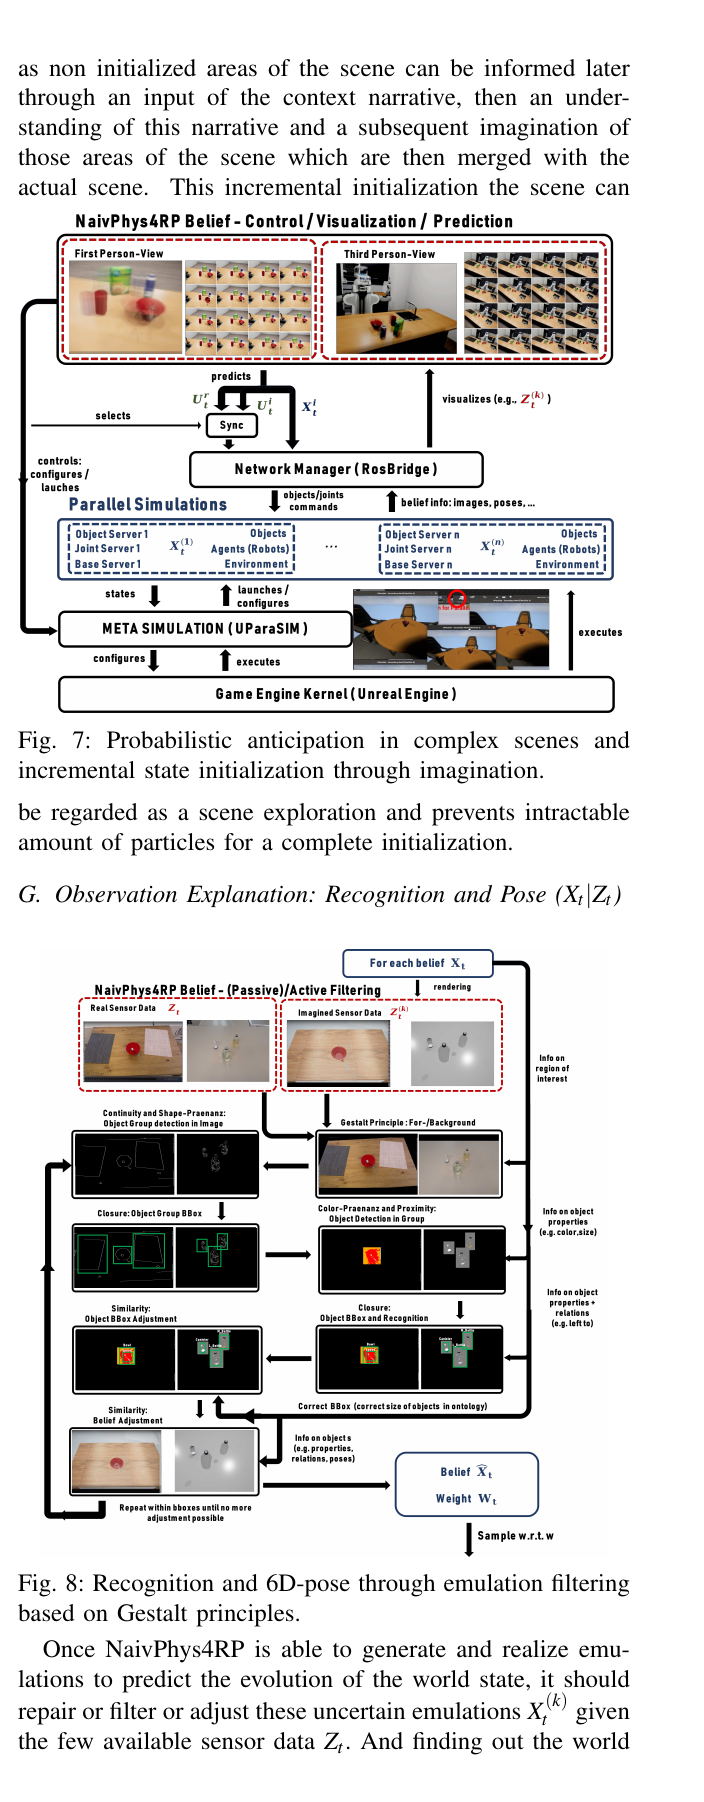
图中的 object、material、texture、pose 与 action 被编译成 simulator 可执行描述。系统生成多个 scene particles,每个粒子代表一种可能世界。作者采用 game-engine-agnostic compiler,再由特定 interpreter 在 Unreal Engine 等环境中实例化。
原论文 Figure 7–8:多粒子预测形成 pose belief,再用真实观测对想象场景做 Gestalt-style fitting 与重采样。来源:作者公开 PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
4.3 Physics transition 与 anticipation
每个粒子在物理引擎中按 actions 推进,形成未来 scene states。belief 可增量初始化,避免一开始枚举大型场景所有可能组合。它不仅解释当前 pose,也试图预测对象会掉落、倾倒或碰撞等后果,这就是论文所说的 safety / anticipation。
4.4 Observation explanation
系统尝试把有限传感数据 Z t Z_t Z t X t ( k ) X_t^{(k)} X t ( k )
5. 实验演示与证据强度
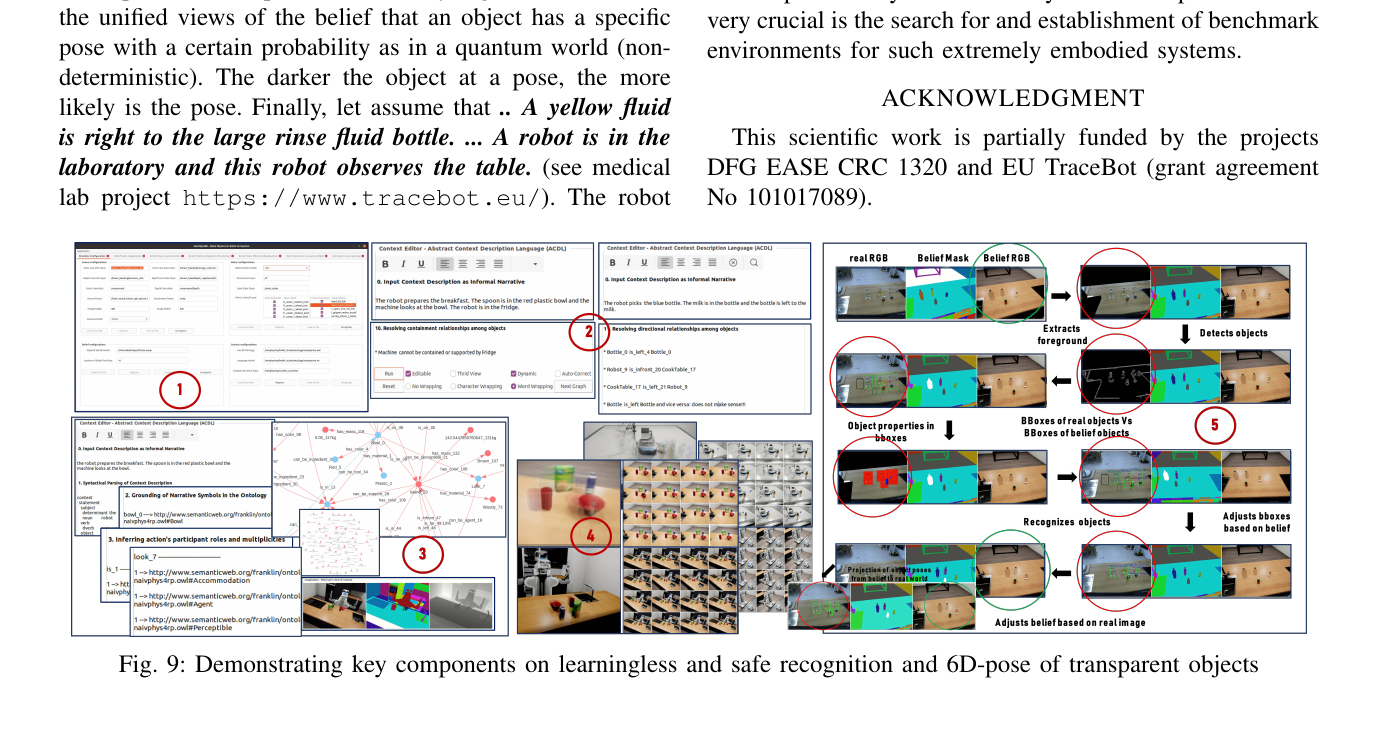
论文展示早餐 / 实验室叙述理解、场景想象、belief visualization,以及透明瓶类对象的 learningless recognition 与 6D pose。Figure 9 串起系统配置、矛盾叙述检测、scene graph、粒子想象和透明物体 pose filtering。
原论文 Figure 9:从上下文理解到 belief particles,再到透明对象 recognition / 6D pose 的系统演示。该图属于概念验证,不是标准数据集误差曲线。来源:作者公开 PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
证据可得性说明
论文没有报告 BOP、ClearPose、TOD 等 benchmark 上的 ADD(-S)、VSD、translation / rotation error,也没有和透明物体 pose baselines 做同协议定量比较。因此:
可以说系统展示了透明物体 recognition 与 6D pose inference;
可以说推理链可检查、无需数据驱动训练;
不能 说其 pose precision、速度或泛化已达到 / 超过现代学习方法;“safe”主要指因果与物理一致性的设计目标,而非经过正式安全认证。
6. 优点与局限
优点
输出不仅是 pose,还有来自 ontology、context 和 physics 的解释。
可将不可见状态、未来风险与当前观测放在统一 belief 中。
对传感器先天困难的透明物体,利用非视觉约束是一条合理补充路线。
局限
依赖高质量 ontology、对象模型、材质、动作程序和 simulator fidelity。
粒子数与场景组合增长带来明显计算复杂度。
缺少标准化定量实验,难判断每个模块的实际贡献。
“learningless”不等于“无先验成本”;大量先验以人工知识与模型资产形式注入。
未系统讨论错误知识或错误 physics model 如何让系统产生高置信错误解释。
7. 对 pose 研究的启发
NaivPhys4RP 的价值更像研究议程:当 RGB-D 对透明对象失效时,pose 不必只由当前像素决定,还可由“对象应在哪里、之前在哪里、受什么作用力、什么状态符合任务语义”联合约束。更可落地的混合方案是让深度网络产生 pose proposals 与 uncertainty,再由可微物理、关系图和 temporal belief 做验证,而不是完全替代数据驱动感知。