论文精读笔记:Pose-VLA
1. 论文信息与阅读边界
标题 :Pose-VLA: Universal Pose Pretraining for Generalizable Vision-Language-Action Policies作者 :Haitao Lin、Hanyang Yu、Jingshun Huang、He Zhang、Yonggen Ling、Ping Tan、Xiangyang Xue、Yanwei Fu机构 :Tencent Robotics X、Futian Laboratory、The Hong Kong University of Science and Technology、Fudan University、Shanghai Innovation Institute会议 / 版本 :官方代码仓库标注 RSS 2026;本站精读 arXiv v3(2026-07-07)论文 :arXiv:2602.19710 项目页 :Pose-VLA 代码 :hetolin/PoseVLA 公开权重 :Stage-1 VLM ;RoboTwin checkpoint 阅读模式 :精读
本文横跨 3D grounding 与 VLA policy。阅读时必须区分三种“pose”:
物体在相机坐标系中的 6DoF pose,用于 3D grounding 预训练;
夹爪在相机坐标系中的 6DoF trajectory waypoint,用于 motion alignment;
action expert 在部署时输出的连续机器人动作,它不是显式物体 pose。
2. 一句话定位
Pose-VLA 把离散 camera-centric pose tokens 设计为非机器人 3D 数据与机器人轨迹之间的通用接口:先让 PaliGemma 学会细粒度 spatial grounding,再用相机系夹爪轨迹对齐运动,最后通过 flow-matching action expert 适配具体机器人;pose prediction 是预训练代理任务,而非部署时的额外推理链。
方法输入与输出
项目 内容(本站整理) 推理输入 RGB 观测与语言指令;可选 depth / validity mask 和由 K K K 最终输出 部署策略经 flow-matching action expert 生成连续机器人动作序列,而非直接输出物体 R , t R,t R , t 训练输入 空间预训练读取图像 / 语言及可用几何条件,以物体 3D 标注监督;运动对齐使用示教与标定后的相机系夹爪轨迹;后训练使用具体机器人观测及示教动作。 训练目标 预训练预测类别、2D anchor、离散 pose / size 或时序轨迹 tokens;后训练预测动作流场以拟合示教 action chunk。GT pose 与未来示教动作属于监督,不是在线已知条件。 输出细节 预训练 pose 位于相机坐标系,平移 / 尺寸为物理量量化的 tokens;部署动作使用目标机器人的 action space。动作维数、horizon、坐标系及单位需按平台配置核对,不能直接把预训练的 6DoF tuple 当控制向量。 必要条件 需要预训练与 embodiment adaptation;使用 raymap / camera-centric 监督时需要可靠标定。深度和 raymap 可被 modality masking 关闭,不应写成所有推理配置的硬依赖。
依据:论文 Sections III-C 至 III-E 。预训练任务的输出与最终策略的输出是不同接口。
2.1 论文图表导读
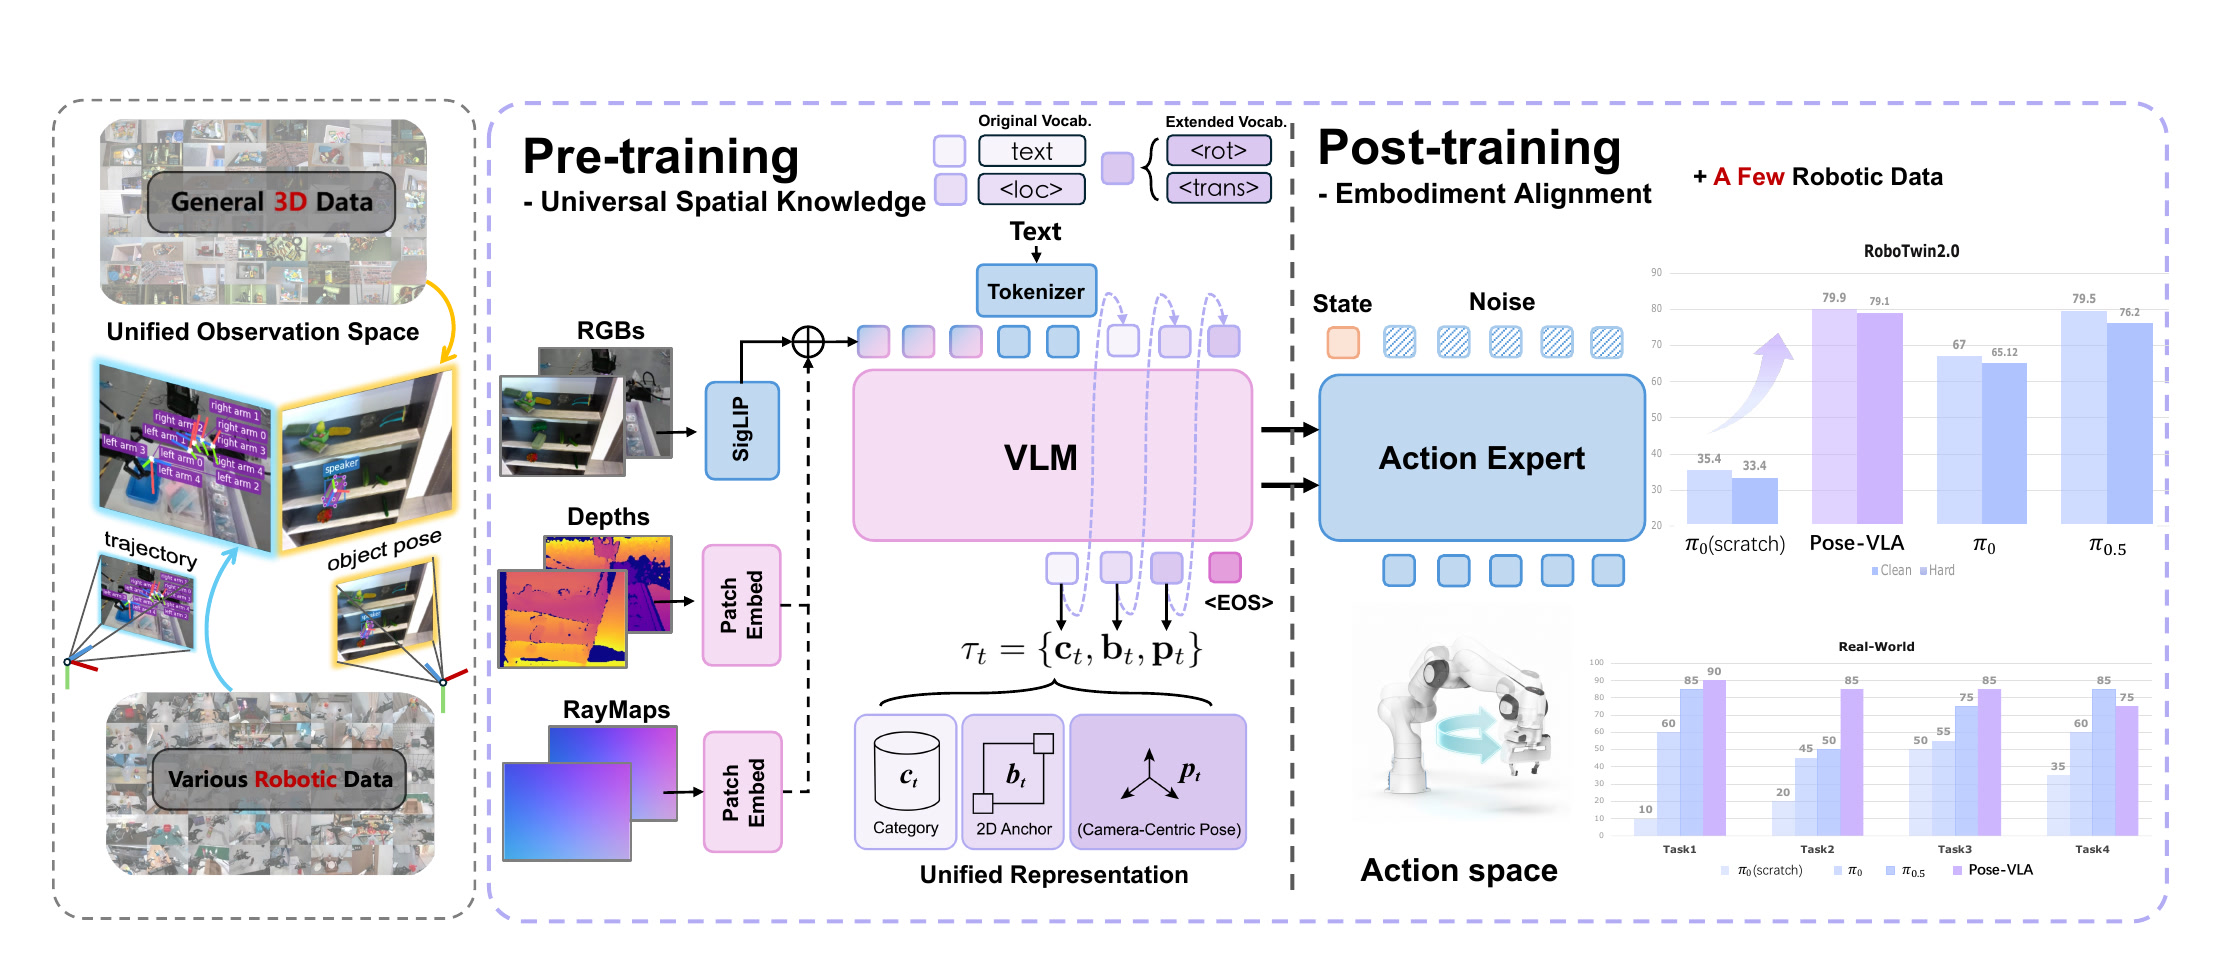
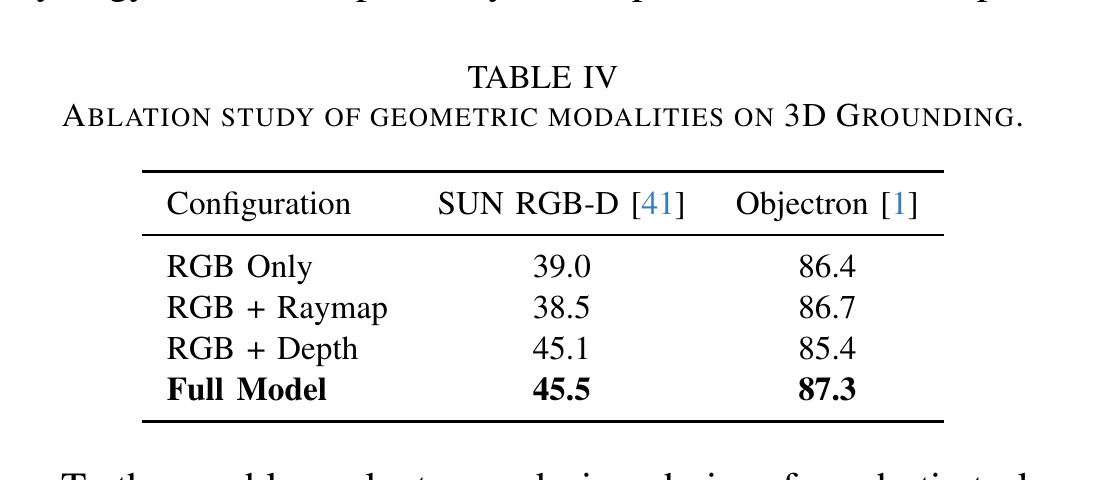
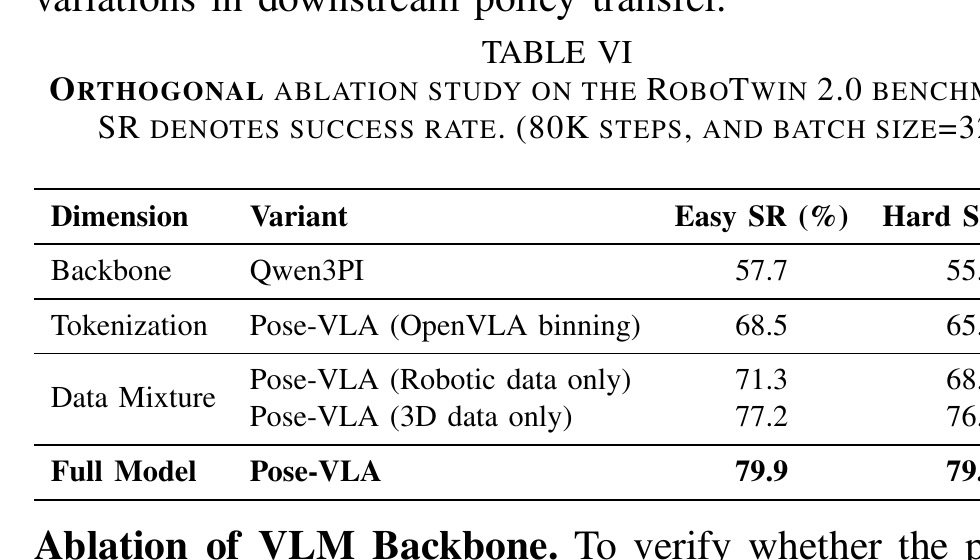
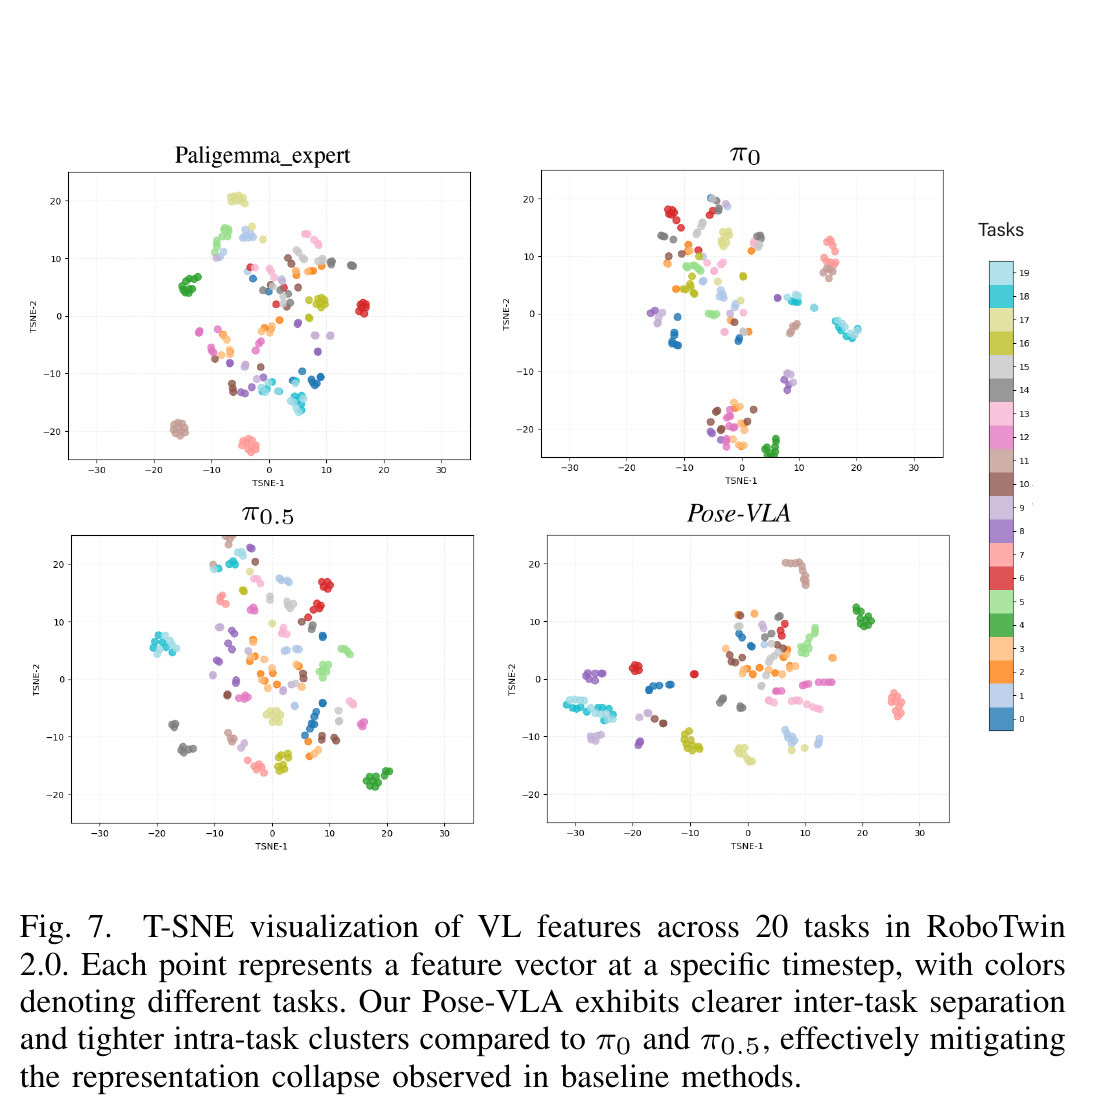
图表 作用 精读重点 Figure 2 完整 pipeline 通用 3D / robot data 先进入同一 camera-centric token space,action expert 后接 Figure 6 pose token 的数据分布 x / y x/y x / y z z z <trans_xy>、<trans_z> 和非均匀量化Table I + Figure 3 3D grounding AP15 数值与未见场景定性结果共同验证 VLM 的空间能力 Tables II–III 仿真策略 RoboTwin 强调视觉扰动,LIBERO 强调跨套件与长程任务 Figures 4–5 真实任务 约 100 demos / task;深度对长程抽屉任务尤其重要 Tables IV–VI 因果拆解 几何模态、数据组成、动作表示、坐标系与 tokenization 分别消融 Figure 7 feature t-SNE 作者用任务簇分离解释 feature collapse 缓解,但它只属辅助证据
原论文 Figure 2。通用 3D 数据与机器人数据先共享 camera-centric observation / pose vocabulary;PaliGemma VLM 生成类别、2D anchor 和 pose tokens,后接 action expert 做连续动作去噪。来源:arXiv:2602.19710 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 研究问题:为什么普通 VLM 不够
3.1 Granularity mismatch
VQA / 图文对齐强调类别、属性和高层关系。机器人操作却要求区分“杯口向左偏了几度”“夹爪还差几厘米接触”“抽屉把手相对相机向前移动了多少”。两个观测语义可以完全相同,最优动作却不同。
因此,VLM 能回答目标是什么,并不意味着其中间特征保留了足以控制的精细 3D state。论文把标准 PaliGemma + action expert 在 RoboTwin Easy / Hard 的 35.4 / 33.4 视为这种 feature collapse 的外部表现。
3.2 Representation mismatch
非机器人 3D 数据通常在 camera frame 标注 object pose;机器人示教却常记录 joint angles、base-frame end-effector pose 或局部 delta action。直接把这些表示混起来有两个问题:
机器人特定 joint vocabulary 很难吸收 object-centric 3D 数据;
相机观测与 base-frame action 的对应需要模型隐式学习外参和运动学变换。
Pose-VLA 选择 camera-centric 6DoF pose 作为共同物理语言。它不是宣称 camera frame 永远优于 base frame,而是让空间监督和动作监督在预训练期间对齐。
4. 形式化
给定多模态观测 O \mathbf O O L \mathbf L L S \mathbf S S
P ( S ∣ O , L ) = ∏ k = 1 K P ( s k ∣ O , L , s < k ) . P(\mathbf S\mid\mathbf O,\mathbf L)
=\prod_{k=1}^{K}P(s_k\mid\mathbf O,\mathbf L,s_{<k}). P ( S ∣ O , L ) = k = 1 ∏ K P ( s k ∣ O , L , s < k ) . 序列由多个结构化 tuple 组成:
S = ( τ 1 , τ 2 , … , τ T ) , τ t = { c t , b t , p t } . \mathbf S=(\tau_1,\tau_2,\ldots,\tau_T),\qquad
\tau_t=\{c_t,b_t,p_t\}. S = ( τ 1 , τ 2 , … , τ T ) , τ t = { c t , b t , p t } .
c t c_t c t b t ∈ R 2 b_t\in\mathbb R^2 b t ∈ R 2 p t ∈ S E ( 3 ) p_t\in SE(3) p t ∈ S E ( 3 )
这个 tuple 在静态图像中表示对象状态;按时间排列后表示夹爪轨迹。论文称它为 universal geometric primitive,因为同一个 token grammar 同时覆盖离散物理实体和连续运动路径。
5. VLM 骨干与显式几何输入
5.1 PaliGemma / SigLIP
Pose-VLA 采用 PaliGemma-3B,视觉编码器为 SigLIP。原始 text vocabulary 与 <loc> vocabulary 保留,用来预测 category 与 2D anchor;新增 pose-related vocabulary 承载旋转、平移和尺度。
5.2 Camera ray encoding
给定内参 K K K ( u , v ) (u,v) ( u , v )
r ( u , v ) = K − 1 [ u , v , 1 ] ⊤ . r(u,v)=K^{-1}[u,v,1]^\top. r ( u , v ) = K − 1 [ u , v , 1 ] ⊤ . raymap 经 patchify 与线性投影后,加到 RGB patch embeddings 上,再进入第一个 Transformer block。它类似几何版 positional encoding:普通 2D patch position 告诉模型“像素在哪里”,ray 告诉模型“这条像素射线朝哪个三维方向”。
这对非中心裁剪与高分辨率推理尤其重要,因为相同局部外观位于不同图像位置时,对应的 camera ray 不同。
5.3 Metric depth prior
深度输入不是单一 D D D
[ D , M ] ∈ R H × W × 2 , [D,M]\in\mathbb R^{H\times W\times 2}, [ D , M ] ∈ R H × W × 2 , 其中 M M M [ D , M ] [D,M] [ D , M ]
训练会采样稀疏 depth points,避免模型只适应规则稠密深度,也让同一编码器能够处理不同传感器噪声与缺测模式。
5.4 Modality masking
训练时随机把 raymap 或 depth 置零。因此几何输入是可选条件,而非硬依赖。仿真主表为了公平比较 RGB-only baseline,会同时 mask depth 与 raymap;真实实验则显示可用 depth 仍有明显价值。
6. Unified pose representation
6.1 Object-level pose tokens
旋转以 Euler angles 表示,每个 principal axis 使用专门的 <rot> token。平移根据统计分布拆为:
x / y x/y x / y <trans_xy> vocabulary;z z z <trans_z> vocabulary;3D grounding 的对象尺寸:<size> vocabulary。
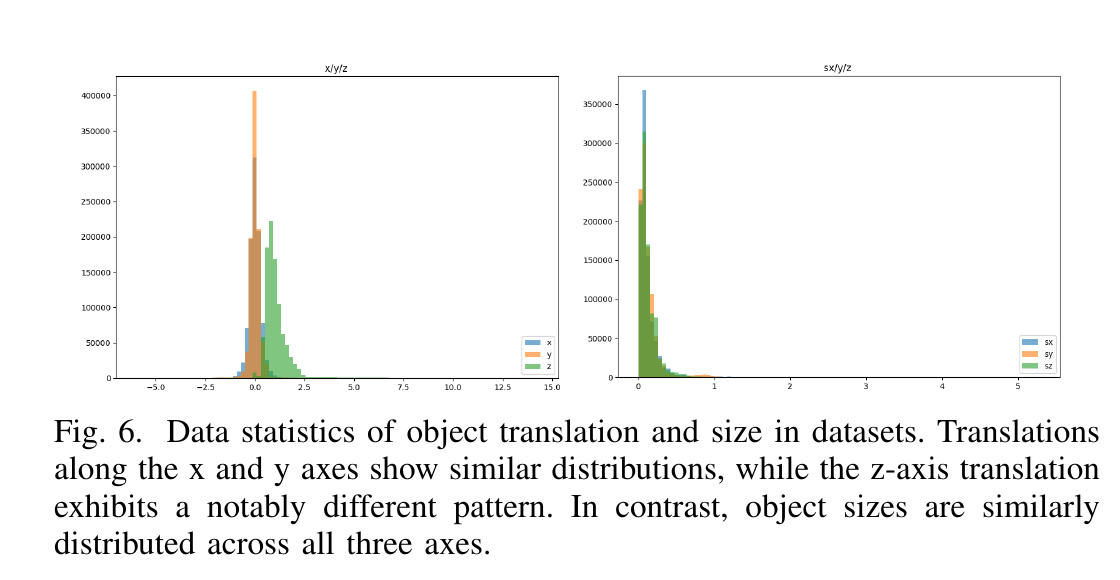
论文指出 x / y x/y x / y z z z
原论文 Figure 6:平移 $x/y$ 的统计相似,$z$ 分布明显偏斜;对象三轴 size 分布则更接近。该统计是拆分 `` / `` 并采用 distribution-aware bins 的依据。来源:论文附录 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
附录按数据密度的倒数设置 bin width:高密度区域用窄 bin,尾部用宽 bin,使离散 token 在训练集上近似等频、提高 vocabulary entropy。<rot>、<trans_xy>、<trans_z> 与 <size> 各分配 N = 2048 N=2048 N = 2048
这里需要谨慎:正文一处把 rotation 写成 uniform quantization,而附录把专用空间 tokens 统一描述为 non-uniform strategy。复现时应以公开代码中的 tokenizer / bin edges 为准,并记录具体 checkpoint 的实现版本。
6.2 Trajectory-level pose tokens
机器人 action 以 6DoF gripper pose 表示;动态过程是一串按时间排序的 pose tokens。作者把数据集提供的 base-frame end-effector trajectories 经标定参数变换到每个 camera frame。
其作用不是要求所有机器人共享相同关节结构,而是让 VLM 先学习“图像中的夹爪如何在三维中运动”。具体 embodiment 的关节与控制接口由 post-training action expert 再处理。
6.3 为什么不是 OpenVLA 的 delta-action bins
OpenVLA 风格 uniform bins 编码局部 delta actions:
token 与具体机器人动作定义耦合;
无法直接承载非机器人 object pose;
均匀量化不适应近场高精度、远场低密度的异方差分布。
正交消融中换回 OpenVLA binning 后,RoboTwin Easy / Hard 从 79.9 / 79.1 降到 68.5 / 65.9。
7. 训练目标与两阶段解耦
7.1 Pre-training:spatial grounding + motion alignment
预训练仍是标准 next-token prediction:
L p r e ( θ ) = − ∑ k = 1 K log p θ ( s k ∣ ϕ ( O ) , L , s < k ) , \mathcal L_{pre}(\theta)
=-\sum_{k=1}^{K}\log p_\theta\big(s_k\mid\phi(\mathbf O),\mathbf L,s_{<k}\big), L p r e ( θ ) = − k = 1 ∑ K log p θ ( s k ∣ ϕ ( O ) , L , s < k ) , ϕ ( O ) \phi(\mathbf O) ϕ ( O )
训练可以理解为两种密集监督:
Spatial grounding :从图像与文本目标恢复 object category、2D anchor、camera-centric 6DoF pose / size。Motion alignment :从机器人视频预测 camera-centric future gripper trajectory。
第一类把 VLM 从 semantic describer 推向 geometric reasoner;第二类让这种几何特征对控制敏感。
7.2 Post-training:flow-matching action expert
VLM 后接轻量 action expert,结构沿用 π0 类双系统思路。expert 接收 action state 与 noise,通过 flow-matching objective 学习连续 action denoising;VLM 与 expert 在 self-attention 中交换信息。
它完成的是 robot-specific embodiment alignment,而不是再次训练 VLM 从头获得全部几何能力。
7.3 推理时不显式求 pose
论文正文给出明确 remark:3D pose prediction strictly serves as an auxiliary proxy task during pre-training。部署时 action expert 直接把隐特征映射为连续动作,不显式估计 object pose 或 camera trajectory,因此没有额外 pose decoding 开销。
这意味着 Pose-VLA 与“先跑 6D pose estimator,再把 R , t R,t R , t
7.4 Action-expert 初始化口径不一致
论文正文称 action expert 从随机初始化开始,不继承 π0 参数;附录却把 full model 写成 Pose-VLA (π0),使用官方 π0 checkpoint,并报告随机初始化 Pose-VLA 为 79.91 / 79.10、π0 初始化版本为 81.30 / 80.72。
因此正确读法是:
79.91 / 79.10 能证明 pose-centric VLM 在 scratch expert 下仍有效;81.30 / 80.72 显示 action-expert pretraining 还有约 1.4–1.6 点收益;复现实验必须标注 expert initialization,不能把两者统称为同一配置。
8. 预训练数据与计算
8.1 非机器人 3D 数据
共 140 万图像、650 万个 3D annotations :
数据支柱 组成 学到什么 General 3D detection Omni3D:Objectron、SUN RGB-D、ARKitScenes 室内与对象中心的 3D box / pose grounding 6D pose estimation Omni6DPose:SOPE、ROPE 大词汇真实 / 合成对象的 6DoF 与尺度 Manipulation-centric perception BOP:YCB-V、LineMOD、HOT3D 接近机器人工作空间的对象几何与姿态
数据混合含真实与合成图像,覆盖不同照明、材质、场景尺度和标注密度。
8.2 机器人轨迹
共约 155 万条 trajectories :
AgibotWorld Beta(真实) :100 万条;100 台同构机器人、200 tasks、87 atomic skills。InternData-A1(仿真) :55 万条;ARX、Aloha、Franka 等 4 embodiments、227 scenes。
轨迹的价值不仅是动作样本量,而是把预训练的静态空间 token 延伸到时序 motion token。
8.3 训练配置
optimizer:AdamW;
schedule:cosine;
peak learning rate:5 × 10 − 5 5\times10^{-5} 5 × 1 0 − 5
minimum learning rate:2.5 × 10 − 6 2.5\times10^{-6} 2.5 × 1 0 − 6
precision:bfloat16;
hardware:16 × NVIDIA H20;
batch:8 / GPU;
3D grounding 与 trajectory estimation 各约 2 天。
这些数字只覆盖论文描述的两个预训练任务;下载 checkpoint、后训练每个机器人 benchmark、仿真采集和真实示教成本仍应单独计算。
9. 3D grounding 评测
9.1 协议
主要在 Omni3D 的 SUN RGB-D 与 Objectron subset 上评测;
文本 prompt 指定目标 object category;
IoU threshold 固定 0.15,报告 AP15 / mAP@0.15;
所有 prediction confidence 固定为 1.0,以减少置信度排序对结果的影响。
AP15 衡量 3D box grounding,不等价于 BOP AP、ADD(-S) 或 VSD / MSSD / MSPD AR。阈值 0.15 也明显比 2D detection 常见的 IoU 0.5 更宽,跨论文比较必须确认协议。
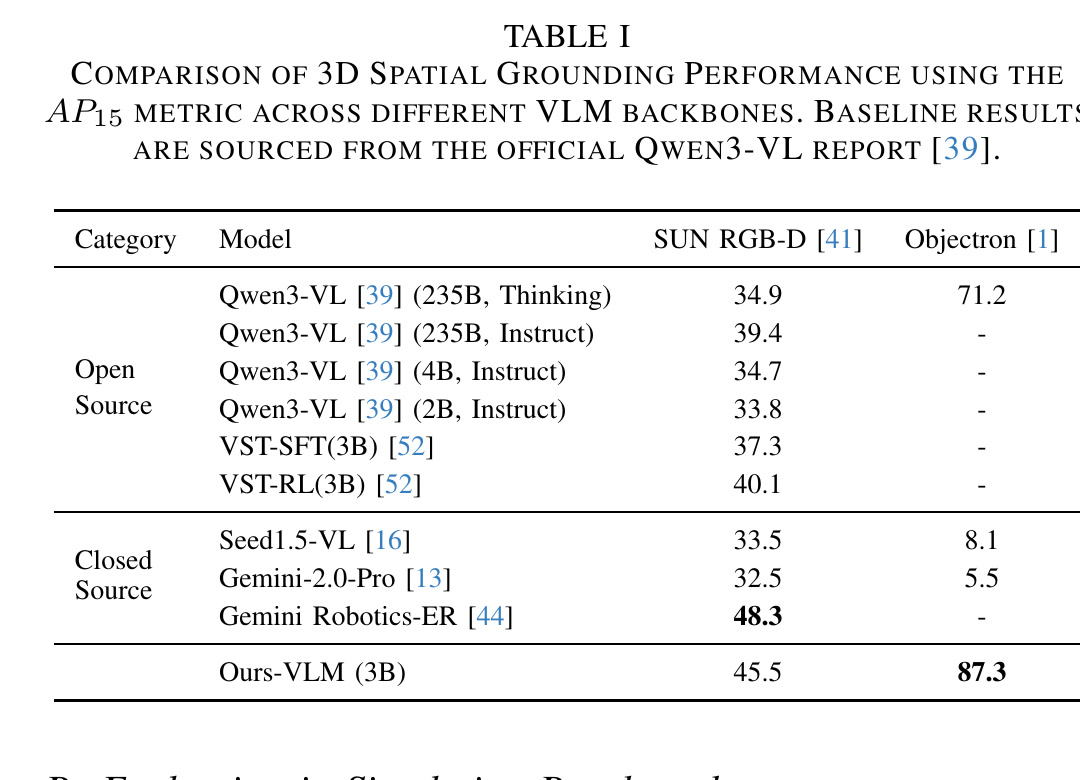
原论文 Table I。Pose-VLA 的 SUN RGB-D / Objectron AP15 为 45.5 / 87.3;Objectron 相对最强开源 Qwen3-VL 235B Thinking 的 71.2 提升 16.1 个绝对点。SUN RGB-D 仍低于闭源 Gemini Robotics-ER 的 48.3。来源:论文原文 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
9.2 结果解释
Objectron 87.3 :对象中心、桌面尺度场景与操控所需几何更接近,收益最突出。SUN RGB-D 45.5 :高于所有表中开源 baseline 与 VST-SFT / RL,但低于 Gemini Robotics-ER 48.3。Qwen3-VL 235B Thinking 在 SUN RGB-D 只有 34.9,说明参数规模和一般 3D QA 能力不能替代针对 pose 的表示预训练。
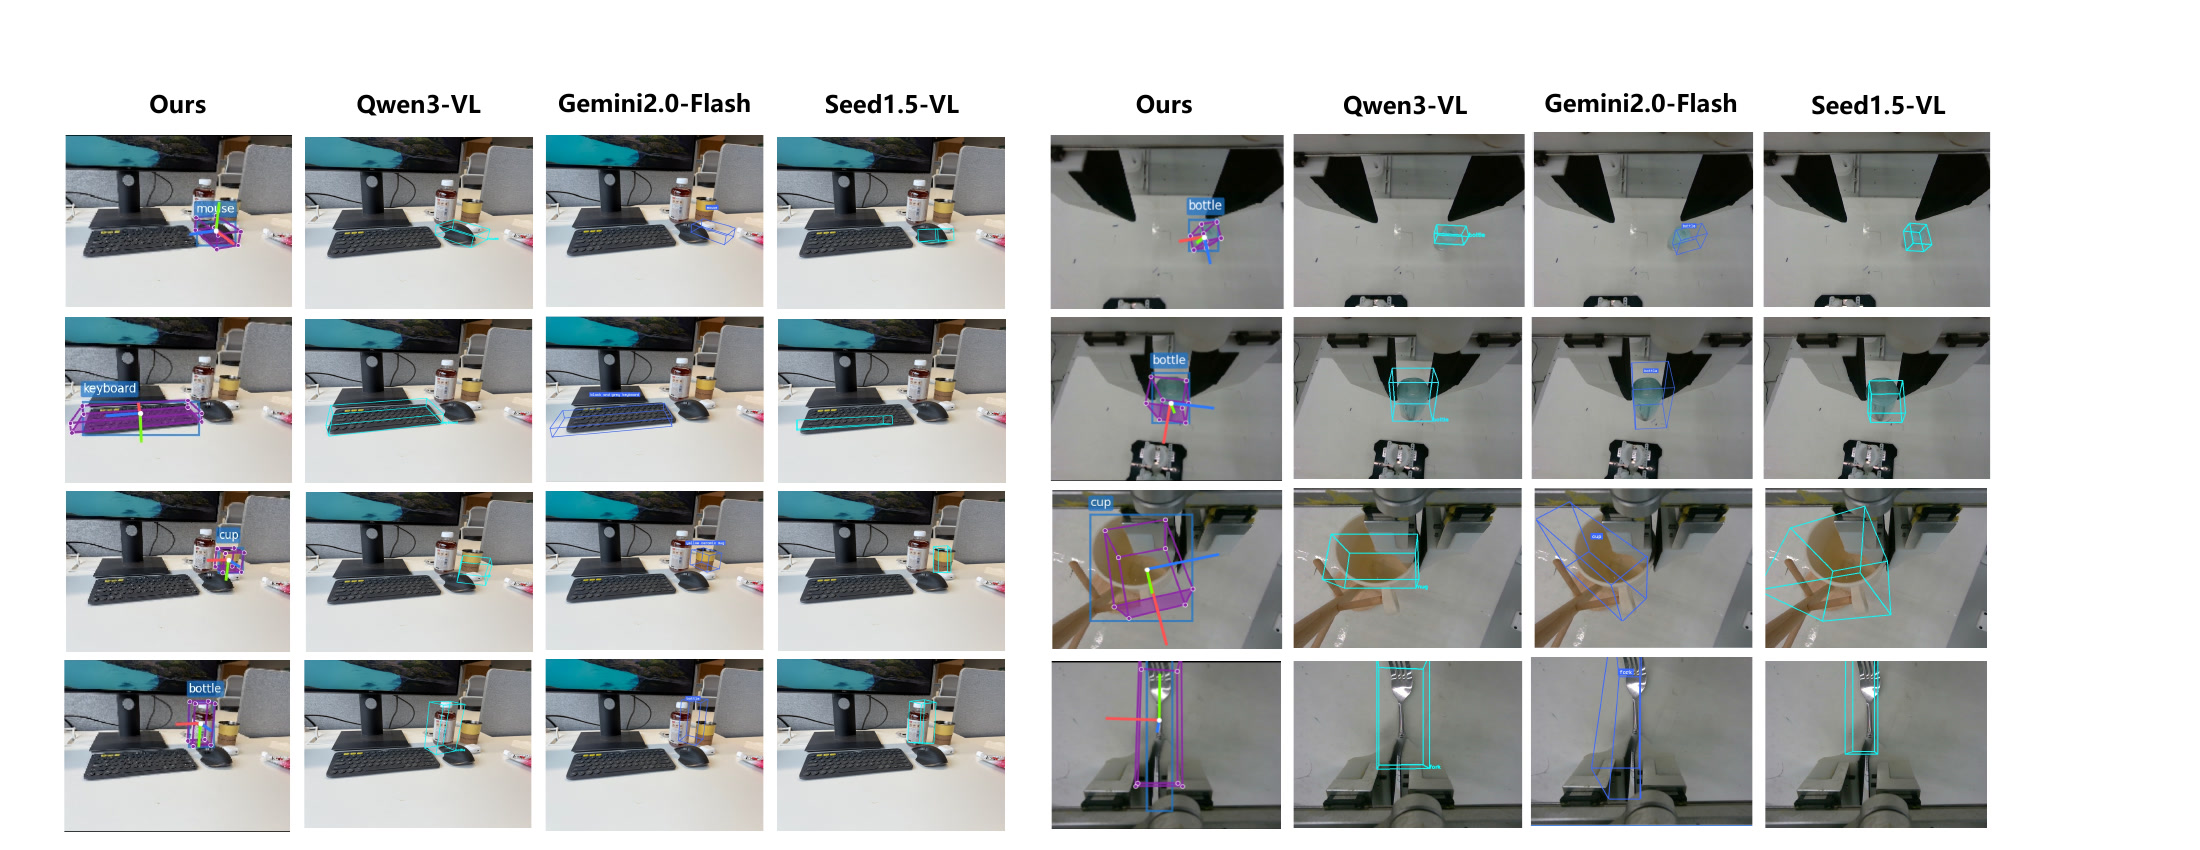
原论文 Figure 3。左半是普通桌面对象,右半是机器人工作空间;Pose-VLA 的 3D box 方向与位置通常更贴合目标。定性图支持泛化叙事,但不能替代按场景分层的误差统计。来源:论文原文 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
10. 仿真策略评测
10.1 RoboTwin 2.0
设置:
50 tasks;
clean demonstrations:2,500(50 / task);
heavily randomized demonstrations:25,000(500 / task);
公平主比较统一 80K optimization steps、total batch size 32;
Easy 与 Hard 各按每任务 100 次 trials 报告平均 success rate;
Pose-VLA 在主表遮蔽 depth 与 raymap,仅使用 RGB。
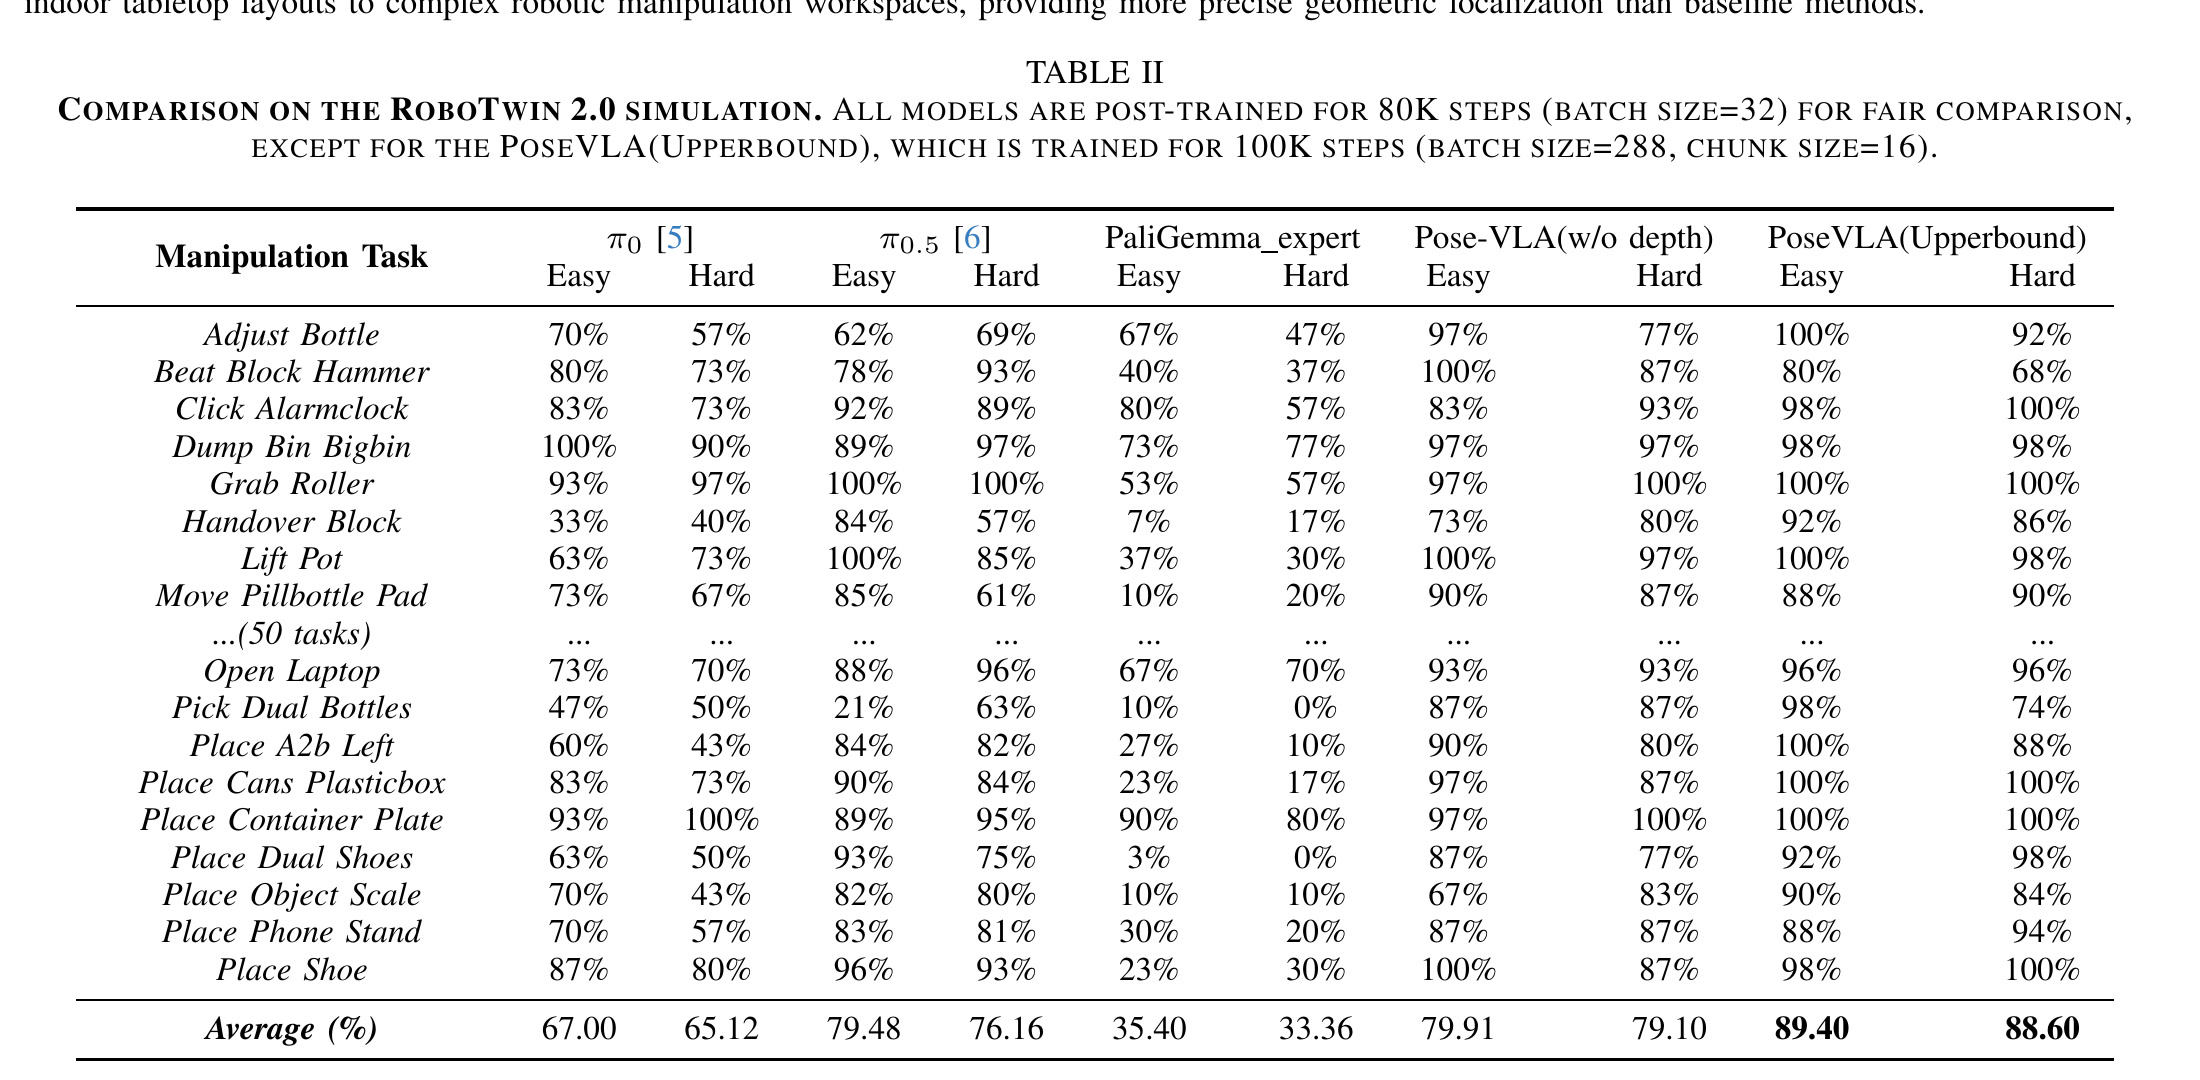
原论文 Table II。80K 公平预算下 Pose-VLA 为 79.91 / 79.10,π0 为 67.00 / 65.12,π0.5 为 79.48 / 76.16。最右 Upperbound 采用 100K steps、batch 288、chunk 16,得到 89.40 / 88.60,应单独看待。来源:论文原文 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
Hard 相对 π0 提升 13.98 点,相对 π0.5 提升 2.94 点。Easy / Hard 差距只有 0.81 点,说明视觉与几何随机化下的性能保持是主亮点。
项目页在 2026 年 7 月更新了扩展训练结果:100K steps、24 GPU × 12 batch、chunk size 16,Easy / Clean 89.4、Hard / Random 88.6。它说明模型可继续 scale,但由于训练步数、batch 和 action chunk 同时变化,不能据此判断是哪项设计带来约 9.5 点提升。
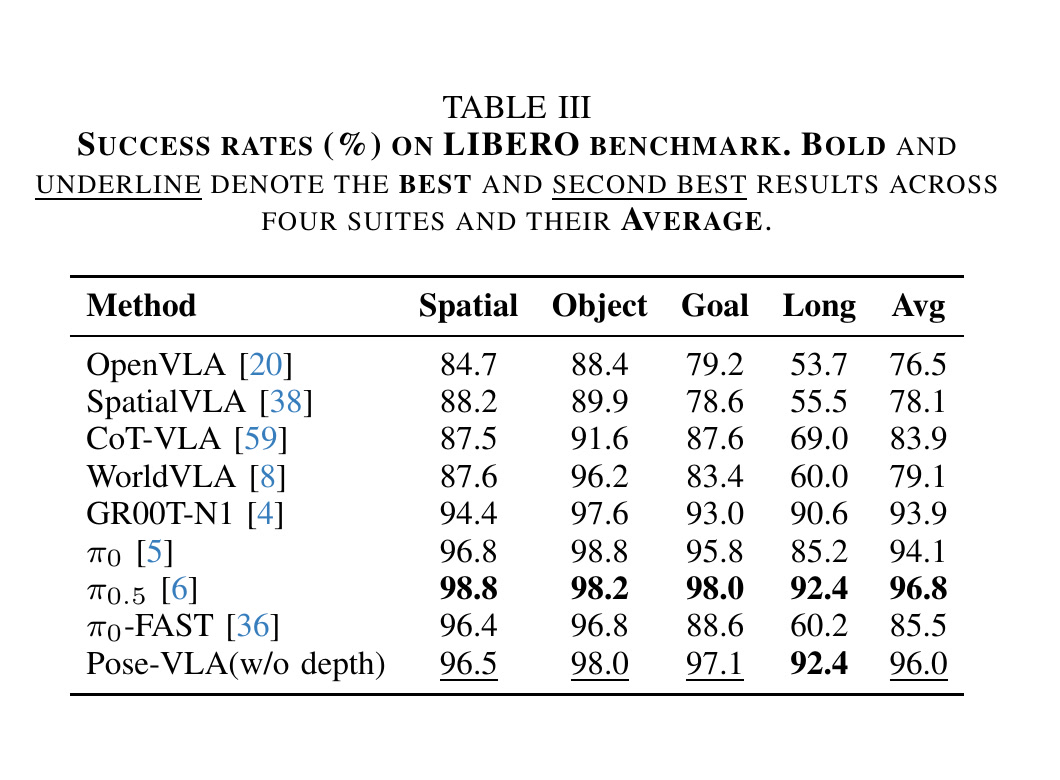
10.2 LIBERO
LIBERO 包含 Spatial、Object、Goal、Long 四个 suite,每个 suite 含 10 tasks、该 suite 内共 500 demonstrations。结果如下:
原论文 Table III。Pose-VLA 在 Spatial / Object / Goal / Long 为 96.5 / 98.0 / 97.1 / 92.4,平均 96.0;平均值低于 π0.5 的 96.8,但 Long 与 π0.5 并列 92.4。来源:论文原文 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
论文称“competitive”比“全面 SOTA”更准确:Pose-VLA 的平均值是第二名,Spatial / Object / Goal 也不是单列第一;最强证据是 Long 达到并列最佳,同时显著高于 π0 的 85.2。
11. 真实双臂实验
11.1 平台与任务
Dual-arm Xtrainer;每臂 1-DoF parallel gripper;
RealSense D455 作为 head-mounted Eye-on-Base;
RealSense D405 作为 Eye-on-Hand;
每任务平均约 100 demonstrations;
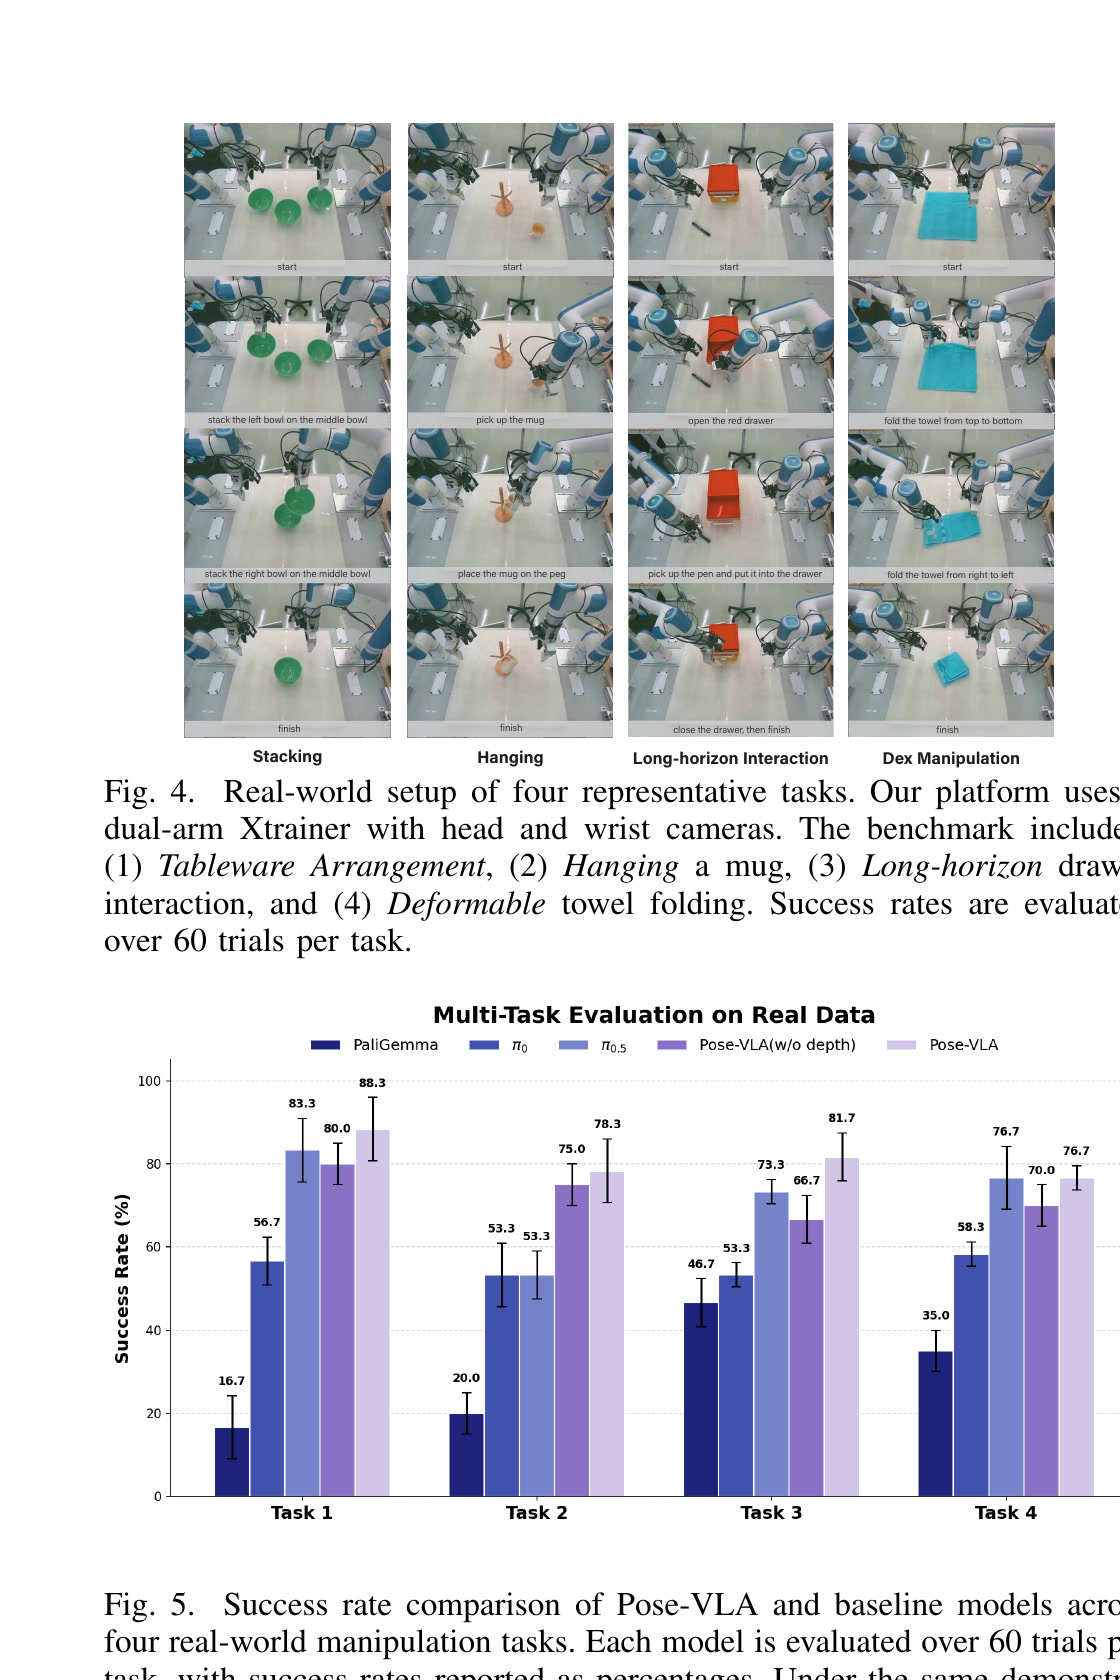
3 random seeds,每 seed 20 trials,总计 60 trials / task。
四个任务:
Stacking:三只套碗堆叠;
Hanging:把杯子挂到木架指定 peg;
Long-horizon Interaction:开抽屉、拿笔放入、关抽屉;
Deformable Manipulation:折叠毛巾。
原论文 Figures 4–5。完整 Pose-VLA 四任务为 88.3 / 78.3 / 81.7 / 76.7,平均 81.25;π0.5 平均 71.65。任务 4 的完整模型与 π0.5 同为 76.7,并非单项全面领先。来源:论文原文 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
11.2 深度贡献
去掉 depth 的 Pose-VLA 为 80.0 / 75.0 / 66.7 / 70.0,完整模型为 88.3 / 78.3 / 81.7 / 76.7:
Stacking:+8.3;
Hanging:+3.3;
Long-horizon:+15.0;
Towel folding:+6.7。
深度在需要精确抽屉几何与多阶段闭环的 Task 3 贡献最大。仿真 RGB-only 结果证明模型可在缺少几何模态时工作,真实结果则证明传感器可用时仍应使用 metric depth。
12. 消融:增益到底来自哪里
12.1 Geometric modalities
原论文 Table IV。SUN RGB-D 上 RGB-only 39.0,加入 depth 达 45.1,完整模型 45.5;Objectron 的 sparse / localized depth 增益较小,完整模型为 87.3。来源:论文原文 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
SUN RGB-D:dense depth 提供大场景 metric context,39.0 → 45.1;raymap 单独为 38.5,不带来正增益。
Objectron:RGB 86.4 已很高;raymap 86.7,depth 85.4,完整模型 87.3。
因此不能单独宣称 raymap 总是有效。表中明确支持的是 raymap 与 depth 联合时得到最佳总体结果 ;raymap 的独立贡献在 SUN RGB-D 上为负 0.5。
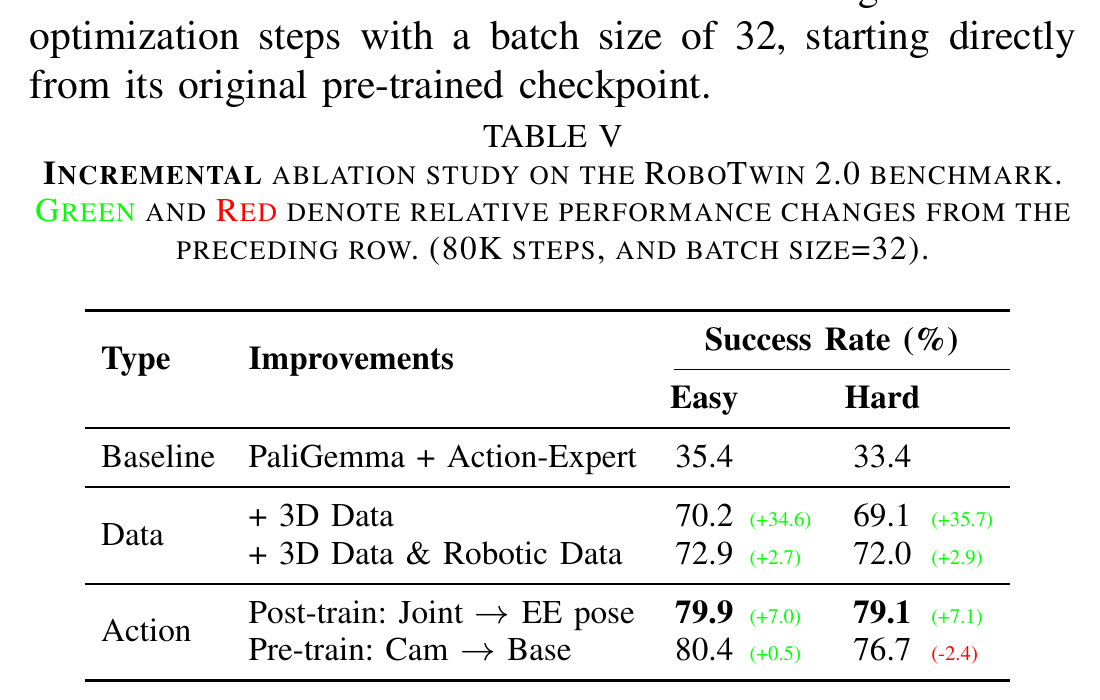
12.2 Data 与 action representation
原论文 Table V。加入非机器人 3D data 是最大单步增益;机器人数据提供约 3 点增量;joint-to-EE pose 再带来约 7 点。把预训练动作从 camera frame 改回 base frame,Hard 下降 2.4 点。来源:论文原文 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
增量配置 Easy Hard 相对上一行的解释 PaliGemma + Action Expert 35.4 33.4 scratch baseline + 3D Data 70.2 69.1 +34.6 / +35.7,最大贡献 + 3D & Robotic Data 72.9 72.0 +2.7 / +2.9,motion alignment 增益 Post-train Joint → EE pose 79.9 79.1 +7.0 / +7.1,动作空间与预训练 pose 对齐 Pre-train Cam → Base 80.4 76.7 Easy +0.5、Hard -2.4,扰动下 camera frame 更稳
“robot data 增量较小”不等于机器人轨迹没用:Table V 是顺序增量,最后 action representation 的收益依赖前面的 trajectory / 3D representation。它只说明在当前数据规模下,通用 3D data 是最大边际来源。
12.3 正交消融
原论文 Table VI(当前截图右侧 Hard 列被裁切,以下完整数值依据论文原表)。Qwen3PI 为 57.7 / 55.3;OpenVLA binning 为 68.5 / 65.9;robot-only data 为 71.3 / 68.3;3D-only data 为 77.2 / 76.2;完整模型 79.9 / 79.1。来源:论文原文 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
三条结论最可靠:
强通用 VLM 不等于强策略 backbone :Qwen3PI 比 Pose-VLA Hard 低 23.8 点。非机器人 3D data 是关键 :3D-only 76.2,robot-only 68.3。表示与数据扩展耦合 :OpenVLA binning 让通用 pose supervision 难以完整转移。
12.4 t-SNE 只能作辅助解释
原论文 Figure 7:20 个 RoboTwin tasks 的 VL features。Pose-VLA 呈现更清晰的 inter-task separation 与更紧的 intra-task clusters,作者据此解释 feature collapse 缓解。t-SNE 会改变全局距离,只能作为可视化支持,不能替代线性 probe 或受控表征指标。来源:论文附录 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
13. 作者主张、证据与本站判断
主张 主要证据 本站判断 pose-centric 预训练缓解 VQA backbone 的 feature collapse PaliGemma 33.4 → Pose-VLA 79.1;t-SNE 任务性能证据强,表征机制证据中等 ;t-SNE 不是因果证明非机器人 3D 数据可转移到控制 +3D data 增益 35.7;3D-only 76.2 支持充分 ,是最强消融结论camera-centric pose 是 universal interface Cam→Base Hard -2.4;EE pose +7.1;跨 3D / robot data 当前平台基本支持 ,跨更多相机标定与移动机器人仍待验证可兼容 RGB-only modality masking;RoboTwin / LIBERO w/o depth 支持 ,但真实任务完整 depth 明显更好少量真实示教即可泛化 四任务、约 100 demos / task、81.25 初步支持 ,任务与平台覆盖仍小几何先验保留长程能力 LIBERO-Long 92.4;真实 long-horizon 81.7 有实验证据 ,但尚未分离视觉几何与策略记忆的贡献
14. 与传统 6D object pose 的关系
14.1 它使用了什么 6D pose supervision
Omni6DPose / BOP 等对象 pose 标注;
camera-centric S E ( 3 ) SE(3) S E ( 3 )
category + 2D anchor + pose / size 的结构化输出;
Objectron / SUN RGB-D 上的 3D grounding AP15 与定性姿态框。
14.2 它没有做什么
没有在 BOP test protocol 上报告 VSD / MSSD / MSPD AR;
没有把部署时 object pose 作为显式、可插拔 API;
没有证明策略成功率可由某个独立 6D pose error 单调解释;
没有在推理时运行 PnP、ICP、render-and-compare 或显式 trajectory estimation。
所以它更适合放在本站的 VLA / 具身智能 分区,而不是与 FoundationPose、MegaPose、SAM-6D 的 BOP 结果直接排名。
14.3 对 6D pose 研究的启发
6D pose annotations 可以成为通用 representation supervision,而不只服务单一 pose head。
object pose 与 end-effector pose 若共享坐标系和 tokenization,可直接连接 perception pretraining 与 control adaptation。
metric depth、intrinsics 和 ray geometry 不一定要成为硬输入,也可通过 modality masking 变成训练期先验。
pose benchmark 的下游价值可以用 policy success 验证,但仍需保留独立 pose metric 才能诊断几何误差。
15. 限制、隐含假设与失败风险
15.1 数据与任务覆盖
pose pretraining 主要来自 rigid-object datasets;deformable task 只在 downstream adaptation 出现。
真实测试局限于静态 tabletop、双臂平行夹爪和四个任务。
没有系统覆盖移动机器人、egocentric camera 或 dexterous hand。
大规模 3D 标注本身并不免费,尤其机器人视频的相机系轨迹需要标定与转换。
15.2 坐标与标定假设
raymap 依赖正确 K K K
camera frame 随相机移动。若相机抖动、rolling shutter 或 hand-eye calibration 偏差未建模,统一 token 会混入系统误差。
Euler angle 离散化存在周期边界和万向节风险;论文未给出对连续旋转拓扑的专门处理。
15.3 Tokenization 风险
2048 bins 在训练分布内提高分辨率,但越过分布尾部时可能量化饱和。
数据分布驱动的 bin edges 可能绑定传感器工作距离;换相机或 workspace 后需重新检查统计。
<trans_xy> 共享 vocabulary 假设横向两轴统计相近,在特殊安装方向下未必成立。
15.4 语义—几何权衡
作者明确承认:强化 spatial priors 可能损伤原 VLM 面对复杂 semantic distractors 时的通用推理。未来需要 semantic-preserving training,而不是默认几何增益没有代价。
15.5 实验口径
RoboTwin Upperbound 同时改变 steps、batch、chunk size,不能作为单变量消融。
论文正文与附录对 action expert initialization 的描述不一致。
3D grounding 置信度全部设为 1.0,不评估 calibration / ranking。
t-SNE 只展示选择后的低维投影,无法量化表征保留的全部信息。
16. 开源状态与复现路径
官方仓库已提供:
VLM spatial training:next-token prediction;
action training:Flow Matching;
3D grounding inference;
RoboTwin evaluation / conversion;
HDF5 与 LeRobot 数据支持;
Stage-1 Hugging Face checkpoint 与 RoboTwin ModelScope checkpoint。
README 给出的主要环境为 Python 3.10.12、PyTorch 2.7.0、CUDA 12.6,并需要 PaliGemma 以及 π0 / π0.5 相关权重。实际复现建议分层:
先用 Stage-1 checkpoint 复查 3D grounding token decode 与 AP15;
固定 camera intrinsics / coordinate convention,验证 object pose token 的 encode-decode round trip;
在小规模 trajectory 上检查 base-to-camera 变换与 EE pose;
明确 action expert 是 scratch 还是 π0 initialization;
复查 80K 公平配置,再单独复现 100K scaling 配置;
同时报告 RGB-only 与 RGB-D,避免把 modality masking 误写成 depth-free 最优。
17. 最终判断
Pose-VLA 最扎实的贡献是一个数据与表示层面的闭环:
non-robotic 3D annotations → camera-centric pose tokens → spatially grounded VLM → EE trajectory alignment → continuous robot actions . \text{non-robotic 3D annotations}
\rightarrow \text{camera-centric pose tokens}
\rightarrow \text{spatially grounded VLM}
\rightarrow \text{EE trajectory alignment}
\rightarrow \text{continuous robot actions}. non-robotic 3D annotations → camera-centric pose tokens → spatially grounded VLM → EE trajectory alignment → continuous robot actions . 论文用强消融证明,性能提升的最大来源确实是通用 3D data,而不是单纯增加机器人示教;EE pose 与 camera frame 又让这些先验更容易迁移到控制。RoboTwin、LIBERO 与真实双臂结果覆盖了扰动、长程和少样本适配,整体证据较完整。
但它还不是“通用机器人空间智能”终点:刚体预训练、固定 tabletop、标定依赖、语义能力权衡和实验初始化口径都需要后续验证。最准确的定位是:Pose-VLA 展示了 pose supervision 可以成为 VLA backbone 的通用预训练信号,而不是证明显式 6D pose 模块已经被端到端策略完全替代。