1. 基本信息
- 作者 / 机构:Elkhan Ismayilzada 等;UNIST、Michigan State University。
- 年份 / 会议:2025 / AAAI。
- 论文页 · 官方 PDF · 项目页
- 阅读模式:精读。
2. 一句话定位
QORT-Former 把“query 不够聚焦”和“decoder 过重”当作手物 pose 实时化的瓶颈:为左右手和物体划分 query,约束 query 落点,再用轻量 decoder 与 contact map 联合恢复 3D pose。
2.1 论文图表导读
| 图表 | 阅读重点 |
|---|
| Figure 2 | encoder feature、hand-object query、三步 decoder、3D keypoint / contact 输出的连线 |
| Figure 3 | 不分区 query 容易偏向左手;proposal loss 的目的不是额外分类,而是改善空间覆盖 |
| Table 1 / 3 / 4 | MEPE、FPS 与 query / contact 消融应一起看,不能只看精度 |
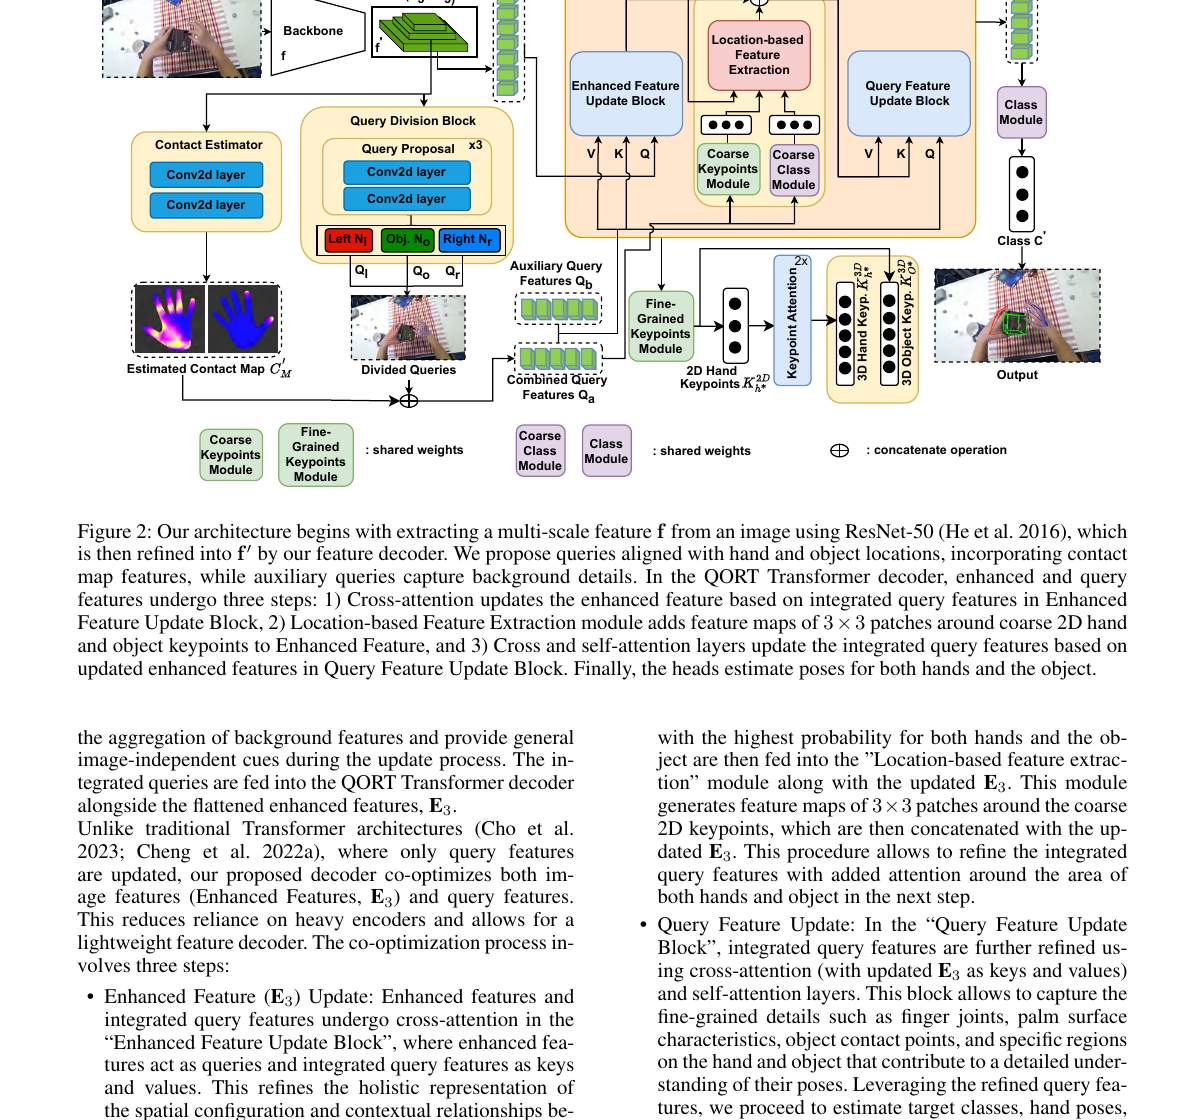 原论文架构所在页局部:分区 hand-object queries 与三步 decoder。来源:AAAI 官方 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
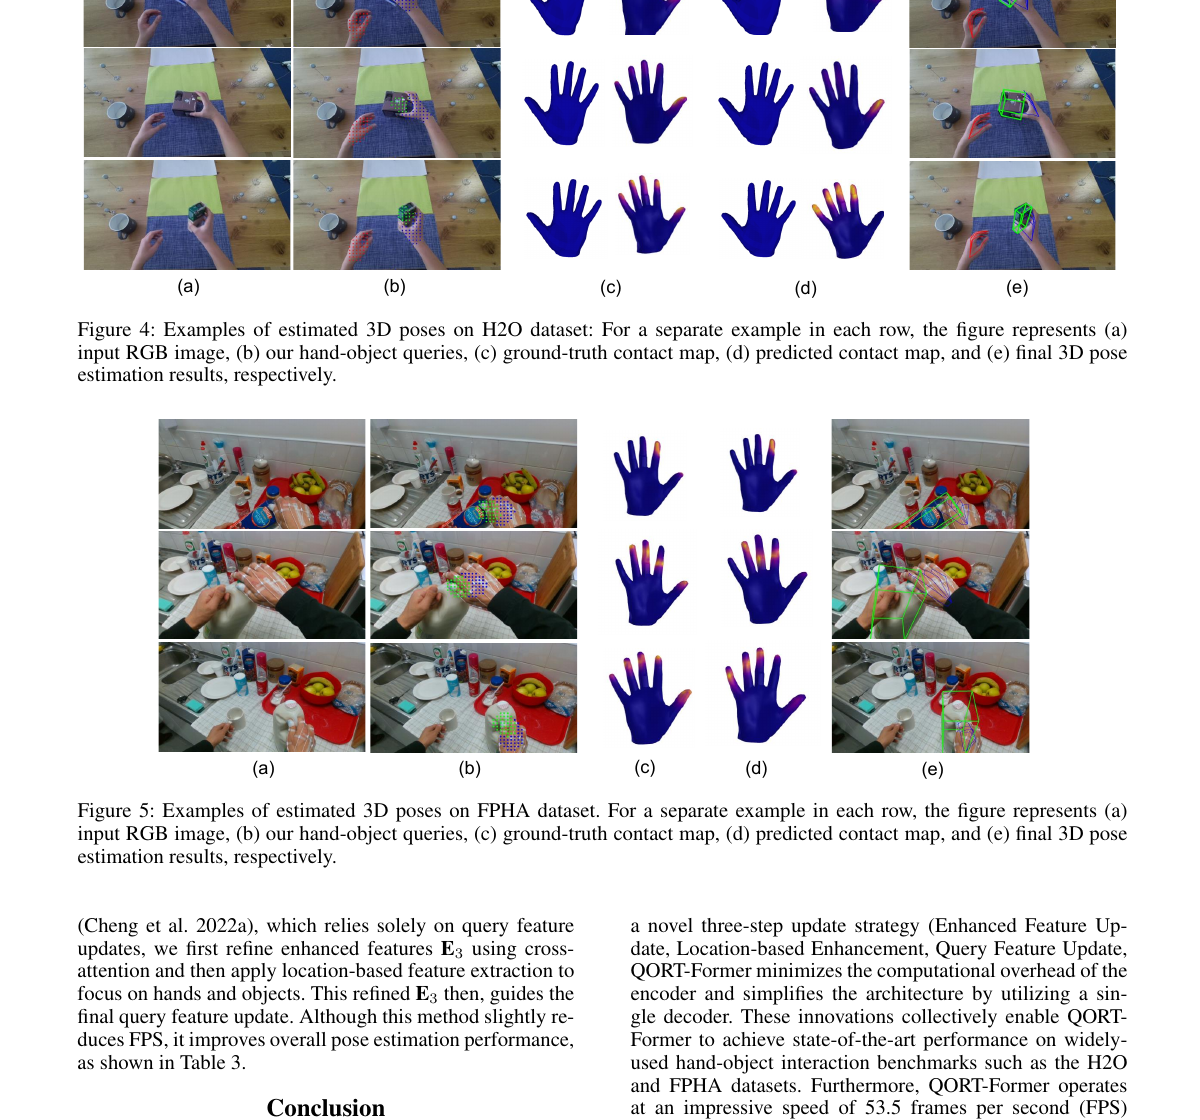 原论文 H2O 定性结果所在页局部:RGB、query、contact map 与最终 3D pose。来源:AAAI 官方 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 任务边界
- 输入是一张 RGB;输出为左右手 21 个 3D joints、物体 3D keypoints / pose 以及 contact relation。
- H2O、FPHA 的评价是 keypoint mean end-point error(mm),并不是 BOP 的 ADD(-S)、VSD 或完整 CAD 6D pose 排名。
- interaction recognition 是扩展实验:用其 pose estimator 替换上游,测下游 Top-1 accuracy 与速度。
4. 方法详解
| 组件 | 机制 | 为什么需要 |
|---|
| Hand-object query division | 为 left / right / object 预留 query 子集 | 防止相似手部特征抢占同一组 query |
| Query proposal loss | 对每类 query 做位置 / 类别监督 | 使 query 落在目标区域,减少背景 token 浪费 |
| 三步 QORT decoder | Enhanced Feature Update → Location-based Feature Extraction → Query Feature Update | 用较少 decoder layer 保留图像–query 交互 |
| Contact map loss | 预测双手网格顶点接触关系 | 给遮挡下的手–物相对空间关系加入约束 |
论文使用 108 queries、1 个 decoder。这里的“query optimized”不是仅减少数量:如果没有分区与 proposal supervision,少 query 很可能只是更快地遗漏右手或物体。
5. 实验与数值
| 数据集 | 指标 / 论文结果 | 对照理解 |
|---|
| H2O | left / right / object MEPE = 20.1 / 19.9 / 32.9 mm | 同表 Cho et al. 为 24.4 / 25.8 / 45.2 mm |
| FPHA | right / object MEPE = 14.2 / 18.8 mm | 同表 Cho et al. 为 15.0 / 21.0 mm |
| 速度 | 53.5 FPS(RTX 3090 Ti) | 完整模型比去掉 LFE 的版本略慢,但精度更好 |
| interaction | H2O Top-1 = 91.3 | 使用其 pose estimator 替换 H2OTR 上游,原文比较值为 90.9 |
消融显示:H2O 上无 hand-object query 时 left / right / object 为 27.3 / 33.5 / 36.5 mm;加入分区 query 为 22.6 / 21.4 / 33.1,再加 contact 为 20.1 / 19.9 / 32.9。这个趋势说明 contact 对手部更显著,但 object 也有改善。
6. 批判性分析
优点:明确把实时性作为设计指标;分区 query 的失败模式可视化;速度、精度、interaction 下游都被报告。
局限:object 用固定 keypoints 表示,和任意 CAD object 的完整 6D pose 仍有距离;多个手 / 多个物体、重度 motion blur、显著类别外物体不在主实验核心;53.5 FPS 取决于 GPU 与前端实现。
启发:实时 pose 系统可先把计算预算分配给实体(hands / object),再做跨实体交互;对工业操作,可把 contact map 换成 grasp affordance 或碰撞约束,并为每个 entity 保留 query confidence。
