论文精读笔记:Recurrent Feature Mining and Keypoint Mixup Padding for Category-Agnostic Pose Estimation
1. 核心判断
- 论文:CVF Open Access
- 关键问题:few-shot category-agnostic keypoint pose 既要将 support 的可变关键点语义迁到 query,又要定位像素级细节;固定长度 zero padding 与单层 attention 都不足。
- 核心回答:递归的 fine-grained / structure-aware feature mining + keypoint mixup padding。
2. 一句话定位
这篇工作不是刚体 6D fitting,而是一种将少量 support annotation 迁移到任意新类别 query 的 2D semantic keypoint localization 方法。
2.1 论文图表导读
| 图表 | 应该看什么 |
|---|
| Figure 1 | 既有 zero padding / single-scale 流程与方法的 recurrent FGSA mining 对比。 |
| Figure 3 | mixup padding 如何在不伪造全零监督的前提下统一 keypoint 数。 |
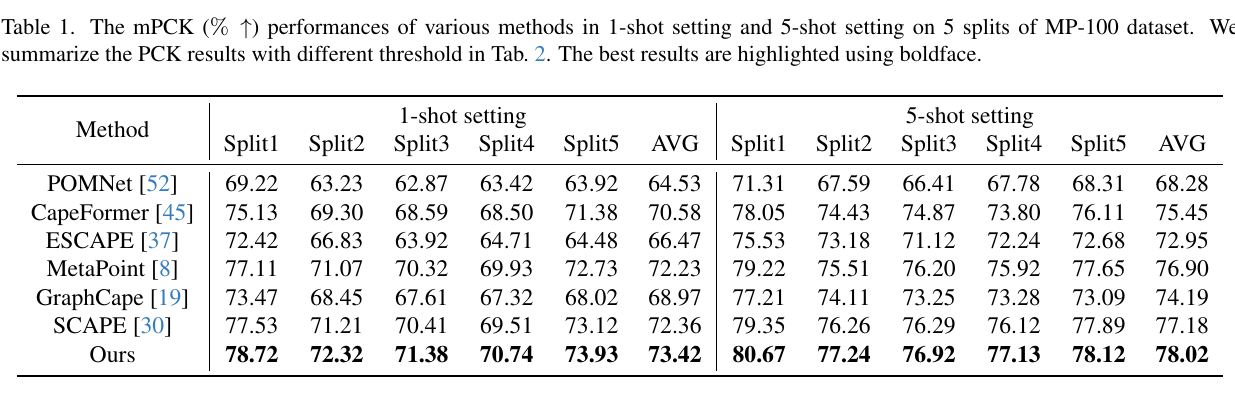
| Table 1 | MP-100 五个 split 上的 1-shot / 5-shot mPCK。 |
| Table 2–4 | 多阈值 PCK、各模块和不同模型版本的消融。 |
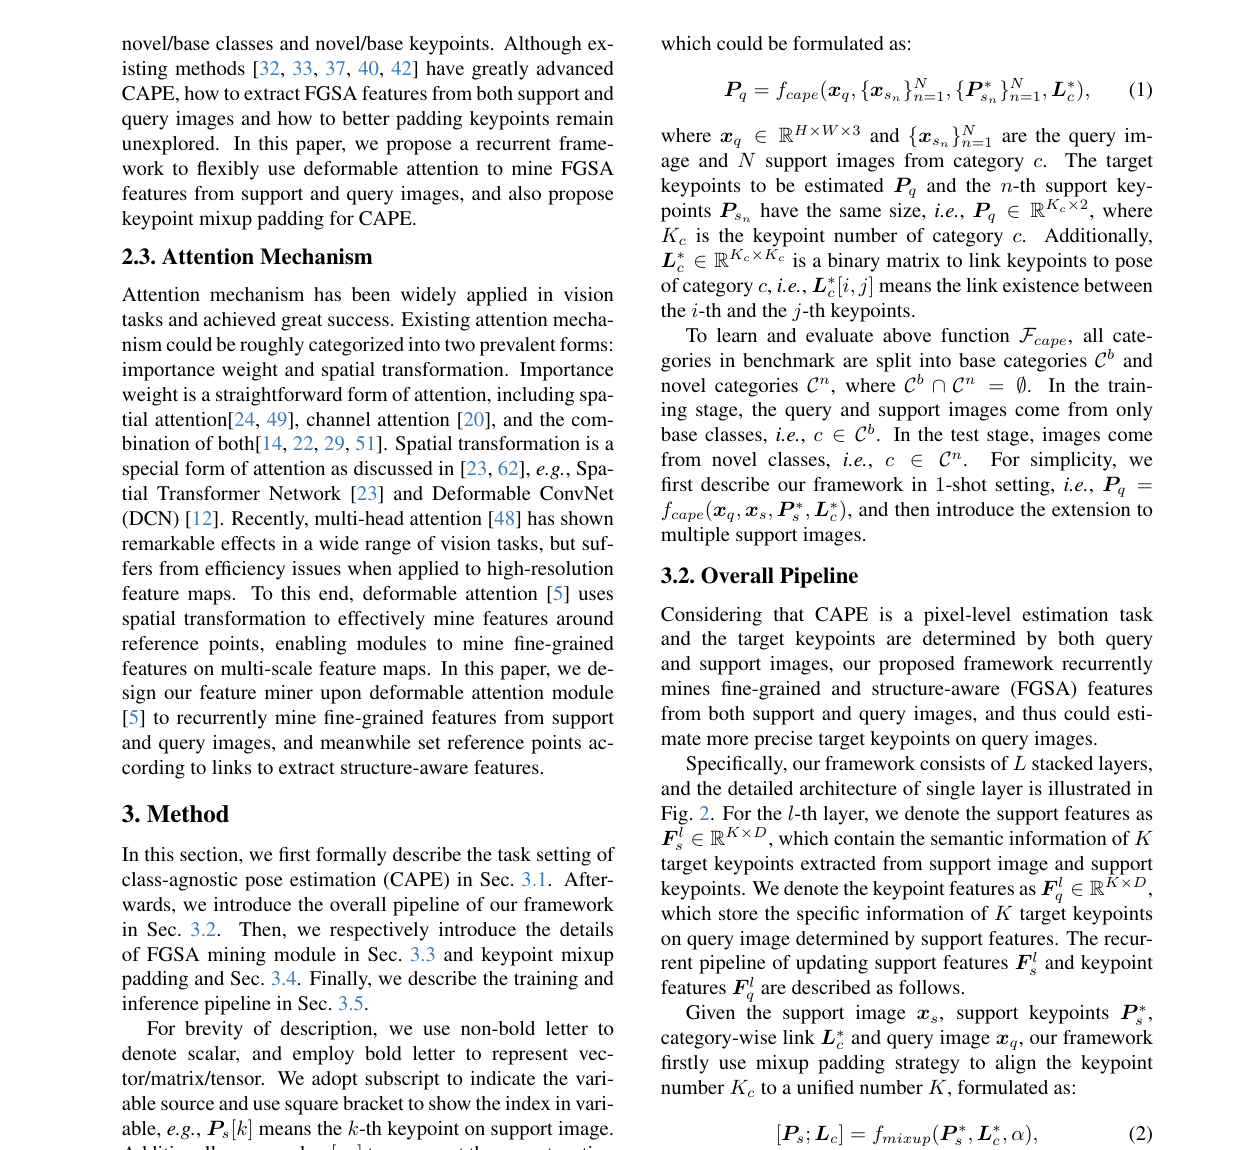 原论文任务定义与方法说明页:包含 attention mechanism、category-agnostic keypoint 任务定义和 recurrent FGSA / mixup padding 的文字及公式说明;当前图片不是架构图。来源:CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与边界
- support images 提供 keypoint annotation,query 来自任意新类别;输出 query 上对应 keypoints 的 2D location。
- 这不是 RGB-D 6D object pose;没有 CAD coordinate 或 PnP 的情况下,不能以 ADD / BOP AR 衡量。
- “category-agnostic”仍依赖 support labels 的定义和同一任务的 semantic correspondence。
4. 方法详解
- FGSA mining:deformable attention 从多尺度 map 获取 fine-grained keypoint features;由 linked keypoints 的 offset 提取 structure-aware clues。
- Recurrent support-query update:将改进后的 support feature 和 query estimate 反复反馈,而不是仅进行一次 cross-attention。
- Mixup padding:对不同类别的 keypoint count,以 mixup keypoints 补齐固定 tensor shape,避免 zero entries 没有监督语义。
5. 实验分析
- MP-100 的 1-shot / 5-shot 五 split mPCK 是主结果;论文还明确报告相较已有 SOTA 在 PCK@0.05 增加 3.2 个百分点。
- 评价应同时看严格阈值与宽松阈值:若只在宽松 PCK 提升,不能证明 pixel-level localization 改善。
- mixup padding 要和 keypoint number / category composition 共同消融,否则可能把 split 统计差异错归因给 padding。
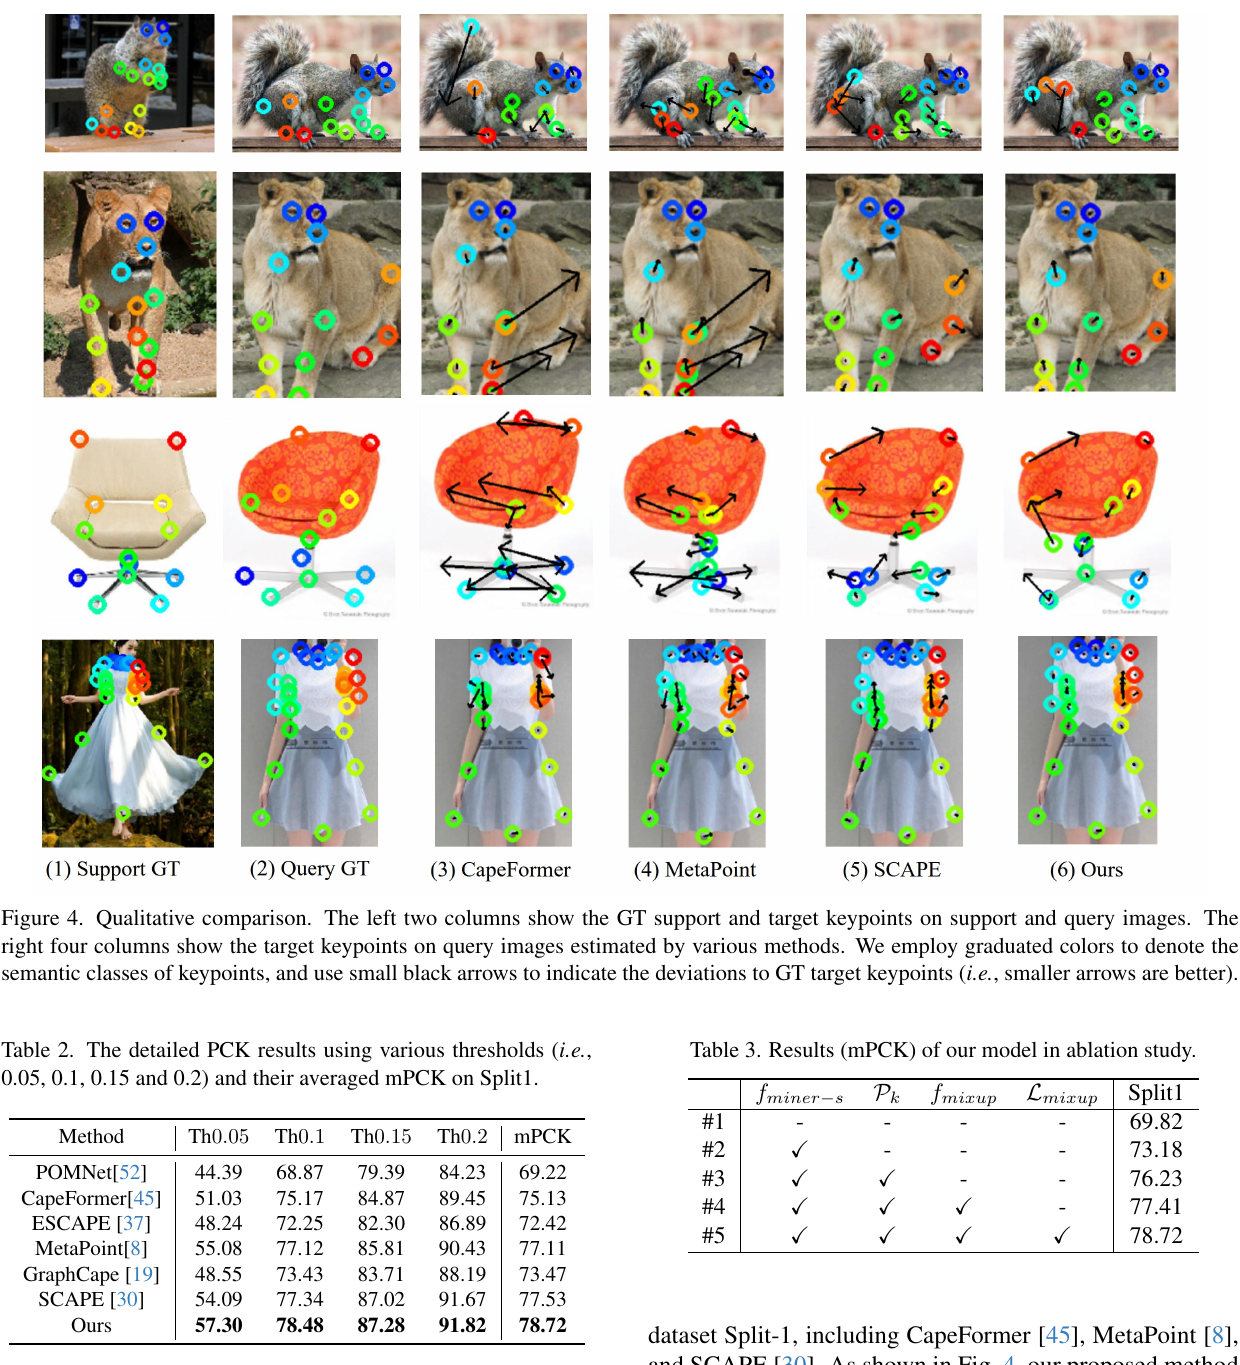 原论文 Figure 4 / Table 2–3:彩色圆点为关键点,黑箭头越短表示预测越接近 GT;下方表格分别给严格到宽松的 PCK 和逐步加入 recurrent mining、structure-aware reference、mixup padding / loss 的结果。来源:CVPR 2025 原论文。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
Split-1 1-shot 的 PCK@0.05 / 0.1 / 0.15 / 0.2 为 57.30 / 78.48 / 87.28 / 91.82,mPCK 78.72。最接近的 SCAPE 为 54.09 / 77.34 / 87.02 / 91.67,差距分别 3.21 / 1.14 / 0.26 / 0.15。提升随阈值放宽快速缩小,说明方法主要改善精确落点,而不是仅让粗位置更容易命中;这正好对应 deformable fine-grained mining 的动机。
逐模块消融从 baseline 69.82 开始:加入 recurrent support feature mining 为 73.18,再加入结构感知 reference points 为 76.23,启用 mixup padding 为 77.41,最后加入 mixup loss 达 78.72。四步都递增,其中前两步贡献更大;mixup padding + loss 贡献 2.49 mPCK,说明可变 keypoint count 的处理不是主收益全部来源,但确实提供了额外监督。
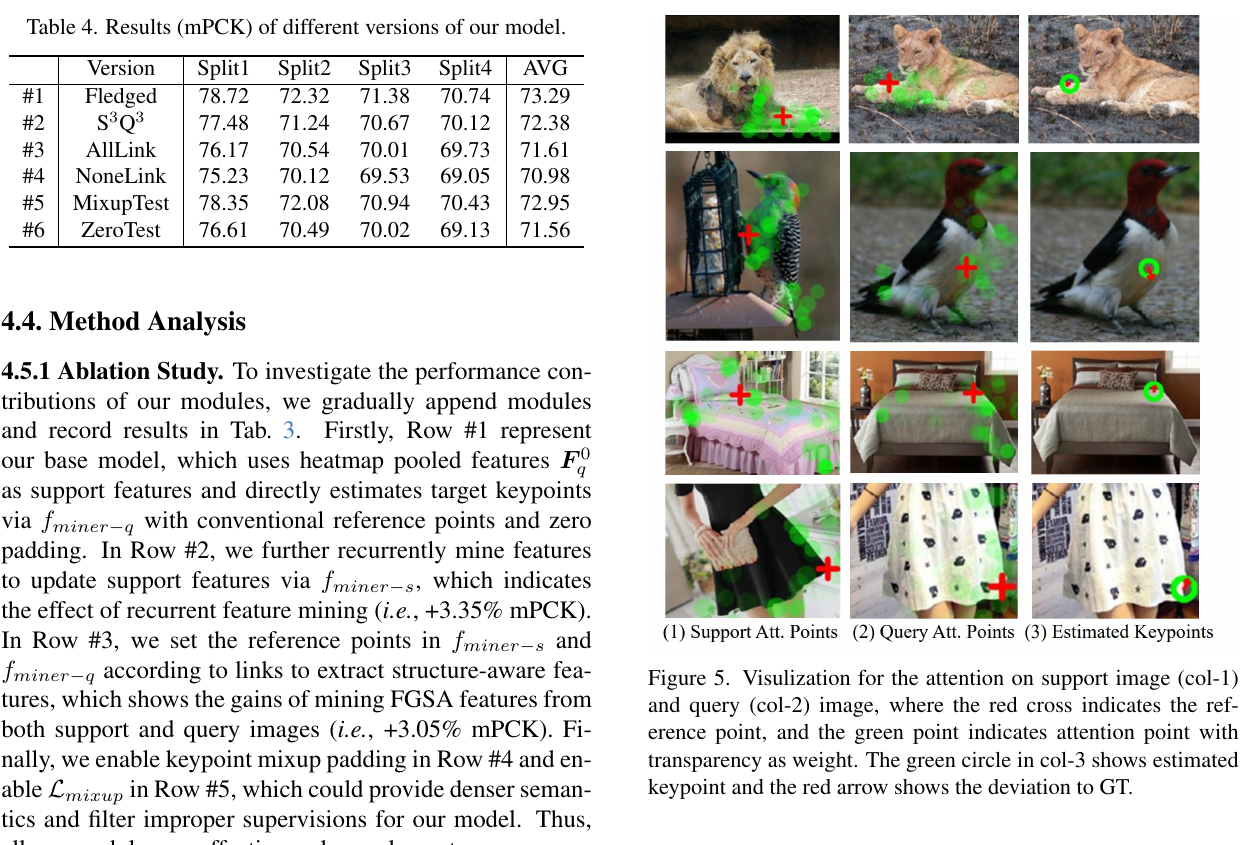 原论文 Table 4 / Figure 5:左表比较 recurrent / stacked、link graph 与测试期 padding;右图显示 deformable attention 在 support 和 query 上采样到的结构区域及最终关键点。来源:CVPR 2025 原论文。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
Table 4 的 Split 1–4 四个 split 平均上,完整 recurrent 模型为 73.29;改成常规 stacked 版本为 72.38,把类别 link graph 改成全连接 / 仅自连接为 71.61 / 70.98,说明结构图不是装饰。测试期使用随机 MixupTest 为 72.95,ZeroTest 为 71.56,均低于统一 padding 的完整配置;训练期可以用 mixup 增强监督,但测试期随机混入其他关键点会引入噪声。
注意力可视化中,采样点沿狮子腿、鸟身体、床边缘和衣物结构分布。它是对“结构感知”的定性支持,但不能单独证明注意力点具有语义可解释性;最终仍应以严格 PCK 和遮挡 / 密集关键点分组作为证据。
6. 作者声称与我的判断
| 作者声称 | 我的判断 |
|---|
| recurrent FGSA 有利于精细定位 | PCK@0.05 的改善方向与动机一致;应进一步显示遮挡、细长结构和稀疏关键点分组。 |
| mixup padding 优于 zero padding | 合理且可由 Table 4 验证,但需要保证 mixup 不引入语义泄漏。 |
7. 复现要点与限制
- 必须保持 MP-100 split、support sampling、keypoint linkage graph 与 image resize 的一致性。
- 此类方法对 support keypoint 标注质量极敏感;support 缺失或错误时 recurrent 机制可能放大偏差。
- 若要进入 6D pose pipeline,还需引入 3D keypoint / CAD、PnP 与对称性处理。
- 网站将它收录为“广义 object pose / keypoint”相关论文,但详情页应持续标注其输出是 2D semantic keypoints,避免读者把 78.02 mPCK 误认为 6D pose accuracy。