RelPose++ 精读
1. 为什么 pairwise 信息不够
两张图中的对称对象可能存在多个同样合理的 relative rotations:只看到无把手一侧的杯子,无法判断把手在背后还是另一侧;第三张图一旦露出把手,前两张的歧义就能消除。原 RelPose 虽通过 pairwise energy 分布表达不确定性,但每一对的分布仍只看两张图。RelPose++ 用 Transformer 在预测任意 pair 前先聚合全部输入图像。
2. Rotation:分布而非单值
图像特征与候选相对旋转一起送入 energy model,得到 P(Ri→j∣I1,…,IN)。推理时寻找一组全局 rotations,使所有 pairwise 分布的总能量最高。与直接 rotation regression 相比,它可以保留多峰假设,并通过全局一致性选解。
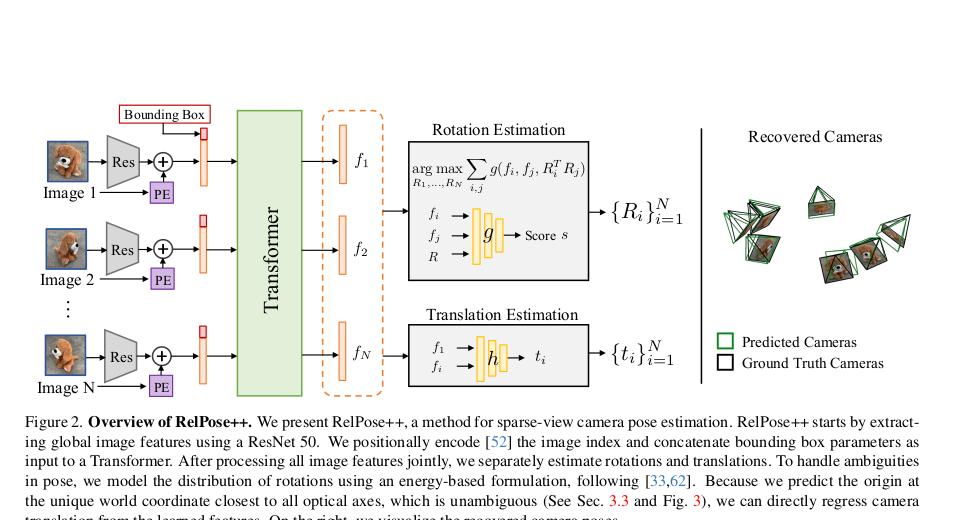 rotation 通过 energy-based pairwise distribution 与全局优化恢复,translation 则由单独 head 在新坐标系下预测。来源:原论文 Figure 2;版权归原作者及 3DV 2024 出版方所有,本站仅作学术解读。
3. Translation:坐标系比网络更关键
若把第一台相机设为世界原点,其他相机的 translation 数值会随第一帧 rotation 误差改变,网络等于同时补偿两个任务。论文假设对象图像大致 center-facing,以各相机光轴交汇附近为世界中心,并规范整体尺度。这样 translation 更接近“相机绕对象的相对位置”,与某一帧的 rotation 误差弱耦合。
消融中,seen 8-view camera-center accuracy:look-at frame 为 85.5,first-frame centered 为 77.7;unseen 为 67.5 vs 65.3。translation 专用 accuracy 在 seen 8-view 为 86.2,constant baseline 56.5;unseen 为 73.6 vs 48.2。
4. 实验拆解
CO3D v2 使用 41 类训练、10 类留出,约 22,375 sequences / 2.21M images。每组随机采样 2–8 张图。rotation 统计 pairwise angle error<15°;camera center 先做最优 7DoF similarity alignment,再统计误差小于场景尺度 20% 的比例。因此结果衡量的是“相机组内部结构”,不是绝对世界尺度定位。
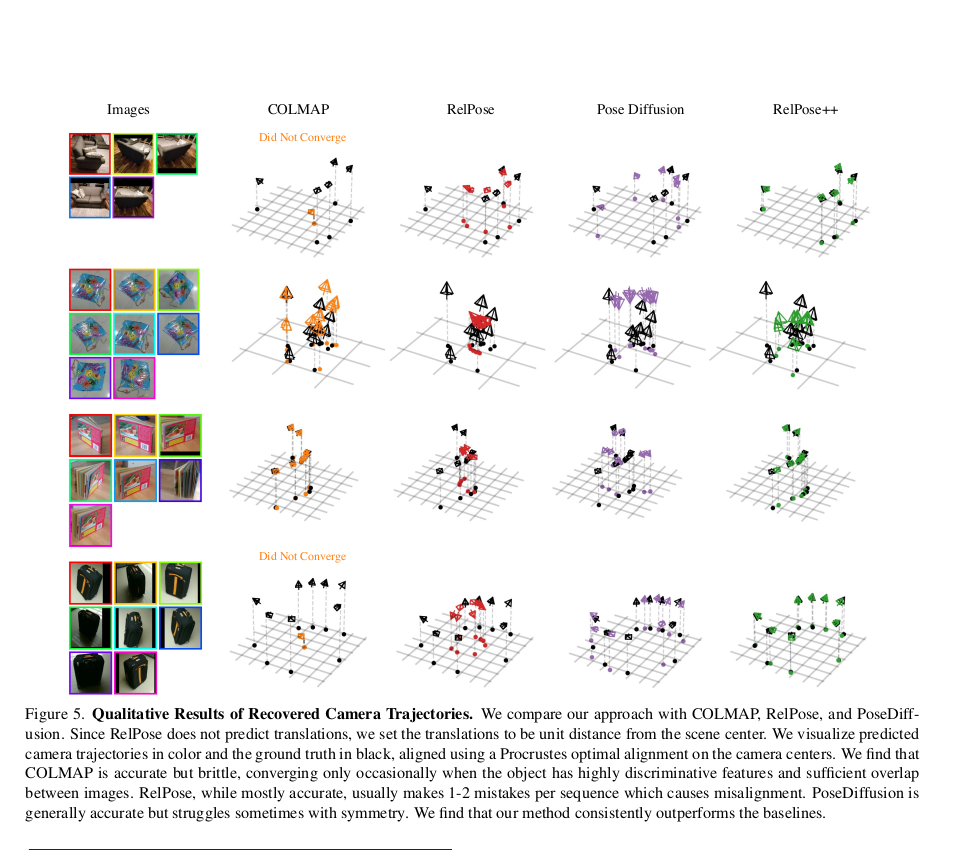 COLMAP 成功时很准,但在稀疏宽基线图像上常无法形成足够匹配;学习方法更稳定但只提供粗 pose。来源:原论文 Figure 5;版权归原作者及 3DV 2024 出版方所有,本站仅作学术解读。
8-view camera-center accuracy:
- seen:COLMAP 19.2,PoseDiffusion 73.7,RelPose++ 85.5
- unseen:COLMAP 25.3,PoseDiffusion 55.1,RelPose++ 67.5
多视图 rotation 消融中,N=2 variant 从 2 到 8 张维持约 69.8→71.2;Full 从 69.8 升到 74.9。这直接支持“上下文在视图更多时消解歧义”,而不仅是模型容量增加。
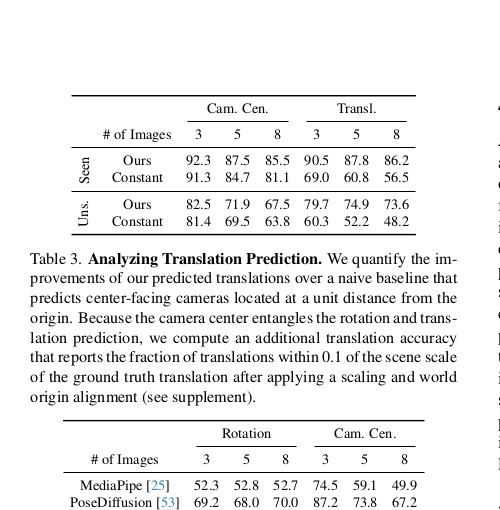 当前截图上方为 Table 3 的 camera-center / translation 回归与 constant 基线比较,下方只含 Table 4 表头及部分方法行,并未显示 look-at / first-camera 坐标系消融。来源:原论文 Table 3–4;版权归原作者及 3DV 2024 出版方所有,本站仅作学术解读。
Objectron 零样本测试中,8-view rotation/center 为 77.0/77.6,高于 PoseDiffusion 70.0/67.2,显示 CO3D 训练的对象级先验能跨数据集迁移。论文还将输出送入 NeRS,证明 pose 足以作为重建初始化。
5. 局限
- roughly center-facing 是关键假设,普通场景相机轨迹未必满足光轴交汇模型。
- energy-based rotation 分布采样与全局优化计算较重,且仍由 pairwise factor 组成。
- 相似变换对齐会消除尺度、原点和全局 rotation 误差;不能据此宣称获得 metric absolute pose。
- 经典 SfM 一旦收敛通常更精确,RelPose++ 的角色是提高初始化/收敛概率。
- 对输入裁剪、背景和类别先验的依赖可能使野外非对象中心图片退化。
6. 我的判断
RelPose++ 的两点可长期复用:用多视图上下文更新 pairwise uncertainty,以及先设计可学习、低耦合的坐标系再回归 translation。它不是 BOP pose 方法,却是少视图无 CAD 对象建模的重要前置模块。
