论文精读笔记:AlignPose: Generalizable 6D Pose Estimation via Multi-view Feature-metric Alignment
1. 核心判断
2. 一句话定位
对多张标定 RGB 观测,AlignPose 先聚合 per-view pose candidates,再用冻结 foundation feature 对当前 mesh 的 on-the-fly render 做联合 refinement。
2.1 论文图表导读
| 图表 | 精读问题 |
|---|
| Figure 1 | pose candidate 的 world-frame conversion 和 NMS 如何影响后续优化? |
| Figure 2 | feature discrepancy 在多视角之间如何共享一个 SE(3) 参数? |
| Table 1 | YCB-V、T-LESS 上多视角是否稳定超过 CosyPose MV? |
| Table 2 | HouseCat6D 的 metallic / glass 子集是否受益? |
| Table 3 | ITODD-MV、IPD、XYZ-IBD 的工业提升来自多视角还是 feature model? |
| Table 6 | DINOv3 与 dense SIFT 的差距是否说明语义 feature 是关键? |
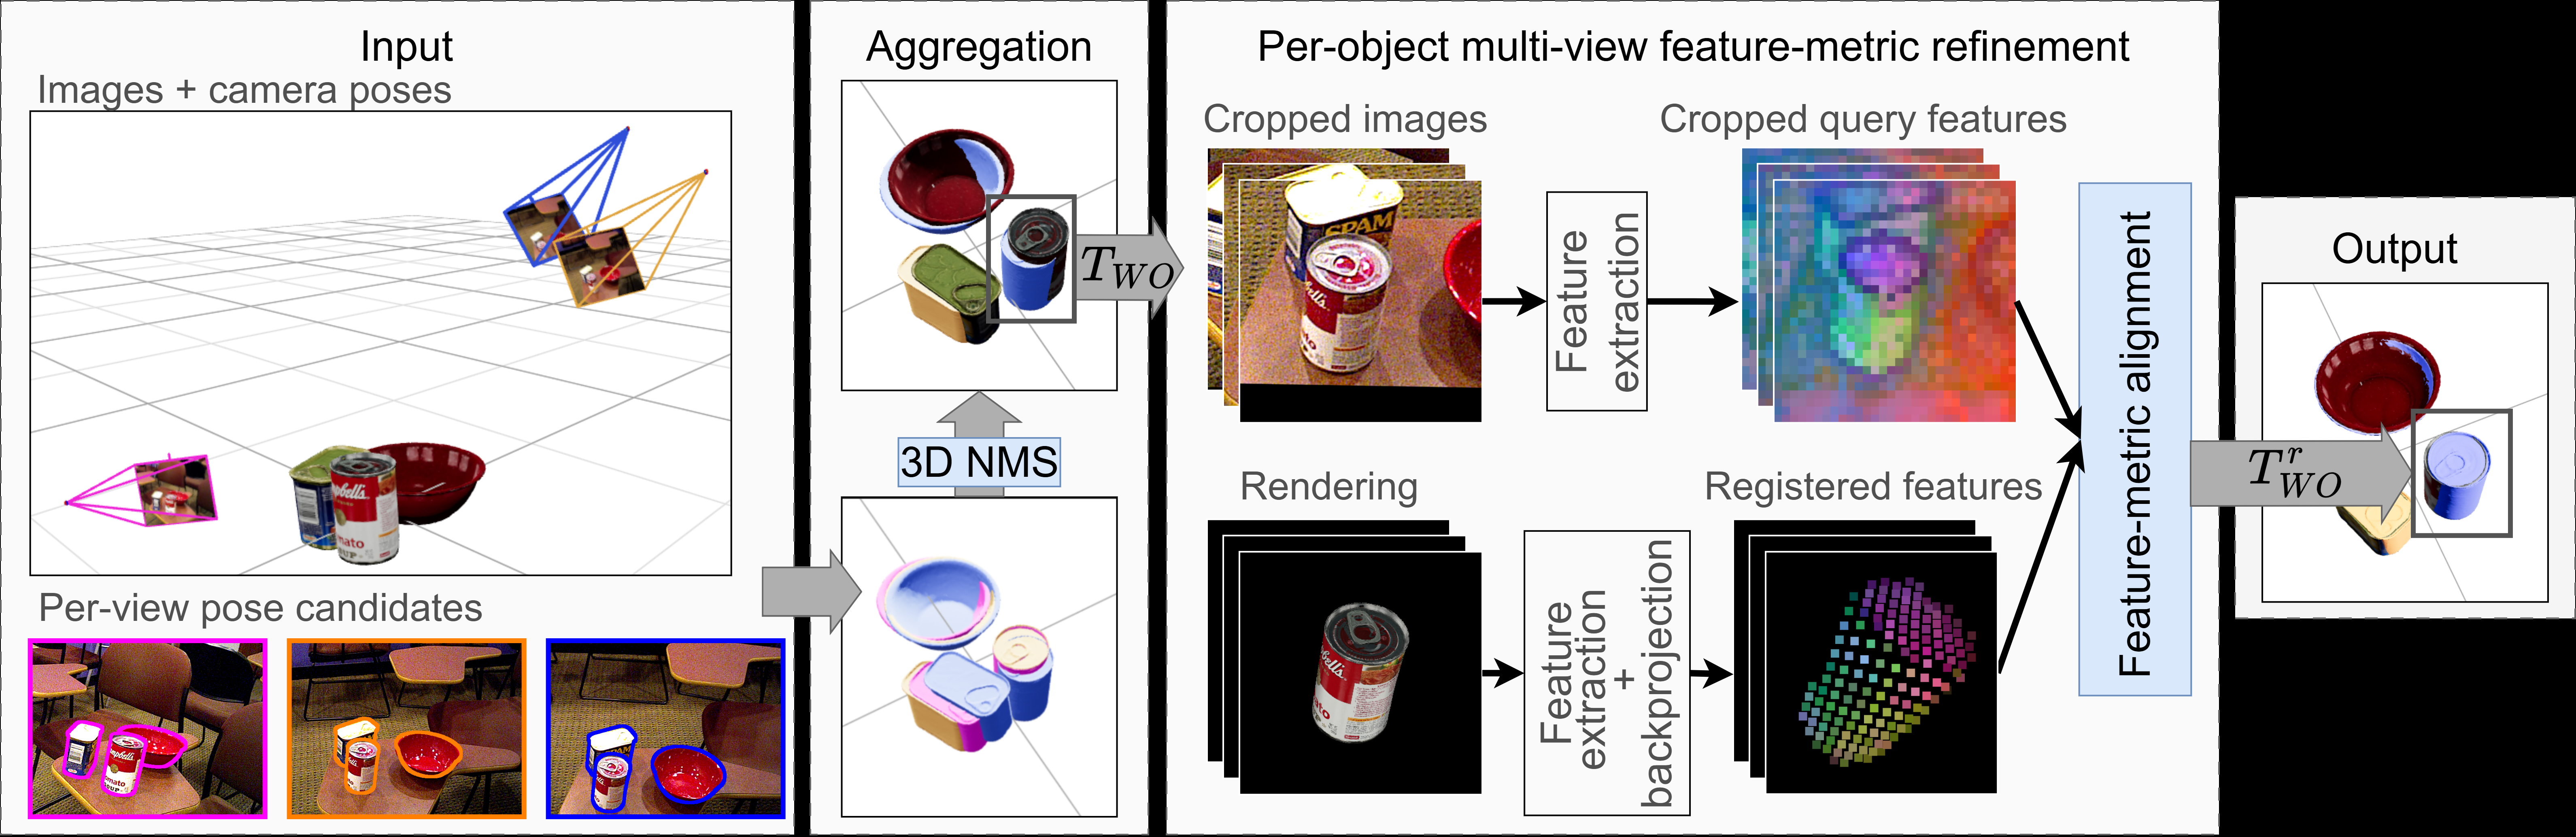 原论文方法图中的相关区域:多视角候选被统一到 world frame 后,通过 feature-metric alignment 得到一个一致的物体姿态。来源:项目页 / CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
- 已知 object mesh、camera intrinsics/extrinsics 和多张 RGB 图像,物体 pose 表示为 TWO∈SE(3)。
- 不需要训练时见过测试物体,也不需要对称性 annotation;对称性通过 multi-hypothesis / BOP evaluation 处理。
- object detections / masks 由前端提供,工业数据集使用外部 detector 与 SAM2 等组件。
- 这是 model-based but generalizable 的路线:它不要求 target-specific fine-tuning,但需要 mesh at inference。
4. 研究脉络
- 单视角 render-and-compare 容易受遮挡、外观歧义与低纹理影响。
- 多视角方法通常融合多个 pose candidate,或使用多视角重建;前者可能出现不一致,后者依赖更重的几何 pipeline。
- feature-metric refinement 将图像对齐从像素亮度转到 feature space,适合光照变化和 texture-less object;AlignPose 将这一思想推广到多视角共同优化。
5. 研究动机
- 工业场景常有多个固定相机,多视角是可用资源而不是额外负担。
- 每个视角单独估计会在遮挡和对称性下产生不同候选,必须把它们约束到一个 world pose。
- 像素级 photometric error 对反光、透明和光照变化不稳,foundation feature 更适合捕获结构和语义相似。
- 直接从 mesh render feature 并对 pose 求梯度,可以省去人工匹配点和重新训练的 refinement head。
6. 方法详解
6.1 Candidate aggregation
- 每个视角先由现有 single-view estimator 生成 pose candidates。
- 将相机坐标中的 pose 变换到 world frame,按位置、旋转和投影一致性聚合。
- 使用 multi-view NMS / hypothesis filtering 保留可能属于同一个物体状态的候选。
6.2 Feature-metric refinement
- 冻结 image foundation model 为每个观测生成 feature map。
- 在当前 TWO 下对 object mesh 做 differentiable render,得到 rendered feature map。
- 用投影关系把 rendered feature 与真实图像中的 feature 对齐,计算 feature discrepancy。
- 多个视角共享同一个 TWO,总损失是各视角 discrepancy 的聚合。
6.3 为什么不需要 symmetry annotation
- 训练和 refinement 使用视觉 feature 与几何投影,不要求为每个物体预先标记对称轴。
- BOP 的 VSD / MSSD / MSPD 会在评测时处理对称等价性。
- 但实际优化仍可能存在多个局部最优,因此 candidate 数量和初始化质量依然重要。
7. 实验分析
7.1 数据与指标
- BOP-Classic:YCB-V、T-LESS;HouseCat6D 还报告 metallic / glass 子集;工业部分为 ITODD-MV、IPD、XYZ-IBD。
- YCB-V / T-LESS 的多视角输入按场景采样 4-view groups;工业数据集使用预定义视角。
- BOP-Classic 报告 AR,工业数据集主要报告 AP,因为 BOP-Industrial 不提供同样的 AR 评测。
7.2 主结果
- Table 1:YCB-V 上 Ours 的 AR 为 83.9 / 83.2(按不同 single-view candidate 来源),T-LESS 上为 84.1 / 88.6,稳定超过对应 multi-view baseline。
- HouseCat6D 上,feature-metric refinement 对 metallic 与 glass object 仍有提升,说明它不只依赖纹理。
- 工业数据集上,论文报告相对公开 RGB baseline 提升超过 14%,验证多视角 world-frame refinement 对遮挡与反光物体的价值。
7.3 消融
- 只聚合候选而不做 refinement,提升有限;加入 feature-metric refinement 后精度明显提高。
- frozen foundation feature 比 dense SIFT 更有效,Table 6 显示特征语义与跨域泛化是重要因素。
- single-view refinement 不如 multi-view refinement,因为后者用多个视角共同限制同一个 pose。
8. 批判性分析
- 优势:利用真实工业中已有的多相机,优化目标明确且可解释。
- 初始化依赖:如果所有单视角 candidates 都落在错误对称分支,feature refinement 也可能无法恢复。
- 工程依赖:需要 mesh、相机标定、检测 / mask 和可微渲染;相机外参漂移会伪装成 pose 误差。
- 计算代价:每个候选、每个视角都要 render 和 feature alignment,实时性取决于视角数与优化迭代。
9. 对我的研究的启发
- 多视角 pose 可以把“结果融合”改成“共享 world pose 的联合优化”,自然得到跨视角一致性。
- 视觉 foundation features 与几何 render 的结合可以作为无 target-specific training 的通用 refiner。
- 可加入 visibility-aware weighting,让被遮挡或反光严重的视角降低对总 pose 的影响。
10. 待解决问题
- 如何在未知相机外参或相机运动中同时优化 camera pose 与 object pose?
- 如何使用 uncertainty-aware candidate aggregation,避免错误 hypothesis 主导 refinement?
- 如何将多视角 feature-metric alignment 扩展到 deformable / articulated object?
11. 精读补充:多视角候选不是终点
11.1 方法的联合优化目标
AlignPose 的输入是多张 calibrated RGB images、每张图的相机 pose、物体 mesh 和 per-view pose candidates。候选先通过 TWO 变换到共同 world frame,再以一个共享的 object-to-world pose 做 feature-metric refinement:渲染 mesh 的 DINO / foundation features,与真实 crop 的 frozen features 比较,优化 SE(3) pose,而不是独立优化每个视图。
这点很关键:单视角 candidate aggregation 只是在 hypotheses 之间投票;真正的 multi-view gain 来自“所有视角必须解释同一个 TWO”。视角中不可见、反光或分割错误的区域可以通过 visibility / feature weighting 降低影响,但论文当前仍需要较好的输入 candidate、mask、mesh 和 camera calibration。
11.2 主要结果
Table 1 的两个跨数据集例子:在 YCB-V / T-LESS 上,CosyPose MV 的 AR / AP 为 79.2 / 76.1 与 66.4 / 63.0;加入 AlignPose 后为 83.9 / 83.2 与 84.1 / 88.6。其他数据集也呈现候选聚合后再 refinement 的一致提升。
在 BOP-Industrial 中,FoundPose 的 AP 为 31.4 / 32.5 / 41.2,加入 AlignPose 后为 79.8 / 66.5 / 76.8(对应 IPD、XYZ-IBD、ITODD-MV)。作者因此报告工业场景超过 14% 的整体提升;这里的 AP 是 BOP 的 pose-aware detection 指标,不要和普通分类 AP 混淆。
11.3 Foundation feature 消融
Table 6 表明 DINOv3 不同 backbone / layer 的结果差异不大但稳定:DINOv3-L layer 18 在两个示例数据集上为 AR / AP 84.5 / 84.1 与 89.0 / 92.0,layer 23 为 84.1 / 83.9 与 89.6 / 91.6;相比 DINOv2-S layer 9 的 80.8 / 80.7 与 87.6 / 90.7 有明显收益。论文还讨论 dense SIFT,说明 frozen semantic features 的跨域能力比局部纹理更适合作为 refinement objective。
11.4 作者声称与我的分析
| 作者声称 | 我的判断 |
|---|
| 多视角 feature alignment 提升 unseen-object 泛化 | YCB-V / T-LESS 与工业 AP 支持,但 improvement 依赖 mesh、calibration 与初始 candidates。 |
| foundation features 比传统 dense SIFT 更好 | layer 消融支持;仍需报告背景、金属和透明物体的 feature confidence。 |
| refinement 比单纯 pose averaging 更有效 | 多视角共享 TWO 的结构是合理解释,但建议报告每轮优化 residual 与错误初值恢复率。 |
12. 复现与工程边界
需要固定 mesh scale、camera extrinsics、crop 坐标、renderer、feature layer、优化步数和 visibility mask。相机外参漂移会被优化器解释成物体 pose,导致“看似收敛、实际坐标系错误”。在实时系统中可先用少量 candidate 做 coarse aggregation,只对高不确定物体执行多视角 feature refinement;对动态 / articulated 物体则需改成 per-part 或时变 pose。
