论文精读笔记:RGBManip: Monocular Image-based Robotic Manipulation through Active Object Pose Estimation
1. 基本信息
- 作者 / 机构:Boshi An、Yiran Geng、Kai Chen、Xiaoqi Li、Qi Dou、Hao Dong;北京大学、北京智源人工智能研究院、香港中文大学
- 年份 / 会议:2024 / ICRA
- 论文:arXiv / PDF
- 项目页:RGBManip
- 阅读模式:精读
2. 核心问题
单目眼在手相机缺少直接深度,固定视角又常被机械臂、柜体和物体自身遮挡。RGBManip 不把 pose estimation 当成一次性前端,而是让机器人主动选视角、积累多视图,再用柔顺控制承接仍然存在的位姿误差。
3. 任务边界
| 维度 | 本文设置 |
|---|
| 传感器 | 眼在手 RGB;真实相机关闭 depth 输出 |
| 目标 | 类别级物体 / 可动部件 pose 与尺寸 |
| 相机相对位姿 | 来自机器人运动学 |
| 训练 | SAPIEN 仿真,PartNet-Mobility + ShapeNet |
| 下游 | 开门、拉抽屉、开锅、拿杯 |
| 输出评测 | 主要是 manipulation success,而非 ADD(-S) |
因此这篇论文属于 active perception for manipulation。它与标准 6D pose benchmark 的核心差别是:系统可以主动移动相机,并允许控制器用接触反馈和柔顺性补偿视觉误差。
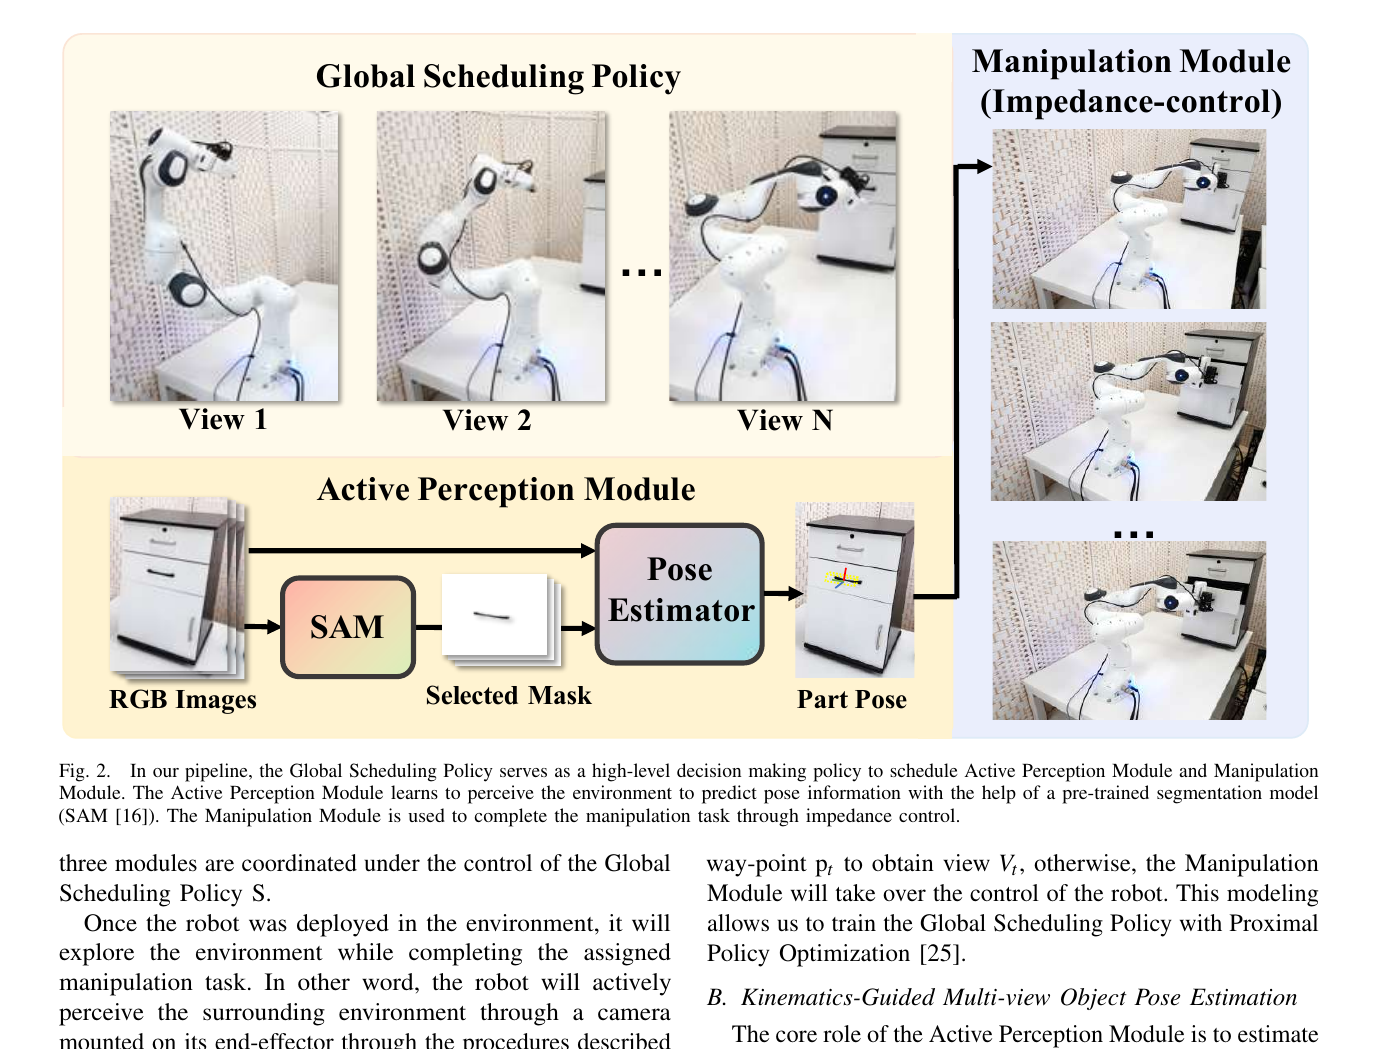 原论文 Figure 2:Global Scheduling Policy 决定继续观察或开始操作,Active Perception 汇总历史视图,预测目标 pose 后交给阻抗控制器。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
4. 方法详解
4.1 Global Scheduling Policy
高层策略接收历史视图、当前 pose prediction 和机器人状态,输出下一步是移动到新的观察 waypoint,还是执行 manipulation。主动感知的 reward 同时包含 pose precision 与运动距离 penalty。论文用参数 α=rpen/rprec 调节精度–效率权衡:过度节省运动会降低 pose 质量,而过小的 α 也可能因 reward 其他项占主导得到次优策略。
4.2 运动学引导的多视图 pose estimator
SAM 先给出目标 mask。相邻两帧间的相机外参由机器人正运动学确定,不必额外做视觉里程计。对于候选 depth planes,系统把前一视角特征 warp 到当前视角;不同深度下的相似度堆叠成 4D depth-aware feature volume,经 regularization 后与 mask feature 拼接,分别预测 object size、rotation 和 translation。
这个模块的关键不是显式恢复 dense depth,而是用已知相机运动把“哪一个深度能跨视角对齐”编码到 feature volume。它仍是 category-level learned estimator,需要类别形状先验与仿真训练。
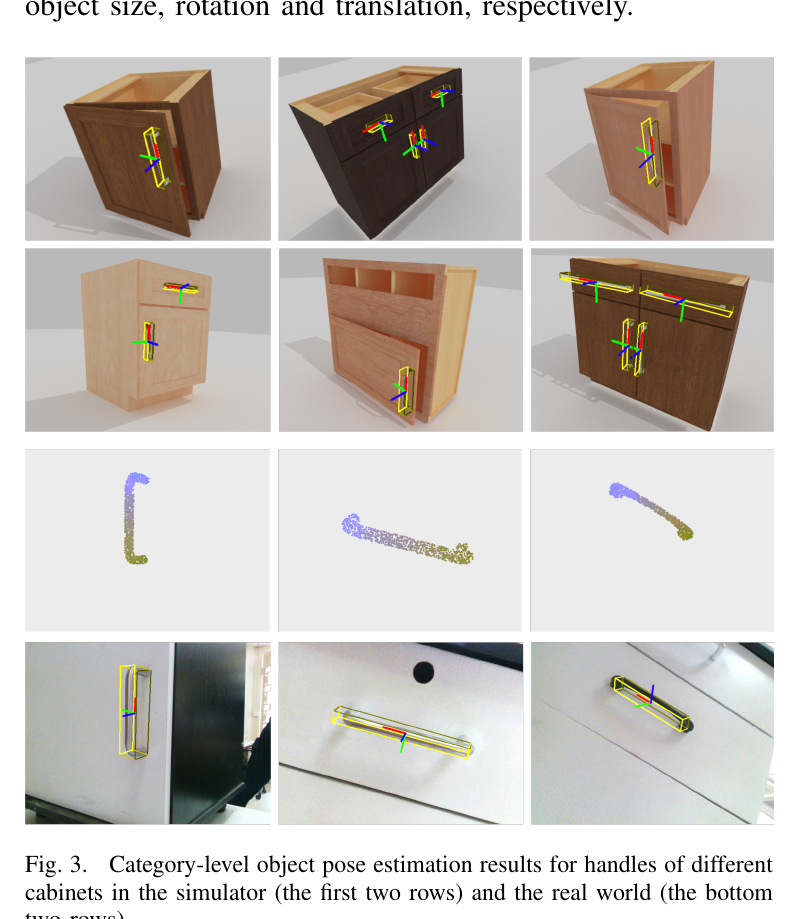 原论文 Figure 3:不同柜体把手在仿真和真实环境中的类别级 pose visualization。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
4.3 Sim-to-real 与控制闭环
训练时随机化透明、镜面和漫反射材质、纹理等视觉因素,降低 RGB sim-to-real gap。执行端使用 impedance controller:
τ=J⊤[−k(XR)−b(Jq˙)]+N,
其中 X,R 是末端相对目标 pose 的误差,k,b 控制刚度和阻尼。该设计允许末端在接触中偏离纯视觉轨迹,解释了为什么 manipulation success 不只由 pose estimator 决定。
5. 实验设计
- 仿真:184 个 shapes、4 个对象类别,六项 manipulation tasks。
- baselines:Where2Act、FlowBot3D、UMPNet、GAPartNet、DrQ-v2、LookCloser。
- 真实:Franka Panda + 眼在手 RealSense,仅使用 RGB。
- 主要指标:任务成功率;论文还分析观察 waypoint 数量和精度–效率权衡。
| 测试任务 | RGBManip 成功率 |
|---|
| Open Door | 88.9% |
| Open Door 45° | 52.9% |
| Open Drawer | 87.0% |
| Open Drawer 30 cm | 61.9% |
| Open Pot | 55.6% |
| Lift Mug | 41.9% |
这些值不能当成 pose accuracy。Open Pot 的测试集比训练集更高,作者明确解释为 split 中测试实例更简单;因此不宜仅按 train/test 差值推断泛化。
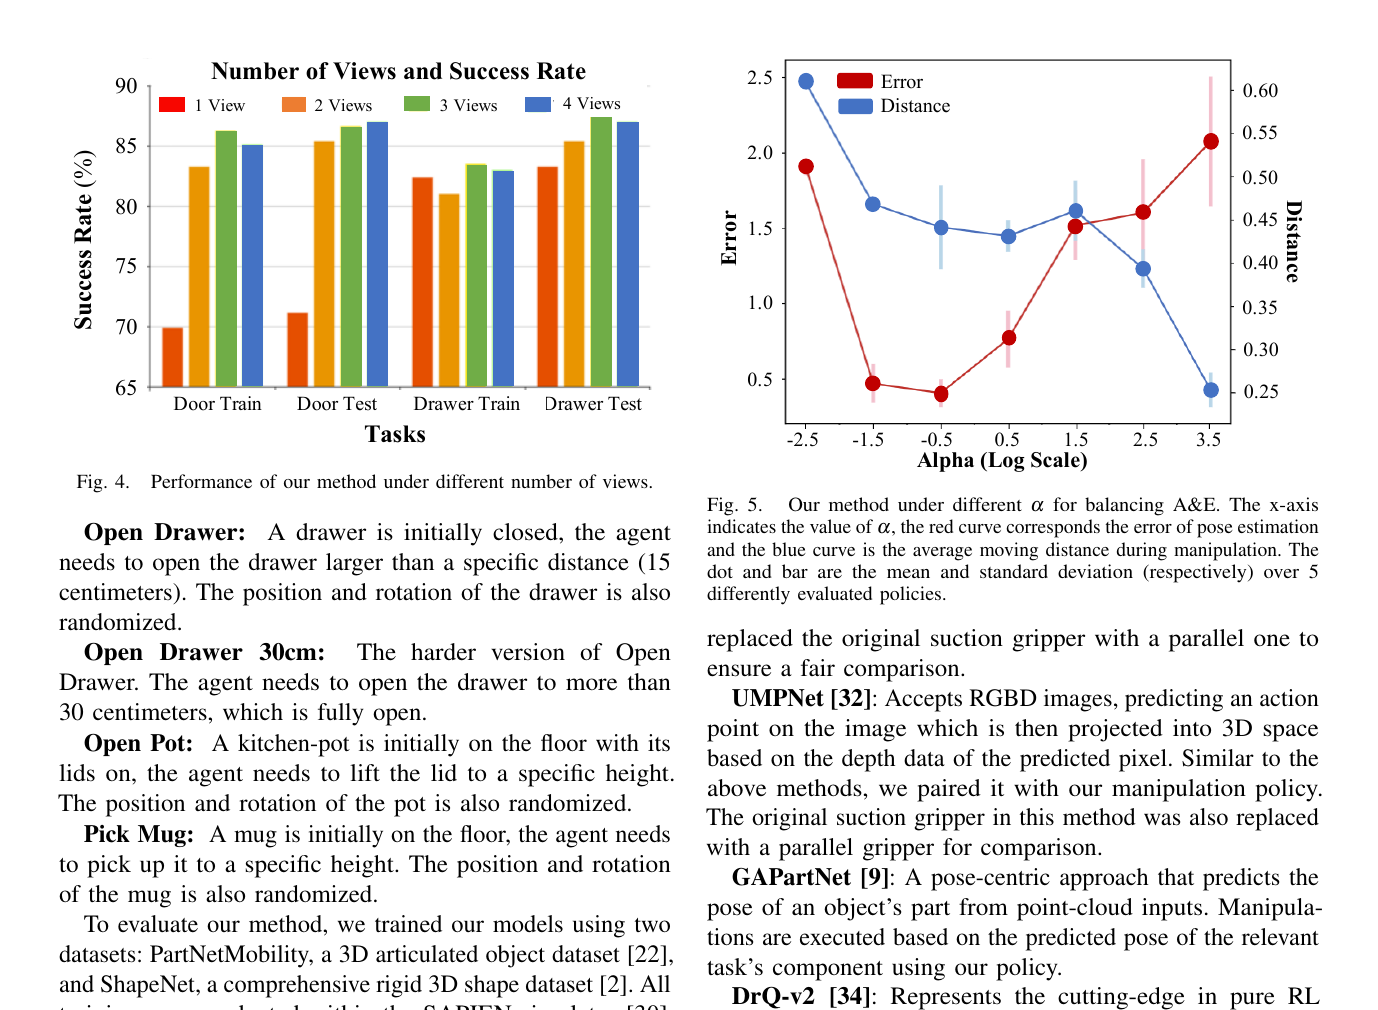 原论文 Figure 4–5:观察视角数量对任务成功率的影响,以及 pose error 与机械臂移动距离之间的精度–效率权衡;Table I–II 的关键数字已在正文表格中转录。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
6. 消融解读
- 去掉 Global Scheduling 后,复杂任务的测试成功率下降,说明固定视角难以适配不同几何。
- 去掉 impedance control 对 Open Door 45° 和 Open Drawer 30 cm 影响尤其大,表明长程接触任务需要控制端容错。
- 去掉 domain randomization 或多视图 pose tricks 均造成明显下降;其中 pose tricks 在若干测试任务上的退化最大。
- 图中比较 1–4 个视角,增加 waypoints 总体改善成功率,但 4 个视角并非每项都优于更少视角;不能据此断言超过 4 个后的饱和,主动感知也不应只追求“看得更多”。
7. 批判性分析
优点
- 将 perception、view planning 与 control 放进同一闭环,而不是假设 pose 前端永远准确。
- 只用 RGB,避免透明 / 反光对象给消费级深度相机带来的空洞。
- 多视图 fusion 利用了机器人已知运动学,工程路径清楚。
局限
- 独立 pose 指标与误差分布报告有限,难以和 NOCS / REAL275 方法直接比较。
- manipulation success 混合了感知、规划、控制、碰撞和 gripper 等多种因素。
- 类别和任务范围有限,真实实验的规模不足以证明广泛 sim-to-real。
- SAM mask、机器人标定和运动学误差都是未被完全隔离的前提。
- 主动移动在动态、人机共融或狭窄环境中会增加时间与安全成本。
8. 对 6D pose 研究的启发
这篇工作提醒我们:机器人真正需要的未必是单帧 pose leaderboard 上的最低平均误差,而是“知道何时不确定、能主动补充哪个视角、并让控制端对残余误差有容忍度”。未来可以显式维护 pose covariance,用 expected task success 选择 next-best-view,并把对称等价 pose 与接触可行性共同纳入调度策略。
