Reading Notes
粗读 / 精读
已生成 src/paper-notes/scaling-3d-compositional-iccv2025/coarse.md
论文粗读笔记
用于快速判断论文定位、问题设定、核心方法、实验结论和是否值得精读。
论文粗读笔记:Scaling 3D Compositional Models for Robust Classification and Pose Estimation
1. 基本信息
- 年份 / 会议:2025 / ICCV;阅读模式:粗读。
- 任务:大规模类别的联合 classification 与 3D pose estimation,并考察 OOD robustness。
- 原文:ICCV Open Access。
2. 一句话定位
3D-CompNet 把 neural mesh 的全类别顶点对比学习拆解为类内和跨类的组合式训练,再聚焦最易混类别,使具 3D 结构归纳偏置的 classification / pose 模型可以扩展到 188 类。
2.1 论文图表导读
| 图表 | 看点 |
|---|---|
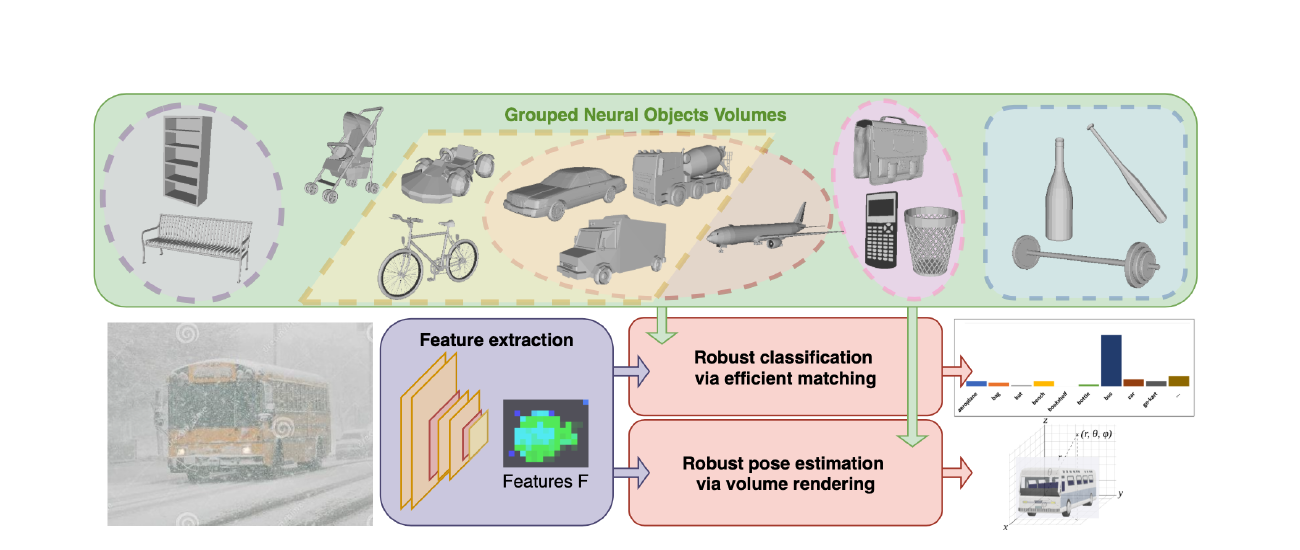
| Figure 3 | 分组 neural object volumes、特征提取、classification matching 与 pose volume rendering 的统一概览。 |
3. 方法概览
- 每个类别以带 vertex features 的 3D neural mesh / volume prototype 表示;图像 backbone 提取 features 后与原型匹配。
- 全量顶点对比的代价随类别数二次增长;论文用 in-category 与 cross-category 对比拆分,并对高混淆类别动态加权。
- 对 pose,给定类别标签后以体渲染式匹配推断姿态;因而它是结构化类别级/OOD 研究,而非无先验 novel-object 6D pose。
4. 实验概览
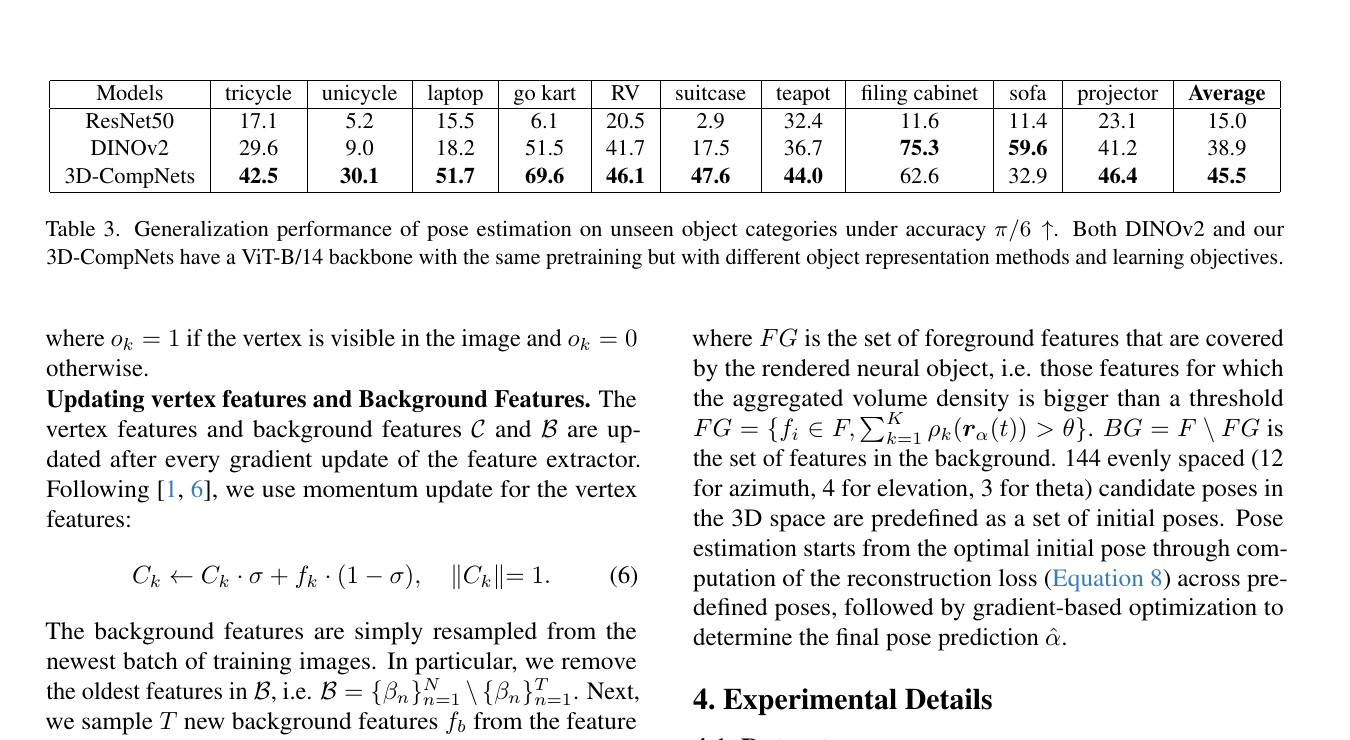
- 数据集:ImageNet3D+、OOD-CV;规模扩展到 188 类。
- 作者声称:相对既有 3D compositional / standard DNN,训练更高效且在遮挡、天气、合成域、未知类别等 OOD 条件更稳。
- 我的分析:贡献首先是把有物理/形状归纳偏置的模型“做大”,不是重新定义 6D pose benchmark;需要 3D 标注/原型的训练成本仍较高。
5. 优缺点与启发
- 优点:从训练复杂度直接解决 scaling bottleneck,并将 robust classification 与 pose 放在共享表示中。
- 风险:推理时 pose 依赖类别识别和 prototype;对杂乱多物体、相机内参误差的讨论有限。
- 启发:可将 hard-negative mining 施加在“类别-几何原型”层,而不只施加在图像 embedding 层。