Reading Notes
粗读 / 精读
已生成 src/paper-notes/semantic-cross-pose-icra2025/coarse.md
论文粗读笔记
用于快速判断论文定位、问题设定、核心方法、实验结论和是否值得精读。
论文粗读笔记:Semantic Cross-Pose Correspondence from a Single Example
1. 基本信息
- 作者:Denis Hadjivelichkov、Sicelukwanda Zwane、Marc Peter Deisenroth、Lourdes Agapito、Dimitrios Kanoulas
- 会议:ICRA 2025
- 论文:UCL Discovery
- PDF:作者接受稿
2. 一句话定位
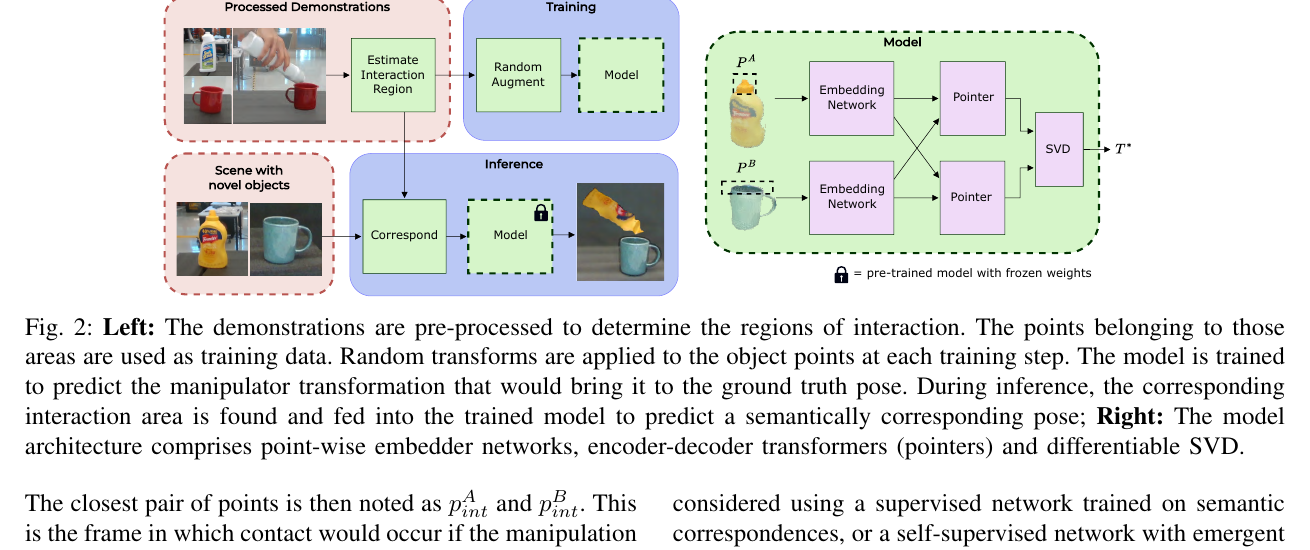
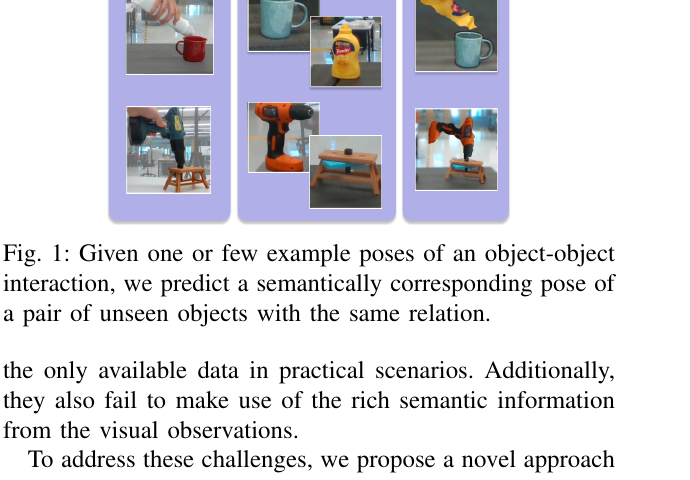
论文从一次双物体交互示范中自动找到接触相关区域,以 DINO-ViT 语义和局部几何学习两件新物体之间的 soft correspondence,再通过 differentiable SVD 迁移示范中的相对 pose。
2.1 论文图表导读
3. 任务不是普通绝对位姿
- 输入:一组 manipulator A 与 manipulandum B 的交互示范,以及新的对象对。
- 输出:新对象之间满足相同语义交互的相对变换。
- 关注:哪里接触、两个对象应如何相对放置。
- 不负责:完整轨迹、碰撞规避、力控制和动态过程。
4. 方法流程
- 从示范 tracking 中寻找两对象点云距离最小的 interaction frame。
- 由近距离点自动裁出 interaction regions。
- 将 DINO-ViT dense features 投影到三维点。
- 以 TAX-Pose 风格双分支网络预测 soft correspondences 与 displacement residuals。
- Differentiable SVD 求两对象相对刚体变换。
- 训练时随机施加 SE(3) 扰动,学习 cross-pose consistency。
5. 结果速览
| 任务 | TAX-Pose | 本文 |
|---|---|---|
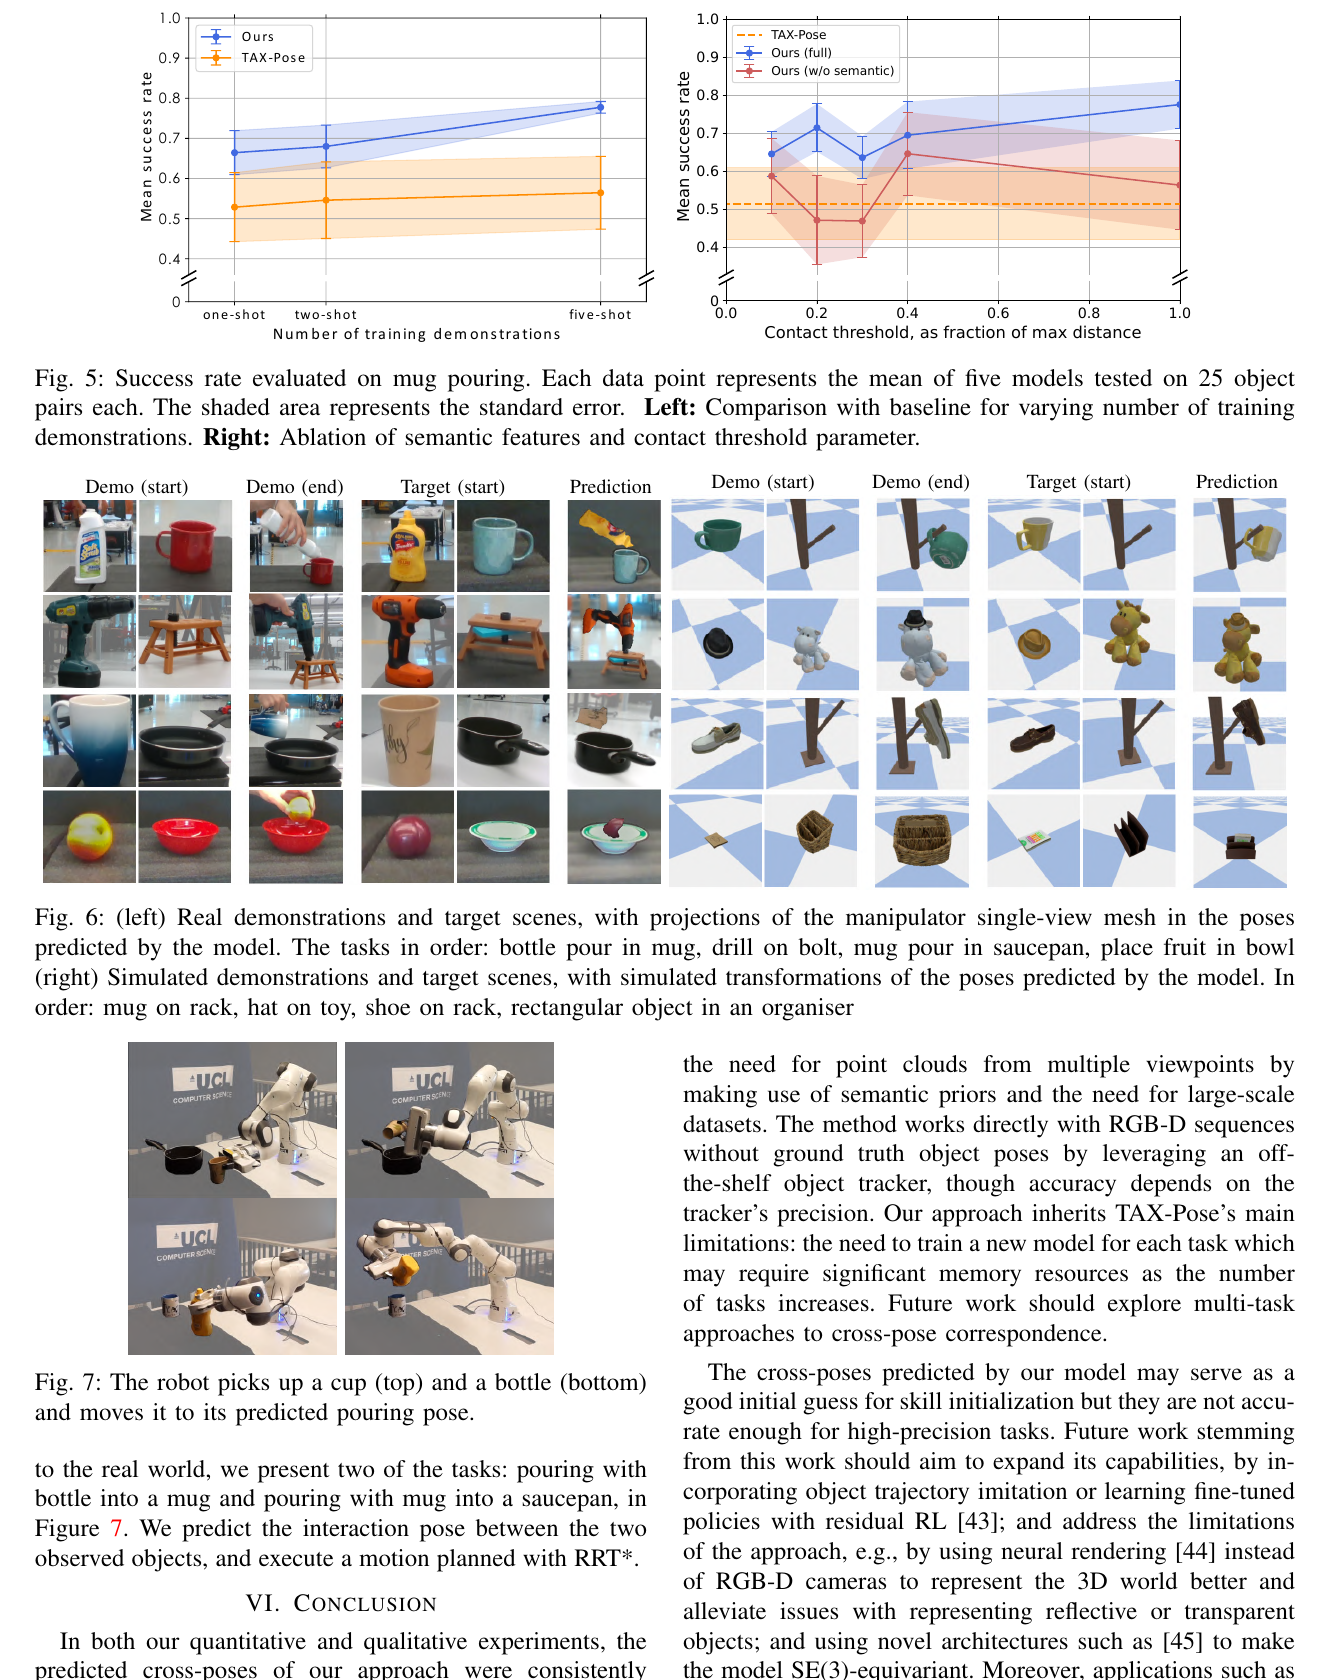
| Mug-Pour 1-shot | 53% | 66% |
| Mug-Pour 2-shot | 55% | 68% |
| Mug-Pour 5-shot | 56% | 78% |
| Mug-Rack arbitrary rotation | 41% | 78% |
Mug-Rack upright setting 两者均为 100%,说明简单初始姿态下语义模块的优势不明显;任意旋转才真正检验 cross-pose 泛化。
6. 粗读结论
这篇工作把 pose 从“对象相对相机在哪里”提升为“两个对象怎样摆才具有相同交互语义”。DINO 提供跨实例语义,局部几何与 SVD 保证刚体一致性。它很适合 one-shot manipulation,但仍需规划器把目标相对 pose 转化为安全轨迹。