论文精读笔记:Sim-to-Real Object Pose Estimation for Random Bin Picking
1. 研究定位
本文面向工业 random bin picking:多个相同、常常无纹理的工件随机堆叠在料箱中,机器人必须先区分可见实例,再估计每个实例相对相机的 6D pose,最后选择可抓取且无碰撞的目标。
论文的主要矛盾是真实标签成本。对一张堆叠点云,标注者不仅要知道“这是哪类物体”,还要:
- 分离外观相同且互相接触的多个实例;
- 为每个实例建立 CAD 对应;
- 标注准确 R∈SO(3) 与 t∈R3;
- 处理对称姿态、遮挡和不可见面。
作者选择不标注真实数据,也不在部署时用真实无标注数据做 adaptation,而是完全依赖物理仿真自动生成监督。
2. 任务分解
完整感知链可以抽象成:
Psinstance segmentation{Ps(j)}j=1Mpose estimation{Tco(j)}j=1M,
其中 Ps 是料箱场景点云,Ps(j) 是第 j 个可见实例,Tco(j) 是 CAD object frame 到 camera frame 的刚体变换。
这两个子任务强耦合:
- segmentation 把两个接触实例粘在一起,pose estimator 会面对不可能由单个刚体解释的点集;
- segmentation 丢掉关键可见面,pose 会退化;
- pose 错误又会影响 grasp approach、碰撞检测和实例选择。
因此,仿真数据不仅要“看起来像点云”,还必须覆盖真实堆叠的实例边界、遮挡率与接触模式。
3. 自动化 synthetic data factory
公开摘要确认的数据生成步骤包括:
- 导入目标对象 3D CAD;
- 使用 physics simulator 生成随机堆叠场景;
- 输出模拟点云;
- 自动生成 instance segmentation annotation;
- 自动生成每个实例的 pose annotation。
物理仿真的价值在于:对象不是被任意粘贴到空中,而是通过重力、碰撞和接触形成稳定堆叠。每个实例的 simulator transform 天然就是无噪声 6D ground truth;renderer 又可以从 instance ID buffer 自动得到分割标签。
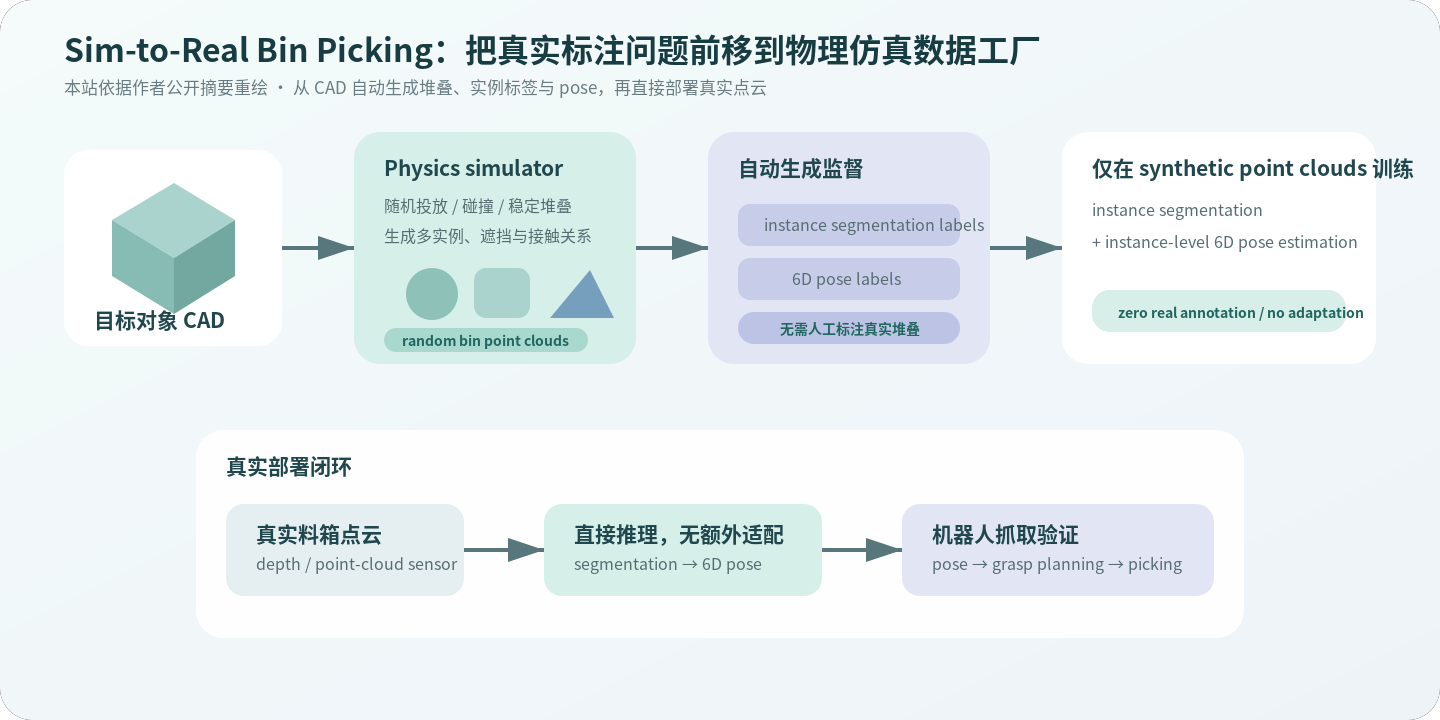 本站依据作者公开摘要重绘,非论文原图。摘要没有披露 simulator、传感器噪声模型、网络和抓取硬件,本图只表达可核验的数据流。论文内容版权归原作者,重绘用于学术解读。来源:Sim-to-Real Bin Picking Pose, ICRA 2024。
4. 为什么点云 sim-to-real 可能比 RGB 更容易?
RGB sim-to-real 要匹配材质、纹理、照明、曝光、阴影和背景。点云主要保留几何,表面颜色差异被移除,理论上域差距更集中在:
- 量化与深度噪声;
- 斜入射表面的系统误差;
- 反光 / 黑色表面的缺测;
- 物体边缘 flying pixels;
- 相机视角、分辨率与裁剪范围;
- 真实堆叠姿态分布。
只要 CAD 几何准确、仿真遮挡分布接近真实、sensor corruption 被适当模拟,synthetic point cloud 可以比 photorealistic RGB 更容易直接迁移。
但“只用几何”不是自动无域差。工业零件常有重复平面、圆柱和对称孔位;真实深度传感器在金属表面可能大量缺测,理想 CAD 渲染反而比 RGB synthetic gap 更难弥合。
5. 训练与部署边界
作者摘要明确:
- 模型只使用 simulated data 训练;
- 真实部署不需要 additional adaptation;
- 方法集成到真实 robot random bin picking。
这与三个相邻概念不同:
| 设定 | 是否需要目标 CAD | 是否用真实训练数据 | 新对象是否重训 |
|---|
| 本文 synthetic-only object-specific | 是 | 否 | 通常需要 |
| sim-to-real self-training | 是 | 需要无标注真实数据 | 通常需要 |
| zero-shot CAD-template method | 是 | 不一定 | 不需要对象专属训练 |
| category-level method | 不需要实例 CAD | 可能需要类别数据 | 同类新实例不重训 |
所以本文的“seamlessly applied to real-world scenarios”指真实域无需适配,不代表 novel CAD 到来时无需重新生成数据或训练。
6. 实验结果与证据等级
作者摘要称:
- synthetic datasets 上 recall 和 accuracy 具有竞争力;
- 真实机器人系统的 picking success rates 显著提高。
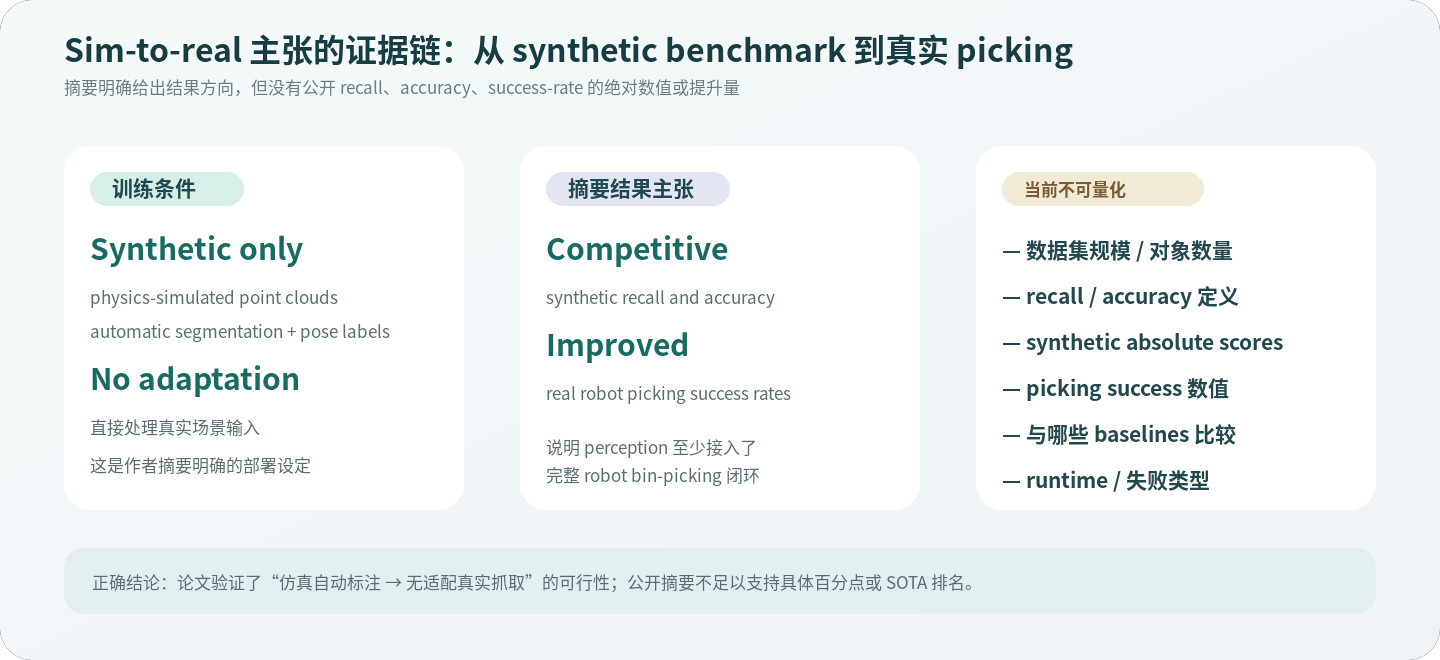 本站根据 DOI 元数据与作者公开摘要整理。由于公开摘要没有具体数字,本图不构造虚假的 recall / accuracy / picking success 柱状图。来源:论文 DOI。
6.1 Synthetic recall / accuracy
摘要没有说明 recall 针对 instance segmentation、pose threshold 还是两者联合,也没有说明 accuracy 的阈值与对称处理。因此不能将其映射为 ADD(-S)、BOP AR 或 5°5cm 等网站统一指标。
6.2 Real robot picking success
真实抓取是很有价值的下游验证,但它不是纯 pose 指标。成功率可拆成:
P(pick)≈P(detect)P(pose∣detect)P(valid grasp∣pose)P(execute∣plan).
任何一环都会影响最终数字。论文摘要说 success rate 显著提升,说明新的 perception 至少对系统有正向价值;但没有全文时,不能把全部提升都归因于 pose accuracy,也不能判断失败来自分割、位姿、碰撞还是夹持。
7. 关键工程变量
即使网络结构固定,以下数据生成选择也可能决定 sim-to-real 成败。
7.1 堆叠分布
投放高度、对象数量、初始姿态、摩擦系数、恢复系数、质量和碰撞网格会决定稳定姿态与遮挡率。如果真实料箱多为“紧密平铺”,仿真却产生“松散随机堆”,网络学到的可见面统计会不同。
7.2 虚拟深度传感器
需要匹配:
- 相机内参和工作距离;
- depth quantization;
- 距离相关噪声;
- 边缘空洞与飞点;
- 反光材质缺测;
- crop 和体素化分辨率。
摘要没有披露这些细节,不能判断作者用了纯几何采样还是 sensor-aware corruption。
7.3 CAD fidelity
真实零件的倒角、孔、磨损、毛刺或装配件可能与设计 CAD 不一致。对点云 pose estimator 而言,几何误差直接改变 correspondence;对具有高对称性的工件,小细节往往正是区分姿态的唯一线索。
8. 可能的网络角色,但不能当作论文事实
公开摘要只说“instance-level object pose estimation method”与学习式 point-cloud segmentation / pose。它没有公布:
- segmentation backbone;
- pose 是 correspondence、keypoint voting、direct regression 还是 point-pair feature;
- segmentation 和 pose 是否联合训练;
- 是否有 ICP refinement;
- 是否处理 symmetry;
- 一次推理返回多少 hypotheses。
这些是复现必需信息,但不能用领域常见模块自动填空。本站 metadata 只保留“point-cloud、instance segmentation、pose estimation、sim-to-real”这些可核验标签。
9. 失败模式
- 实例粘连:相同工件接触时,分割边界在点云中几乎不存在。
- 高遮挡:只见一个平面或圆弧时,pose 约束不足。
- 对称性:几何对称对象存在多个等价 pose,普通 rotation loss 与 picking 需求可能不一致。
- 真实深度缺失:金属、黑色或高倾角表面使输入比仿真稀疏。
- 仿真姿态偏差:错误摩擦和碰撞模型导致训练时从未见过真实稳定堆叠。
- CAD 偏差:真实零件与名义模型不一致。
- 抓取耦合:位姿数值正确不等于抓取可行,夹爪接近方向和邻近碰撞同样关键。
10. 取得全文后应补齐的核对清单
- 仿真器、对象数量、场景数、点数与训练数据规模;
- 物理参数和 randomization 范围;
- 虚拟相机及 depth noise / dropout 模型;
- instance segmentation 与 pose 网络结构;
- pose representation、loss 与 symmetry handling;
- synthetic benchmark 的 recall / accuracy 定义和绝对数字;
- real robot 对象、传感器、机械臂、夹爪和 trial 数;
- picking success 的 baseline、提升量和失败分类;
- 是否真的完全没有真实 fine-tuning、threshold tuning 或 calibration data;
- 新对象的 synthetic generation + training 总耗时;
- 推理速度、GPU 与机器人 cycle time。
11. 研究启发
这篇工作的核心启发不是“仿真能替代真实”,而是要把数据生成视为系统设计的一部分:
- 用真实传感器少量无标签扫描拟合 depth corruption,而不用于 pose supervision;
- 根据真实部署失败主动生成 hard synthetic piles;
- 将 pose metric 与 grasp feasibility 联合设计,优先学习会改变抓取决策的姿态误差;
- 对称工件输出等价 pose set 或 grasp-equivalent pose;
- 报告“新 CAD → 可部署模型”的总时间,而不只报告 inference FPS。
在工业场景中,CAD 已经存在、产品迭代相对稳定,synthetic-only object-specific training 可能比追求完全通用的 zero-shot 更可靠。本文用真实抓取闭环支撑了这条路线的可行性;但由于全文与数字未公开,目前应把它作为方法和系统趋势证据,而不是可复现排行榜条目。
