论文精读笔记:Differentiable Rendering-based Pose Estimation for Surgical Robotic Instruments
1. 核心判断
这篇论文处理的不是一般意义上“在图像中找一个刚体物体的 6D pose”,而是一个带运动学和机械结构约束的联合标定问题:
{T^rc,θ^visible}=argT,θminL(R(TTmr(θ)M),Mref),
其中 Trc 按原文 Eq. (4) 将 robot base 坐标映射到 camera(原文称 camera-to-robot transform),Tmr(θ) 由 dVRK forward kinematics 给出,将 mesh frame 映射到 robot base,M 是已知 link meshes,R 是可微 silhouette renderer,Mref 来自真实内窥镜图像的器械 mask。
难点在于:编码器关节角会受 cable stretch / hysteresis 影响;相机只看到机械臂末端的一小段细长 shaft 和 gripper;从任意 SE(3) 初值做 silhouette matching 很容易陷入局部极小值。作者的实质贡献是把搜索空间、可微渲染和器械解析几何组合成一个单帧初始化器。
2. 输入、输出与适用边界
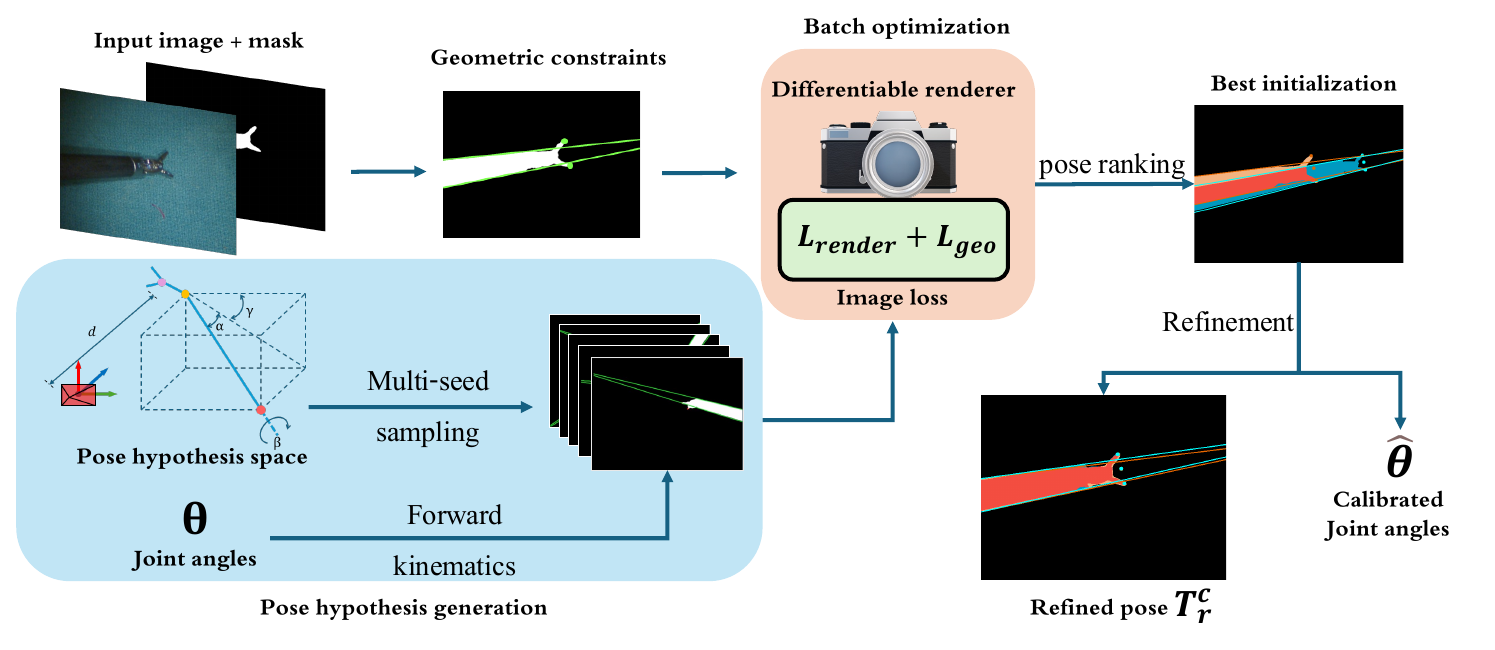 原论文 Figure 2。500 个候选先做 coarse batch optimization,最佳候选再长程细化;输出不只是刚体外参,还包括 Wrist Pitch、Wrist Yaw 与 Jaw Angle。来源:作者公开稿;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
必需输入
- 单幅 640×480 单目内窥镜 RGB;
- 器械 reference mask,论文用 Segment Anything 2 生成;
- camera intrinsics;
- dVRK 每个可见 link 的 metric meshes / CAD;
- dVRK forward-kinematics model;
- 编码器给出的近似关节角;
- 大致适合真实 dVRK 场景的 pose hypothesis sampling range。
输出
- robot base 到 camera 的刚体变换 Trc;
- Wrist Pitch、Wrist Yaw、Jaw Angle 三个末端关节的视觉校准值。
不包含
- 对任意未知手术器械或未知 CAD 的类别级泛化;
- 不依赖机器人运动学的通用 6D pose;
- 连续帧时序滤波与在线漂移补偿;
- 目标物体(纱布 / 缝合针)的 pose estimation;
- 绝对 calibration ground truth。
“markerless”指机器人器械上不需要人工 marker。开放环抓纱布实验仍在纱布上放置 ArUco 以估计目标 pose,不能把整个实验系统描述为完全无标记。
3. 受结构约束的四维候选空间
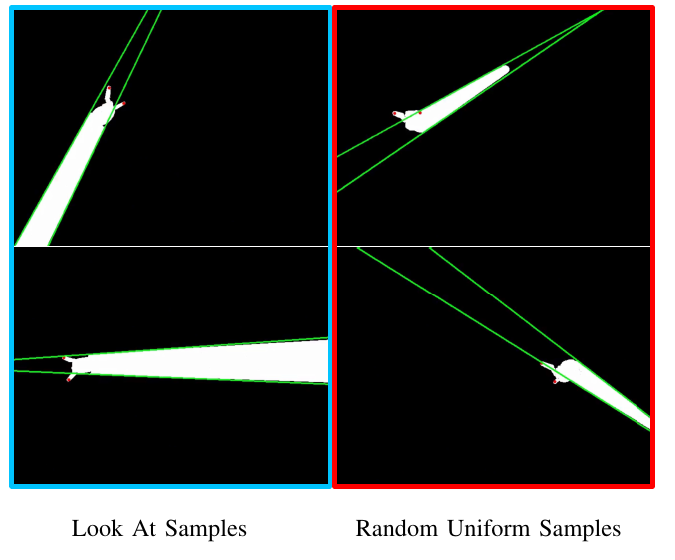 原论文 Figure 4:LookAt 候选集中覆盖镜头前物理可行的器械朝向,均匀随机 6D 采样则浪费大量样本在不可能的方向。图中是采样效率的定性示意,论文没有单独报告候选召回率或数量—精度曲线。来源:作者公开稿;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
作者没有直接在无界 SE(3) 上均匀采样,而以
[α,β,γ,d]
参数化初始候选:
- α,γ:相对 camera frame 的两个方向角;
- β:绕器械局部 shaft / z 轴的滚转;
- d:camera 到 robot origin 的距离。
通过 LookAt transform 构造
TLookAt(di,αi,βi,γi)=[RLookAt(αi,βi,γi)0⊤t(di)1].
直观上,手术器械插入轴必须朝向术野,不会从相机背后出现或穿过成像平面;将这些物理不可能状态排除,500 个候选才能覆盖更有意义的区域。它和 RCM 机械约束高度相关,因此这是 dVRK-specific 的搜索空间,而不是可直接移植到任意 articulated object 的一般参数化。
论文只给出 Figure 4 的可行 / 不可行候选示意,没有:
- 与均匀 SE(3) 采样在同候选数下的成功率;
- 候选数量从少到多的收敛曲线;
- 真值是否落入 sampling range 的覆盖率;
- α,β,γ,d 的具体采样上下界。
所以“更快、更准”在机制上合理,但无法从公开表格量化候选空间本身贡献了多少。
4. 从运动学模型到可微 silhouette
每个 mesh vertex 先通过机器人运动学和候选外参变换到 camera frame:
vc=TLookAtTmr(q)vm.
PyTorch3D silhouette renderer 把所有可见 link 投影成二值 mask S。这一设计有两点价值:
- robot base 外参与可见关节角能在同一计算图中联合求梯度;
- 不需要合成—真实图像的纹理、材质和照明一致,只匹配几何轮廓。
代价是估计质量上限受 reference mask 和 CAD / kinematics accuracy 约束。SAM2 若漏掉细小 gripper、把反光高光切断或把背景组织并入器械,优化目标本身就会偏;论文展示了不同 mask quality 的定性结果,但没有 mask noise robustness 曲线,也没有比较人工 GT mask。
5. 三项渲染损失
5.1 Silhouette MSE
LMSE=i,j∑(S(i,j)−Mref(i,j))2.
它在两幅 mask 已经重叠时适合精细对齐,但相距较远时没有方向明确的梯度。
5.2 Distance-field loss
作者从 reference mask 计算距离场 Dref,背景像素的值随到前景距离增大而变化,并定义:
Ldist=i,j∑S(i,j)Dref(i,j).
即使两个 mask 没有交集,rendered foreground 仍能沿距离场向 reference silhouette 移动。这一项主要扩大 basin of convergence。
5.3 Scale loss
Lscale=i,j∑S(i,j)−i,j∑Mref(i,j).
投影面积对深度 d 敏感,因此该项给 camera–robot distance 提供粗约束。但同样的投影面积可能来自不同深度、shaft 朝向和关节状态,不能单独解除歧义。
三项合成:
Lrender=λ1LMSE+λ2Ldist+λ3Lscale.
论文没有公布所有 λi、距离场衰减系数与损失尺度敏感性,完整复现仍缺关键超参数。
6. 解析几何损失为何重要
手术器械的可见面积主要由长 shaft 决定,但 shaft 很窄。小的轴向角度误差可能对控制很关键,像素级 silhouette 面积却只改变少量边缘像素。
6.1 Cylinder edge loss
作者把 shaft 视为已知半径圆柱,将两条轮廓母线投影为 image-plane lines。reference mask 上通过 Canny edge detector 和 Hough transform 取两条最长边缘,再把直线写成极坐标 (ρ,θ):
d(ℓ1,ℓ2)=min(∣θ1−θ2∣,π−∣θ1−θ2∣)+γ∣ρ1−ρ2∣.
由于两侧边缘没有预配对,loss 枚举两种关联并取较小者,同时加入两条线均值差:
Lcylinder=min(dr1,p1+dr2,p2,dr1,p2+dr2,p1)+drˉ,pˉ.
这比在 mask 上平均误差更直接地约束 shaft orientation。不过,当 Canny / Hough 把组织边缘或高光当成长线时,reference lines 也会错;论文没有报告 line-detection failure rate。
6.2 Gripper-tip keypoint loss
作者在两个 tip 末端放置模型关键点,对两种左右关联取最小,并加关键点均值差:
Lkpt=min(∑∥p1,2r−p1,2p∥,∑∥p2,1r−p1,2p∥)+∥pˉr−pˉp∥.
正文没有详细说明真实 reference tip keypoints 的自动提取流程;从算法描述看,SAM2 只直接生成 mask。因此这一环节是复现时需要特别核对的实现细节。
最终:
L=Lrender+Lgeo,Lgeo=λ4Lcylinder+λ5Lkpt.
7. 两阶段优化不是一次前向
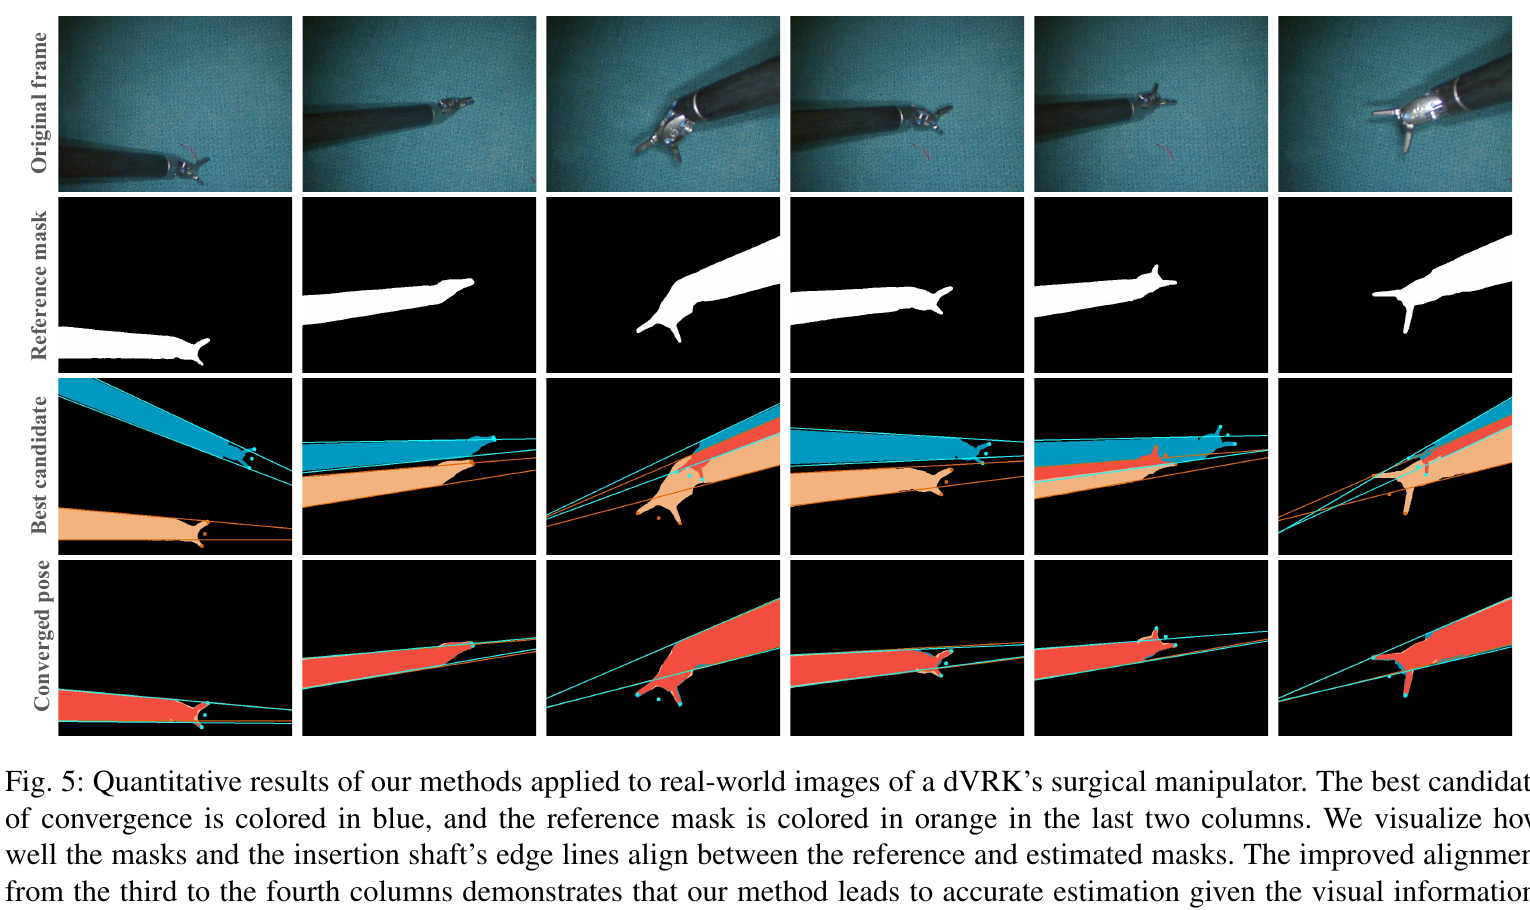 原论文 Figure 5:每列展示原图、reference mask、粗排序后的最佳候选和最终收敛结果;蓝色是候选 / 估计投影,橙色是 reference mask。该图能观察轮廓与 shaft lines 的改善,但 caption 将其称为 quantitative results 并不准确,图中没有数值误差。来源:作者公开稿;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
论文在 RTX 3090 上使用:
- 输入分辨率:640×480;
- 候选数:500 / frame;
- coarse pose ranking:每个候选 100 iterations,Adam,learning rate 0.003;
- refinement:最佳候选 1000 iterations,learning rate 0.0005;
- refinement 额外使用 Gaussian-noise perturbation 与 coordinate descent;
- 联合优化 Wrist Pitch、Wrist Yaw、Jaw Angle。
粗阶段相当于每帧约 50,000 个 candidate-iterations,再加 1000 次 refinement。作者没有给 wall-clock runtime、显存、batch size、成功率或早停条件。因此:
- “single-shot / one-shot” = 单幅图像;
- 不等于 one-pass;
- 不等于实时;
- 也不能从“few coarse iterations”推断工程延迟。
论文结论明确把接入 active tracker、实时补偿 joint-angle errors 作为 future work。
8. 校准一致性实验:数值很漂亮,但指标不是绝对误差
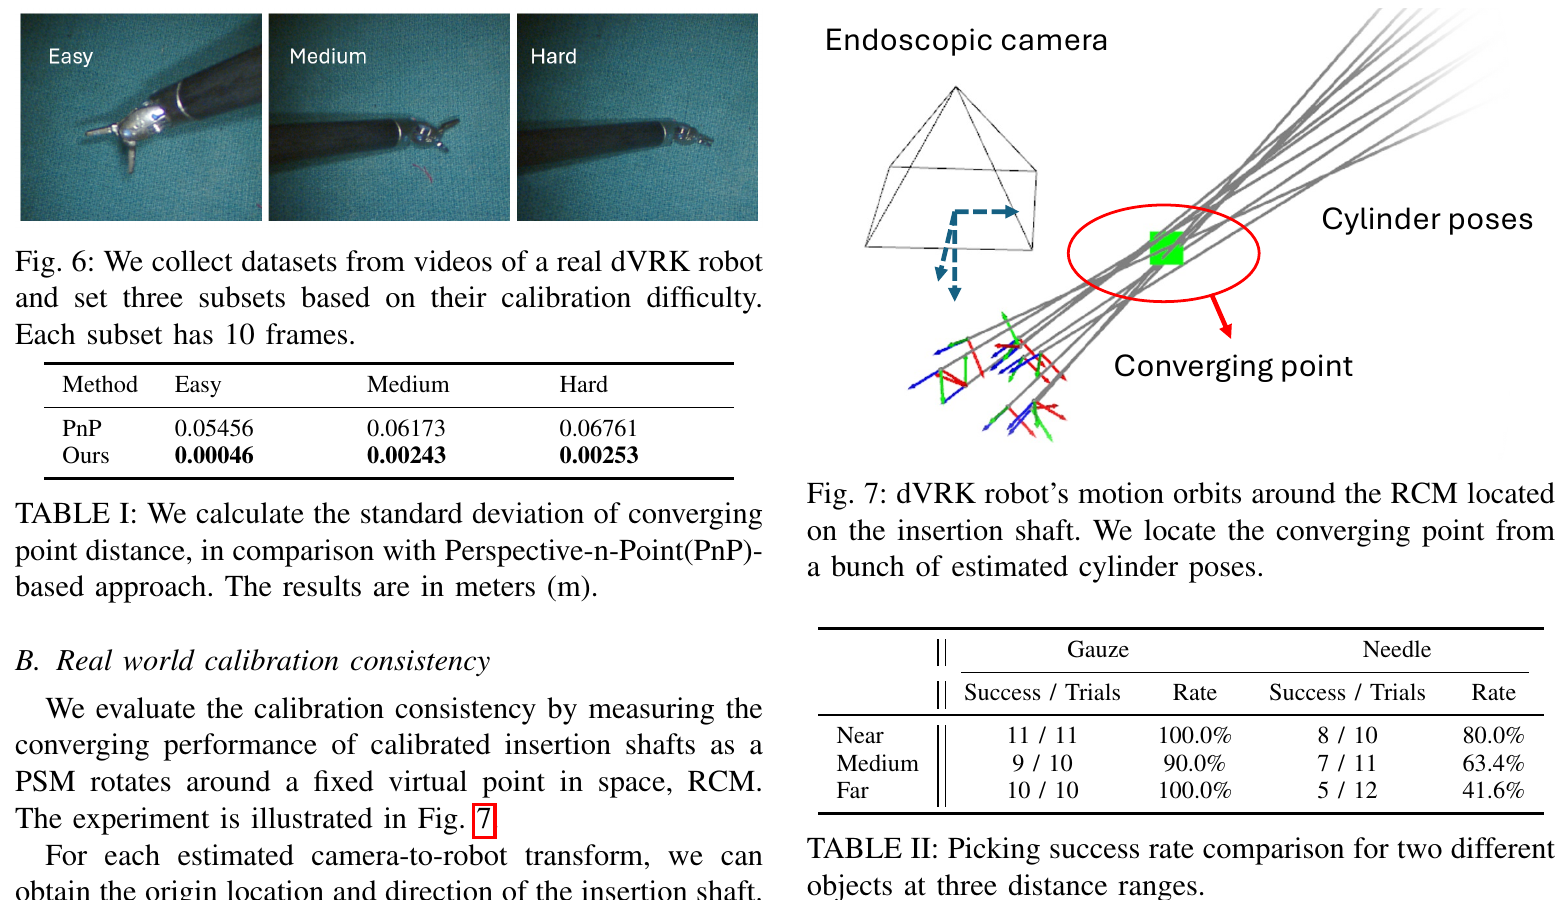 原论文 Figure 6、Figure 7、Table I 与 Table II。左侧是每档 10 帧的真实数据和 RCM consistency,右侧是汇聚点几何与开放环抓取结果。来源:作者公开稿;图表版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
作者让 PSM 围绕固定 Remote Center of Motion 运动。对第 i 个估计 shaft 轴线,以起点 pi 和方向 di 表示,寻找离所有轴线总距离最小的点:
x∗=argxmini∑(x−pi)−(di⊤(x−pi))di2.
然后统计每条轴线到该汇聚点的距离标准差 σ。结果:
| 方法 | Easy ↓ | Medium ↓ | Hard ↓ |
|---|
| PnP | 0.05456 m | 0.06173 m | 0.06761 m |
| Ours | 0.00046 m | 0.00243 m | 0.00253 m |
相对 PnP,方法在三档分别把标准差压低约 96%–99%,说明估计出的多帧 shaft 轴线非常接近共同 RCM。这对于受 RCM 约束的 dVRK 是强几何证据。
但它不是:
- camera-to-robot translation error;
- rotation error;
- ADD / ADD-S;
- 相对 motion-capture 或 fiducial calibration GT 的误差。
如果所有帧共享某个系统性的外参偏差,轴线仍可能高度一致地汇聚。数据量也只有 3×10=30 frames,且没有说明来自多少视频、多少 camera placements、是否重复采样或如何定义 easy / medium / hard。稳妥结论是“比 PnP 更符合 RCM consistency”,不能直接写成“绝对校准达到 0.46 mm”。
9. 开放环操作实验如何解读
机器人只使用最初一次 calibration,随后从随机 PSM 和目标起点执行:
移动到目标上方 → 接近并拾取 → 放下目标 → 复位。
距离按约 1 cm、3–4 cm 和 7 cm 分档:
| 距离 | Gauze success | Needle success |
|---|
| Near | 11 / 11 = 100% | 8 / 10 = 80% |
| Medium | 9 / 10 = 90% | 7 / 11;论文印刷 63.4% |
| Far | 10 / 10 = 100% | 5 / 12 = 41.6% |
这里有四个必须保留的解释边界:
- 7/11=63.636…%,通常应四舍五入为 63.6%,论文的 63.4% 似为数值 / 排版错误。
- Gauze pose 用贴在纱布上的 ArUco marker + OpenCV PnP 计算;器械校准无 marker,不代表下游目标定位也无 marker。
- Needle pose 由已有实时 needle tracker 提供。
- 这是开放环端到端成功率,同时受 robot calibration、目标 pose、trajectory、gripper geometry、关节 encoder error 和 cable stretch 影响。
纱布面积大、容错高,三档近似 100%;针的有效抓取区域小,远距离动作中 encoder / cable error 累积,因此从 80% 降至 41.6%。这个趋势说明单次 calibration 不能替代在线 visual feedback,也正好支持作者把 active tracking 留作下一步。
10. 与传统 PnP 初始化的关系
先前 dVRK tracker 常用涂色点或检测的 2D keypoints 与机器人模型 3D points 做 PnP。问题是:
- 内窥镜分辨率低、光照和反光复杂;
- gripper keypoints 很小;
- 2D–3D 点关联对像素误差敏感;
- 有时需要额外物理标记;
- 部分器械被画面裁切时点数不足。
本文改为利用:
- 整体 silhouette;
- distance field 的长程梯度;
- shaft cylinder edges;
- gripper tips;
- dVRK kinematics;
- RCM-compatible candidate space。
因此它不是“完全不用关键点”,而是“不再只靠少量关键点 + PnP”:tip keypoints 仍进入 geometry loss,只是与轮廓和圆柱边缘共同优化。
11. 复现清单
可从论文明确得到
- PyTorch + PyTorch3D;
- SAM2 reference mask;
- scikit-fmm distance field;
- Canny + Hough shaft edges;
- Adam optimizer;
- 500 candidates;
- 100 coarse iterations,learning rate 0.003;
- 1000 refinement iterations,learning rate 0.0005;
- 640×480;
- RTX 3090;
- refinement 使用 Gaussian perturbation + coordinate descent;
- 联合优化三个可见末端关节。
尚不充分
- 四维候选的 sampling ranges / distributions;
- 五项损失的 λ1…λ5;
- distance-field 衰减 γ;
- silhouette renderer 的 blur / rasterization 参数;
- SAM2 prompt 形式及失败处理;
- reference gripper-tip keypoints 的提取;
- Canny / Hough thresholds;
- batch size、runtime 与显存;
- joint-angle parameter bounds;
- easy / medium / hard 的可操作定义;
- 30 帧评测集和 PnP baseline 实现;
- 随机种子、失败样本和 confidence interval。
截至 2026-07-31,未找到作者公开的方法代码或评测数据。因此当前可以理解和重写算法,但还不足以无歧义复现实验数字。
12. 局限
- dVRK-specific 的 CAD、kinematics、RCM 和可见几何先验很强;
- 只验证一种 PSM / large needle driver,未做跨器械泛化;
- reference mask 依赖 SAM2,却没有 mask robustness 定量;
- 500×100 + 1000 次优化,没有 runtime;
- 候选空间缺采样范围、覆盖率和定量消融;
- loss weights 与若干检测阈值未公开;
- 校准 consistency 不是绝对 pose ground truth;
- 真实校准评测仅 30 帧;
- baseline 主要是 keypoint PnP,缺少 marker-based calibration GT 或其他 render-and-compare baseline;
- 下游抓取成功率混入目标定位和控制误差;
- 纱布实验的目标本身使用 ArUco;
- 针的远距离成功率只有 41.6%;
- 7/11 对应百分比存在论文数值不一致;
- 当前仍是单帧初始化,没有在线 correction;
- 未开放代码和评测数据。
13. 最终评价
这是一篇问题建模很贴合手术机器人的工作:它没有把 dVRK 当成普通刚体,而是利用“只有末端可见、shaft 近似圆柱、绕 RCM 运动、关节编码不准”这些结构,把原本容易失败的全局 render-and-compare 拆成高效候选排序和局部联合细化。
最可信的结论是:在作者采集的 30 个真实帧上,该方法比 PnP 产生明显更一致的 RCM 汇聚几何,并且一次初始化足以支撑一定范围的真实开放环抓取。不能进一步推成“达到亚毫米绝对校准”“实时运行”或“完全无标记的端到端手术操作”。如果后续补齐绝对真值、运行时间、候选 / 损失消融和在线 tracking,这条路线会更接近可验证的临床机器人视觉校准系统。
