Reading Notes
粗读 / 精读
已生成 src/paper-notes/cosypose/coarse.md
论文粗读笔记
用于快速判断论文定位、问题设定、核心方法、实验结论和是否值得精读。
论文粗读笔记:CosyPose: Consistent Multi-view Multi-object 6D Pose Estimation
1. 基本信息
- 标题:CosyPose: Consistent Multi-view Multi-object 6D Pose Estimation
- 作者 / 机构:Yann Labbé, Justin Carpentier, Mathieu Aubry, Josef Sivic;ENS / CNRS / PSL, INRIA, École des Ponts / Univ Gustave Eiffel / CNRS, CIIRC CTU
- 年份 / 会议或期刊:2020 / ECCV
- 论文链接:arXiv:2008.08465
- 代码 / 项目页:Project / Code
- 阅读模式:粗读
2. 一句话定位
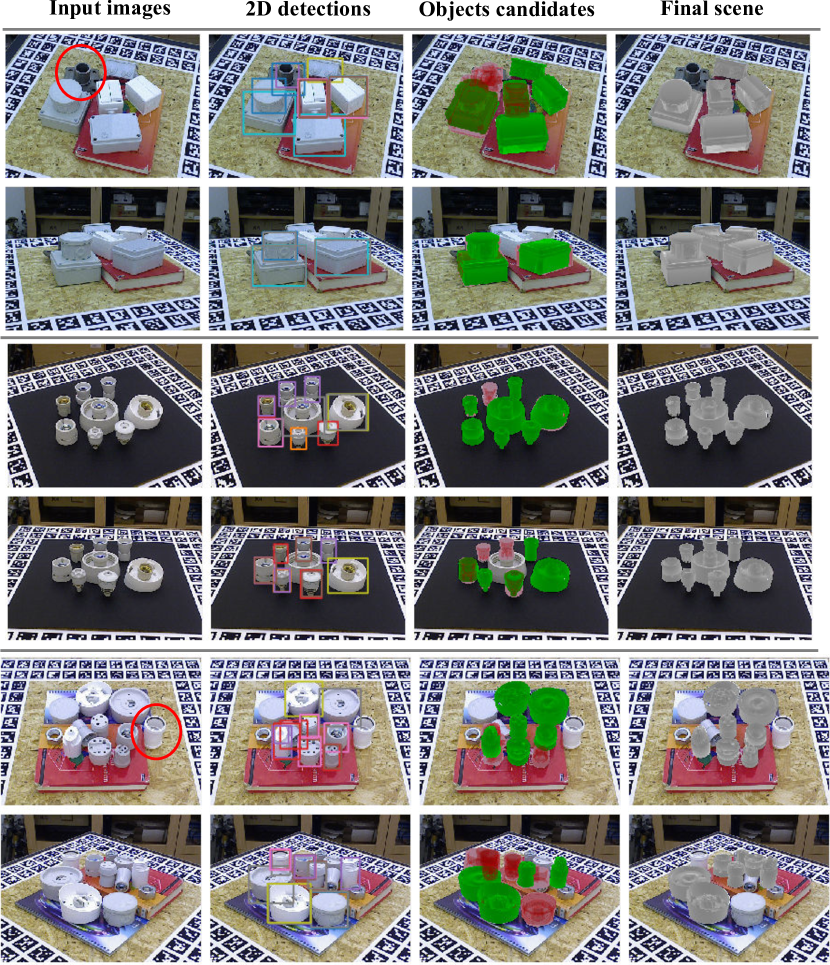
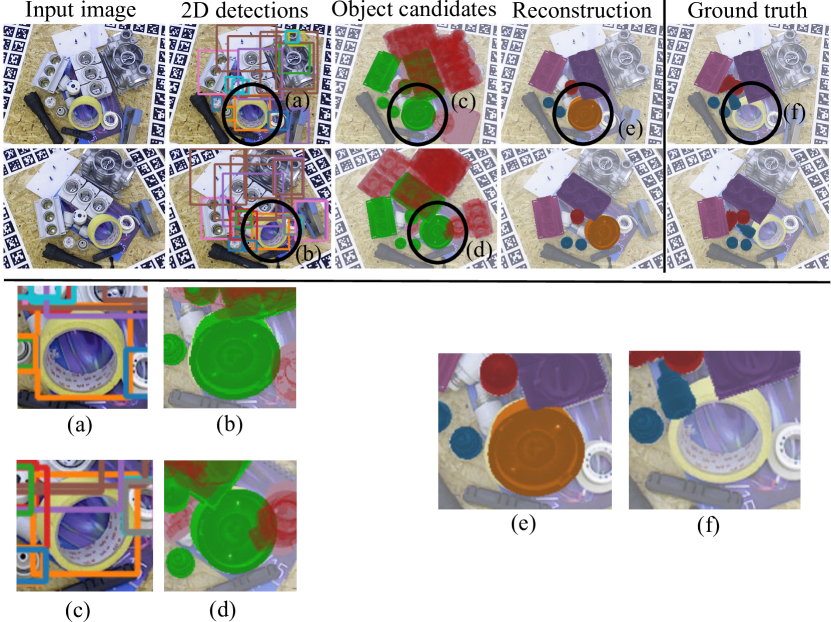
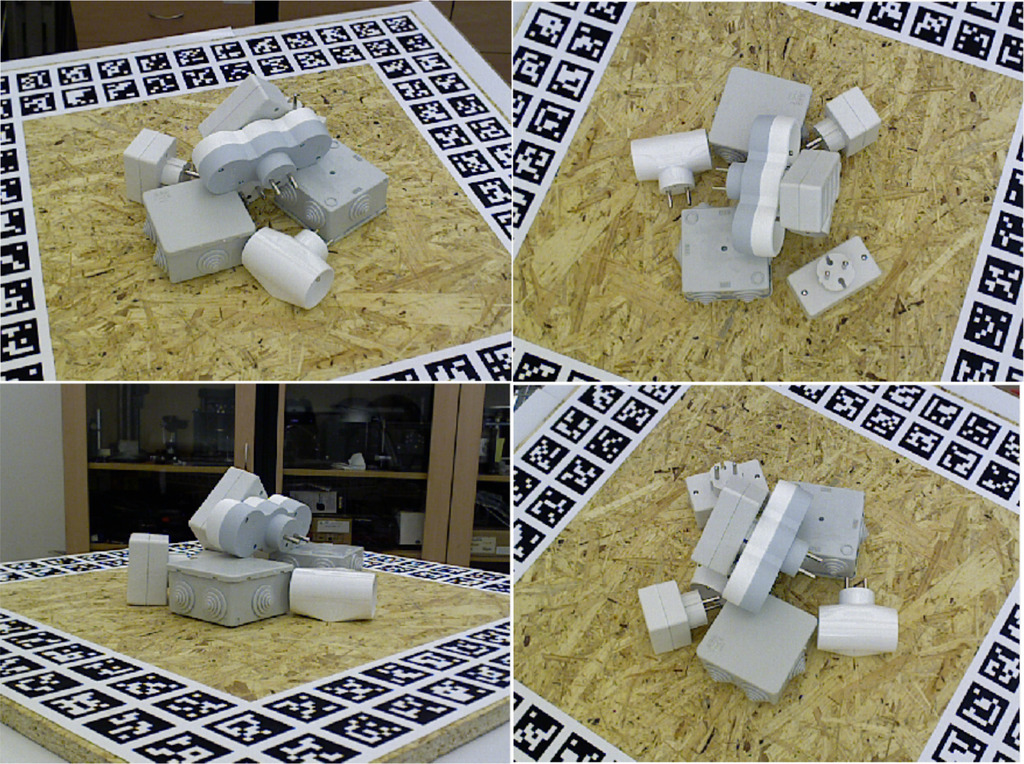
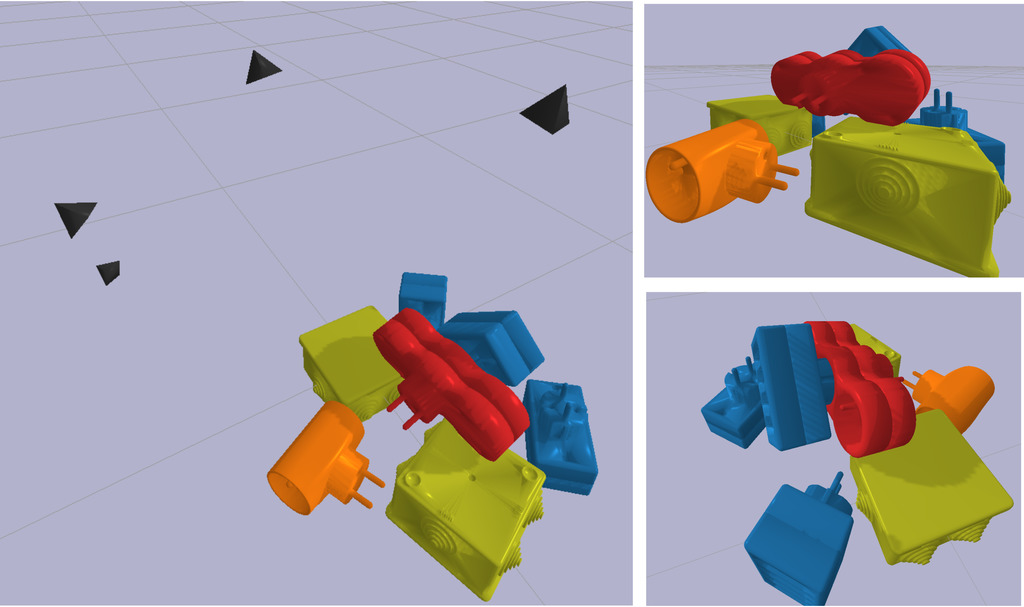
这篇论文把单视角 RGB 6D pose hypothesis、多视角 object-level matching 和 object-level bundle adjustment 串成一个系统,在已知 CAD 模型、未知相机外参、多物体多实例场景中,同时恢复物体数量、物体 6D 位姿和相机位姿。
2.1 图示速览
3. 问题设定
- 任务:多视角、多物体、已知物体实例的 6D pose estimation。
- 输入:同一场景的多张 RGB 图像、相机内参、已知物体 3D/CAD 模型;单视角阶段还需要 2D object detections。
- 输出:一个一致的 scene model,包括每个物体实例的类别、数量、6D pose,以及各视角 camera pose。
- 关键假设 / 先验:
- instance-level、seen-object setting。
- 已知物体 3D 模型和 camera intrinsics。
- 不需要 depth,也不要求输入视角之间已知 camera extrinsics。
- 至少有足够多跨视角一致的 object candidates 用于估计相机关系。
- 适用场景:机器人操作、移动相机或多相机捕获的杂乱已知物体场景,尤其是 textureless、symmetric、occluded objects。
4. 核心动机
- 想解决什么问题:
- 单视角 RGB 位姿估计会受深度歧义、遮挡、误检、漏检影响。
- 多视角信息常常可用,但传统多视角方法往往依赖已知相机外参、local feature matching、depth 或 temporal continuity。
- 为什么这个问题重要:
- 真实机器人系统中,一个场景通常有多个物体;若能得到一致的 scene-level pose,就能更可靠地规划抓取、导航和交互。
- 相比已有方法主要不满在哪里:
- 单视角方法多数把每个 detection 独立处理,不保证 scene-level consistency。
- 早期 object-level SLAM / RGB-D 方法依赖 depth 或连续帧。
- 当场景 textureless、baseline 大、local features 失败时,传统 SfM/COLMAP 式相机估计不稳定。
5. 方法概览
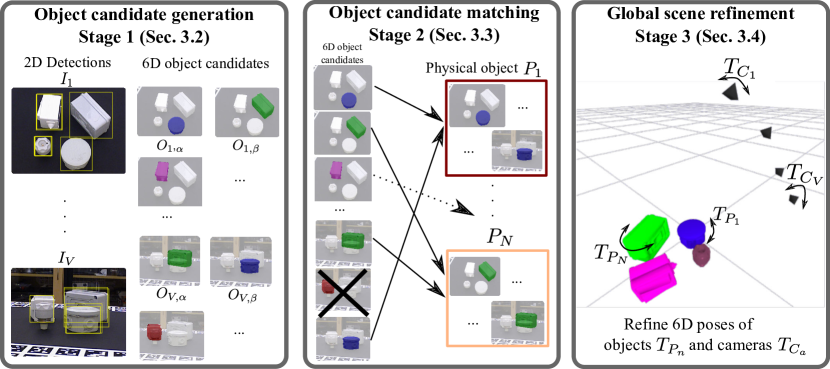
- 总体 pipeline:
- 对每个视角独立检测物体,并生成 object-level 6D pose hypotheses。
- 用 RANSAC 在视角对之间匹配 object candidates,估计相对 camera pose,并过滤不一致候选。
- 将跨视角匹配结果形成 graph,connected component 对应物理物体实例。
- 做 object-level bundle adjustment,联合优化所有 object poses 和 camera poses。
- 关键模块:
- 单视角 pose estimator:受 DeepIM 启发,用 render-and-compare refinement;主干使用 EfficientNet-B3。
- symmetry-aware distance:显式枚举 / 离散化 object symmetries,避免对称物体姿态误差定义不合理。
- RANSAC object matching:采样两个 candidate pairs 来假设 camera transform,并用第三个以上 inliers 验证。
- scene refinement:最小化多视角 object reprojection error,而不是普通 bundle adjustment 的 point reprojection error。
- 使用的基础模型 / 技术:CNN detector、EfficientNet-B3、render-and-compare、RANSAC、Levenberg-Marquardt、bundle adjustment。
- training-free 还是需要训练:需要训练单视角检测和 pose/refinement 网络;多视角 matching 和 global refinement 是几何优化流程。
6. 实验概览
- 数据集:YCB-Video、T-LESS。
- 评估指标:ADD-S、ADD(-S)、AUC of ADD-S / ADD(-S)、VSD recall、ADD-S 0.1d、mAP@ADD-S0.1d 等。
- 主要 baseline:PoseCNN、PVNet、DeepIM、Pix2Pose、Implicit、MCN / A Unified Framework for Multi-view Multi-class Object Pose Estimation。
- 主要结果:
- 单视角阶段:YCB-Video 上 AUC of ADD-S 89.8、AUC of ADD(-S) 84.5,略高于 DeepIM;T-LESS SiSo 上 VSD recall 63.8,显著高于 Pix2Pose 29.5 和 Implicit 26.8。
- 多视角阶段:YCB-Video 5 views AUC of ADD-S 达到 93.4,高于 MCN 80.2,且不需要 GT camera poses。
- T-LESS ViVo:从 1 view 到 4 / 8 views,AUC of ADD-S、ADD-S 0.1d、mAP@ADD-S0.1d 均提升。
- scene refinement:YCB / T-LESS 上 inlier candidates 的平均 ADD-S error 从 6.40 / 4.43 mm 降到 5.05 / 3.19 mm。
| 论文表格 | 设置 | 关键数字 | 粗读结论 |
|---|---|---|---|
| Table 1(a) | YCB-Video single-view,AUC of ADD-S | 89.8 | 单视角 refiner 已经强于 DeepIM 的 88.1 |
| Table 1(b) | T-LESS SiSo,VSD recall | 63.8 | 对 textureless / symmetry-heavy 物体提升很明显 |
| Table 2(a) | YCB-Video multi-view,AUC of ADD-S | 93.4 | 5 views 明显优于 MCN 的 80.2,且不需要 GT camera poses |
| Table 2(b) | T-LESS ViVo,mAP@ADD-S0.1d | 55.0 → 69.0 | 1 view 到 8 views,检测 + 位姿整体质量提升 |
| Table 3 | Scene refinement,ADD-S error | YCB 6.40 → 5.05 mm;T-LESS 4.43 → 3.19 mm | object-level bundle adjustment 确实降低误差 |
- 作者声称的结论是否基本被实验支持:
- 作者声称:多视角一致性显著提升多物体 6D pose,且无需 depth 和已知 camera extrinsics。
- 我的分析:论文内的对比和消融基本支持该主张;但实验仍限定在已知模型、benchmark 数据和离线多视角输入,不等同于任意开放世界场景。
7. 优缺点
优点
- 任务设定有价值:同时处理多物体、多实例、多视角、未知 camera poses。
- 系统设计清晰:单视角 hypothesis 生成 + RANSAC 匹配 + object-level BA,模块边界很明确。
- 对称物体处理比较系统,matching 和优化里都考虑 symmetry-aware distance。
- 不依赖 depth,对 RGB-only 场景更有意义。
- 代码、模型和数据处理脚本公开,适合作为多视角 6D pose baseline。
缺点 / 风险
- 依赖 2D detector 和单视角 pose estimator,前端连续出错时后端无法彻底修复。
- 需要 CAD / 3D model,不是 open-vocabulary 或 category-level 方法。
- 候选必须跨视角匹配;如果某个物体只在一个视角被正确检测,最终可能丢失。
- 若错误候选在多个相似视角中保持一致,RANSAC/graph matching 可能把错误物体保留下来。
- 工程链路较长:检测、渲染、pose refinement、RANSAC、global optimization 都要调通。
8. 对我的启发
- 可以借鉴的点:
- 把单帧 pose predictions 当成 object-level measurements,再做 scene-level optimization。
- 对称性不只用于评价,也应进入 matching、loss 和 refinement。
- 多视角约束可以用来过滤 false positives / distractors。
- 可以作为 baseline 吗:
- 对已知 CAD、多视角 RGB、多物体场景,非常值得作为 baseline。
- 对单目单帧、category-level、open-world 场景则不是直接 baseline。
- 是否值得精读:
- 值得。尤其是 Stage 2 的 object candidate matching、Stage 3 的 object-level bundle adjustment,以及 appendix 中的 failure modes。
- 后续需要查的问题:
- 代码当前维护状态和可运行环境。
- 后续多视角 6D pose 方法是否已经替换掉 CosyPose 的 matching / refinement 设计。
- 如果结合 SAM / foundation detector / modern pose refiner,能否保留 CosyPose 的 scene consistency 框架。