论文精读笔记:Diffusion Features for Pose
1. 核心判断
这篇工作的关键不是用 diffusion model 生成 pose,而是将 Stable Diffusion U-Net 当成多尺度视觉 backbone。作者观察到:
discriminative pose feature 在训练对象上很准,但到未见对象会掉;
Stable Diffusion 的中间 feature 在没有见过 LM / O-LM 目标实例时,仍能保留局部外观与视角结构;
不同 U-Net 层对不同对象最有效,因此不能固定选一个层;
一个随输入分配层权重的聚合器,能把这些通用 feature 适配为 pose-template similarity。
正式 CVPR 版本在 unseen LM / O-LM 达 98.2 / 85.9 Acc15,T-LESS VSD recall 为 71.03。结果很强,但协议也较窄:使用真值 object crop、测试时 CAD 和大量模板;LM / O-LM 主要评对象身份与 rotation,不等于完整检测到 6D pose。
2. 任务设定与输出到底是什么
给定:
query RGB object crop I q I_q I q
候选对象 CAD;
每个对象在不同 pose 下的 template images { I t k } \{I_t^k\} { I t k }
模型计算相似度:
s ( I q , I t k ) = Avg ( u , v ) ∈ M k [ cos ( F ^ q ( u , v ) , F ^ t k ( u , v ) ) ] , s(I_q,I_t^k)=
\operatorname{Avg}_{(u,v)\in \mathcal M_k}
\left[
\operatorname{cos}
\left(
\hat F_q(u,v),\hat F_t^k(u,v)
\right)
\right], s ( I q , I t k ) = Avg ( u , v ) ∈ M k [ cos ( F ^ q ( u , v ) , F ^ t k ( u , v ) ) ] , 经过 threshold 和 template mask 过滤,选择最大相似度模板,将其 object id 与 pose 赋给 query。
LM / O-LM 的 Acc15 同时要求:
d ( R ^ , R ) = 1 π arccos ( tr ( R ⊤ R ^ ) − 1 2 ) < 15 ∘ , d(\hat R,R)=
\frac{1}{\pi}
\arccos\left(\frac{\operatorname{tr}(R^\top\hat R)-1}{2}\right)
<15^\circ, d ( R ^ , R ) = π 1 arccos ( 2 tr ( R ⊤ R ^ ) − 1 ) < 1 5 ∘ , 且对象类别 / id 正确。
T-LESS 使用 VSD recall@0.3,并沿用 SSD-6D 的 projective distance translation estimation。换言之:
论文主要学习 pose-aware image similarity ;
rotation 来自 best template;
translation 不是 diffusion aggregator 直接回归;
detection / cropping 不在主协议内。
3. 为什么 diffusion features 可能泛化
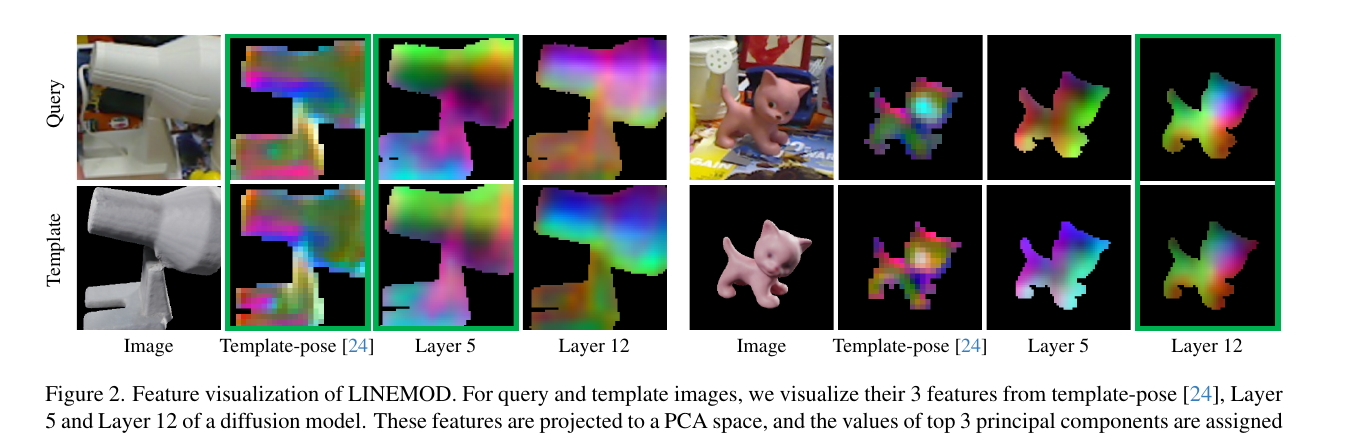
原论文 Figure 2。作者将 template-pose feature 与 Stable Diffusion 第 5、12 层 feature PCA 到 RGB;绿色框显示不同对象的最佳层并不相同。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
作者先对 LINEMOD query / template 的 feature 做 PCA visualization:
Template-pose 的 task-specific feature 对训练对象有判别性,但对 unseen appearance 的对应更不稳定;
Stable Diffusion 浅 / 中层更保留局部结构,高层更偏对象语义与大尺度形状;
lamp 上 layer 5 更一致,cat 上 layer 12 更一致;
因此“最佳 layer”依赖输入对象和场景。
这里的泛化不来自 diffusion sampling,也不需要 text prompt。Stable Diffusion 在 LAION-5B 上学到的生成式视觉统计被当作 frozen prior。
论文将输入图直接送入 SD v1.5:
resolution 512;
timestep t = 0 t=0 t = 0
不人为加噪;
使用 unconditional text embedding;
抽取 U-Net 各层 features;
统一到 64 × 64 64\times64 64 × 64
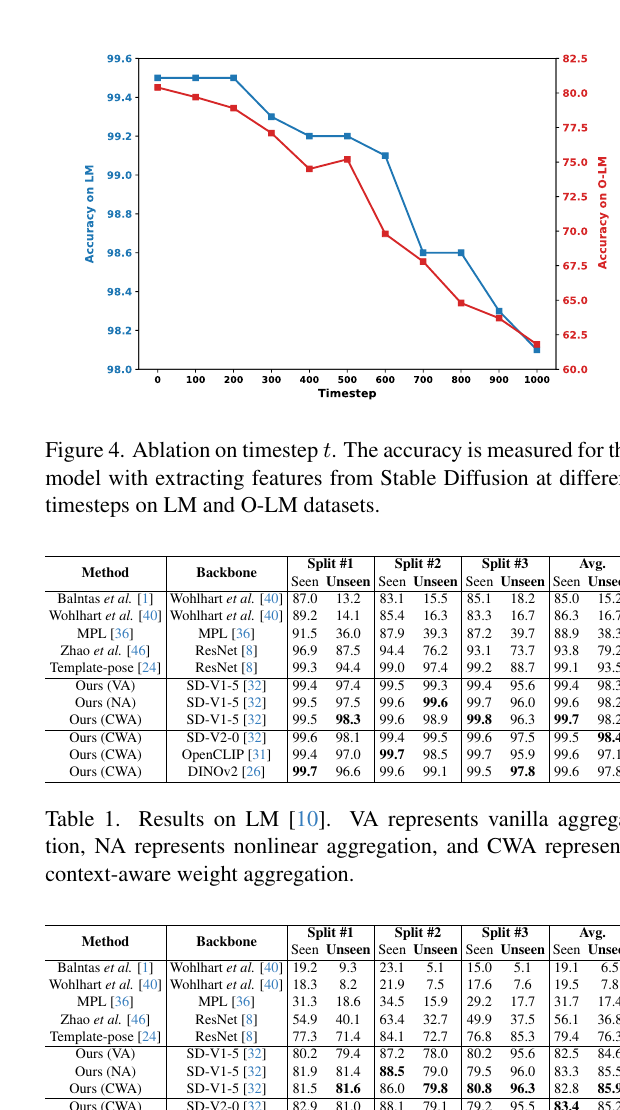
timestep ablation 显示从 0 增到 1000 时 LM / O-LM accuracy 持续下降。对干净 object image,模型假设噪声越大,feature 越偏离精细姿态。
4. 三种聚合器
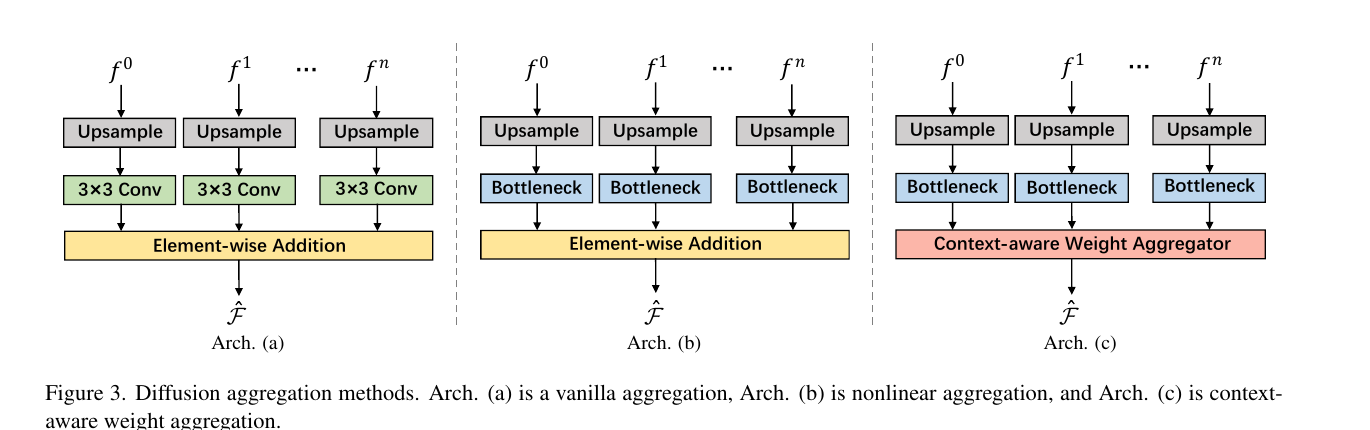
原论文 Figure 3。三种方法都先统一 feature resolution;区别是逐层线性映射、带残差 bottleneck 的非线性映射,以及按 query context 动态赋权。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
设 U-Net 多层 feature 为 { f i } i = 1 n \{f_i\}_{i=1}^n { f i } i = 1 n
4.1 Vanilla aggregation,VA
F ^ = ∑ i = 1 n Φ ext i ( f i ) . \hat F=\sum_{i=1}^{n}\Phi_{\text{ext}}^i(f_i). F ^ = i = 1 ∑ n Φ ext i ( f i ) . 每层先上采样、3×3 conv 投影到统一 channels,再相加。它参数少(2.53M),但所有层固定等权,表达能力受限。
4.2 Nonlinear aggregation,NA
将普通 conv extractor 换成含三层 convolution、ReLU 和 skip connection 的 bottleneck。最后卷积采用 zero initialization,初始时近似 identity / zero residual,减少有限 pose 数据破坏预训练 feature 的风险。
NA 参数 13.28M,在 O-LM unseen 为 85.5,明显优于 VA 84.6。
4.3 Context-aware weight aggregation,CWA
先计算:
h i = Φ ext i ( f i ) , h_i=\Phi_{\text{ext}}^i(f_i), h i = Φ ext i ( f i ) , 全局池化得到每层摘要 l i l_i l i
{ w 1 , … , w n } = softmax ( MLP ( [ l 1 , … , l n ] ) ) . \{w_1,\ldots,w_n\}
=\operatorname{softmax}(\operatorname{MLP}([l_1,\ldots,l_n])). { w 1 , … , w n } = softmax ( MLP ([ l 1 , … , l n ])) . 最终:
F ^ = ∑ i w i h i . \hat F=\sum_iw_ih_i. F ^ = i ∑ w i h i . CWA 的意义是对 lamp、cat 等不同对象选择不同层组合,而不是学一组全数据固定标量。参数 13.29M,与 NA 几乎相同,性能提升来自动态 weighting。
5. 训练与模板匹配
Stable Diffusion 全部冻结,只训练聚合器。对每张真实训练图:
1 个同对象 / 正确 pose 的 positive template;
M − 1 M-1 M − 1 用 InfoNCE 拉近正 pair、推开负 pair。
测试 similarity 沿用 Template-pose:
对 query / template fused feature 求 dense cosine similarity;
threshold 去掉低置信度位置;
template mask 只保留前景;
对剩余值平均;
检索最高分 template。
这种设计的优点是训练目标与 inference retrieval 一致;缺点是速度和内存随 template count 增长,且需要可靠 crop / mask。
6. 数据协议
LM / O-LM:
LM 13 个 objects;
按 object 分成三个 non-overlapping groups;
每组保留 10% 图像评 seen objects;
在 LM 训练,在 LM 与 heavily-occluded O-LM 测试;
每对象 301 templates;
使用 GT pose 居中裁剪 object,遵循 Template-pose 协议。
T-LESS:
30 个 textureless、对称、相似 industrial objects;
objects 1–18 seen,19–30 unseen;
只用 seen objects 训练;
测试完整 test set;
每对象 21,672 templates;
使用 GT bounding box crop;
指标为 VSD recall@0.3。
模板数“21K”和“92K”是约数:
论文主方法:21,672;
Template-pose full:约 92k;
同模板量 Template-pose:约 21k。
7. LM / O-LM 结果
原论文 Figure 4 与 Table 1–2。上方证明 clean-image extraction 最适合 timestep 0;下方按三个 object splits 报 seen / unseen Acc15。来源:CVPR 2024 正式论文 ;图表版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
平均 Acc15:
Backbone / aggregation LM seen LM unseen O-LM seen O-LM unseen Template-pose / ResNet 99.1 93.5 79.4 76.3 SD-v1.5 / VA 99.4 98.3 82.5 84.6 SD-v1.5 / NA 99.6 98.2 83.3 85.5 SD-v1.5 / CWA 99.7 98.2 82.8 85.9 SD-v2.0 / CWA 99.5 98.4 83.4 85.2 OpenCLIP / CWA 99.6 97.1 81.9 81.1 DINOv2 / CWA 99.6 97.8 83.1 78.1
几个重要解读:
CWA 不是每列都最高;LM unseen 的 SD-v2.0 为 98.4,O-LM seen 的 NA / SD-v2.0 更高。
主张应是“SD features + learned aggregation 整体泛化更强”,不是 CWA 在所有条件绝对最优。
O-LM unseen 85.9 相对 76.3 提升 9.6 points;论文正文写“10.9%”更接近相对增幅表达,网站统一按百分点描述。
DINOv2 在 O-LM unseen 只有 78.1,说明该任务 / 实现下生成式 feature 的 occlusion robustness 更明显;不能泛化成所有几何任务 diffusion 都优于 DINOv2。
8. T-LESS:模板量、对称性与完整 6D
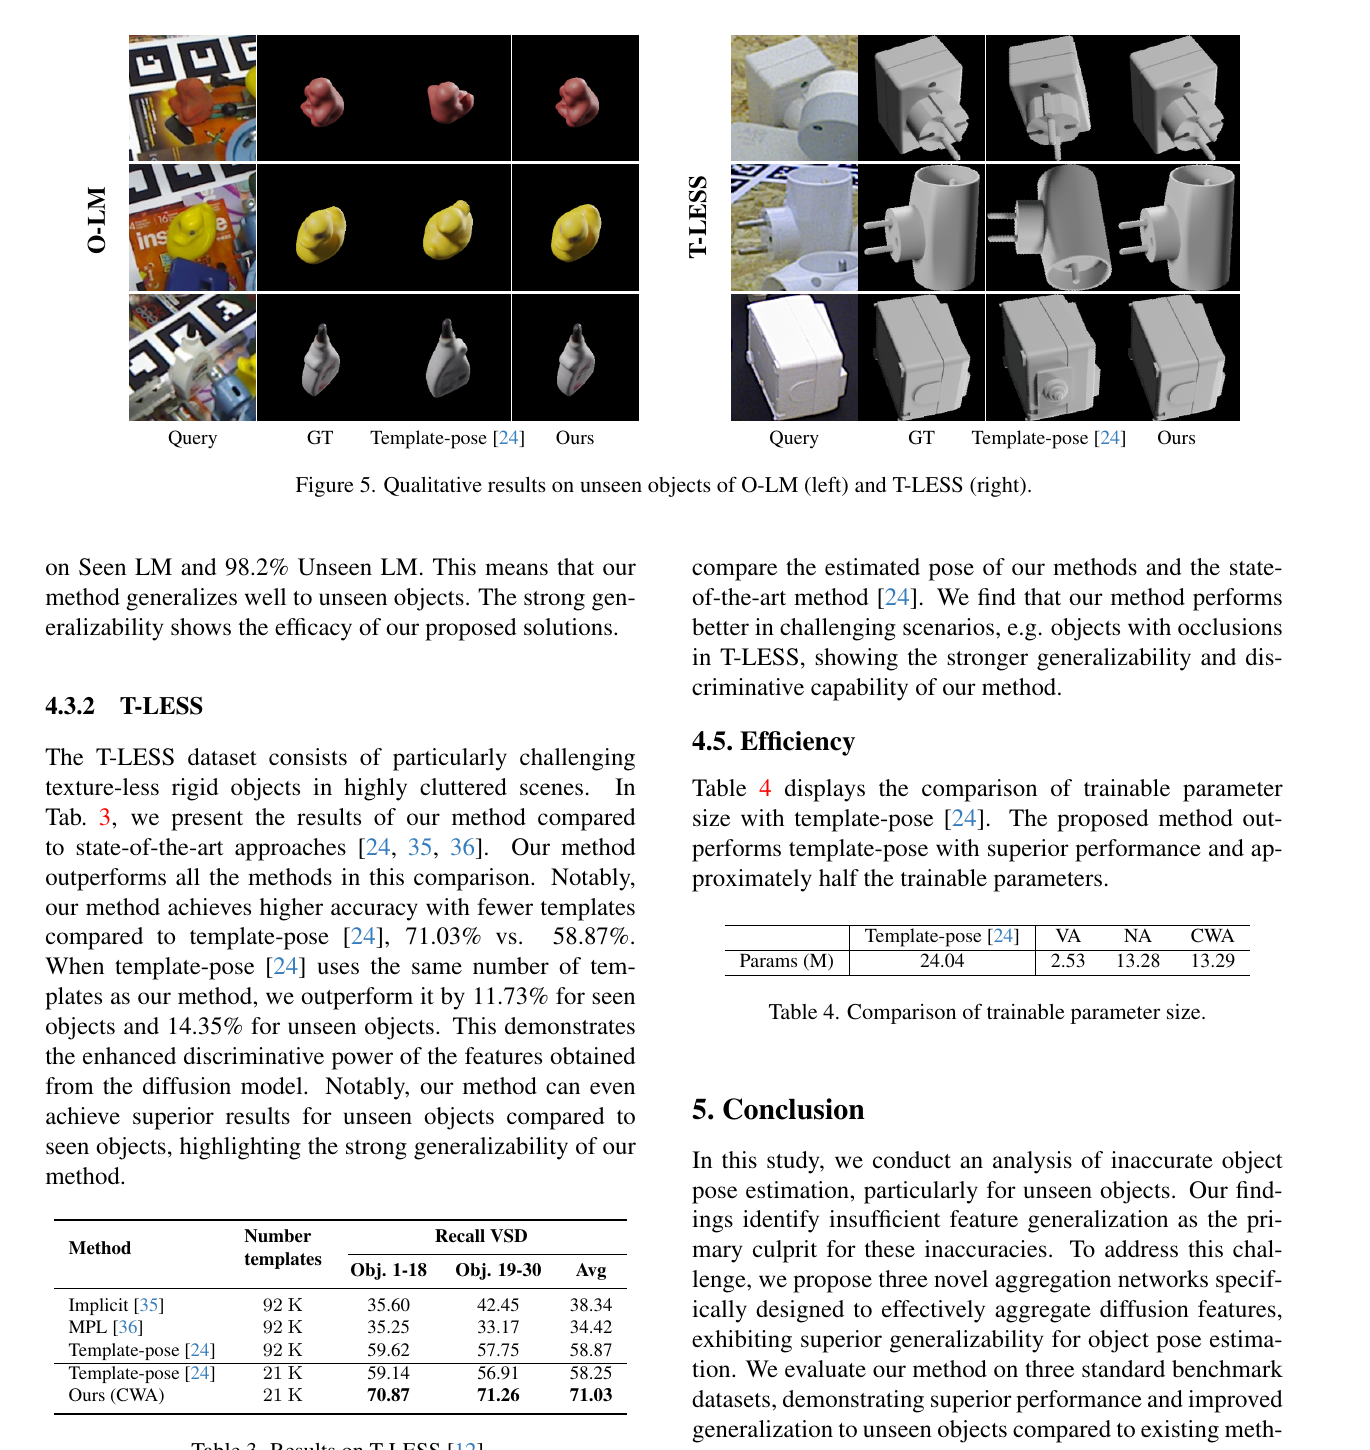
原论文 Figure 5 与 Table 3–4。上方对比 unseen objects 的 GT、Template-pose 与本文检索;Table 3 报 T-LESS seen / unseen VSD recall,Table 4 只统计可训练聚合器参数。来源:CVPR 2024 正式论文 ;图表版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
方法 模板 / object Seen 1–18 Unseen 19–30 Avg Implicit 92k 35.60 42.45 38.34 MPL 92k 35.25 33.17 34.42 Template-pose 92k 59.62 57.75 58.87 Template-pose 21k 59.14 56.91 58.25 CWA 21k 70.87 71.26 71.03
主方法在 unseen 略高于 seen,这不表示未知对象天然更容易;两组 object identity、对称性和可见性分布不同。合理结论是 seen→unseen 没出现明显崩溃。
T-LESS 数字还受以下模块共同影响:
template rotation sampling;
VSD symmetry handling;
SSD-6D projective translation;
GT crop;
template render quality。
所以 71.03 不能全部归因于 rotation feature。
9. 参数与效率
可训练参数:
模型 参数 Template-pose 24.04M VA 2.53M NA 13.28M CWA 13.29M
该表不包括:
冻结 Stable Diffusion v1.5 U-Net 的数亿参数;
多层 feature storage;
21,672 templates / object 的离线与在线开销;
对所有 templates 计算 similarity 的时间;
external crop / detector;
T-LESS translation module。
因此论文证明的是 trainable adaptation 更轻 ,不是端到端系统一定比 Template-pose 更快或更省显存。部署评估必须额外测 latency、peak memory、template database size。
10. 与其他 foundation-feature pose 的关系
与 FoundPose / GigaPose:
三者都利用大模型 feature 做 unseen-object CAD matching;
GigaPose 通过自由度分解只保留 162 templates,并明确优化速度;
本文关注多层 diffusion feature 的表示泛化,模板库远大;
FoundPose 更强调 DINOv2 feature matching 与几何 correspondence。
与 diffusion pose generation:
SE(3) Score Diffusion / 6D-Diff 使用扩散过程生成 pose 或 keypoints;
本文不运行 pose denoising,不输出 pose distribution;
“Diffusion Features”指预训练扩散网络的 deterministic intermediate representation。
与 DIFT:
都从 frozen diffusion model 提取 correspondence feature;
本文额外学习 task-specific layer aggregation,并在 template-based object pose 协议评测。
11. 局限与公平性
使用 GT bounding box / crop,未计 detection failure;
测试需 object CAD;
301 / 21,672 templates 带来数据库与检索成本;
LM / O-LM Acc15 不评 translation;
T-LESS translation 来自外部 projective-distance method;
参数表不包含 frozen SD backbone;
不报告完整端到端 latency / memory;
三个 benchmark 的对象规模仍小;
对极端光照、真实材质、domain shift 的测试有限;
similarity averaging 依赖 template mask,segmentation boundary error 仍会影响;
feature layer 数和 extractor resolution 会显著影响显存;
CVF 正式版与早期 arXiv 摘要的 unseen LM 数字曾有差异,应以正式主表 98.2 为准。
12. 复现检查表
使用 Stable Diffusion v1.5 的完全相同 checkpoint;
图像 resize 到 512,timestep 0,不加噪;
明确 unconditional text embedding;
抽取相同 U-Net layers;
统一输出 64 × 64 64\times64 64 × 64
冻结 SD,只训练 aggregation network;
NA / CWA bottleneck 最后一层 zero initialization;
复现三个 object-disjoint splits;
LM / O-LM 每对象 301 templates;
T-LESS 精确使用 21,672 templates;
GT crop 与 template mask 协议保持一致;
Acc15 同时检查 object id 与 rotation;
T-LESS 使用同一 VSD threshold 0.3 与 translation code;
参数量外额外报告 total backbone、latency、VRAM 和 template disk size;
分开报 seen / unseen,不只报平均。
13. 最终评价
这篇论文最扎实的贡献是将“diffusion 中间层是否适合 pose”从直觉变成了跨层可视化、timestep 消融、三类聚合器和多 backbone 对照。O-LM unseen 85.9 对 76.3、T-LESS 71.03 对 58.87,说明生成式预训练 feature 对遮挡和未见对象确有价值。
但它不是完整的通用 6D pose system:真值 crop、CAD、模板库、外部 translation estimator 都是协议的一部分,参数表也不能代表总成本。最准确的结论是:冻结扩散模型的多层局部 feature 经 context-aware aggregation 后,可显著改善 CAD-template pose retrieval 的 unseen-object 泛化;它解决的是表示瓶颈,而非检测、几何求解和系统效率的全部问题。