论文精读笔记:DiffusionNOCS
1. 核心判断
DiffusionNOCS 的关键不是简单地把 pose regression 换成 diffusion,而是重新选择了随机变量:模型生成的是与图像对齐的 稠密 NOCS 图。这个中间表示同时承载局部形状、2D–3D 对应和对称姿态的多模态分布,随后仍可交给经典几何求解器恢复尺度与 6D pose。
作者的主要主张是:仅用合成数据训练,依靠扩散的多假设能力与可选择的多模态条件,可以在多种真实环境中比确定性类别级方法更稳定。我的判断是,这一主张在论文的跨数据集结果上有较强证据,但性能由 diffusion、DINOv2 语义特征、法向预处理和新的合成训练协议共同带来,不能把全部提升都归因于扩散模型。
2. 问题设定与任务边界
给定单个目标的二维检测框、类别 ID 和观测图像,目标是估计未知类别实例相对相机的旋转 R、平移 t 与尺度 s。方法默认深度可用,并可选地使用 RGB、表面法向和 DINOv2 特征。
这里的“category-level”意味着训练时看过类别,但没有看过测试实例;“zero-shot generalization”指训练只使用作者合成数据,直接在 TYO-L、YCB-V、HOPE 等真实数据集上评测,并不表示可处理训练类别集合之外的任意新类别。
需要明确的系统前提包括:
- 前端已经给出正确的目标框、类别 ID 与分割区域;
- 相机内参已知,深度具有足够有效像素;
- 训练类别有可用的 ShapeNet 模型;
- 最终结果是从多个样本中选一个点估计,不是完整的 pose posterior 或校准协方差。
3. 为什么选择 NOCS 分布,而不是直接生成 pose?
NOCS 将每个物体实例归一化到 [0,1]3 的类别共享规范空间。图像中的每个前景像素对应一个三维规范坐标,因此预测 NOCS 图等价于预测一组稠密的观测表面—规范表面对应。
这种设计有三点好处:
- 几何可解释:NOCS 与深度点能组成 3D–3D 对应,最终可用鲁棒配准而非黑盒回归得到 pose。
- 同时恢复部分形状:输出不是 6 或 9 个全局参数,而是可见表面的规范坐标图。
- 多解自然存在:对于碗、罐等轴对称物体,不同噪声可以收敛到一组等价 NOCS 图与姿态,而不必强迫网络平均成一个不合法旋转。
代价是模型要生成高维图像型变量,推理比直接回归更慢;而且 NOCS 的类别规范化本身仍依赖一致的合成模型朝向。
4. 方法详解
4.1 多模态条件构造
论文使用四类信息:
- Surface normal:由深度直接计算。它比原始深度更少纠缠尺度、平移和相机参数,适合作为几何条件。
- RGB:提供材质、纹理和部件外观,可用可见把手等线索打破纯几何对称。
- DINOv2 feature:从 RGB 提取高维语义特征,再用 PCA 压缩。作者最终选 6 维,在训练与推理中使用同一投影。
- Category ID:通过 embedding 输入扩散网络,告诉模型应生成哪一种类别的规范坐标分布。
训练时以 25% 概率丢弃某个输入表示,使同一网络适应 N、RGB-N、DINO-N、RGB-DINO-N 等组合。这个做法很像 modality dropout:它是“可选输入”成立的重要条件,而不是推理时简单地把缺失通道置零。
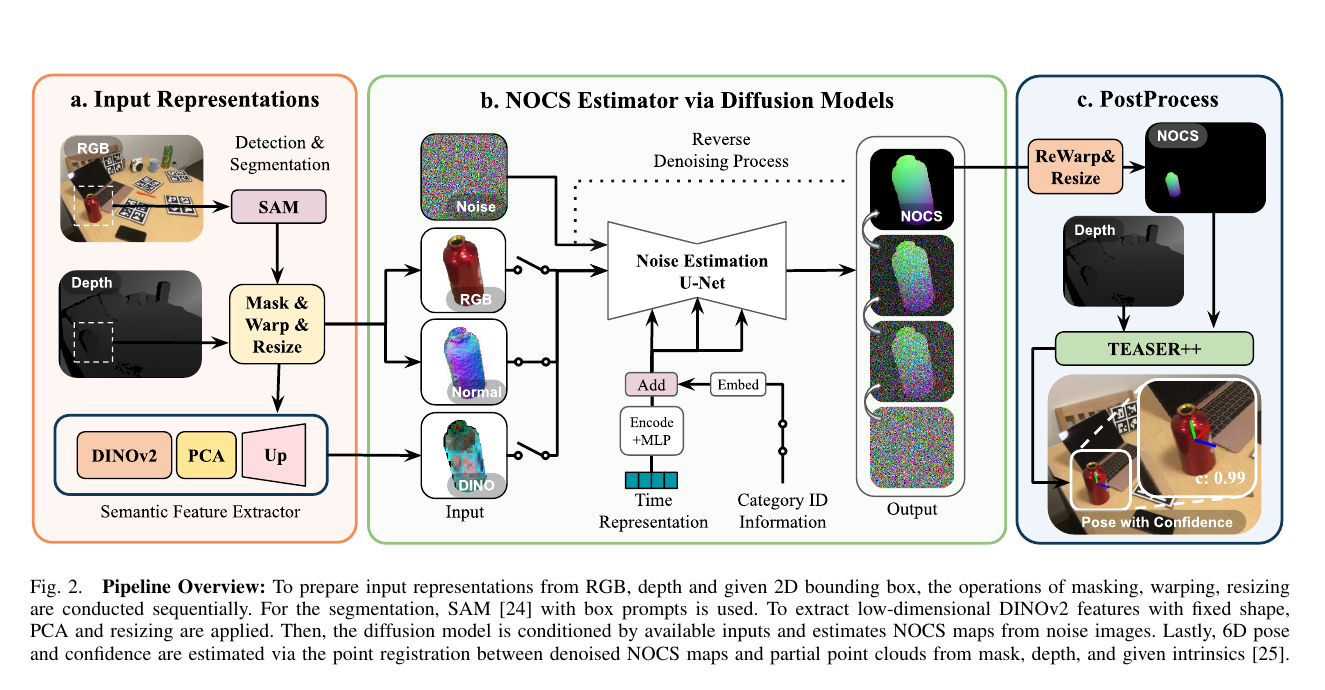 原论文 Figure 2。流程分为输入表示、条件扩散 NOCS 估计和几何后处理三段;这张图比论文首页示意图更准确地展示了方法的数据流。来源:作者公开稿;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
4.2 条件扩散 NOCS 估计
模型以二维 U-Net 为主干,将有条件输入与当前噪声 NOCS 图拼接。时间步经过正弦位置编码和 MLP,类别 ID 经 embedding 后共同注入 U-Net。训练目标是标准的逐像素噪声预测:
L=MSE(ϵk,ϵθ(I,C,N0+ϵk,k)),
其中 I 表示当前可用的图像条件,C 是类别,N0 是真实 NOCS 图,k 是扩散时间步。
训练使用 1000 步 DDPM 噪声日程;推理不执行完整 1000 步,而是使用 10 步 DPM-Solver。默认从 6 份独立高斯噪声出发,得到 6 个候选 NOCS 图。
4.3 从 NOCS 图到 6D pose
对检测框内的每个有效像素:
- 深度经内参反投影为相机坐标点;
- 扩散输出提供对应的 NOCS 三维点;
- 观测点与 NOCS 点组成带离群值的 3D–3D 对应;
- TEASER++ 求解包含尺度的鲁棒相似变换;
- 以求解后的 inlier ratio 作为该样本的 pose confidence;
- 在多个噪声样本中选置信度最高者。
因此,扩散负责产生假设,TEASER++ 负责保证刚体几何一致性。这个分工也解释了为何方法仍需要深度:RGB 可以补充 NOCS,但最终对齐依赖真实相机坐标点。
5. 合成数据与泛化协议
作者从 ShapeNet 中为每个目标类别选择 20 个模型,并沿二十面体采样相机视角;每个实例渲染 162 张、分辨率 160×160 的 RGB、深度、法向、NOCS 和类别标签。训练类别覆盖 NOCS 中的瓶、碗、相机、罐、笔记本电脑和马克杯。
跨域评测使用:
- TYO-L:真实工业/日常对象,姿态分布更自由;
- YCB-V:真实桌面场景,但多个类别与 NOCS 相近,且对象常直立、光照较稳定;
- HOPE:真实家居对象与不同遮挡、光照条件。
作者只选择这些数据集中与 NOCS 类别重合的对象。论文还针对“can”同时存在轴对称和反射对称的情况调整旋转误差,使对称轴正反方向等价。这个改动合理,但意味着结果不是原封不动套用所有数据集的默认 protocol,复现时必须保留其对称定义。
6. 结果怎样读
6.1 NOCS REAL275
仅合成数据训练时:
| 配置 | 5°5cm | 10°5cm | 15°5cm |
|---|
| Normal only | 28.7 | 56.3 | 65.5 |
| RGB + Normal | 33.5 | 62.8 | 72.2 |
| DINO + Normal | 34.5 | 66.7 | 77.0 |
| RGB + DINO + Normal | 35.0 | 66.6 | 77.1 |
加入外观或语义特征明显优于只用法向;但 DINO-N 在 10°5cm 上略高于完整组合,说明更多模态并不保证每个阈值都单调提升。
6.2 跨数据集泛化
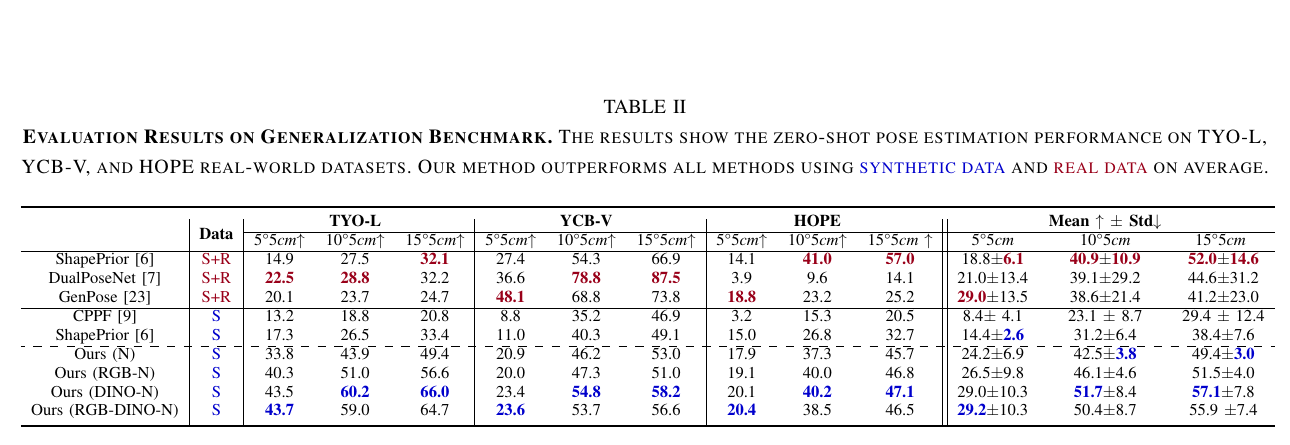 原论文 Table II。红色是使用合成+真实训练数据方法的最佳值,蓝色是仅合成训练方法的最佳值。DiffusionNOCS 的优势主要体现在三套环境的平均稳定性,而不是每个单独数据集都取绝对最高。来源:作者公开稿;表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
- RGB-DINO-N 在三套数据上的平均
5°5cm 为 29.2±10.3,对比仅合成训练 ShapePrior 的 14.4±2.6。
- DINO-N 的平均
10°5cm / 15°5cm 为 51.7 / 57.1。
- YCB-V 上,使用真实数据训练的 DualPoseNet、GenPose 明显更强;作者认为其训练域与 YCB-V 的直立物体、近距离与光照条件更接近。
- 因此准确结论是“仅合成训练时跨环境平均泛化强”,而不是“在所有真实 benchmark 上全面超过使用真实训练数据的方法”。
6.3 多假设与速度
| 噪声样本数 | PCA 维度 | 5°5cm | 10°5cm | 15°5cm | 时间 |
|---|
| 1 | 6 | 30.0 | 54.1 | 63.4 | 0.386 s |
| 3 | 6 | 34.5 | 65.0 | 75.2 | 0.522 s |
| 6 | 6 | 35.0 | 66.6 | 77.1 | 0.855 s |
| 9 | 6 | 35.3 | 66.6 | 77.1 | 1.147 s |
从 1 增至 6 个样本时,较宽松阈值提升约 13 个点;从 6 增至 9 已基本饱和。这支持“多假设有用”,也显示默认配置是清晰的精度—延迟折中,而非免费的提升。
7. 对称性与不确定性:论文证明了什么?
作者可视化 20 次采样:
- 碗的候选旋转沿对称轴形成连续分布;
- 可见把手的马克杯形成清晰单峰;
- 把手不可见时,候选沿可能的把手方向分散。
这说明生成分布在定性上与可观测性相符。但论文最终仍只用最大 inlier ratio 选择一个 pose,没有报告负对数似然、coverage、expected calibration error 或多假设 recall。因此,更谨慎的说法是“扩散采样产生了符合对称结构的候选”,还不能等同于“获得了经过校准的 pose uncertainty”。
8. 批判性分析
优点
- 随机变量选择合理:NOCS 比直接 pose 更容易连接生成模型与几何求解。
- 对称性处理不依赖逐类别枚举的 loss,理论上更容易扩展。
- modality dropout 让单模型支持不同传感器组合。
- 跨 TYO-L、YCB-V、HOPE 的统一评测比只在 NOCS REAL275 上报告结果更能说明 sim-to-real 稳定性。
局限
- “多模态可选”仍不等于 RGB-only pose;默认求解链路需要深度。
- 检测、分类与分割由前端提供,端到端系统误差未被计入。
- 训练类别仍来自 NOCS 六类,不能直接外推到开放类别。
- 0.855 s 只是论文指定 V100 配置的 pose 阶段时间,不含检测、SAM、DINOv2 特征和所有数据搬运时,很难直接理解为整套系统帧率。
- 不确定性只通过采样形态与最终候选选择展示,缺少 calibration 与 failure probability 分析。
9. 复现清单
- 固定 ShapeNet 模型子集、类别坐标系和二十面体视角采样;
- 记录深度到表面法向的实现与边界处理;
- 保存 DINOv2 版本、PCA 拟合数据和 6 维投影矩阵;
- 训练时复现 25% modality dropout 与 1000 步 DDPM 日程;
- 推理记录 DPM-Solver 步数、噪声样本数和随机种子;
- 明确 TEASER++ 阈值、inlier ratio 定义以及尺度恢复;
- 对 TYO-L / YCB-V / HOPE 使用论文一致的类别子集和 can 对称误差。
10. 可延伸方向
- 将“选最高置信单解”改为保留多个 pose hypotheses,并在抓取碰撞检查或多视角主动观测中消歧;
- 用深度有效性 mask 显式调节不同模态的条件强度,而不是只在训练时随机丢模态;
- 将 NOCS diffusion 扩展到可动物体的部件级规范坐标与关节状态;
- 报告可校准的不确定性指标,并研究样本多样性与真实 pose coverage 的关系;
- 采用 consistency / distillation 将多步扩散压缩为实时少步预测。
11. 最终评价
DiffusionNOCS 是 IROS 2024 类别级 pose 论文中很有代表性的一篇:它并非只追求某个 benchmark 的最高数字,而是把对称多解、模态缺失和 synthetic-to-real 放进同一条生成式对应链路。最应借鉴的是“NOCS 分布 + 鲁棒几何求解”的模块划分;最需要继续验证的是不确定性是否校准,以及在包含前端检测与特征提取后的真实系统延迟。
