论文精读笔记:Learning Distributional Demonstration Spaces for Task-Specific Cross-Pose Estimation
1. 基本信息
- 作者 / 机构:Jenny Wang、Octavian Donca、David Held;Carnegie Mellon University
- 年份 / 会议:2024 / ICRA
- 论文:arXiv / PDF
- 项目页:TAX-PoseD
- 阅读模式:精读
2. 核心问题
对相对放置任务,正确答案往往不是单一 SE(3):杯子可挂在左挂钩或右挂钩,盘子可放在任一餐垫。单峰回归会预测多个模式的均值,而这个“平均 pose”通常恰好处于两个支撑点之间。TAX-PoseD 学的是有效 cross-pose 的分布。
3. 绝对 pose、relative pose 与 cross-pose
给定 action object A 和 anchor object / scene B,任务要预测
TAB=f(PA,PB)∈SE(3),
使 TABTA 与 TB 形成 demonstration 定义的关系。若同时对两对象施加同一世界变换,关系仍应成立。因此网络应关注对象间 geometry,而非世界坐标。本文输入是 segmented point clouds,不要求 object identity 或人工标注“哪个点是挂钩”。
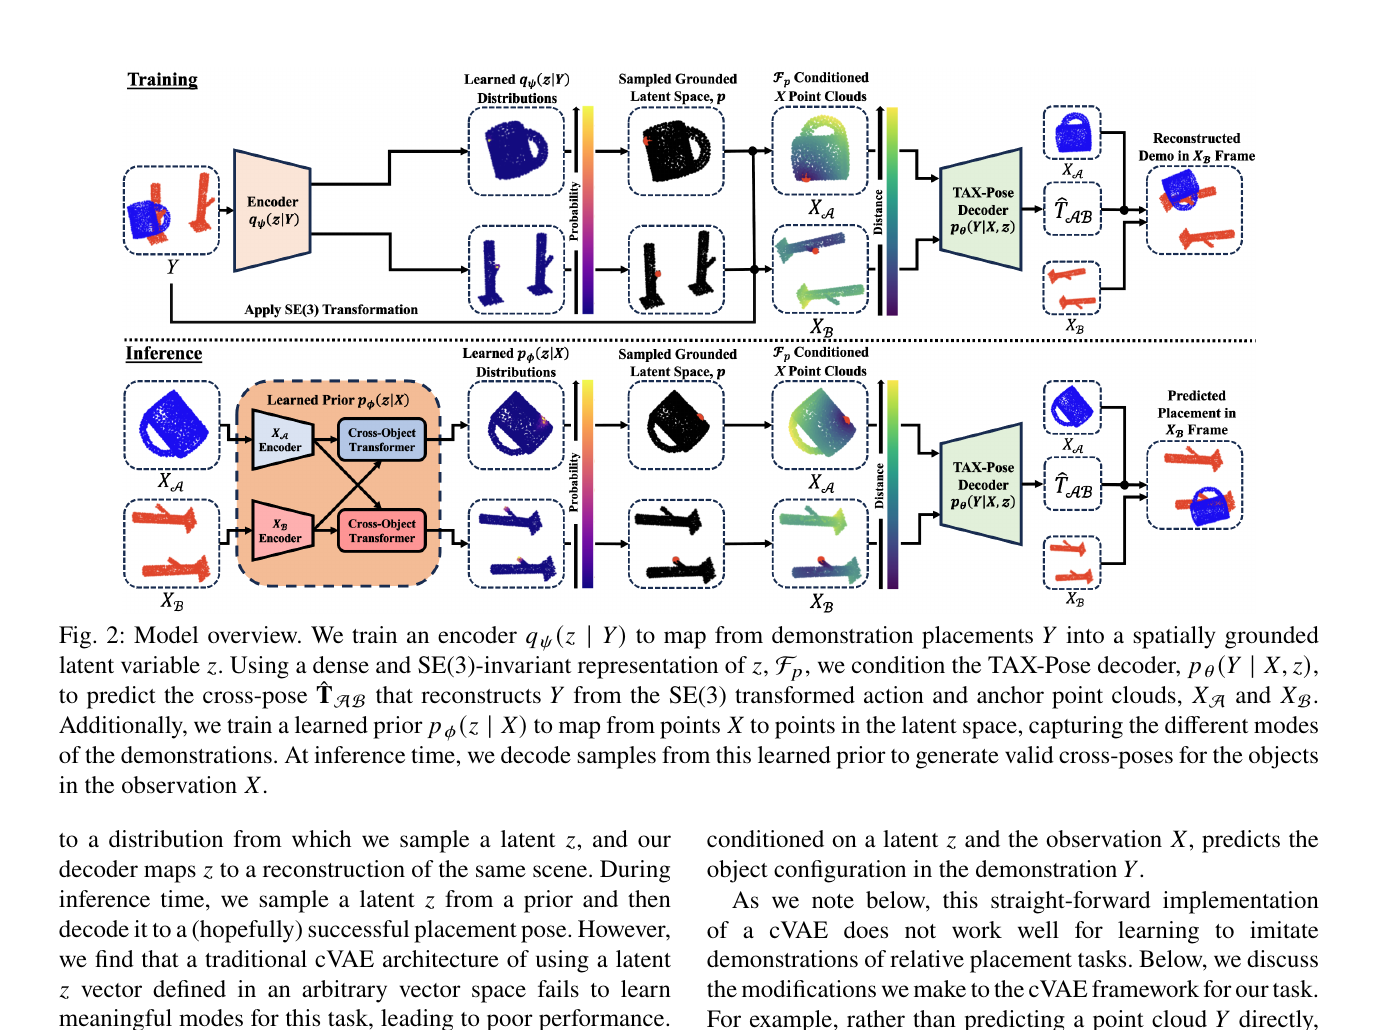 原论文 Figure 2:encoder 从成功 demonstration 提取 spatial latent,prior 从当前 point clouds 预测模式分布,decoder 输出对应 cross-pose。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
4. 方法详解
4.1 为什么普通 cVAE latent 不够
标准 cVAE 把 z 设为 Gaussian continuous vector。对于多个离散 placement modes,这种全局向量缺少“模式位于场景哪里”的归纳偏置,decoder 容易输出平滑的中间解。
TAX-PoseD 将 z 表示成点云上的 categorical distribution:latent 直接选择 / 加权某个空间位置。对 mug-rack,prior 的概率峰可以落在每个 rack peg 附近,因而可解释,也能随 rack 数量和位置变化。
4.2 Encoder、prior 与 decoder
- posterior encoder qψ(z∣X,Y) 同时看当前 scene X 与成功 demonstration placement Y,学习“这次示范使用了哪个空间模式”。
- learned prior pϕ(z∣X) 只看 inference 时可得的 point clouds,预测当前几何下所有可行模式。
- decoder pθ(TAB∣X,z) 基于 TAX-Pose 的 relational point features 输出 cross-pose。
- ELBO 以 reconstruction / pose loss 拟合示范,同时用 KL(qψ∥pϕ) 让 prior 覆盖 demonstration modes。
作者进一步构造旋转不变的 dense feature 来向 decoder 传递 latent 位置,避免直接拼接稀疏 one-hot map。
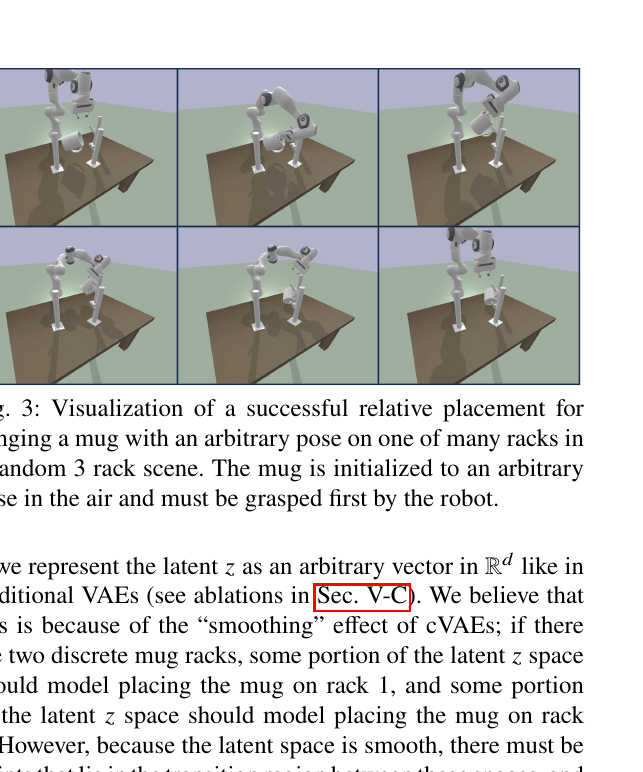 原论文 Figure 3:action object 与 anchor scene 的 cross-pose 定义和成功相对放置示例。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
5. 实验
PyBullet 环境由四个 depth cameras 生成 point clouds。每个任务只给 10 个 demonstrations;测试使用未见 mugs 和随机 initial poses。机器人先预测 gripper–mug cross-pose 完成抓取,再预测 mug–rack cross-pose完成放置。
| 方法 | 1 Rack | 2 Racks | 3 Racks(仅 2-rack 训练) |
|---|
| TAX-Pose | 0.84 | 0.07 | 0.14 |
| TAX-PoseD | 0.82 | 0.57 | 0.59 |
单模态任务没有牺牲明显精度;多模态任务则避免了 TAX-Pose 预测两 racks 中点的模式平均。更有说服力的是 3-rack generalization:point-wise prior 能在 inference 时给未见的第三个 rack 产生新概率峰。
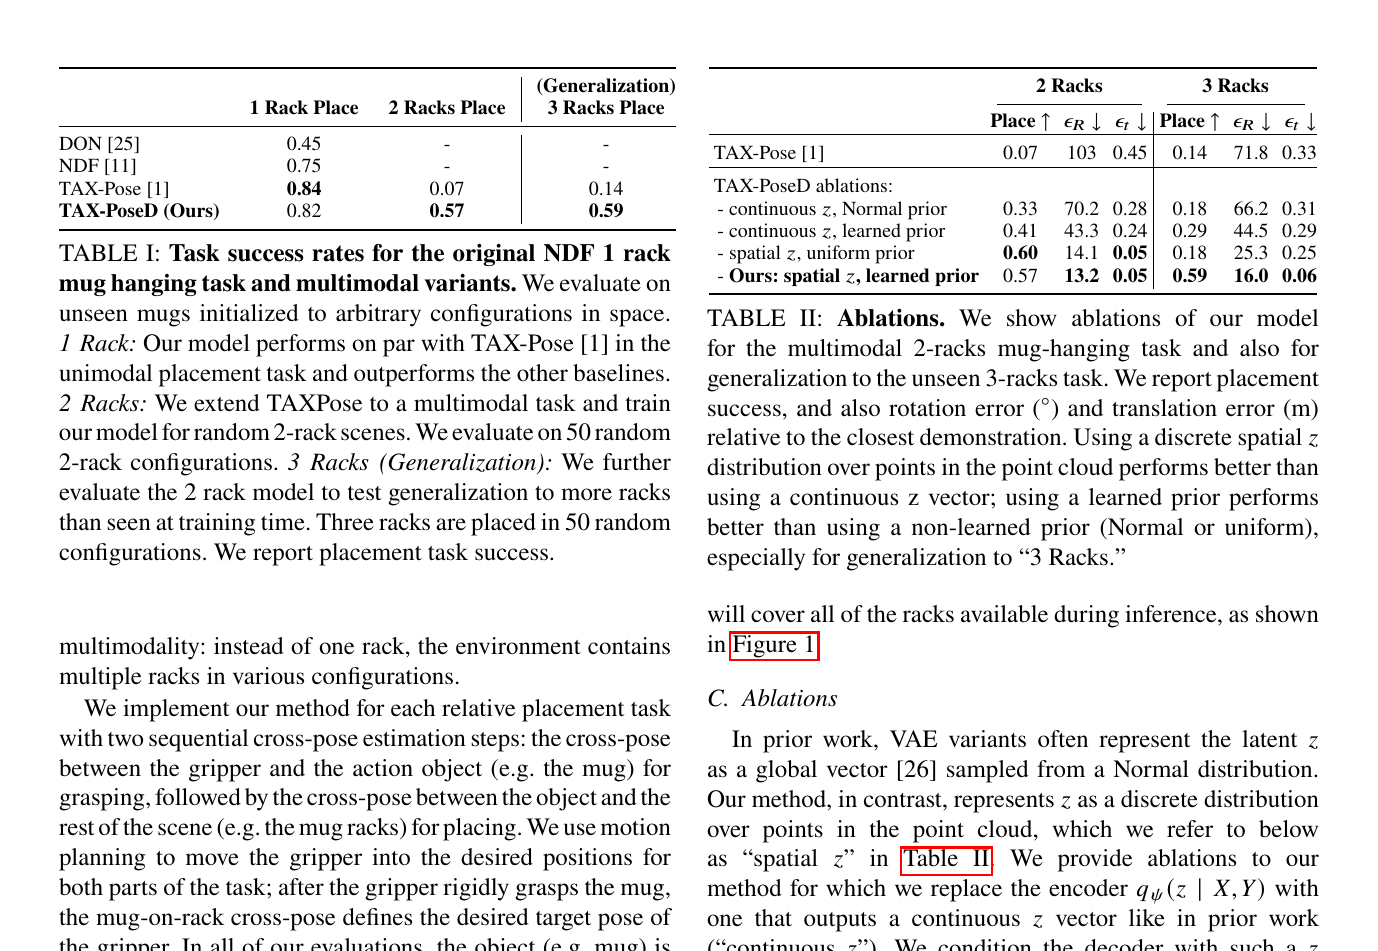 原论文 Table I–II:1/2/3 racks 的 placement success,以及 continuous latent、uniform prior 与 spatial learned prior 的比较。来源:论文 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
消融显示 continuous z 的 2-rack / 3-rack 成功率最高仅 0.41 / 0.29;spatial z+uniform prior 在 2 racks 可达 0.60,却在 3 racks 降到 0.18。完整 learned prior 为 0.57 / 0.59,说明 spatial representation 解决“模式在哪里”,learned prior 解决“哪些点真的可行”。
6. 局限与研究启发
- 主要实验是 mug hanging,任务形态和 physics complexity 较窄。
- 输入已是干净 segmented point clouds,没有把 perception uncertainty 纳入模型。
- success 依赖 grasp、motion planner 与物理稳定性,不是纯 pose metric。
- distribution 的 calibration、mode coverage 与采样效率报告有限。
- 3-rack 泛化仍在同类几何内,尚未证明跨任务组合。
对 6D pose 社区的启发是:对称与多解不应总被折叠成一个 canonical pose。对 manipulation,更合理的是输出 task-conditioned pose distribution,并让 planner 依据可达性、碰撞和不确定性选择其中一个解。
