论文精读笔记:DKPMV: Dense Keypoints Fusion from Multi-View RGB Frames for 6D Pose Estimation of Textureless Objects
1. 核心判断
- 论文:arXiv 2510.10933
- 核心问题:当工业对象缺少纹理、反射严重,RGB 对应不稳定而深度又经常失效时,如何真正利用多视图约束,而不是把若干个不可靠的单视图 pose 再做平均?
- 核心回答:把融合粒度从 pose 降到 CAD 稠密关键点;先让所有视角预测同一组带可见性和对称性规范的 2D keypoint,再用已标定相机把它们重建为 3D 点云,最后与 CAD 对齐。
- 我的判断:DKPMV 的主要贡献不是新的闭式 pose solver,而是“可融合的关键点表征 + 多视图渐进求解”这一整套接口设计。它在 ROBI 上很有效,但不应被概括为无模型或单目 RGB 方法。
2. 一句话定位
DKPMV 是一条 CAD 稠密关键点驱动的多视图 RGB 6D pose 流水线:对称性感知监督解决标签歧义,邻域注意力修正点预测,三阶段几何求解把跨视图对应变成高精度位姿。
2.1 图表导读
| 图表 | 应该关注什么 |
|---|
| Figure 2 | 512 个 CAD 点如何在多个 RGB 视角共享身份,以及三阶段求解的数据流。 |
| Table I–II | Ensenso / RealSense 与 4 / 8 视角必须分开读;ALL 才是整体结果。 |
| Figure 3、Table III–IV | 注意力和 symmetry-aware training 分别修正了什么误差。 |
| Table V | DKPMV 三阶段和通用 Min3P 三阶段的差异,说明收益来自输入点质量与第一阶段几何,而非只靠末端优化。 |
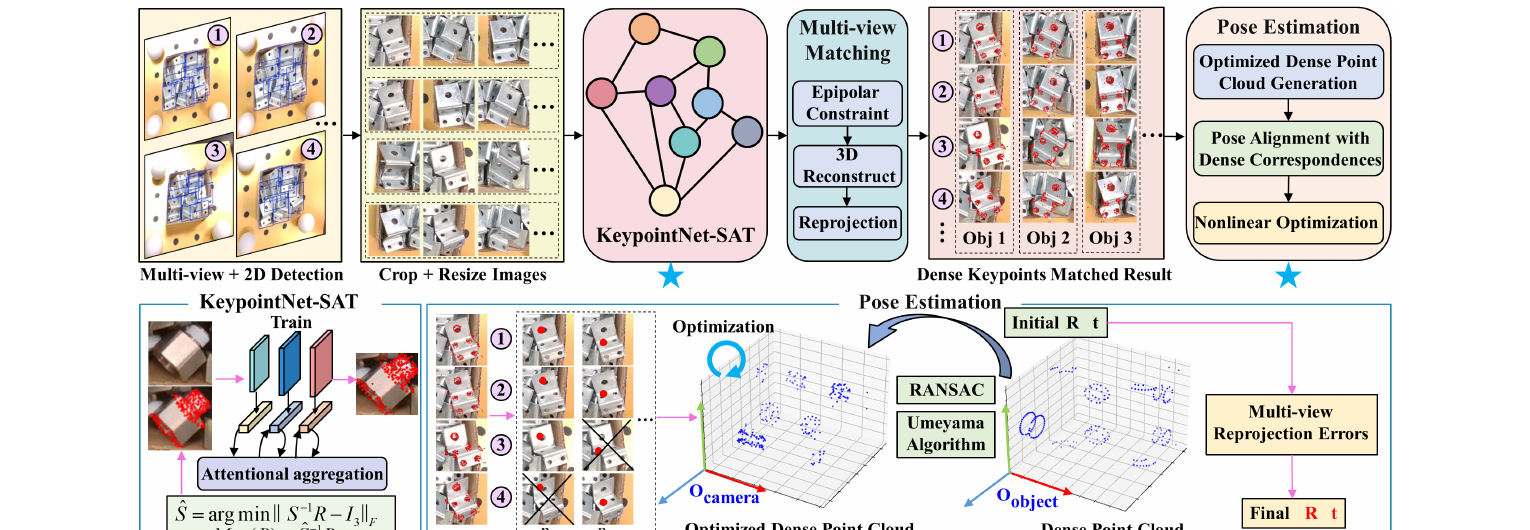 原论文 Figure 2:目标检测后,各视角网络预测共享 CAD 身份的稠密关键点;多视图求解依次执行 3D 点重建、初始对齐和重投影优化。来源:DKPMV 原论文。图片版权归论文作者所有,本站仅作学术解读展示。
3. 问题设定
输入是 V 张同步或近同步 RGB 图像、已知相机内外参,以及测试对象的 CAD 模型。目标是在共同参考相机坐标系中恢复每个对象的旋转 R∈SO(3) 与平移 t∈R3。在线阶段不读深度,但有三项重要先验:
- 对象身份与 CAD 已知:网络预测的不是类别自由关键点,而是 CAD 表面预定义点的图像位置。
- 相机间外参已知:多视图射线能否交汇完全依赖标定质量。
- 每个视角已有检测框:论文使用 YOLOv11,检测失败会在关键点网络之前截断流水线。
因此,“RGB-only”准确含义是测量模态不用深度,不是无 CAD、无标定或单目条件。
4. 为什么稠密关键点比 pose-level fusion 更合适
许多多视图方法先从每个视角独立估计一个 pose,再用全局优化求一致解。问题在于:单视图若因遮挡、反光或对称性落入错误模式,后端看到的只是一个已压缩的 6DoF 答案,难以知道究竟哪些局部证据可靠。DKPMV 保留 512 个关键点及其可见性,相当于把每个视角的局部支持暴露给几何后端:
- 某个点只在少数视角可见时可以单独剔除,不必抛弃整张图的 pose。
- 不同视角对同一 CAD 点形成的射线可直接检查几何一致性。
- 反光造成的局部误差可由 RANSAC 与大量其余点稀释。
- 视角增加时,增加的是约束数量,而不是简单增加待平均的 pose 数量。
代价也很明确:点身份必须跨视角一致,512 个点的预测、存储和配对成本显著高于少量语义关键点。
5. 关键点网络
5.1 CAD 点定义与编码
作者在 CAD 表面用 farthest point sampling 选取 512 个点。网络以 CheckerPose / KeypointNet-SAT 为基础,不直接为每个点回归二维连续坐标,而是预测离散编码、可见性和局部位置。固定 CAD 索引让不同相机中的第 i 个输出都指向同一个表面点,这是后续多视图三角化的基础。
5.2 邻域注意力聚合
对每个目标关键点,网络汇聚其 CAD 邻域中 k=20 个点的特征。这里的注意力不是跨视角 Transformer,而是让单视角关键点预测利用对象表面上的局部几何关系。直观地说,一个无纹理点本身可能没有辨识度,但它与邻近轮廓、孔洞和边缘的相对布局仍提供结构线索。
5.3 对称性感知训练
轴对称或离散对称对象存在多个几何等价 pose。若训练标签只选其中一个 canonical pose,外观完全相同的图像会被要求输出不同 CAD 点身份,网络接收到相互冲突的监督。SAT 根据对象对称群把标签规范到一致等价类,再监督编码和可见性。它的作用不是在评测阶段放宽阈值,而是从源头避免关键点身份随机翻转。
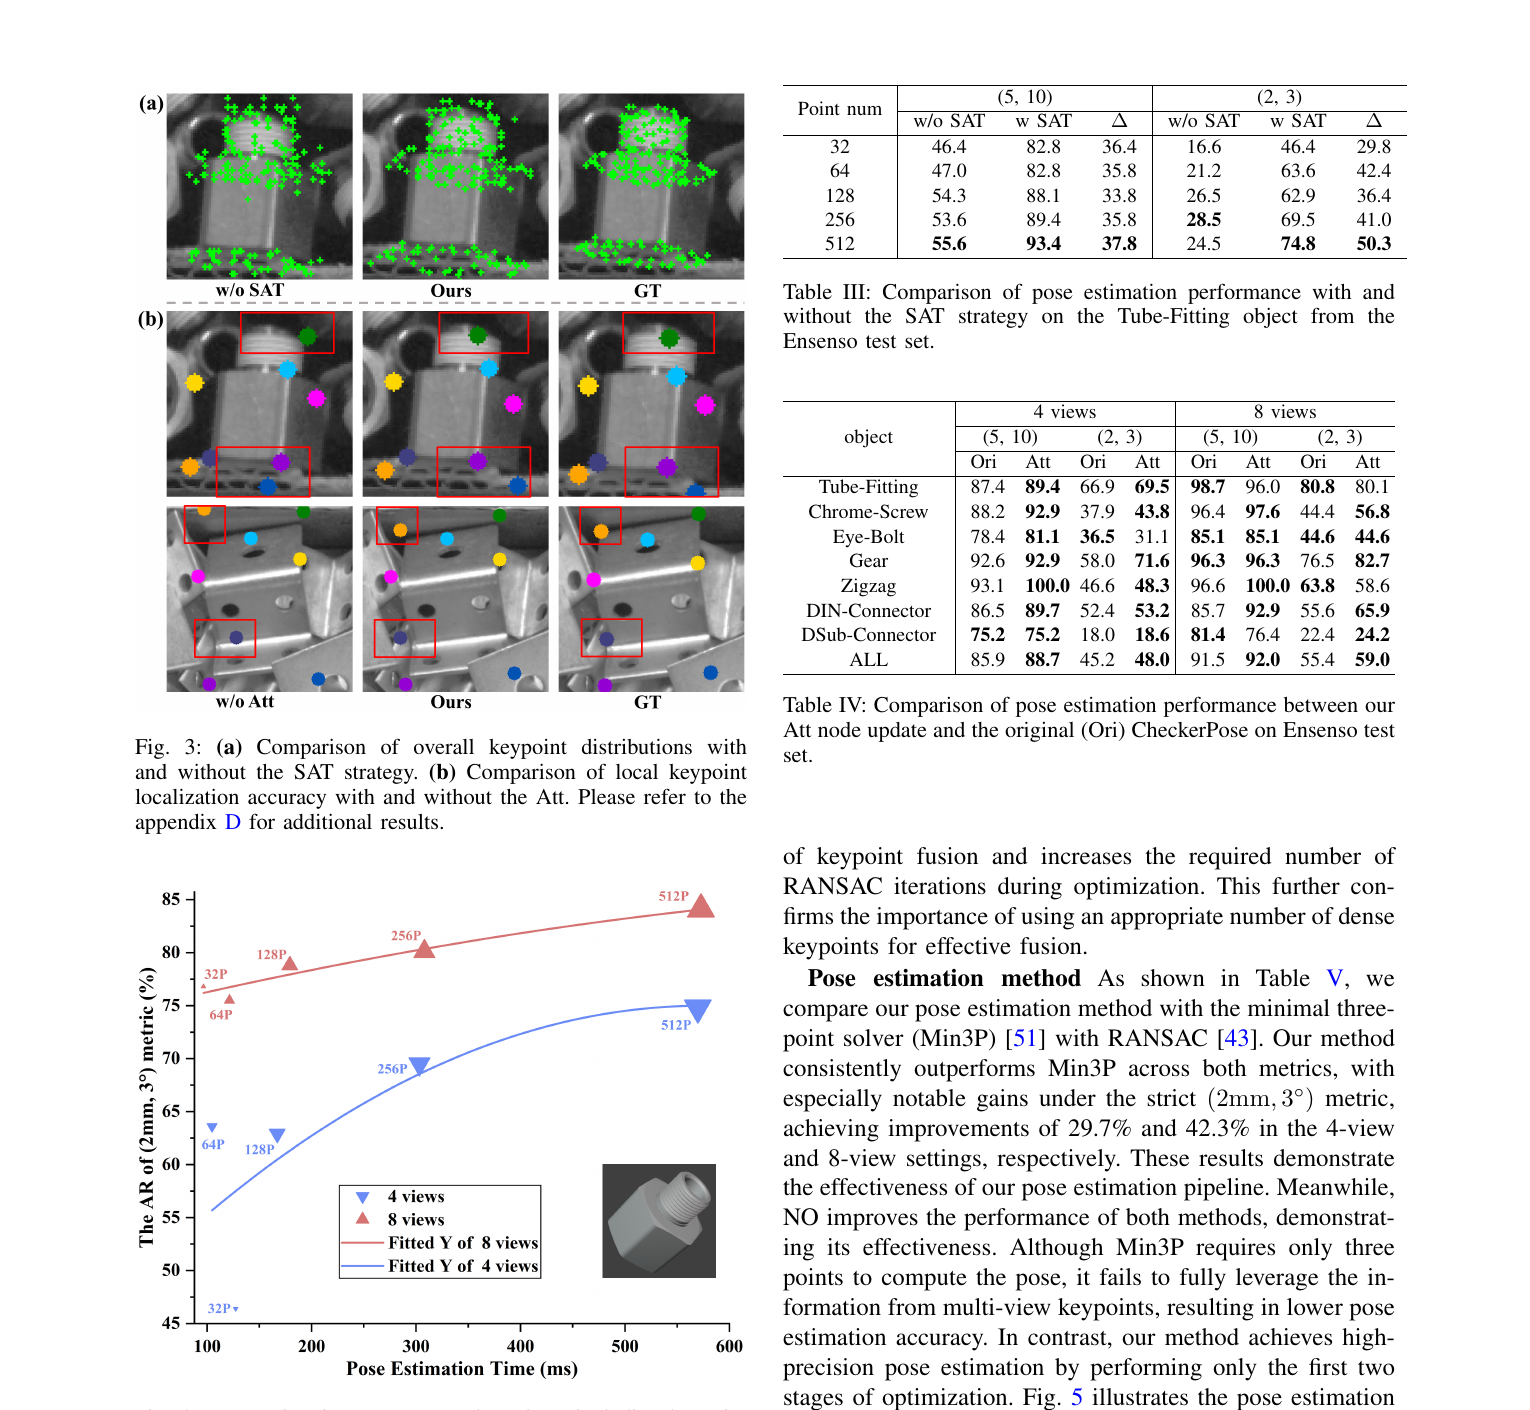 原论文 Figure 3 与 Table III–V:邻域注意力用于聚合 CAD 点结构;SAT 对对称对象的严格阈值提升尤其明显;三阶段消融还对比了 DKPMV 与 Min3P。来源:DKPMV 原论文。图片版权归论文作者所有,本站仅作学术解读展示。
Tube Fitting 的 512 点结果很能说明问题:加入 SAT 后,5 mm 10° recall 从 55.6 跃升到 93.4,2 mm 3° 从 24.5 提升到 74.8。如此大的幅度表明原始误差并非一般回归噪声,而是对称等价点的系统性错配。注意力模块带来的提升相对温和,但在严格阈值下仍有价值。
6. 三阶段渐进求解
阶段一:多视图 3D 关键点重建
每个 CAD 点在多个已知相机中对应若干条反投影射线。作者从这些射线恢复该点在参考坐标系中的 3D 位置,并结合 RANSAC / SVD 处理错误预测。这里已经使用了跨视图几何,因此不是“先单视图 PnP,再融合 pose”。
阶段二:CAD 与重建点云对齐
重建点云与 CAD 点拥有同一索引,可用 Umeyama / SVD 求刚体对齐,得到 R,t 初值。由于对象尺度已由 CAD 固定,实际关注刚体变换;论文中的对齐形式借用了 Umeyama 的稳定闭式解。
阶段三:非线性重投影优化
最后以所有可用视角中的 2D 关键点为观测,最小化预测 CAD 点经候选 pose 和相机投影后的重投影误差。这个阶段在图像空间重新利用原始观测,可修正三角化和闭式对齐中的小偏差。
Table V 的重要信息是:对 DKPMV,前两阶段已经给出很强解,末端非线性优化只带来较小增益;而同样三阶段接在 Min3P 上时,严格 2 mm 3° 结果仍显著更差。4 / 8 视角下,DKPMV 相比 Min3P 的严格指标分别高约 29.7 / 42.3 个百分点。这说明性能不能简单归因于“多做了一次 nonlinear refinement”,关键仍是稠密、可融合的点和第一阶段的多视图重建。
7. 主结果怎么读
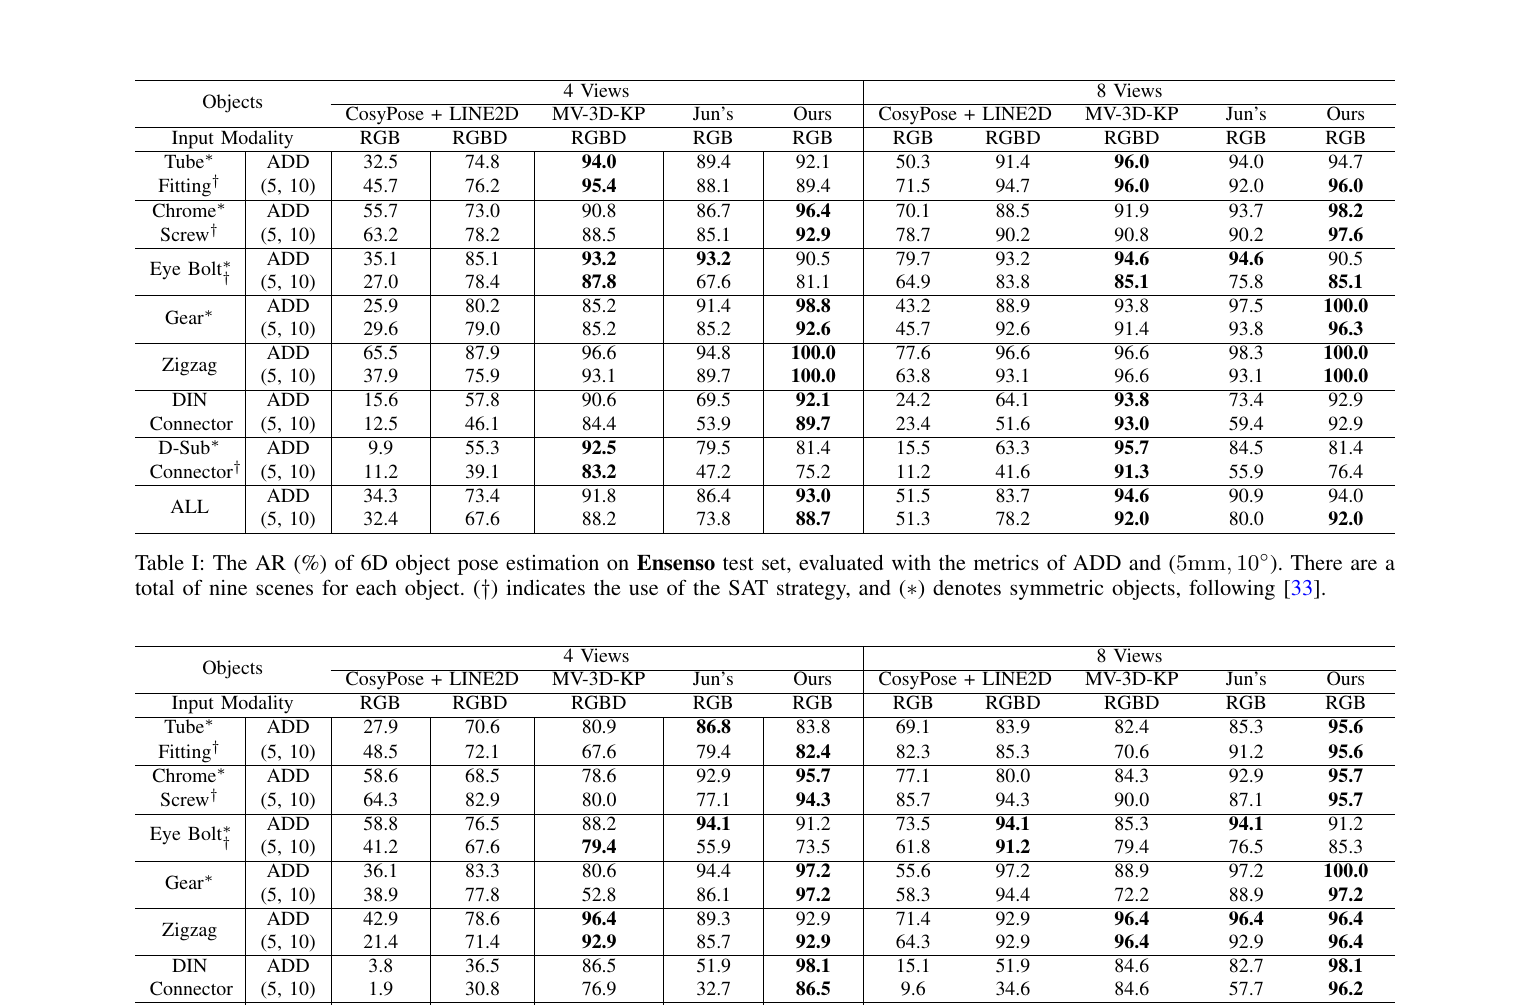 原论文 Table I–II:分别报告 Ensenso 与 RealSense、4 / 8 视角下各对象和 ALL 的 ADD AR、5 mm 10°、2 mm 3°。来源:DKPMV 原论文。图片版权归论文作者所有,本站仅作学术解读展示。
ROBI 同时包含高质量 Ensenso 与更常见的 RealSense。整体结果如下:
| 传感器 | 视角 | ADD AR | 5 mm 10° |
|---|
| Ensenso | 4 | 93.0 | 88.7 |
| Ensenso | 8 | 94.0 | 92.0 |
| RealSense | 4 | 92.5 | 87.2 |
| RealSense | 8 | 95.5 | 93.6 |
视角从 4 增至 8 通常提升性能,RealSense 的提升尤其明显,符合“低质量单视图可由更多几何冗余补偿”的预期。但对象级结果并不均匀,D-Sub 等对象仍困难;因此 ALL 数字不代表对所有反光几何都稳定。
作者还比较了 RGB-D 方法。DKPMV 在多数设置超过这些基线,支持“坏深度不一定比无深度更好”的主张。不过这里不能推广成 RGB 总是胜过 RGB-D:比较限于 ROBI、既定相机阵列和特定基线;若深度质量高、相机外参不准或只有单视角,结论可能相反。
8. 作者声称与证据强度
| 作者声称 | 证据与我的判断 |
|---|
| 稠密关键点级多视图融合优于 pose-level fusion | ROBI 主表和 Min3P 对照支持,但缺少在更多公开工业数据集上的跨域验证。 |
| SAT 解决对称物体关键点歧义 | Tube Fitting 严格阈值提升巨大,证据直接;仍需检查离散 / 连续对称的覆盖范围。 |
| 仅 RGB 可超过 RGB-D | 在 ROBI 多数比较中成立;它依赖多视角、CAD 与标定,不应写成普遍传感器结论。 |
| 三阶段求解充分利用多视图几何 | 方法推导与消融一致,且末端优化不是唯一性能来源。 |
9. 复现清单
- 明确 512 点 FPS 的随机种子、CAD 单位和坐标原点;点索引变化会使已训练网络失效。
- 复现 SAT 时必须使用与 BOP / ROBI 相同的对象对称定义,避免训练等价类与评测等价类不一致。
- 相机外参误差会被解释为关键点误差;应先用重投影检查标定。
- 检查每点在多少视角可见、RANSAC 最小样本与阈值,而不仅看最终 pose。
- 报告端到端延迟时应包含 YOLOv11、所有视角关键点网络、跨视图融合和非线性优化。
- 项目页给出的仓库链接在本站整理时尚未形成可核验的完整复现包,因此元数据暂不标“开源完成”。
10. 局限与可延伸方向
- 强资产依赖:CAD、对象身份、相机标定都已知;它解决的是“深度不可用”,不是开放世界 onboarding。
- 系统复杂度:多相机布置与同步可能比增加深度传感器更昂贵,需要按应用现场权衡。
- 遮挡相关性:若多个相机从相近方向观察,遮挡并非独立,增加视角数量也不一定增加有效基线。
- 连续对称与重复结构:统一对称标签能消除监督冲突,但不能凭空创造不可观测的绕轴角。
- 更自然的下一步:把每个关键点的不确定性带入三角化与对齐,而不是只用可见 / 不可见二值;同时联合优化轻微外参漂移,会更适合真实工业部署。
总体而言,DKPMV 最值得借鉴的是接口思想:在多视图系统里,尽量保留可检验的局部对应与置信度,让几何后端看到信息,而不是过早把每张图压缩成一个 pose。
