论文精读笔记:DVMNet
1. 核心判断
DVMNet 质疑 single-reference relative pose 中常见的“离散 hypothesis + 逐个评分”范式。RelPose / 3DAHV 等方法用成千上万个 sampled rotations 逼近连续 S O ( 3 ) SO(3) S O ( 3 )
DVMNet 改用:
把 reference / query 2D features 提升到共享 3D voxel grid;
建立 soft voxel-to-voxel correspondence;
结合 2D mask 与 learned 3D objectness 给对应加权;
用 weighted Procrustes / SVD 一次求相对 rotation。
它在 CO3D 未见 10 类达到 19.95° mean angular error,优于 3DAHV 28.44°;A100 上每图对约 23 ms。最有价值之处是把 network prediction 与 closed-form geometry 结合,而不是“3D voxel 看起来像几何”本身。
2. 任务边界
输入:
同一对象的 reference RGB crop I r I_r I r
query RGB crop I q I_q I q
论文实验使用 ground-truth bounding boxes。
输出:
Δ R = R q R r ⊤ . \Delta R=R_qR_r^\top. Δ R = R q R r ⊤ . 若 reference absolute rotation R r R_r R r R q = Δ R R r R_q=\Delta R R_r R q = Δ R R r
不需要:
CAD / mesh;
depth;
test-object training;
pose hypothesis enumeration。
但 object localization 和两幅图中的 instance identity 被视为已解决。
3. Cross-view 2D→3D autoencoder
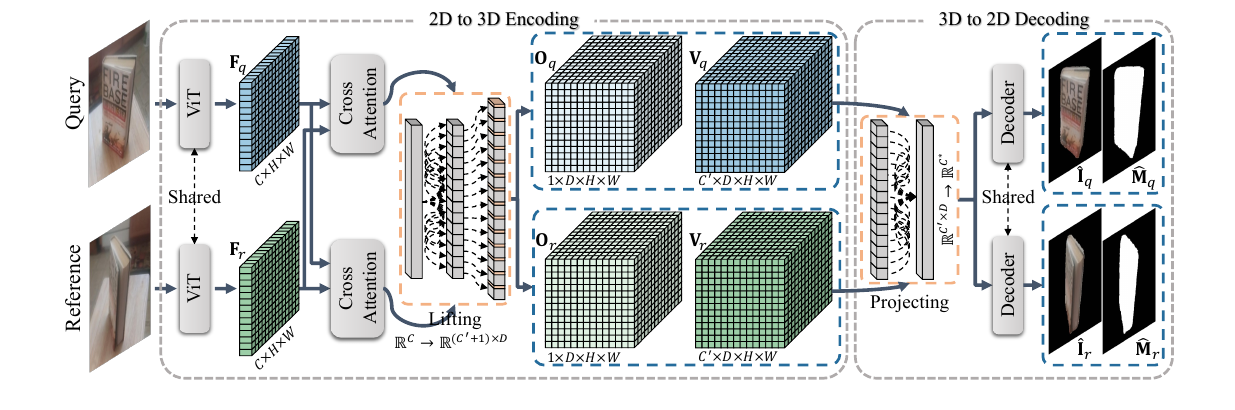
原论文 Figure 2。共享 ViT 后,query 与 reference features 通过 cross-attention 交换视角信息,再 reshape 为 voxel volumes 与 objectness maps;decoder 重建去背景图和 masks。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
共享 ViT 提取:
F q , F r ∈ R C × H × W . F_q,F_r\in\mathbb R^{C\times H\times W}. F q , F r ∈ R C × H × W . 三个 cross-attention modules 让 query feature 以 reference 为 key / value,反方向同理。这样每个 view 的 representation 在 lifting 前已编码跨视图关系。
网络将 channel 维重排为 depth:
R C × H × W → R ( C ′ + 1 ) × D × H × W . \mathbb R^{C\times H\times W}
\rightarrow
\mathbb R^{(C'+1)\times D\times H\times W}. R C × H × W → R ( C ′ + 1 ) × D × H × W . 得到:
voxel feature V q , V r ∈ R C ′ × D × H × W V_q,V_r\in\mathbb R^{C'\times D\times H\times W} V q , V r ∈ R C ′ × D × H × W
objectness volume O q , O r ∈ R 1 × D × H × W O_q,O_r\in\mathbb R^{1\times D\times H\times W} O q , O r ∈ R 1 × D × H × W
这里没有 camera intrinsics、depth 或 multi-view triangulation,所以 voxel coordinates 不是度量相机 3D,而是由训练监督塑造的 object-centric latent 3D grid。
decoder 沿 depth 聚合 voxel,经过三个 self-attention modules,重建 foreground image I ^ \hat I I ^ M ^ \hat M M ^
L ae = L mse ( I ^ q , I q g t ) + L mse ( I ^ r , I r g t ) + L bce ( M ^ q , M q g t ) + L bce ( M ^ r , M r g t ) . \mathcal L_{\text{ae}}=
\mathcal L_{\text{mse}}(\hat I_q,I_q^{gt})
+\mathcal L_{\text{mse}}(\hat I_r,I_r^{gt})
+\mathcal L_{\text{bce}}(\hat M_q,M_q^{gt})
+\mathcal L_{\text{bce}}(\hat M_r,M_r^{gt}). L ae = L mse ( I ^ q , I q g t ) + L mse ( I ^ r , I r g t ) + L bce ( M ^ q , M q g t ) + L bce ( M ^ r , M r g t ) . autoencoder supervision 迫使 voxel 保留 object pattern,并减轻背景进入 matching。
4. Deep voxel matching
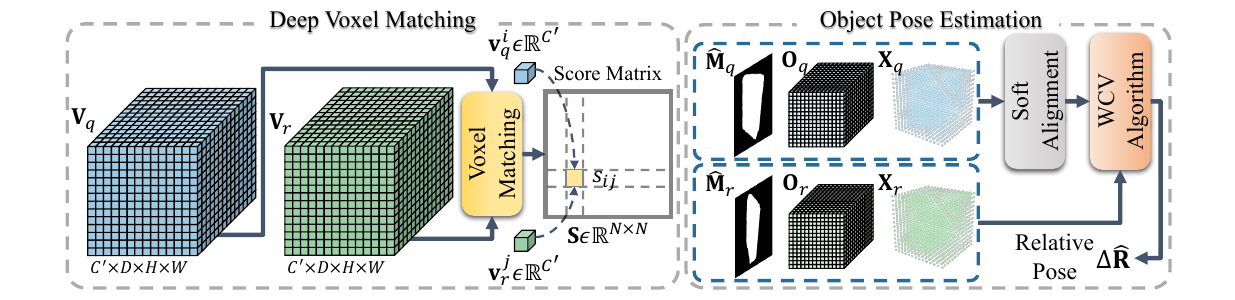
原论文 Figure 3:query / reference voxels 以 cosine similarity 构成 score matrix,soft assignment 将 query coordinates 对齐到 reference;2D masks、3D objectness 与 voxel coordinates 共同进入 WCV 求相对 rotation。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
将有效 voxels 展平为 v q i , v r j ∈ R C ′ v_q^i,v_r^j\in\mathbb R^{C'} v q i , v r j ∈ R C ′
s i j = ( v q i ) ⊤ v r j ∥ v q i ∥ 2 ∥ v r j ∥ 2 . s_{ij}=
\frac{(v_q^i)^\top v_r^j}
{\|v_q^i\|_2\|v_r^j\|_2}. s ij = ∥ v q i ∥ 2 ∥ v r j ∥ 2 ( v q i ) ⊤ v r j . score matrix 经温度 τ \tau τ
X q ′ = p ( S / τ ) X q . X'_q=p(S/\tau)X_q. X q ′ = p ( S / τ ) X q . 这相当于为每个 reference voxel 计算 query coordinates 的加权期望,不需 hard nearest neighbor,也可端到端反传。
若对应完全可靠,相对 rotation 可由 covariance
H = ∑ i x r i ( x q i ) ⊤ = U Σ V ⊤ H=\sum_i x_r^i(x_q^i)^\top=U\Sigma V^\top H = i ∑ x r i ( x q i ) ⊤ = U Σ V ⊤ 的闭式解 Δ R ^ = V U ⊤ \Delta \hat R=VU^\top Δ R ^ = V U ⊤
5. Weighted Closest Voxel
WCV 权重来自两种 complementary evidence:
将预测 2D mask 沿 depth 复制成 pseudo-3D mask,过滤明显背景;
learned 3D objectness 进一步判断 voxel 是否真正描述对象。
最终 weighted covariance:
H = ∑ i ω i x r i ( x q i ) ⊤ . H=\sum_i \omega_i x_r^i(x_q^i)^\top. H = i ∑ ω i x r i ( x q i ) ⊤ . 作者用 soft assignment、mask 与 objectness 的组合构造 ω i ∈ ( 0 , 1 ) \omega_i\in(0,1) ω i ∈ ( 0 , 1 )
L pose = ∥ q ( R ^ ) − q ( R g t ) ∥ , L = L ae + L pose . \mathcal L_{\text{pose}}=\|q(\hat R)-q(R_{gt})\|,
\qquad
\mathcal L=\mathcal L_{\text{ae}}+\mathcal L_{\text{pose}}. L pose = ∥ q ( R ^ ) − q ( R g t ) ∥ , L = L ae + L pose . 因此从 2D lifting、voxel matching、weighting 到 closed-form solver 均可端到端优化。
6. CO3D:类别不重叠实验
CO3D 含 18,619 video sequences、51 categories。按 RelPose 设置:
41 类训练;
10 类测试;
测试类别训练时全部未见;
指标为 geodesic angular error:
e = arccos ( tr ( R ^ ⊤ R g t ) − 1 2 ) . e=\arccos\left(\frac{\operatorname{tr}(\hat R^\top R_{gt})-1}{2}\right). e = arccos ( 2 tr ( R ^ ⊤ R g t ) − 1 ) .
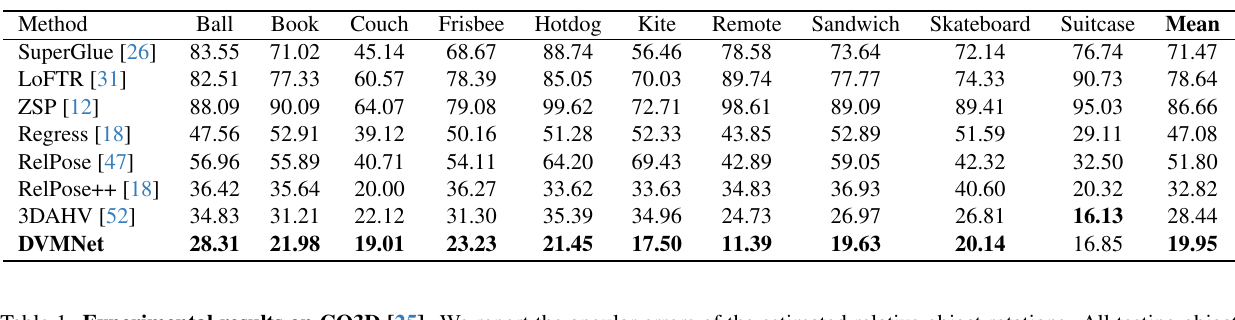
原论文 Table 1:DVMNet 在 ball、book、couch、frisbee、hotdog、kite、remote、sandwich、skateboard、suitcase 的 mean error 为 19.95°。来源:CVPR 2024 正式论文 ;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
方法 Mean angular error SuperGlue 71.47° LoFTR 78.64° ZSP 86.66° direct regression 47.08° RelPose 51.80° RelPose++ 32.82° 3DAHV 28.44° DVMNet 19.95°
DVMNet 对最近的 3DAHV 改善 8.49°。image matching 极差说明同一对象的大 viewpoint gap 不是普通 2D feature matching 能稳定解决的。
per-category 不是全胜:suitcase 上 3DAHV 16.13°,DVMNet 16.85°;但其余 9 类 DVMNet 最优,mean 改善不是由单个类别偶然造成。
7. GROP:真实与大规模合成对象
GROP 包含:
Objaverse:128 个测试对象的 synthetic multi-view images;
LINEMOD:5 个真实对象;
含测试对象的图像从训练中排除。
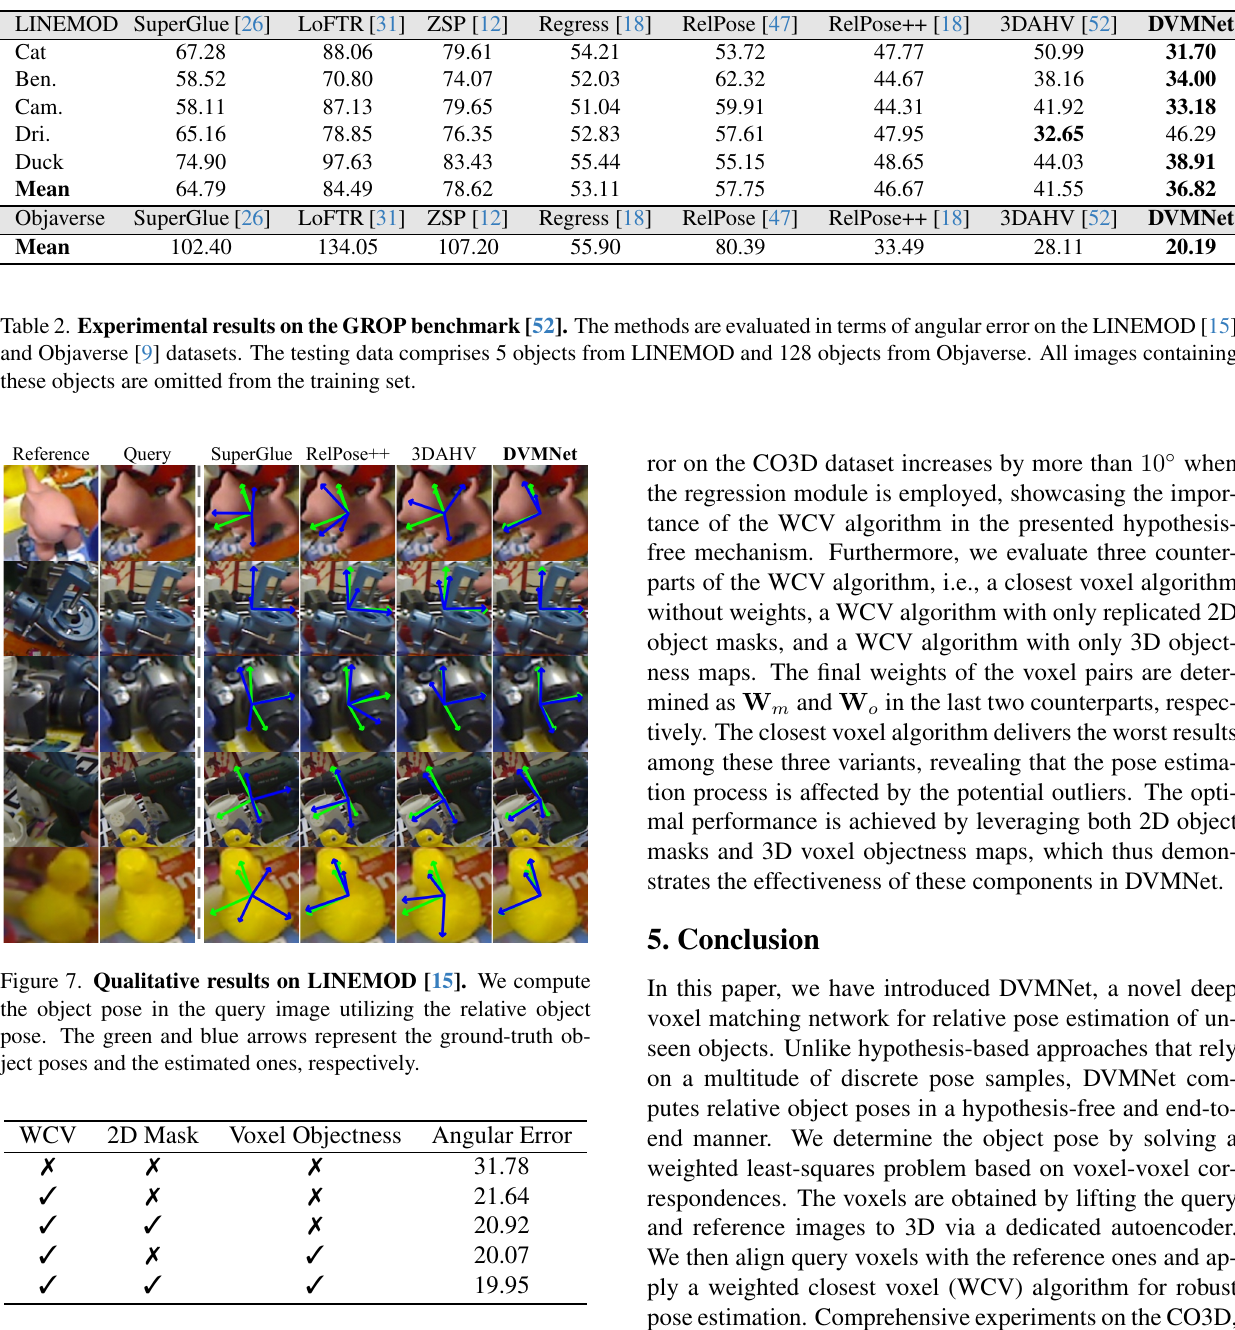
原论文 Table 2、Figure 7 与 Table 3:上方是 GROP angular error,中左为 LINEMOD 定性结果,下方是 WCV / mask / objectness 消融。来源:CVPR 2024 正式论文 ;图表版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
数据 SuperGlue LoFTR RelPose++ 3DAHV DVMNet Objaverse mean 102.40° 134.05° 33.49° 28.11° 20.19° LINEMOD mean 64.79° 84.49° 46.67° 41.55° 36.82°
LINEMOD 的 domain shift 更强,且 textureless household objects 对 RGB lifting 不利。DVMNet mean 最佳,但 driller 为 46.29°,明显差于 3DAHV 32.65°;方法不是对每种局部结构都稳健。
8. WCV 消融与效率
CO3D mean:
WCV 2D mask voxel objectness Error 无 无 无 31.78° direct regression 替代 WCV 无 无 21.64° unweighted closest voxel 有 无 20.92° WCV 无 有 20.07° WCV 有 有 19.95°
解读:
完全去掉 geometry solver,误差 +11.83°;
简单 direct regression 已达 21.64°,说明 lifted features 本身很强;
correspondence solver 再改善 1.69°;
objectness 的贡献略大于复制 2D mask;
mask + objectness 组合只比 objectness 单独好 0.12°,最终增益小但方向一致。
效率:
DVMNet:23 ms / pair;
RelPose++:29 ms;
3DAHV:35 ms;
评测硬件:A100。
hypothesis-based 方法的 MACs 随 sample count 从 1k 到 500k 增长;DVMNet 单次匹配的位置固定,取得更好的 error / MAC trade-off。但 23 ms 不含 bbox detector,也不是完整 absolute pose pipeline。
9. “3D voxel”应如何理解
DVMNet 的 voxel grid 有三维坐标,并允许用 rotation alignment 求解,但它不是从 camera calibration 得到的 metric scene geometry:
没有 intrinsics;
没有 depth;
只有两张 RGB;
channel reshape 决定初始 depth axis;
3D consistency 来自 cross-view / reconstruction / pose loss。
因此更准确的描述是 learned object-centric equivariant-like 3D latent grid 。它能支持 relative rotation,却不能自然给 metric translation。这也解释了论文虽然使用 weighted least squares 和 6D rotation representation,实验仍只报告角误差。
10. 与相邻路线的关系
对 NOPE:NOPE 枚举 342 viewpoints 并输出多峰分布;DVMNet 无 hypothesis、闭式单解、更快,但不显式表达 symmetry uncertainty。
对 image matching:SuperGlue / LoFTR 在大 viewpoint gap 下缺少 object-centric 3D prior,错误率极高。
对 RelPose / 3DAHV:这些方法直接对 rotation hypotheses 评分;DVMNet 改在 voxel correspondence 上解决。
对 Oryon:Oryon 用 RGB-D + text + robust 3D registration,可估 Δ R , Δ t \Delta R,\Delta t Δ R , Δ t
11. 局限与复现检查
只输出 rotation,不是完整 6DoF;
reported protocol 使用 GT bbox;
同一对象在 reference / query 中的 identity 已知;
对称对象被迫输出单个 rotation,缺少 calibrated multi-modal uncertainty;
latent voxel 不具 metric scale,无法直接扩展 translation;
CO3D / GROP 数据划分必须严格排除测试类别或对象;
温度 τ = 0.1 \tau=0.1 τ = 0.1
训练 batch 64、AdamW、learning rate 10 − 5 10^{-5} 1 0 − 5
rotation 6D representation 需在 loss 前正确正交化;
SVD 需处理 det ( R ) < 0 \det(R)<0 det ( R ) < 0
runtime 比较应注明不含 detector。
12. 最终评价
DVMNet 最有说服力的结果不是“用了 voxel”,而是 把 hypothesis space 的计算转成 correspondence space 的计算,并用可微闭式 solver 对网络施加几何结构。 CO3D 相对 3DAHV 的 -8.49°、WCV 相对无 solver 的 -11.83°,以及 23 ms 的 pair latency 都支持这条思路。
它仍然是受控的 relative rotation module:GT crop、无 translation、无 symmetry distribution。对完整机器人 6D pose,还需要 detection、reference absolute pose 与平移估计。不过在 CAD-free、single-reference、类别外泛化这条支线上,DVMNet 是结构清楚且计算高效的代表方法。