论文精读笔记:DynamicPose
1. 核心判断
DynamicPose 不是重新设计一个从视频直接回归 pose 的时序网络,而是修补 FoundationPose 式 tracking 在快速运动下的三个初始化断点:
上一帧 pose 投影出的 ROI 会被相机自运动 推离目标;
即使补偿相机,对象自身大平移 仍会让 ROI 漂移;
ROI 正确也不够,大帧间旋转 可能超出局部 refiner 的收敛域。
作者分别用 VIO、深度辅助 2D tracker、VIO-guided Kalman 多候选解决这三件事,再复用预训练 FoundationPose refiner 做候选更新与筛选。真正有价值的是把机器人已有的 RGB-D / IMU / VIO 与 foundation pose model 组织成闭环,而不是单个模块的新颖度。
2. 任务边界与先验
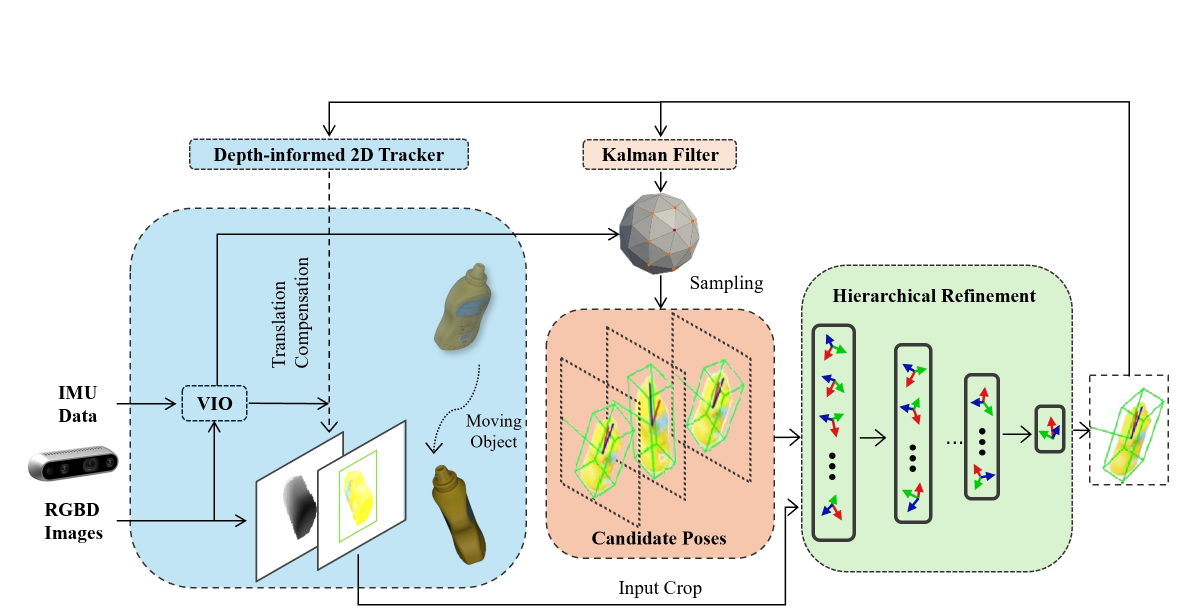
原论文 Figure 2。蓝色部分补偿平移与 ROI,橙色部分生成旋转候选,绿色部分逐层细化;最终 pose 同时反馈给 2D tracker 与 Kalman filter。来源:作者公开稿 ;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
问题属于 CAD model-based、instance-level、unseen-object tracking 。给定:
目标对象的准确 CAD 与对象身份;
连续、标定且时间同步的 RGB-D;
机载 IMU,以及可从视觉惯性里程计得到的相机跨帧运动;
相机内参;
首帧对象 mask / 初始 pose。
“unseen / retraining-free”只表示 FoundationPose 的预训练 refiner 和 scorer 不必针对每个新 CAD 再训练。它不表示 category-level、model-free 或从任意视频自动发现对象。论文问题定义直接要求 initial pose;实现中可用 SAM2 mask、median depth 和 FoundationPose 的全局候选搜索获得首帧 pose。
3. 为什么上一帧 pose 在高速运动下会失效
FoundationPose tracking 通常把上一帧 pose 当作当前帧 coarse pose,投影 CAD 得到 ROI,再由局部 refiner 输出 Δ t , Δ R \Delta t,\Delta R Δ t , Δ R
当前目标仍在上一帧投影附近;
当前旋转仍在 refiner 可纠正的局部范围内。
相机或物体突然运动时,第一条先破坏 ROI,refiner 看到的 crop 不再含足够目标信息;即使 ROI 尚可,大旋转也会使 rendered object 与 observation 差异过大。错误 pose 又会产生下一帧更差的 ROI,形成级联漂移。DynamicPose 的闭环就是为了阻断这条链。
4. 首帧初始化与 FoundationPose refiner
首帧给定 SAM2 对象 mask:
以 mask 内 median depth 初始化平移并裁剪 RGB-D;
在以 CAD 为中心的正二十面体上均匀采 N s N_s N s
每个 viewpoint 再采 N i N_i N i N s N i N_sN_i N s N i
FoundationPose refiner 迭代细化;
scorer 选出最符合当前图像的候选。
跟踪阶段只复用 refiner:它将 coarse pose 下的 CAD render 与当前 RGB-D crop 送入共享 encoder、残差卷积和 transformer,输出平移与旋转更新。DynamicPose 的核心是让送进 refiner 的 translation、ROI 与 rotation candidates 足够接近真值。
5. 平移与 ROI 补偿
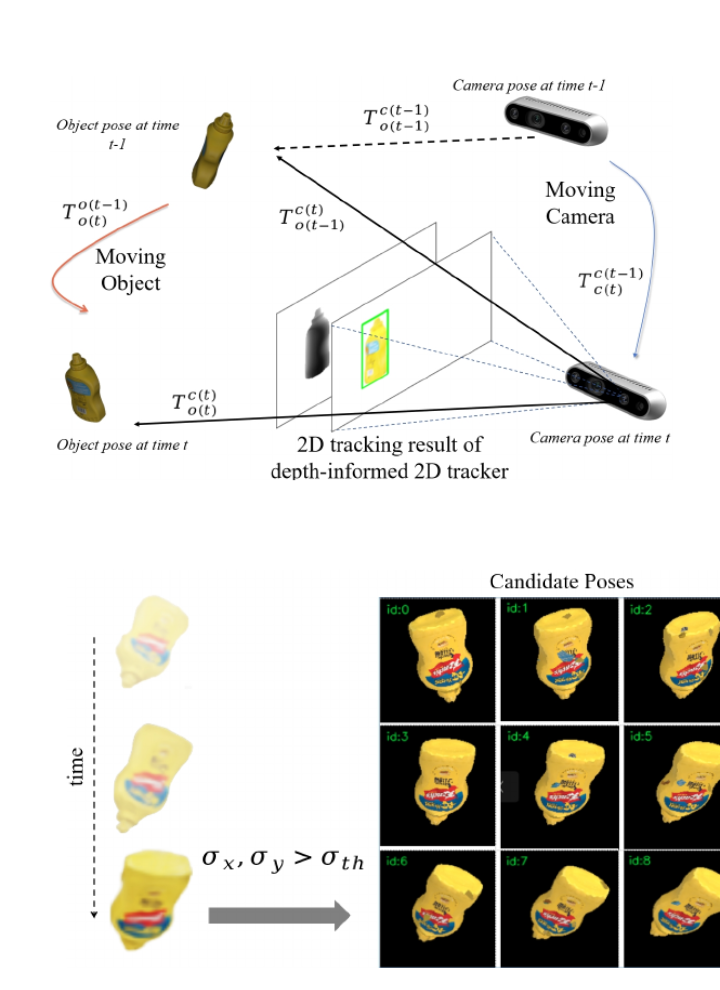
原论文 Figure 4–5 的组合裁切。上:VIO 先补偿相机运动,2D bbox 中心与 median depth 再处理对象自身平移;下:Kalman 方差高的旋转轴采三个候选,方差低的轴只保留均值。来源:作者公开稿 ;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
5.1 相机自运动补偿
设上一帧对象相对上一帧相机的 pose 为 T o ( t − 1 ) c ( t − 1 ) T^{c(t-1)}_{o(t-1)} T o ( t − 1 ) c ( t − 1 ) T c ( t − 1 ) c ( t ) T^{c(t)}_{c(t-1)} T c ( t − 1 ) c ( t )
这一步处理的是相机坐标系本身变化,不是预测对象的独立运动。若对象也显著平移,仅靠 VIO 显然会留下残差。
5.2 深度辅助 2D tracker
2D tracker 从上一帧位置得到当前 RGB bbox,取中心 ( u , v ) (u,v) ( u , v ) z z z
t o c ( t ) = K − 1 [ u , v , 1 ] ⊤ z \mathbf t_o^{c(t)}
=
\mathbf K^{-1}[u,v,1]^\top z t o c ( t ) = K − 1 [ u , v , 1 ] ⊤ z 反投影成当前三维平移假设。它把 2D 外观跟踪对大位移的容忍度与 depth 的度量尺度结合起来。论文正文把具体 tracker 视为可替换模块;公开仓库当前集成 MixFormerV2,并另外集成 Grounding DINO 等前端。
这不是严格的三维目标运动估计:bbox 中心未必对应物体坐标原点,median depth 也可能落在前表面、遮挡物或错误区域。它的角色是把 coarse translation 拉回 refiner 的收敛域。
6. 世界坐标锚定与 Kalman 旋转预测
直接在移动相机坐标系估计对象角速度会混入 camera ego-rotation。作者用 VIO 的世界—相机旋转把对象旋转锚定到世界坐标:
R o w ( t ) = R c w ( t ) R o c ( t ) ( t ) . \mathbf R_o^w(t)=\mathbf R_c^w(t)\mathbf R_o^{c(t)}(t). R o w ( t ) = R c w ( t ) R o c ( t ) ( t ) . 随后以 Tait–Bryan angles
θ = [ θ roll , θ pitch , θ yaw ] \boldsymbol\theta=[\theta_{\text{roll}},\theta_{\text{pitch}},\theta_{\text{yaw}}] θ = [ θ roll , θ pitch , θ yaw ] 表示旋转,先用常角速度
ω ( t ) = θ ( t ) − θ ( t − 1 ) Δ t , θ ( t + 1 ) = θ ( t ) + ω ( t ) Δ t \boldsymbol\omega(t)
=
\frac{\boldsymbol\theta(t)-\boldsymbol\theta(t-1)}{\Delta t},
\qquad
\boldsymbol\theta(t+1)
=
\boldsymbol\theta(t)+\boldsymbol\omega(t)\Delta t ω ( t ) = Δ t θ ( t ) − θ ( t − 1 ) , θ ( t + 1 ) = θ ( t ) + ω ( t ) Δ t 做预测。Kalman process noise 设为
Q = ∥ ω ˙ ( t ) ∥ I , \mathbf Q=\|\dot{\boldsymbol\omega}(t)\|\mathbf I, Q = ∥ ω ˙ ( t ) ∥ I , 即角加速度越大,预测 covariance 越高。refiner 最终输出的旋转作为 observation 更新 filter,measurement covariance 在实验中固定为 0.05。
这个建模很轻量,但要注意 Tait–Bryan angle 不是全局无奇异的 S O ( 3 ) SO(3) S O ( 3 )
7. 方差感知多候选
对每个轴 i ∈ { roll,pitch,yaw } i\in\{\text{roll,pitch,yaw}\} i ∈ { roll,pitch,yaw } σ t h \sigma_{\mathrm{th}} σ th μ i \mu_i μ i
μ i − σ i , μ i , μ i + σ i . \mu_i-\sigma_i,\quad \mu_i,\quad \mu_i+\sigma_i. μ i − σ i , μ i , μ i + σ i . 因此:
三轴都稳定:1 个候选;
一个轴不稳定:3 个;
两个轴不稳定:9 个;
三轴都不稳定:最多 27 个。
它比固定密集旋转采样更节省计算,也比只用 Kalman mean 更不容易在突然变向时失效。但候选位置只取一倍标准差,阈值、covariance calibration 与角度周期性都可能影响覆盖率;论文没有系统报告 candidate count–accuracy–latency 曲线。
8. Hierarchical refinement 与选择准则
第 i i i K i K_i K i
t i + 1 = t i + Δ t i , R i + 1 = Δ R i ⊗ R i . \mathbf t_{i+1}=\mathbf t_i+\Delta\mathbf t_i,
\qquad
\mathbf R_{i+1}=\Delta\mathbf R_i\otimes\mathbf R_i. t i + 1 = t i + Δ t i , R i + 1 = Δ R i ⊗ R i . 作者用 refiner 旋转更新量的 L 2 L_2 L 2 ∥ Δ R i ∥ 2 \|\Delta R_i\|_2 ∥Δ R i ∥ 2 K i + 1 K_{i+1} K i + 1 K N = 1 K_N=1 K N = 1
这里没有使用 ground truth;“更新量小即更好”是启发式假设。若 refiner 在错误候选上饱和并输出很小更新,或对近对称姿态产生小更新,它可能误选。论文主实验说明该策略在测试运动分布上有效,但没有单独比较 learned scorer、rendering residual 或不同层数。
最终 pose 有两个反馈路径:
投影 CAD 得到 RGB region,更新 2D tracker 的 target template;
转到世界坐标作为 Kalman measurement,更新下一帧 rotation prediction。
9. 仿真协议与指标
现有 benchmark 缺少同步 camera pose / IMU,作者因此没有在 YCB-Video 原始视频上直接比较,而是在 Isaac Sim 中放入 13 个 YCB-Video 对象。
主测试:对象和相机沿相同预设轨迹分别运行各方法;
相对线速度 > 1.5 >1.5 > 1.5
相对角速度 > 3.0 >3.0 > 3.0
baselines:FoundationPose、SRT3D;
对称对象使用 ADD-S,其他对象同时报告 ADD;
曲线阈值上限 0.1 m,表格为 AUC。
ADD 比较同名 CAD 点在真值与预测变换后的平均距离;ADD-S 对每个真值点找最近预测点,缓解对称对应歧义。这里的 AUC 数字不能直接与使用 0.1d、BOP AR 或真实 YCB-V protocol 的论文横比。
10. 主结果
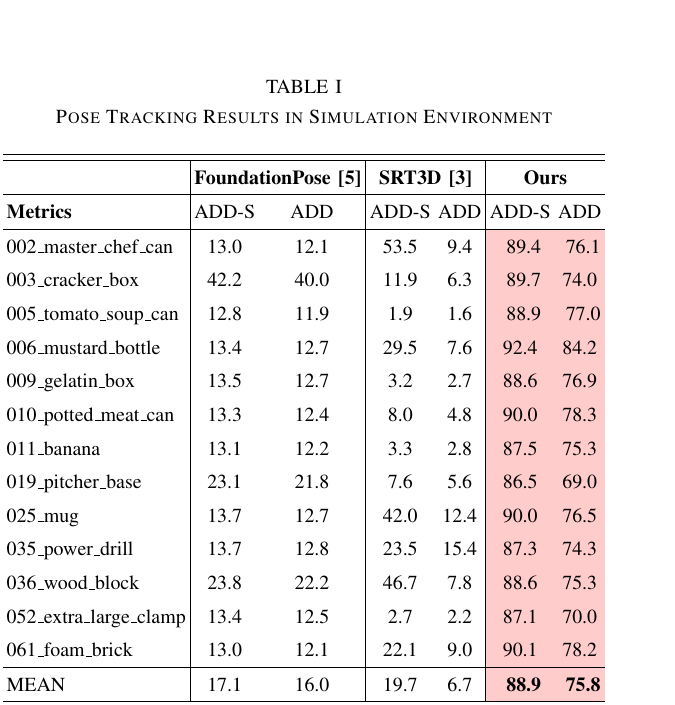
原论文 Table I。三种方法在同一快速运动仿真轨迹上比较;红色列为 DynamicPose。来源:作者公开稿 ;表格版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
方法 平均 ADD-S AUC 平均 ADD AUC FoundationPose 17.1 16.0 SRT3D 19.7 6.7 DynamicPose 88.9 75.8
DynamicPose 在 13 个对象上都取得 86.5–92.4 的 ADD-S AUC;ADD 为 69.0–84.2。相较 FoundationPose,平均 ADD-S +71.8、ADD +59.8;相较 SRT3D,分别 +69.2、+69.1 个绝对点。
这组差距主要证明“上一帧 pose + 单次局部更新”在作者构造的高速运动下会级联失效,而额外的定位和多候选机制能保持跟踪。它不能单独证明静态精度更高,因为实验刻意测试的是 baseline 的失效区域。
11. 定性对比、消融和速度
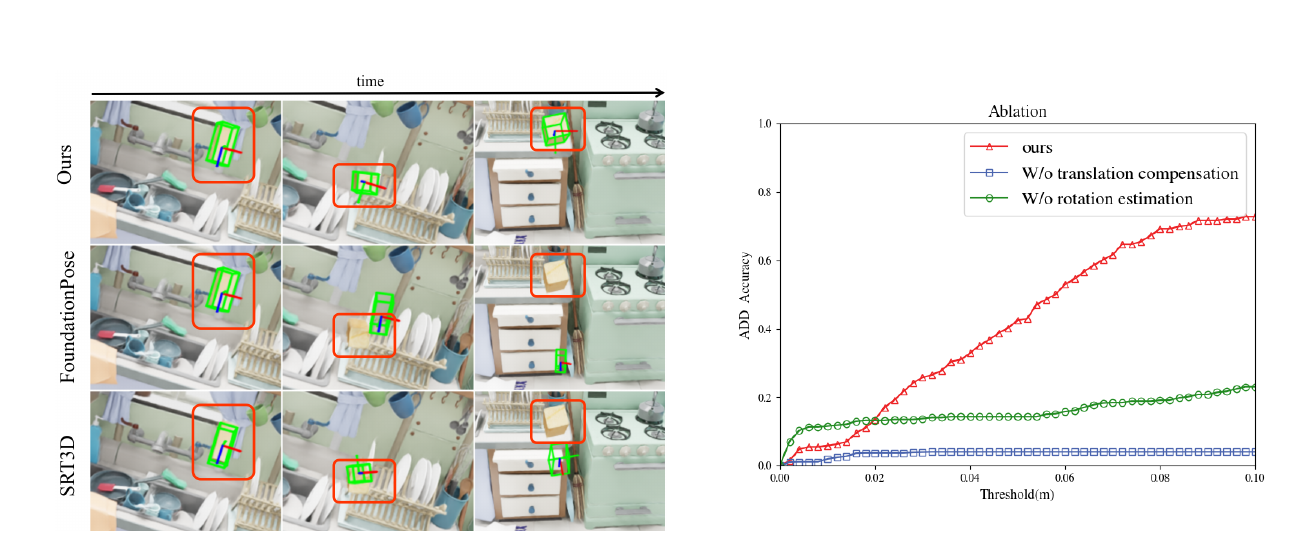
原论文 Figure 6–7。左:wood block 序列中,FoundationPose 因 ROI 初始化失效、SRT3D 因大旋转丢失;右:在超过 3 m/s、8 rad/s 的更激进场景里,完整系统的 ADD 曲线显著高于移除任一补偿模块的版本。来源:作者公开稿 ;图片版权归论文作者及 IEEE 所有,本站仅作论文解读展示。
消融使用更困难的相对运动:线速度 > 3 >3 > 3 > 8 >8 > 8
W/o translation compensation:移除 depth-informed 2D tracker;W/o rotation estimation:移除 VIO-guided Kalman candidate generation;Ours:完整系统。
从 Figure 7 的 0.1 m 端点目读,完整系统 ADD accuracy 约 0.72,移除旋转估计约 0.23,移除平移补偿约 0.04;论文未给这些曲线的精确数值表,因此只能作为近似读图。平移补偿在该轨迹上影响最大,但不能据此推断所有动态场景都如此。
Intel i7-13700F 与 RTX 3060 上平均约 10 Hz。论文没有把 VIO、2D tracker、候选数量、render/refinement 的分段耗时列出,也没有报告最坏帧延迟;“real-time”应理解为作者平台上的约 100 ms/frame,而不是高帧率控制。
12. 真实世界证据
真实实验中,目标刚性固定在移动机械臂末端并沿组合平移 / 旋转轨迹运动,实验者手动移动 RGB-D 相机制造 camera motion。Figure 1 展示 pose overlay 与第三人称画面。
这说明系统至少可以在真实传感器、VIO 与机器人通信链上运行,但证据仍是定性的:
无 pose ground truth;
无 ADD、漂移、成功率或丢失次数;
无与 baseline 的同轨迹定量对照;
无运动速度实测分布;
目标始终保持在相机视野内。
因此,论文最可信的精度结论来自仿真,真实实验更适合证明 system feasibility。
13. 失败模式与局限
作者明确列出三点:
快速相机 / 对象运动造成 RGB motion blur,损失纹理并降低 refiner 精度;
bbox / mask 区域的 median depth 可能偏离真实对象原点,使 translation hypothesis 有系统误差;
深度相机在 3 m 之外测量不准,平移补偿显著退化。
此外还应注意:
VIO 漂移或时间同步误差会同时污染 ROI 和世界坐标旋转;
目标长时间完全遮挡或离开视野时,闭环没有全局重检测保证;
Tait–Bryan + 独立轴高斯在大角度和奇异区域不是理想旋转统计模型;
∥ Δ R ∥ 2 \|\Delta R\|_2 ∥Δ R ∥ 2 候选最多 27 个,极端不确定时 refiner 计算量会上升;
精确 CAD、可靠 depth、首帧 mask / pose 仍是强依赖;
仿真轨迹、材质、motion blur 与 VIO noise 是否覆盖真实机器人分布没有量化。
14. 开源与复现
官方 GitHub 已公开部分代码,仓库声明 2025-09-30 发布首批实现,当前可见依赖包括:
FoundationPose refiner / scorer 与其权重;
MixFormerV2 2D tracker;
Grounding DINO;
SAM2 相关组件;
VINS-Mono VIO;
ROS / catkin、RGB-D–IMU 传感器标定与 demo bag。
仓库采用 GPL-3.0。复现时最关键的并非训练,而是:
RGB、depth、IMU 的时间同步和外参;
VINS-Mono 坐标系与对象 / 相机坐标系变换约定;
bbox 中心、median depth 的有效像素筛选;
σ t h \sigma_{\mathrm{th}} σ th candidate pruning schedule K i K_i K i
FoundationPose 权重、CAD 尺度与渲染坐标;
tracking 丢失检测和重新初始化策略。
“部分代码公开”与“论文全部实验可一键复现”不是同一件事,尤其 Isaac Sim 轨迹和完整评测脚本需要进一步核对仓库版本。
15. 最终评价
DynamicPose 是一篇偏系统、但失效分析清晰的工作。它不试图让单个神经网络在任意高速运动下神奇泛化,而是利用 VIO 分离相机运动、以 2D+depth 找回平移、用 covariance-aware candidates 扩大 rotation basin,再把成熟 refiner 放进闭环。13 对象仿真主表和激进运动消融对这一设计给出强支持。
读者应同时保留两点判断:第一,它在作者定义的快速运动条件下确实显著提高了 tracking robustness;第二,结论依赖仿真、准确 CAD、RGB-D–IMU 和可靠 VIO,真实世界精度尚未被定量验证。对于移动机器人上的高速已知物体跟踪,它值得作为“几何 / 状态估计先把输入拉回 foundation refiner 收敛域”的代表方案。