论文精读笔记:Event-based Motion & Appearance Fusion
1. 核心判断
论文:arXiv 2603.08264
核心问题:事件相机没有 motion blur、延迟低,却只输出亮度变化。只靠局部模板校正时,快运动可能一步跑出搜索邻域;只积分 optical-flow velocity 又必然漂移。
核心回答:把 event stream 分别解码为运动 cue 和速度无关 appearance cue,以 propagation–correction 架构组合,再用 UKF 抑制离散模板校正的抖动。
我的判断:这是一条清晰、可解释的 event-only tracking baseline。论文最强的证据是 fast synthetic sequence 和模块消融;最弱的部分是没有真实 6D 真值、没有完整在线实现,因而“约 110 Hz”只能视为 latency budget 推算。
2. 发表与任务边界
预印本第一页上方写有 “accepted for publication in IEEE ICRA 2026”,但所有页面底部又明确标注 ICRA 2026 的 neuromorphic field robotics workshop。本站为避免把 workshop 论文误标为主会,按 ICRA 2026 Workshop 记录。
给定:
已知对象 3D mesh;
已知初始 6D pose P 0 = { t 0 , R 0 } P_0=\{t_0,R_0\} P 0 = { t 0 , R 0 }
标定后的事件流 E = { x i , y i , t i } E=\{x_i,y_i,t_i\} E = { x i , y i , t i }
静态相机,背景通常静止。
输出相机坐标中的连续 pose。算法本身不检测对象,也不从零恢复初始 pose。事件相机对“变化”敏感,因此对象静止或与背景同速时信息会变弱;相机运动 / 动态背景会额外触发事件,违背实验设置。
3. 双通道总览
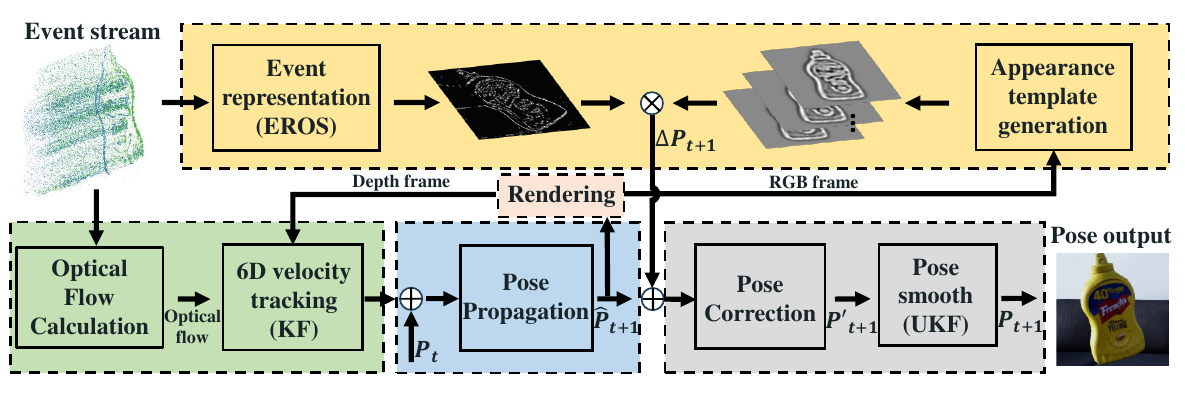
原论文 Figure 1:同一 event stream 同时更新 optical flow 与 EROS。前者预测 pose 中心,后者从 13 个局部渲染模板中选择校正量;UKF 只在最后做时序平滑。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
这套结构解决两个互逆的失效:
纯 propagation :搜索范围无限,但微小 velocity bias 会逐帧积分;纯 local correction :不会长期积分同一误差,但真 pose 一旦离开小扰动邻域就无法找回;组合 :传播让局部邻域跟着对象移动,校正把传播中心重新拉向观测。
4. 运动分支
4.1 时空三元组 optical flow
若同一表面点短时间内依次触发三个事件 e i , e j , e k e_i,e_j,e_k e i , e j , e k
F ( x i ) = x k − x i t k − t i . F(x_i)=\frac{x_k-x_i}{t_k-t_i}. F ( x i ) = t k − t i x k − x i . 单个 triplet 容易被背景噪声或错误关联污染。作者把图像划分为小 RoI,在每个 RoI 收集多组候选,并用时空 registration 选择能同时解释多事件的 flow:
F = arg min F ∈ M ∑ i = 1 n min F i c ∈ M i ∣ F − F i c ∣ . F=\arg\min_{F\in M}\sum_{i=1}^{n}\min_{F_i^c\in M_i}|F-F_i^c|. F = arg F ∈ M min i = 1 ∑ n F i c ∈ M i min ∣ F − F i c ∣. 这仍不是 dense learned optical flow;它是基于事件局部一致性的鲁棒代表向量。
4.2 从 2D flow 到 6D velocity
刚体速度写成
V t = [ v t o , ω t o ] , V_t=[v_t^o,\omega_t^o], V t = [ v t o , ω t o ] , 其中 v t o v_t^o v t o ω t o \omega_t^o ω t o
V t + 1 = ρ V t + w , ρ = 0.5 , V_{t+1}=\rho V_t+w,\qquad \rho=0.5, V t + 1 = ρ V t + w , ρ = 0.5 , 观测 residual 则比较 event flow F ( u , v ) F(u,v) F ( u , v )
F ^ ( u , v ) = J ( u , v ) V t . \hat F(u,v)=J(u,v)V_t. F ^ ( u , v ) = J ( u , v ) V t . 图像 Jacobian 需要点的深度。前一工作从 RGB-D 相机读取 depth;本文利用已知 mesh 和当前 pose 渲染 depth,从而把在线输入缩减为 event-only。需要看到其循环依赖:pose 越偏,rendered depth 越错,6D velocity 反解也会变差,因此后面的 appearance correction 不是可选修饰。
4.3 Pose propagation
线速度直接积分平移,角速度在 quaternion 上积分,得到 P ^ t + 1 \hat P_{t+1} P ^ t + 1
5. 外观分支
5.1 EROS
EROS 是一个与图像同尺寸、取值在 [ 0 , 1 ] [0,1] [ 0 , 1 ] ( u , v ) (u,v) ( u , v ) λ \lambda λ
快运动不因固定曝光而模糊;
相比直接累计事件,慢 / 快对象的轮廓强度更一致;
缺少绝对颜色和静态纹理,适合与渲染 edge 而非 RGB template 比较。
5.2 局部模板
围绕 propagated pose 构造 6 个自由度的正、负扰动:
平移扰动按 image Jacobian 反推,使模板在像平面移动约 1 pixel;
三个旋转轴各取 ± 0.5 ∘ \pm0.5^\circ ± 0. 5 ∘
加上零扰动,共 13 个 pose hypotheses。
对每个 hypothesis 渲染对象 RGB / appearance,Sobel 提取梯度,Difference of Gaussians 扩宽边缘并形成匹配容差。与当前 EROS 点积最高的模板给出 Δ P t + 1 \Delta P_{t+1} Δ P t + 1 P ^ t + 1 \hat P_{t+1} P ^ t + 1
局部步长在像平面定义而非固定毫米值是合理的:同样 1 mm 在不同深度对应像素位移不同。不过 13 个轴向候选没有搜索耦合旋转—平移,一次只能取一个离散方向;若传播误差大于局部邻域,仍会失败。
5.3 UKF
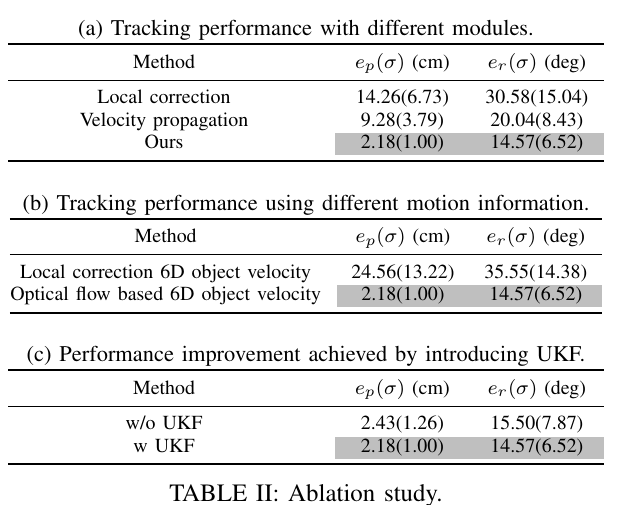
UKF 对校正 pose 做最后平滑,处理 SE(3) 动态非线性和模板离散跳变。Table II(c) 显示:
设置 平移 RMSE 旋转 RMSE 无 UKF 2.43 cm 15.50° 有 UKF 2.18 cm 14.57°
改善存在但不大,主要收益来自 propagation 与 correction 的组合,不应把 UKF 当作核心创新。
6. 数据与评测协议
合成序列来自前作,包含 mustard bottle、potted meat can、cracker box、tomato soup can:
event、RGB-D 和 ground truth 原始频率均为 500 Hz;
将 RGB frame 平均为 60 FPS 以人为制造 exposure blur;
depth 加入标准差 25 mm 的 Gaussian noise;
每对象分 regular 和 fast,共 8 条序列。
真实数据由 1280×720 event camera 与 RealSense D415 同步采集,D415 只为 RGB-D baseline 服务,不进入本文 tracker。对象由人手移动,真实序列没有 pose ground truth。
指标为 position RMSE e p e_p e p e r e_r e r σ \sigma σ
7. 合成主结果
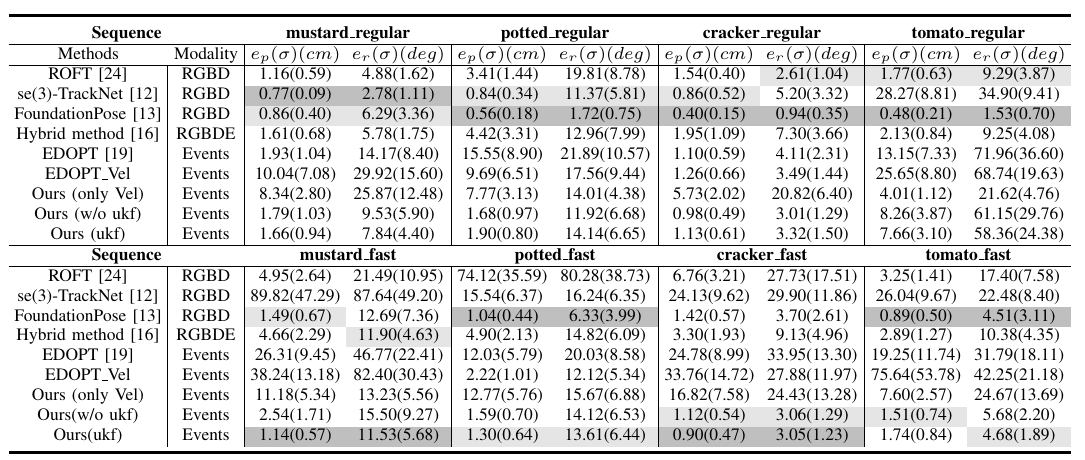
原论文 Table I:regular motion 下 RGB-D 深度方法通常更准;进入 fast motion 后,本文在 mustard 与 cracker 上达到或超过 FoundationPose,但不是所有对象都领先。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
代表性 fast 结果:
对象 FoundationPose 本文 mustard 1.49 cm / 12.69° 1.14 cm / 11.53° potted 1.04 / 6.33 1.30 / 13.61 cracker 1.42 / 3.70 0.90 / 3.05 tomato 0.89 / 4.51 1.74 / 4.68
所以准确结论是“在部分 fast sequences 可与 FoundationPose 相当或更好”,不是 event-only 全面领先 RGB-D transformer。regular motion 中帧模糊很轻,FoundationPose 的纹理 / 深度信息更完整;事件法尤其在 potted 和 tomato 的旋转上明显落后。
相较 EDOPT,本文在大多数序列优势明显。原因是 EDOPT 只有局部模板更新,快运动时真实 pose 会越出扰动区域;本文先用 flow propagation 搬动搜索中心。
8. 模块消融
原论文 Table II:8 条序列平均后,传播与校正缺一不可;event optical flow 估计的 6D velocity 远好于从相邻局部 pose 差分得到的 velocity,UKF 只带来小幅增益。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
设计 平移 RMSE 旋转 RMSE 解释 只做 local correction 14.26 cm 30.58° 真 pose 易跑出局部模板域 只做 velocity propagation 9.28 20.04° 积分漂移 两者组合 2.18 14.57° 互补有效 用相邻 pose 差分估 velocity 24.56 35.55° 把 correction 噪声再次微分 event flow velocity 2.18 14.57° 直接运动 cue 更稳定
这里 rotation RMSE 仍达 14.57°,表明“跟得住”与“高精度”不同;translation 的改善比 orientation 更强。
9. 真实实验与 latency
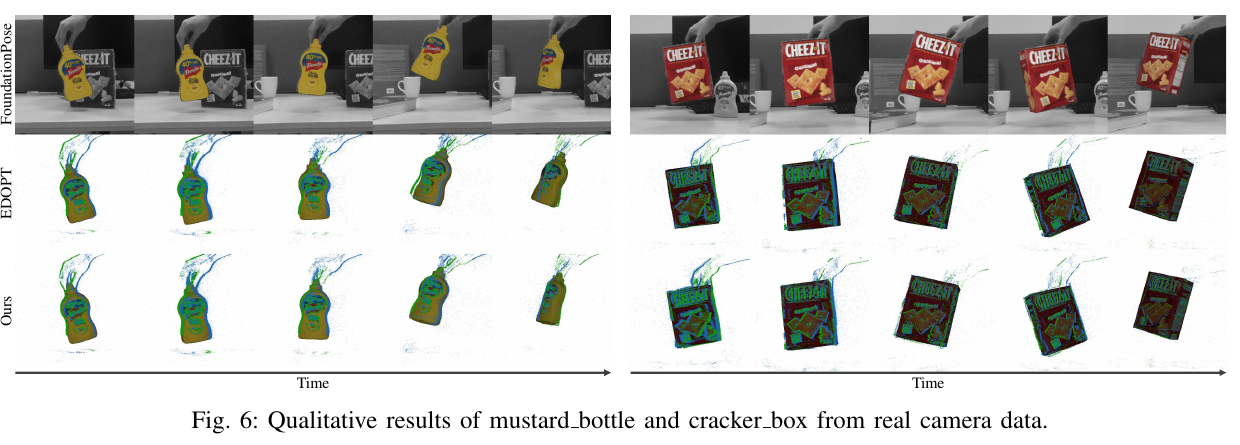
原论文 Figure 6:本文和 FoundationPose 的渲染轮廓在短序列中保持对齐,EDOPT 随时间错位;由于真实数据无 6D 真值,这只能作为定性证据。来源:原论文 。图片版权归论文作者所有,本站仅作学术解读展示。
真实 mustard / cracker 只展示 mesh overlay:
FoundationPose 叠在 RGB frame;
EDOPT 与本文叠在短时间 event accumulation;
作者观察本文与 FoundationPose 均保持对齐,EDOPT 后期漂移。
因为输入图像类型不同,且没有 GT,不能从图中计算“相当”到何种程度。
组件独立计时:
optical flow + velocity KF:约 2 ms;
template correction:约 5 ms;
propagation + final UKF:低于 2 ms。
作者据此预计在线系统约 110 Hz,但 Discussion 明确写道当前还没有完整 full-online pipeline。因此报告时应写“estimated from component timings”,不能写成实测端到端 FPS。
10. 局限与复现建议
初始 pose 与 mesh 是硬前提;论文建议未来增加 event pose detector 做初始化 / 重定位。
背景运动、移动相机和多个独立运动对象会触发额外事件,当前静态背景假设不再成立。
对象停止时事件不足,tracker 需要依靠状态先验;论文没有系统评估 stop–start。
13 个模板只覆盖局部、轴向、离散扰动;应测试更大误差、组合扰动和 coarse-to-fine search。
合成 blur 由 500 FPS frame averaging 得到,未必完全等价于真实 rolling / global shutter 曝光。
真实数据需要 motion-capture 6D GT,尤其要覆盖高速平移、面外旋转、低对比与不同光照。
应分别给 event rate、每次 pose update 消耗的事件数、端到端 latency 和硬件占用。
截至本站整理时未找到官方代码仓库,复现需要组合前作 event flow、EROS、renderer 与滤波器。
11. 方法启发
这篇论文揭示了 event pose tracking 的合理分工:事件数据并不只有一种“最佳表示”。时空局部结构适合读运动,衰减记忆图适合读轮廓;试图用单一 representation 同时承担大范围预测与高精度对齐,往往会在捕获范围和漂移之间二选一。传播—校正框架让两种信息各做擅长的部分,也为后续加入 learned event reconstruction 或 novel-object descriptor 留出了清晰接口。