
Reading Notes
粗读 / 精读
已生成 src/paper-notes/feature-exchange-transformer-icra2025/coarse.md
论文粗读笔记
用于快速判断论文定位、问题设定、核心方法、实验结论和是否值得精读。
论文粗读笔记:Multi-Layer Feature Exchange Transformer for Multi-View 6D Object Pose Estimation in Robot Bin Picking
1. 基本信息
- 作者:Momen Khalil、Vincent Dietrich、Slobodan Ilic
- 会议 / 年份:IEEE ICRA 2025
- 机构:Technical University of Munich、Siemens AG
- 论文:DOI
- 任务 / 数据:多视角 RGB-D 工业 bin-picking 6D pose;ROBI benchmark
- 基础方法:EpiSurfEmb
- 公开性:正文非开放获取,未发现作者公开稿或代码;事实以作者摘要为边界
2. 一句话总结
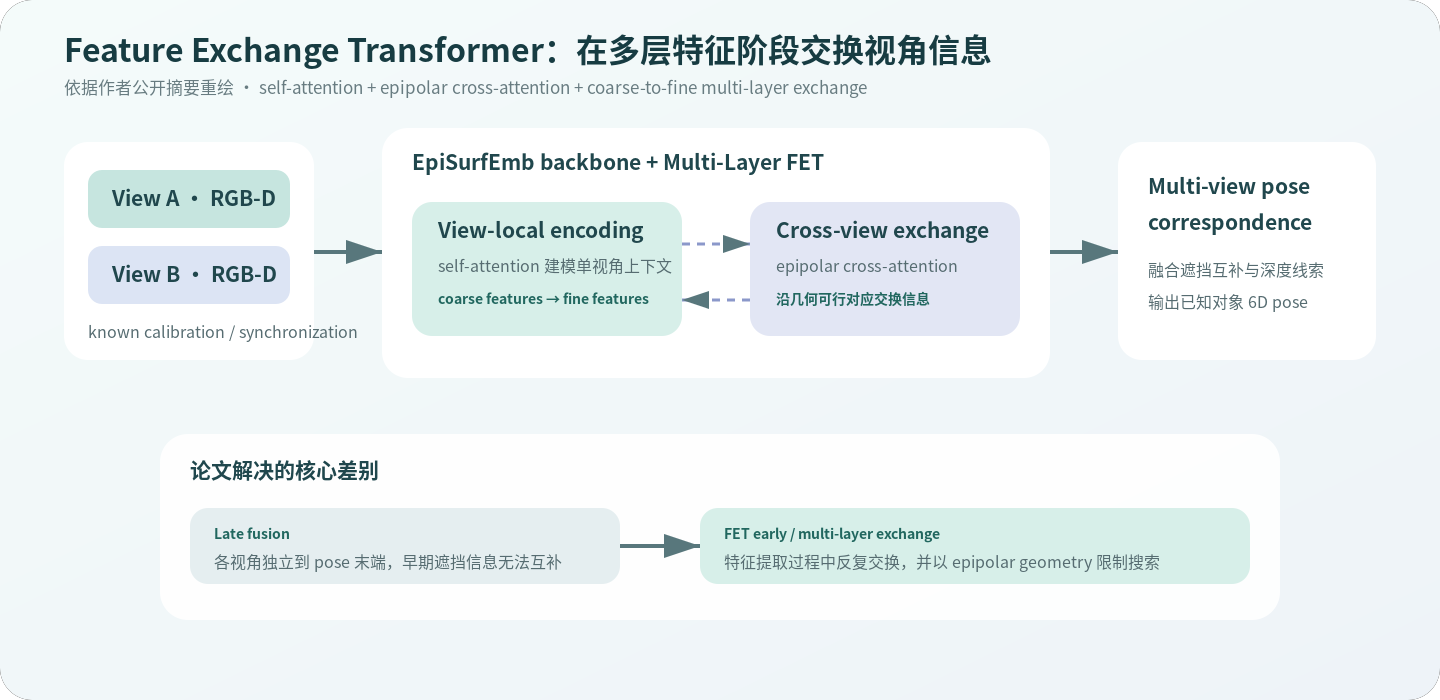
FET 认为多视角 pose 不能等到每个视角独立完成后才做 late fusion;它在 EpiSurfEmb 特征提取过程中插入多层 Feature Exchange Transformer,用 self-attention 建模视角内关系、用 epipolar cross-attention 沿几何可行位置交换视角间信息,并通过 coarse-to-fine 调度控制成本。
3. 方法主线
单视角在反光、遮挡和缺深度的 bin-picking 中常只有部分可靠证据。另一相机可能正好看到被挡区域,但 late fusion 只能在 pose hypothesis 层合并,无法修正前面已经丢失的 correspondence feature。
FET 的公开结构包括:
- 多个已标定 RGB-D views;
- EpiSurfEmb-style correspondence backbone;
- 各层 self-attention;
- epipolar cross-attention,在对应 epipolar locus 上寻找跨视角信息;
- coarse-to-fine multi-layer exchange;
- 输出 multi-view 6D pose。
4. 公开结果与证据边界
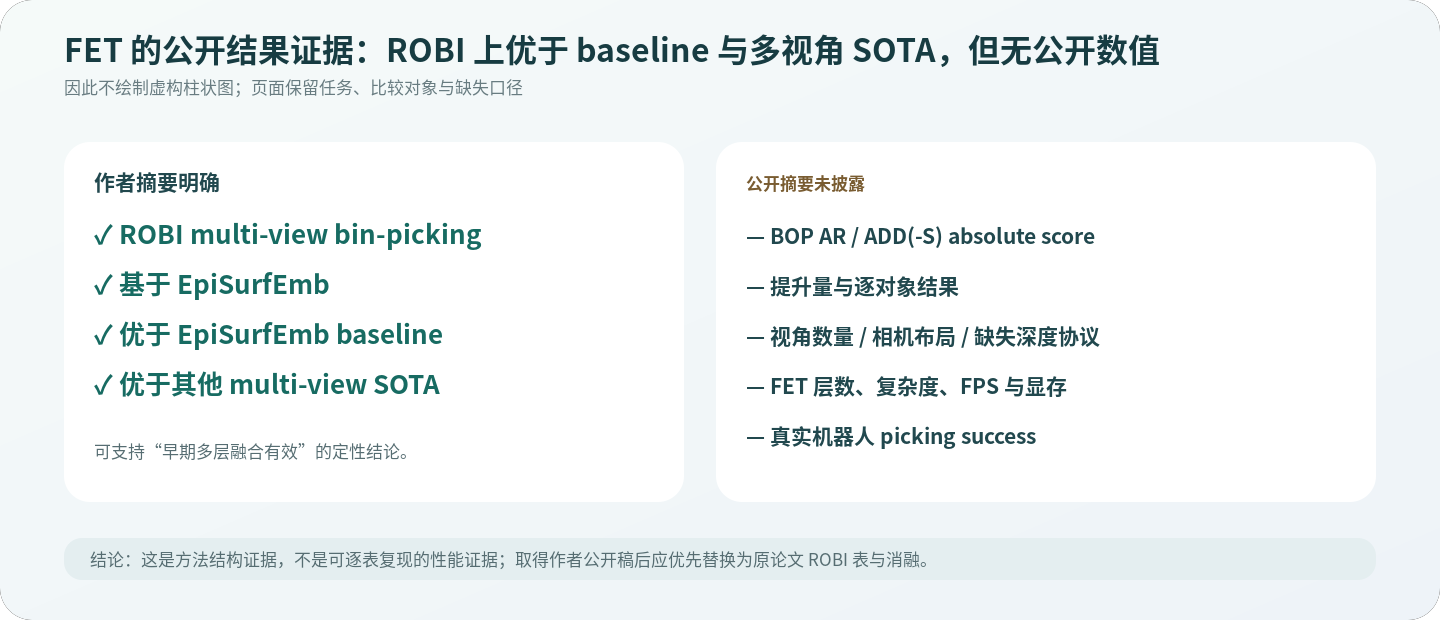
摘要称 ROBI 上:
- 优于 EpiSurfEmb baseline;
- 优于其他 state-of-the-art multi-view pose methods;
- 在 challenging bin-picking 中提升 accuracy 与 robustness。
但没有公开 BOP AR、ADD(-S)、提升量、逐对象表或 runtime。
5. 粗读评价
方法的亮点是把 epipolar geometry 变成 attention 的搜索约束:相比全局 cross-attention,极线限制既减少错误匹配也控制计算。coarse-to-fine 则让低分辨率先交换全局信息,高分辨率再细化局部对应。
部署代价也清楚:需要多相机标定、同步、视角重叠与更高显存;反光导致的跨视角深度错误若相关,增加相机不一定带来独立证据。当前无数字,页面只能确认方法方向,不能判断性能收益是否覆盖硬件和计算成本。