论文精读笔记:Fit-NGP: Fitting Object Models to Neural Graphics Primitives
1. 基本信息
作者 / 机构 :Marwan Taher、Ignacio Alzugaray、Andrew J. Davison;Imperial College London,Dyson Robotics Lab年份 / 会议 :2024 / ICRA论文 :arXiv / PDF 阅读模式 :精读
2. 核心定位
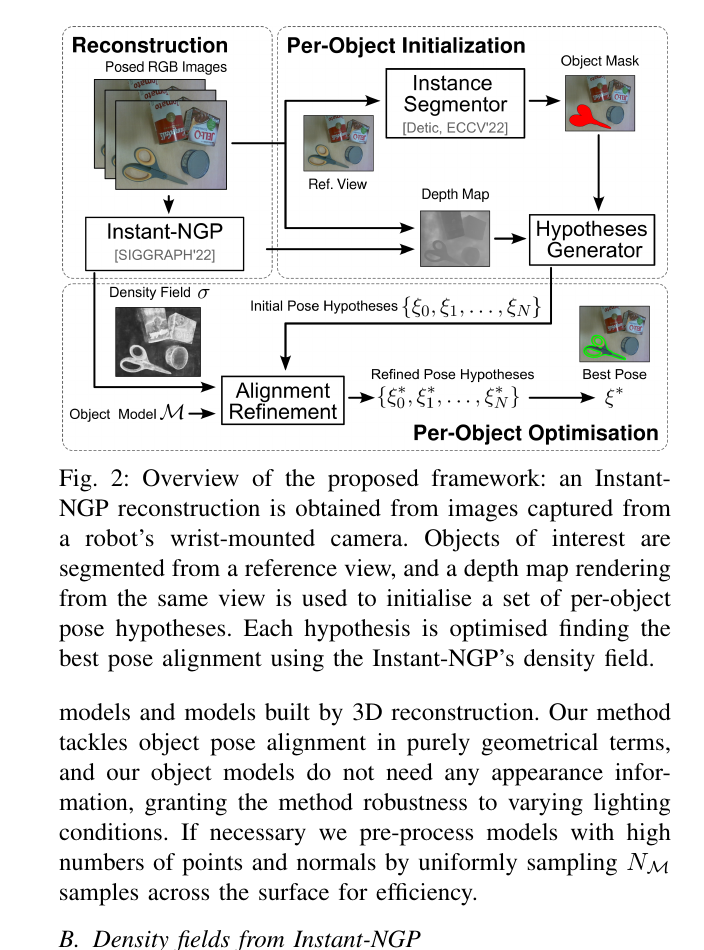
Fit-NGP 不是从单张图直接回归 pose,而是把机器人绕场采集的 RGB 序列先压缩成 Instant-NGP density field,再把已知 CAD 表面当作 query,直接在连续 density 中优化每个物体的 6D pose。
3. 任务边界
输入 / 假设 要求 已知 CAD 模型与尺度 必需 静态桌面场景 必需 多张有位姿 RGB 必需,由腕载相机扫描获得 深度相机 不需要 参考帧实例 mask 需要,论文用 Detic 单帧实时输出 不属于本文目标
因此它适合机器人进入新静态场景后做一次 scene setup,再服务于后续 manipulation;不适合动态目标或只给一帧图像的 benchmark。
原论文 Figure 2:Instant-NGP 重建、参考图分割、pose hypotheses 初始化和模型–density 优化。来源:论文 PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
4. 方法拆解
4.1 用 neural field 聚合多视图证据
机器人移动腕载 RGB 相机,借运动学和 hand–eye calibration 得到初始 camera poses。Instant-NGP 从这些图像学习颜色 c ( x , d ) c(x,d) c ( x , d ) σ ( x ) \sigma(x) σ ( x )
4.2 由参考视图生成初始假设
Detic 在一张参考图上产生 object mask。系统从该视图渲染 NeRF depth,将 mask 内像素反投影为目标附近的 3D 区域,再生成多组 translation / orientation hypotheses。初始化并不追求一步准确,而是要让至少一个假设进入后续优化的 basin。
4.3 模型表面与 density 的拟合
给定 CAD 表面采样点 X M X_M X M T T T σ ( T x ) \sigma(Tx) σ ( T x )
多个初始化假设并行优化,最终依据 density-based score 选择。对于旋转对称对象,评估会按对象 symmetry 对齐,避免把等价旋转误判为错误。
4.4 Camera pose refinement 是关键组成
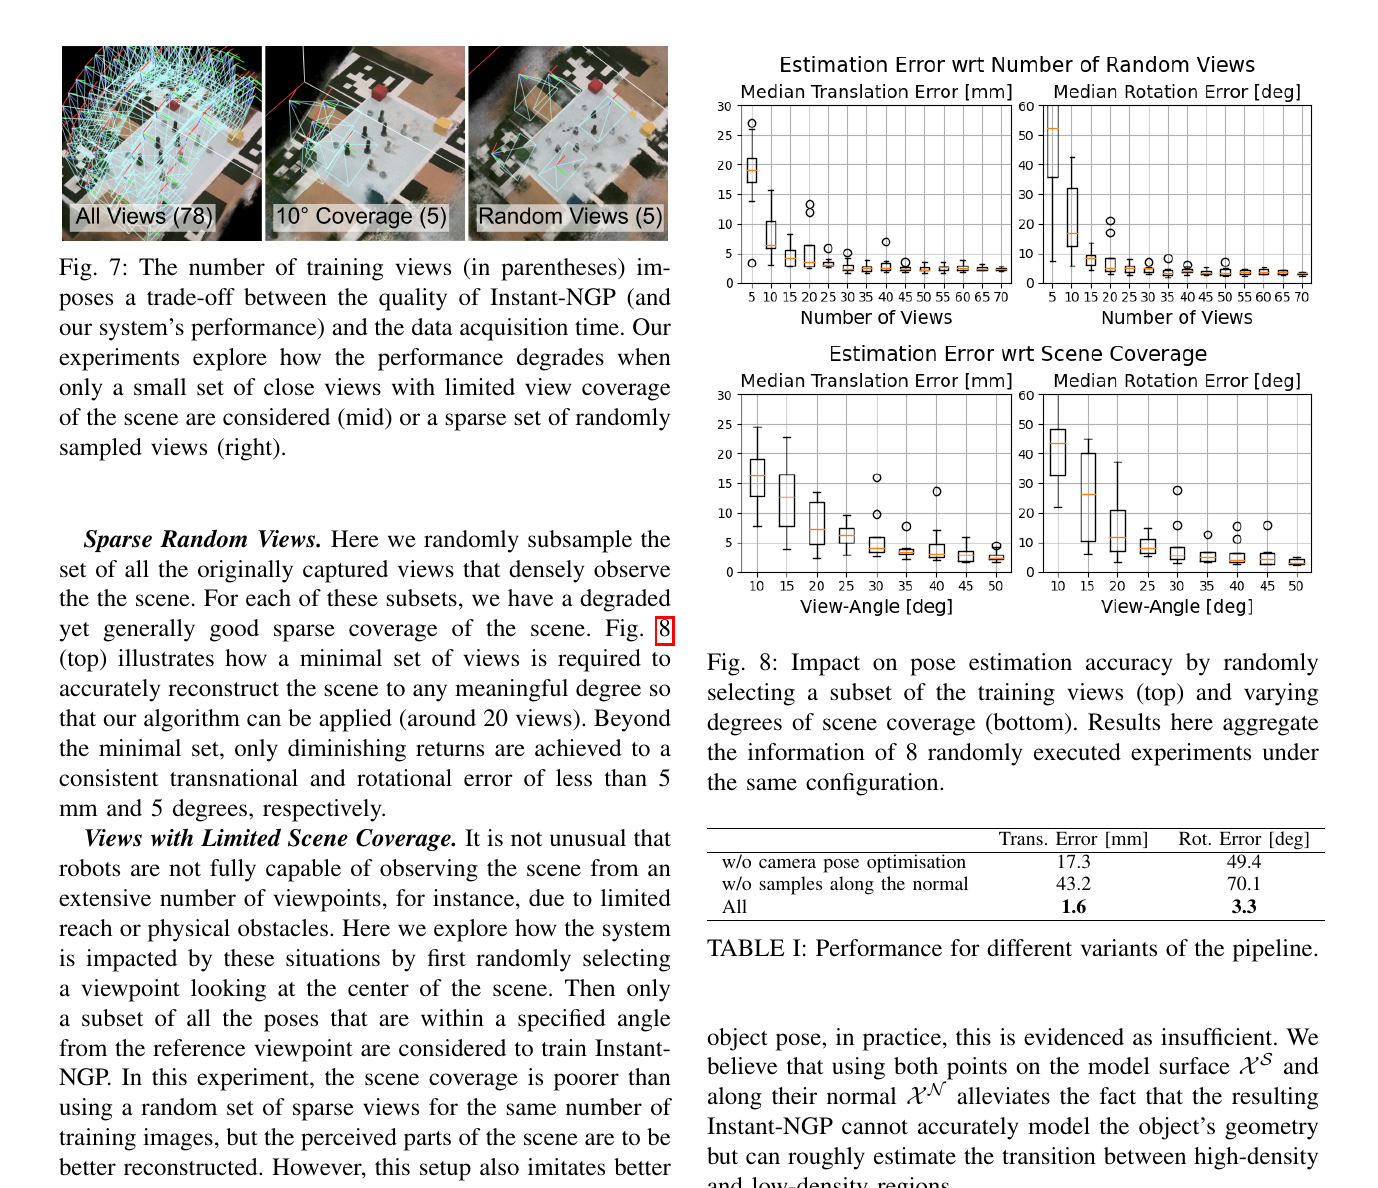
机器人运动学、编码器噪声和手眼标定偏差会直接扭曲 NeRF 几何。作者启用 Instant-NGP 的 camera-pose optimization,使影像和 camera extrinsics 一起对齐。消融中去掉它后 pose 几乎失效,说明 Fit-NGP 的高精度依赖“先把场景坐标系校准好”,而不仅是物体拟合损失。
5. 实验
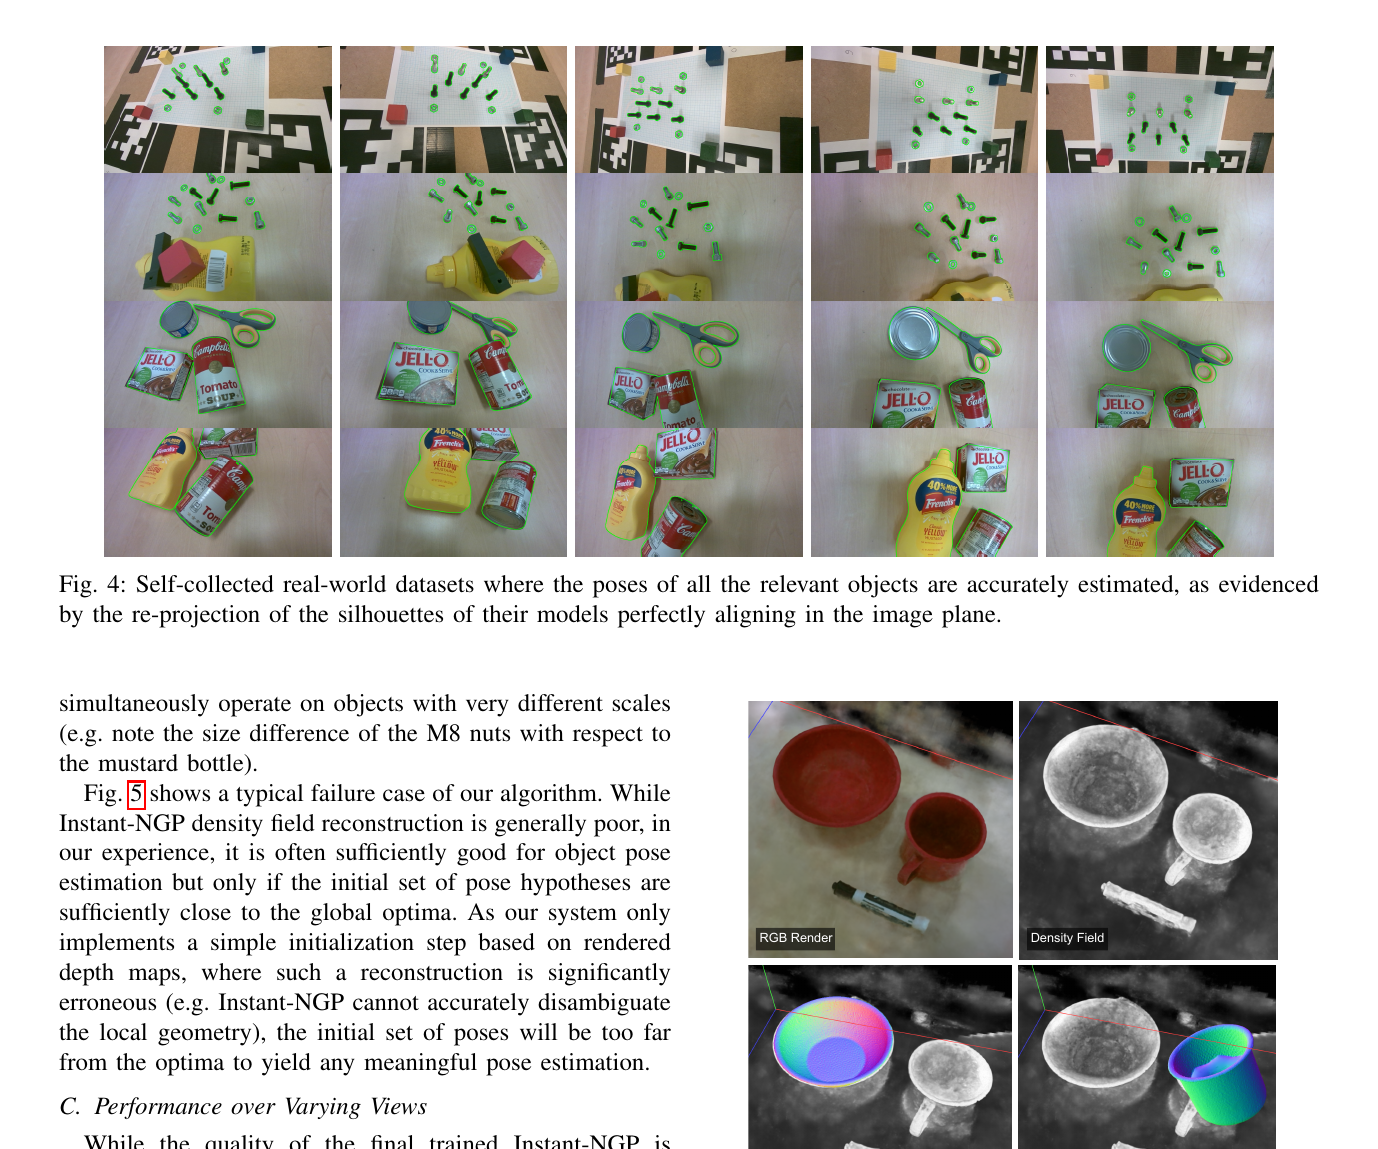
作者在 4 个自采真实桌面场景、共 43 个实例上评测,包含螺栓、螺母、垫圈、罐体和餐具等不同尺寸对象。主要指标为对 symmetry 处理后的相对 rotation / translation error。
设置 中位平移误差 中位旋转误差 完整系统 1.6 mm 3.3° 无 camera-pose optimization 17.3 mm 49.4° 不沿法向采样 43.2 mm 70.1°
这里的 1.6 mm 是 43 个实例上的 median,不代表所有实例都达到毫米级,也不能替代 success-threshold 曲线。
原论文 Figure 4–6:成功场景、低纹理杯子的失败案例,以及视图数量对 density field 的影响。来源:论文 PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
5.1 视图数量和覆盖度
作者的实验指出,约 20 个视图是形成可用 density field 的经验下限。相同视图数下,随机分布、覆盖目标多侧的相机轨迹明显优于集中在狭小角度的轨迹。这说明主动感知策略应优先增加 baseline / angular coverage,而不是简单堆帧。
原论文 Figure 7–8 / Table I:密集局部视图与稀疏广覆盖视图的比较,以及 camera-pose refinement、法向采样等设计的消融。来源:论文 PDF 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
6. 失败模式与批判性分析
低纹理 / 镜面物体 :NeRF 可能学不到正确 density surface,CAD 再精确也无处可拟合。初始化范围 :mask、rendered depth 或目标分离错误会让所有 hypotheses 离真值太远。场景静态性 :扫描期间物体移动会破坏统一场表示。系统时间 :扫描、NeRF training、segmentation 与多假设优化不适合动态闭环。数据规模 :4 个自采场景不足以代表仓储 bin-picking 的拥挤度和遮挡。模型条件 :方法称为 RGB-only sensing,但仍依赖高质量、metric CAD 和对象类别清单。
7. 值得延伸的方向
可以将 next-best-view 直接定义为降低 pose-hypothesis entropy,而非只追求 NeRF rendering quality;也可以把 density uncertainty、semantic feature field 与 CAD edge / normal 联合优化。对于动态机器人场景,更现实的路径是用快速 3D Gaussian 表示、增量更新和局部 object field,减少全场景重建成本。