论文精读笔记:PoseFlex
1. 核心判断
这篇论文与传统“物体 6D pose”最不同之处是输出空间。它估计:
θ=(α,β,γ,δ),
其中 α,β 是两段柔性臂的 arc / bending angles,γ,δ 是整体 yaw / roll。它不输出独立的 3D translation,也不是刚体 SE(3)。因此专题中应把它归为 deformable robotic-instrument configuration-aware pose,不能与 ADD / BOP AR 论文做数值排名。
方法的主要贡献是把已知机器人 kinematics 转成可动态变形的 3D geometry prior,再通过 attention 注入单目图像,而非让 CNN 仅靠 appearance 猜四个角。
2. 数据、输入与监督
作者使用 Agilis Robotics 的腔内手术 flexible-arm prototype,在 ex-vivo 环境收集 12,473 image-pose pairs:
- 9,473 用于 training / validation;
- 3,000 用于 testing;
- GT 来自 robot motor signals,并经人工校正;
- G1:只改变 δ;
- G2:改变 γ,δ;
- G3:α,β,γ,δ 同时改变。
网络输入不只是 RGB:
- 需要 binary robot mask;
- 需要 home-position 3D shape prior;
- 每个 prior point 有 segment / part label;
- 需要 part length、radius、segment count 等 configuration。
正文没有将 mask prediction 纳入 pipeline,也没有报告 mask noise robustness。开源 test data 结构同样直接提供 mask/,所以这属于外部前置条件。
3. 静态 shape prior 如何指导 2D image
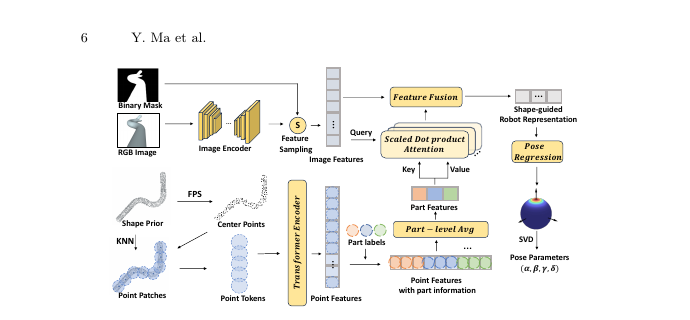 原论文 Figure 3。图像与 shape prior 不做显式 2D–3D correspondence,而在 feature space 中以 part geometry 为 key / value 对 mask 内 image features 做 attention。来源:ECVA 正式论文;图片版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
给定 shape point cloud X∈RN×3:
Pc=FPS(X),Pp=KNN(X,Pc).
每个 patch 过 PointNet 得 token,并加 center-coordinate positional embedding;Transformer 编码后得到 point features fp。利用预定义 part labels,按段平均:
fpartj=∣s(partj)∣1i∈s(partj)∑fpi.
随后 image feature fI 作 query,part features 作 key / value,经 scaled dot-product attention 得 part-aware descriptor。优点是远离 camera、图像中占比小的 robot segments 仍有显式先验;代价是网络默认 kinematic segmentation 与实际机器人完全一致。
这不是传统 CAD matching:没有从 3D points 投影并建立像素 correspondences,shape prior 的作用是 learned feature conditioning。
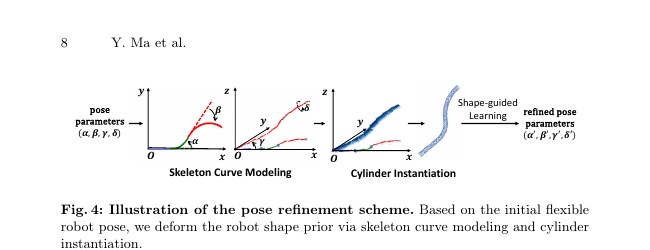 原论文 Figure 4。初始 pose 把 home-position prior 的直线 / 静态形状转换为分段恒曲率 skeleton,再在相邻 control points 间实例化 cylinder,得到 pose-conditioned dynamic prior。来源:ECVA 正式论文;图片版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
静态 prior 只代表 home position;弯曲后形状差距越大,其 geometry guidance 越不可信。PoseFlex 因此采用两阶段:
- PoseEst 用静态 prior 得初始 θ^;
- deformation function Λ(θ^,ϕ,w) 根据预测角、配置 ϕ 与 radius w 生成动态 prior;
- 对每段按 piecewise constant curvature 计算 skeleton control points;
- 使用 Rodrigues rotation 合成 γ,δ;
- 在相邻 control points 间采样 cylinder surface;
- PoseRefine 以新 prior 再次引导图像。
这类似 analysis-by-synthesis,但不渲染 photometric image;它合成的是可供 feature encoder 使用的几何点云。若初值错误,dynamic prior 也会错误,因此 refinement 的 basin 仍依赖 PoseEst。
5. Matrix-Fisher 概率回归
每个自由度独立表示为 matrix-Fisher:
p(R)=M(R;A)=n(A)1exp(tr(A⊤R)).
训练以 negative log likelihood:
L(Y,A)=−logM(Y;A).
推理对 A=USV⊤ 做 SVD:
- U,V 恢复 distribution mode / pose;
- singular values S 表示 concentration,可转换为 uncertainty。
连续 rotation distribution 避免 Euler wrap-around 与 quaternion double-cover 的直接回归问题。但作者为四个角使用独立 distributions,没有显式建模 α,β,γ,δ 的联合相关性;而 flexible-arm kinematics 本身是强耦合的。
6. 主结果:自由度越高,roll 越难
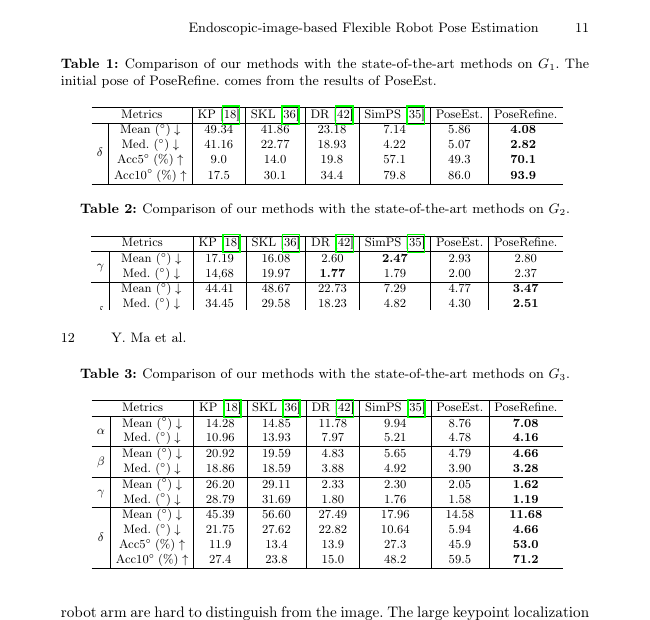 原论文 Table 1–3。PoseRefine 的 initial pose 来自 PoseEst;KP / SKL 还使用 monocular depth Transformer 将 2D keypoints / skeleton 提升到 3D,因此它们的失败包含 depth error。来源:ECVA 正式论文;表格版权归论文作者及 Springer Nature 所有,本站将三张原表组合用于解读。
G1,仅 δ:
| 方法 | Mean | Median | Acc5° | Acc10° |
|---|
| SimPS | 7.14° | 4.22° | 57.1 | 79.8 |
| PoseEst | 5.86° | 5.07° | 49.3 | 86.0 |
| PoseRefine | 4.08° | 2.82° | 70.1 | 93.9 |
PoseEst 的 mean 虽低于 SimPS,Acc5° 反而低 7.8 points,说明 error distribution 不同;Refine 才全面占优。
G2:
- γ:PoseRefine mean 2.80°,但 DR / SimPS 的 2.60° / 2.47° 更低;论文并非每个参数都最好。
- δ:PoseRefine mean / median 3.47° / 2.51°,Acc5° / Acc10° 74.4 / 97.1%,明显最佳。
G3:
| 参数 | SimPS mean | PoseEst mean | PoseRefine mean |
|---|
| α | 9.94° | 8.76° | 7.08° |
| β | 5.65° | 4.79° | 4.66° |
| γ | 2.30° | 2.05° | 1.62° |
| δ | 17.96° | 14.58° | 11.68° |
δ 仍显著难于其他三个参数;高自由度、自遮挡与 camera-axis geometry 使 roll ambiguity 没有被 shape prior 完全消除。
7. 配置与环境变化
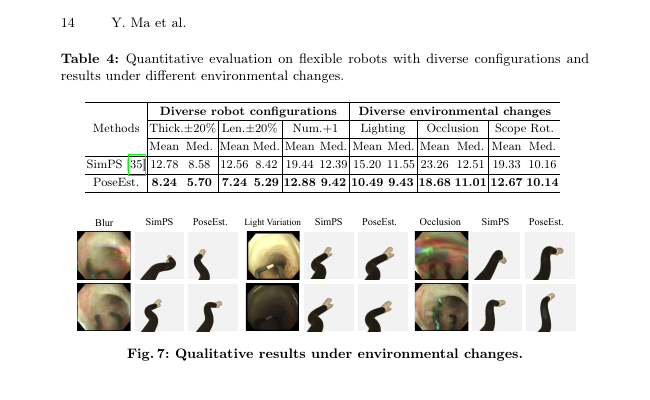 原论文 Table 4 与 Figure 7。这里只比较 SimPS 与 PoseEst,没有 PoseRefine;变化包括厚度 / 长度 ±20%、增加一段,以及照明、冲洗水 / 气泡遮挡和运动模糊。来源:ECVA 正式论文;图表版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
PoseEst mean / median:
- thickness ±20%:8.24° / 5.70°;
- length ±20%:7.24° / 5.29°;
- segment count +1:12.88° / 9.42°;
- lighting:10.49° / 9.43°;
- flushing / bubbles occlusion:18.68° / 11.01°;
- scope rotation blur:12.67° / 10.14°。
全部优于 SimPS,但证据仍有边界:只是一种 prototype 的手工 configuration variations,表中未给每个条件的样本数,也未给完全不同机构 / 材料 / camera 的跨机器人数据。
8. 不确定性证据
项目补充结果显示,高 matrix-Fisher uncertainty 的样本更常对应大 error。它可用于:
- control 时拒绝低置信预测;
- 选择重新观察 / 降速;
- temporal filter 的 measurement covariance。
但正文没有给 Expected Calibration Error、reliability diagram 或 uncertainty-threshold 下的 coverage–risk curve。因此目前证明的是相关性,不是完整概率校准。
9. 关键局限
- 输出是四个 angles,不含 metric translation,不能称为一般 6DoF instrument pose。
- 单一私有 prototype 与 ex-vivo 数据;不存在公开 benchmark 的独立复核。
- GT 来自 motor signals + manual rectification,误差范围未量化。
- binary mask 是必需输入,但 segmentation 误差未纳入。
- test 是否严格按时间序列 / motion trajectory 隔离说明不足,可能存在相邻帧高度相关。
- dynamic prior 依赖 PoseEst,初值失效时可能确认偏差。
- 四个 matrix-Fisher distributions 独立,忽略 joint correlations。
- 对 depth baseline 的比较使用单目预测深度,不能推导真实 stereo / depth sensor 一定更差。
- 无 runtime、模型大小或控制频率。
- future work 才包含 synthetic training 与机器人闭环集成。
- 开源仓库提供代码、test data 与 checkpoint,但完整训练数据需用户自行组织。
10. 复现检查表
- 公开 train / val / test image IDs,并按 trajectory 防止相邻帧泄漏;
- 记录 motor-to-angle calibration 与 manual correction variance;
- 明确 binary mask 来源,并加入 mask corruption;
- 固定 home prior、part labels、length、radius、segment count;
- 分别评估 PoseEst 与 PoseRefine;
- 按 α,β,γ,δ 单独报告 mean / median / thresholds;
- 报告 refinement 对不同 initial-error bins 的成功率;
- 对 uncertainty 做 ECE、NLL、coverage–risk;
- 与真实 depth / stereo sensor 对照,而不仅是 monocular predicted depth;
- 测量 preprocessing、shape deformation、network、SVD 的端到端 latency;
- 增加跨机器人、跨内窥镜、in-vivo 或更真实组织环境。
11. 最终评价
PoseFlex 是把“已知机器人几何”引入单目柔性器械状态估计的一套完整设计:part-aware shape tokens 提升图像特征,初始角度把静态 prior 变形成动态 prior,matrix-Fisher 又让输出带有 uncertainty。G3 四参数均优于 SimPS,说明 shape guidance 对高自由度形变确有帮助。
同时,它解决的是单一柔性臂的四角度估计,不是通用 6DoF 物体 pose。binary mask、真实 pose labels、准确 configuration 与私有数据都是前置条件,δ 仍有 11.68° mean error,且没有速度和闭环控制。适合作为“kinematic prior + visual representation”的代表工作,而不是与 BOP rigid pose 横向比较。
