论文精读笔记:Free-Moving Object Reconstruction and Pose Estimation with Virtual Camera
1. 基本信息
- 作者 / 机构:Haixin Shi 等;EPFL、Magic Leap。
- 年份 / 会议:2025 / AAAI。
- 论文页 · 官方 PDF · 项目页
- 阅读模式:精读。
2. 一句话定位
这是一个 pose-free initialization 的单目 sequence 优化方法:不从已知 CAD 或固定手部关系出发,而是用 virtual camera 将“相机和物体都在自由运动”的优化重参数化为更易收敛的问题。
2.1 论文图表导读
| 图表 | 阅读重点 |
|---|
| Figure 3–5 | virtual camera、progressive training 与 global refinement 分别解决什么优化障碍 |
| Table 1 | mesh 的 HDRM SE,低值更好 |
| Table 2–4 | pose AUC / 相对误差,以及 virtual camera、match、reset、4D reduction 的消融 |
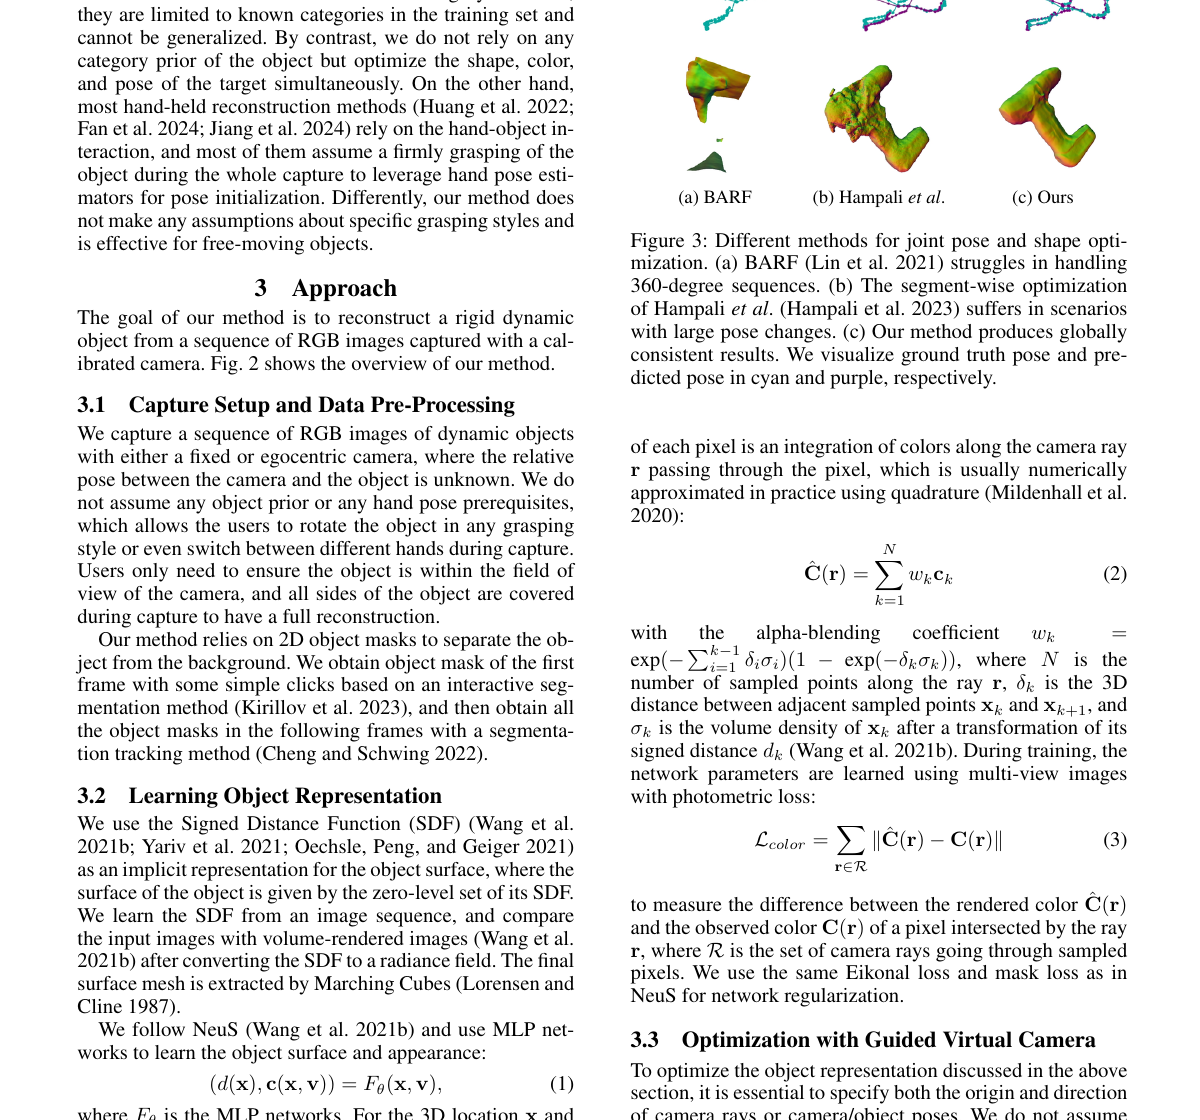 原论文 virtual-camera 优化方法所在页局部。来源:AAAI 官方 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
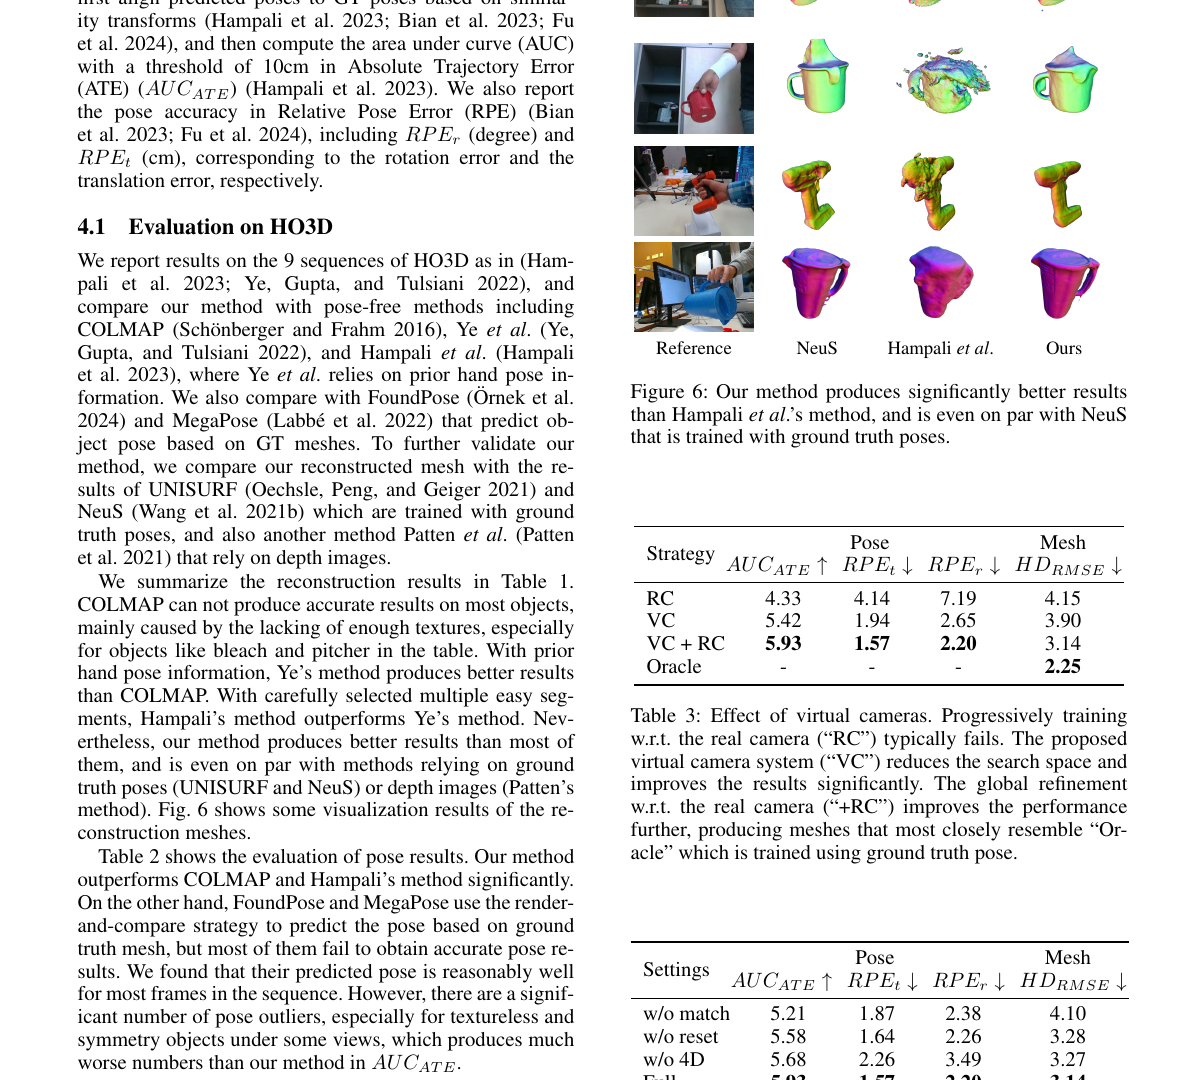 原论文 HO3D 结果与消融所在页局部。来源:AAAI 官方 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 设定与难点
- 输入为有 object mask 的 monocular RGB video,输出每帧 pose 和物体 mesh。
- 当 object、camera、hand 都可自由运动时,传统 static-camera 或 known-hand-pose 假设不再可用;直接同时优化 SDF 和 6DoF trajectory 也容易局部最优。
- 因此其核心不是新 pose head,而是为联合 shape-pose optimization 设计坐标系与训练日程。
4. 方法拆解
- SDF MLP 与 Color MLP 组成隐式物体表示,Pose MLP 从 frame embedding 输出 pose。
- virtual camera 将观测投到受控相机系统,缩小自由旋转 / 平移带来的搜索空间。
- progressive training 按序列组扩展训练,已收敛图像也被少量回放以维持一致性。
- 从 virtual system 得到 3D–2D 对应后用 RANSAC EPnP 回到 real camera;随后以所有图像 global refinement。
- 论文还采用 match loss、形状网络定期 reset,并将 pose 自由度在初始化阶段缩为 4D,以改善收敛。
5. 实验与数值
| HO3D 平均结果 | 数值 | 解读 |
|---|
| Mesh HDRM SE ↓ | 3.14 mm | 优于表中多数 pose-free 方法;接近部分使用 GT pose 的重建路线 |
| Pose AUC ATE ↑ | 5.9 | 与绝对轨迹误差阈值有关,不能和 ADD AUC 混用 |
| virtual camera + real refinement | AUC 5.93;RPE-t 1.57 cm;RPE-r 2.20°;HDRM 3.14 mm | 比只在 real camera 上渐进训练(AUC 4.33、HDRM 4.15)更好 |
完整消融还显示去掉 match / reset / 4D reduction 都会使最终指标变差,说明 virtual camera 本身不是唯一贡献。
6. 批判性分析
优点:把难题定位为优化坐标系而非单纯网络容量;形状和 pose 统一评估;给出了多组件消融。
局限:训练一个 100-frame sequence 约需初始化 3 小时和 refinement 7 小时(V100,论文报告),不属于即时部署方案;高度依赖 mask 与稳定序列,纹理弱 / 长时间遮挡仍可能让隐式优化漂移。
启发:对于无 CAD pose,先构造可控的局部 / 虚拟坐标系,再进行全局配准,比直接回归世界坐标更稳;后续可将 pretrained object representation 或 uncertainty-aware keyframe selection 接入以降低 per-sequence 优化成本。
