论文精读笔记:FreeZe
1. 核心判断
FreeZe 的核心不是“用 DINOv2 做 pose”,而是构造一个同时编码几何与外观的 3D point descriptor:
- GeDi 解决无纹理、遮挡和局部形状;
- DINOv2 区分几何相似但纹理不同的表面;
- 两者都被提升 / 定义在 3D points 上,最终仍交给 3D–3D correspondence 与 rigid registration。
这比直接从 foundation feature 回归 SE(3) 更可解释,也不需要 pose-specific training。消融显示,geometry-only 已有 56.5 AR,vision-only 最好 39.6,融合后 64.7;这说明视觉不是替代几何,而是在几何主干上补充 discriminative evidence。
“training-free”也必须准确理解:FreeZe 不在 BOP / MegaPose 合成数据上训练,但 GeDi 和 DINOv2 是冻结预训练模型,前端 CNOS / SAM6D 也有各自训练与对象 onboarding。它是 task-specific pose-training-free,不是无学习组件。
2. 输入与系统边界
输入:
- RGB-D image I 与 intrinsics;
- query object 3D model Q;
- CNOS 或 SAM6D 给出的 instance mask candidates。
输出 model-to-camera T=(R,t)。query 表面采样 N=5K,target mask 内点云采样 M=1K。
如果 CAD 只有 geometry,GeDi 仍可工作;视觉 query branch 则需要可渲染 texture。BOP 的 ordinary objects 多为 RGB-D reconstructed textured meshes,T-LESS / ITODD 工业 CAD 主要依赖 geometry。
3. 对称的 query / target 特征构造
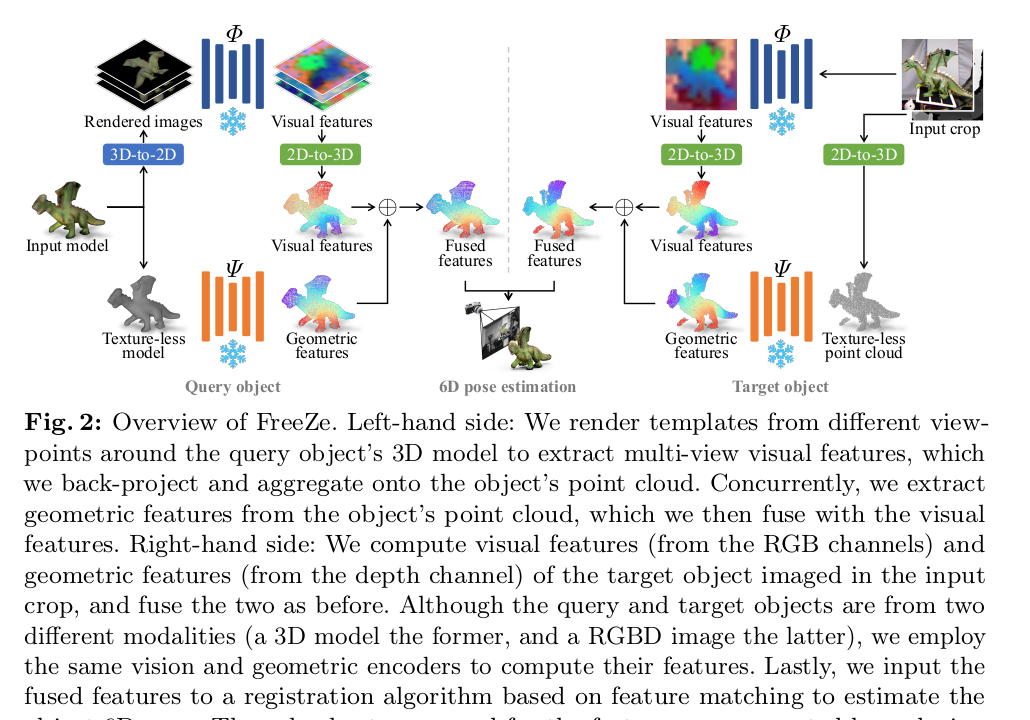 原论文 Figure 2。两侧虽然分别来自 3D model 与 RGB-D observation,但使用同一 GeDi 与 DINOv2;最终都得到位于 3D points 上的 fused descriptors。来源:ECVA 正式论文;图片版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
3.1 Query object
- 从 CAD 表面采样 PQ;
- 冻结 GeDi 在 object diameter 0.3 / 0.4 两个半径提 32D local descriptors,拼为 64D;
- 从多个视角渲染 RGB-D;
- DINOv2 ViT-G 对 RGB crop 输出 patch features,经 bilinear interpolation 变为 pixel features;
- rendered depth 将 pixel feature back-project 到 3D;
- 多视角对同一 query point 的 feature 求平均。
3.2 Target observation
mask + depth + intrinsics 直接反投影为 PT。GeDi 处理点云;DINOv2处理 RGB crop;RGB 与 depth 像素一一对应,因此前景 pixel feature 可直接绑定到 target points。
3.3 Fusion
geometry 与 vision 分别 L2 normalize,再 concatenate:
f=[∥g∥2g∥v∥2v].
两种 feature 均为 64D,融合为 128D。独立归一化防止 DINOv2 1,536D raw scale 或某一模态 norm 主导;PCA 既降到 64D,也让视觉和几何维度平衡。
4. 3D correspondence、RANSAC 与 refinement
RANSAC 从 query 点采样 triplets,在 fused feature space 搜 target nearest neighbors,剔除不一致 matches,并估计 PQR+t≈PT。对多个 mask candidates 分别估计,取 registration inliers 最多者。
ICP 随后做 point-level geometry refinement。这个 pipeline 的优势是所有阶段都可检查 correspondence / inlier / residual;局限是速度和鲁棒性受 RANSAC iteration、overlap、mask outlier 和 ICP basin 影响。
论文结论也承认简单 RANSAC 是后续改进方向;但没有给 runtime、RANSAC iterations 和统一硬件 profiling,使工程代价不够透明。
5. Symmetry-Aware Refinement
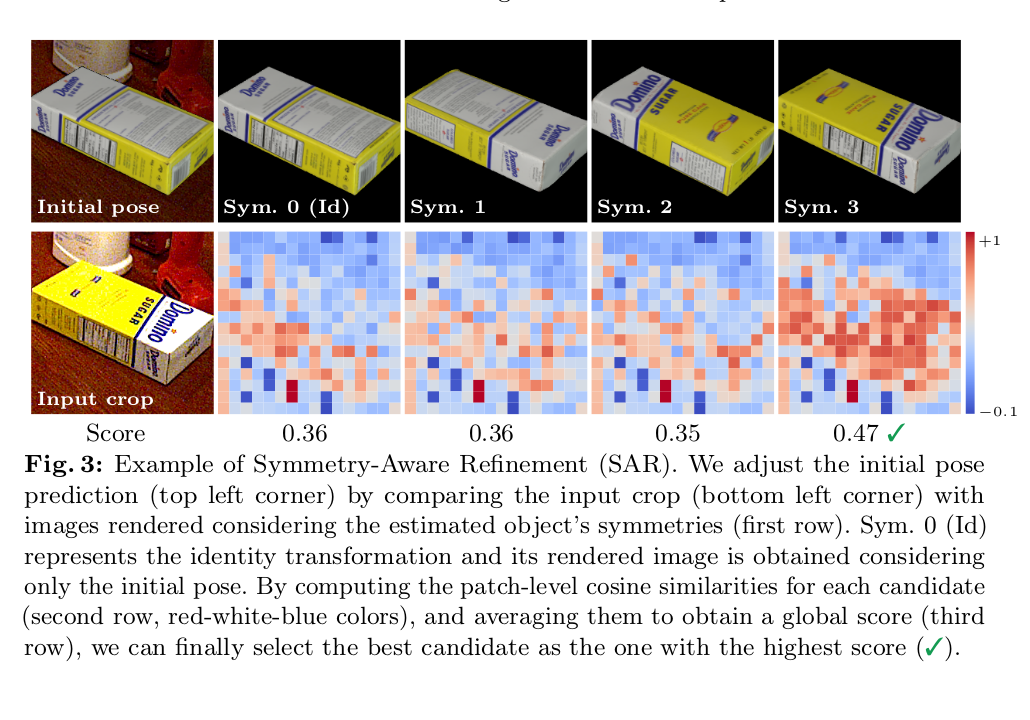 原论文 Figure 3:初始几何 pose 对多个 symmetry rotations 都成立;SAR 渲染候选并与 input crop 做 DINOv2 patch-level cosine similarity,选择分数 0.47 的纹理一致候选。来源:ECVA 正式论文;图片版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
SAR 分两步:
- 在 SO(3) 均匀采样 rotations,以 CD(RsPQ,PQ) 小的变换估计 geometry-only symmetries;
- 将 ICP pose 与每个 Rs 组合渲染,提取 DINOv2 patch features,与 input crop 的 patch features 做 cosine similarity 平均,选最高候选。
这专门处理“几何等价、纹理不等价”的对象。若对象物理上与纹理上都对称,候选本就不可辨;若 coarse pose 不是 symmetry-related error,SAR 也不能替代 general refinement。
6. BOP 主结果
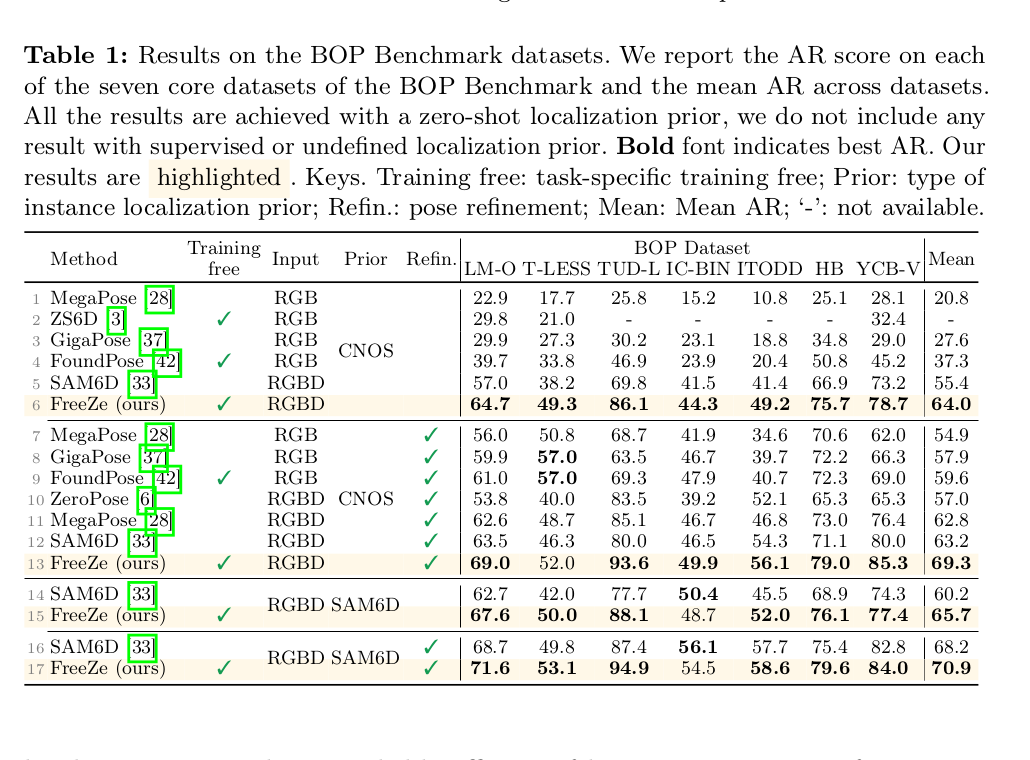 原论文 Table 1。上半部统一使用 CNOS prior,下半部使用 SAM6D prior;RGB-only 行与 RGB-D FreeZe 输入不同,只宜作背景参考。来源:ECVA 正式论文;表格版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
指标为 BOP AR=(ARVSD+ARMSSD+ARMSPD)/3。
| Prior | 方法 | Refinement | Mean AR |
|---|
| CNOS | FoundPose RGB | 无 | 37.3 |
| CNOS | SAM6D RGB-D | 无 | 55.4 |
| CNOS | FreeZe RGB-D | 无 | 64.0 |
| CNOS | SAM6D RGB-D | 有 | 63.2 |
| CNOS | FreeZe RGB-D | ICP + SAR | 69.3 |
| SAM6D | SAM6D RGB-D | 无 | 60.2 |
| SAM6D | FreeZe RGB-D | 无 | 65.7 |
| SAM6D | SAM6D RGB-D | 有 | 68.2 |
| SAM6D | FreeZe RGB-D | 有 | 70.9 |
FreeZe coarse 64.0 已高于 CNOS + refined SAM6D 的 63.2,但两者 pipeline 并不完全相同。最突出数据集是 TUD-L:CNOS + FreeZe coarse 86.1,refined 93.6;作者认为强几何特征对困难光照尤其有效。
mask prior 本身影响明显:FreeZe coarse 64.0→65.7,refined 69.3→70.9。不能只比较 pose backend 而忽略 localization quality。
7. 消融:geometry 是主干,vision 提供增量
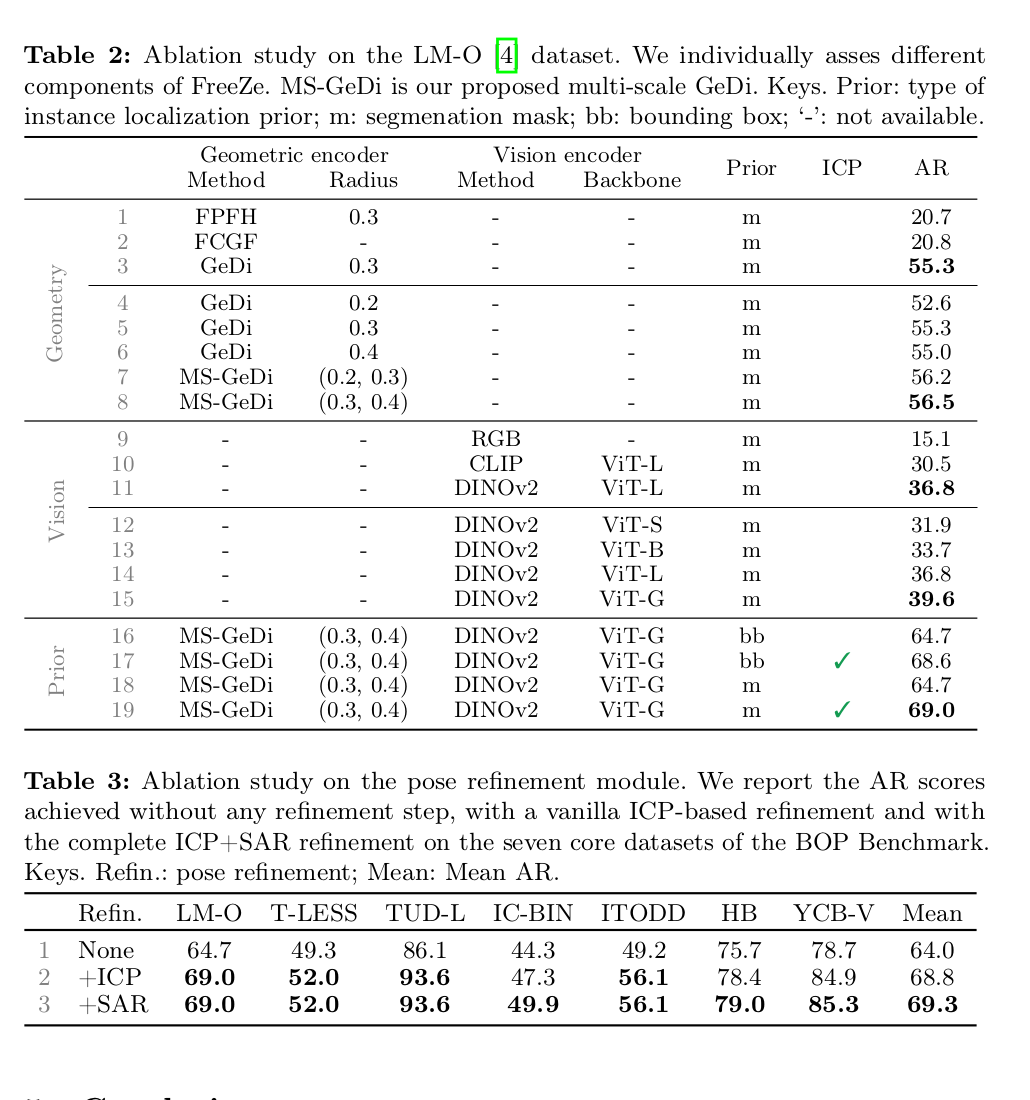 原论文 Table 2–3。LM-O 上 multi-scale GeDi + DINOv2 ViT-G 为 64.7 AR;七集上 ICP 将 64.0 提至 68.8,SAR 再到 69.3。来源:ECVA 正式论文;表格版权归论文作者及 Springer Nature 所有,本站仅作论文解读展示。
LM-O geometry-only:
- FPFH 20.7;
- FCGF 20.8;
- GeDi radius 0.3:55.3;
- MS-GeDi (0.3, 0.4):56.5。
vision-only:
- raw RGB 15.1;
- CLIP ViT-L 30.5;
- DINOv2 ViT-L 36.8;
- DINOv2 ViT-G 39.6。
融合 MS-GeDi + ViT-G:64.7。几何比视觉单模态高 16.9 points,融合比几何再高 8.2,符合“geometry backbone + visual disambiguation”的解释。
box / mask prior 在 coarse 时同为 64.7;加入 ICP 后 box 68.6、mask 69.0。mask 更干净,但 missing object parts 也可能损伤 correspondence;ICP 对 box background outliers 更敏感。
refinement:
- none:64.0;
- +ICP:68.8;
- +SAR:69.3。
SAR 的平均增量仅 0.5,但 IC-BIN +2.6、HB +0.6、YCB-V +0.4,集中在 geometrically symmetric、texture-discriminative 数据。
8. 失败模式与局限
论文 Figure 5 展示四类失败:
- 遮挡后只对齐最近角点,整体旋转约垂直错误;
- 简单 box geometry + 弱纹理导致“侧躺 / 正放”混淆;
- mug 主体对齐但小 handle 未对齐;
- drill handle 全遮挡,只能对齐可见主体。
系统局限:
- 需要 depth,传感器噪声 / 透明反光物体会直接污染 3D;
- GeDi 逐点局部特征和 ViT-G 较重,作者也指出 edge deployment 难;
- runtime、显存、参数量未报告;
- RANSAC / ICP 仍是瓶颈且依赖 overlap;
- RGB-only 尚不可用,作者把“从 RGB 预测 geometry features”列为未来方向;
- query texture、render lighting 与真实图差距会影响 visual feature;
- CNOS / SAM6D 的 candidate calibration 不稳定,需保留多个 masks,增加计算;
- SAR 的 symmetry estimation 是离散采样 + Chamfer threshold,精度和候选数未充分分析。
9. 复现检查表
- query 5K points、target 1K points;
- GeDi radii = 0.3d / 0.4d,各 32D;
- DINOv2 ViT-G、224×224、1,536D→PCA 64D;
- query 多视图视觉 feature 按 3D point 聚合;
- 两模态先分别 L2 normalize 再 concatenate;
- 同时保存 box / mask prior 与多个 candidates;
- 固化 feature NN、triplet sampling、inlier pruning 和 RANSAC参数;
- 分开评估 coarse、ICP、SAR;
- 使用同一 CNOS / SAM6D masks 比较 baselines;
- 补充 feature extraction、matching、RANSAC、ICP、SAR 的逐阶段 runtime 与 memory;
- 对 depth missing、visible ratio、small-part area 和 symmetry type 分层。
10. 最终评价
FreeZe 是一篇结构非常干净的 RGB-D zero-shot pose 方法:不训练新 pose network,而是把成熟的 geometric / vision pretrained features 都落到 3D points,以经典 registration 完成 SE(3) 求解。BOP 七集的 64.0 coarse、69.3 CNOS-refined 和 70.9 SAM6D-refined 证明这种“强特征 + 显式几何”在 2024 年足以超过大规模 pose-specific training。
它也不是轻量万能方案:depth、CAD、mask、GeDi、ViT-G、RANSAC 和 ICP 缺一不可,且没有 runtime。理解这些依赖后,FreeZe 仍是 foundation models 与 3D geometry 如何互补的代表论文;后续 dGeDi 的工作也正是针对其几何 encoder 过慢问题继续优化。
