Reading Notes
粗读 / 精读
已生成 src/paper-notes/gen6d/coarse.md
论文粗读笔记
用于快速判断论文定位、问题设定、核心方法、实验结论和是否值得精读。
论文粗读笔记:Gen6D: Generalizable Model-Free 6-DoF Object Pose Estimation from RGB Images
1. 基本信息
- 标题:Gen6D: Generalizable Model-Free 6-DoF Object Pose Estimation from RGB Images
- 作者 / 机构:Yuan Liu, Yilin Wen, Sida Peng, Cheng Lin, Xiaoxiao Long, Taku Komura, Wenping Wang;The University of Hong Kong, Zhejiang University, Tencent, Texas A&M University
- 年份 / 会议或期刊:2022 / ECCV
- 论文链接:arXiv:2204.10776
- 代码 / 项目页:Project / Code
- 阅读模式:粗读
2. 一句话定位
Gen6D 是早期 generalizable、CAD-free、RGB-only 6D pose 的代表作:给未见物体少量已知相机位姿的参考图,它通过 detector、viewpoint selector 和 feature-volume refiner,在不使用 CAD、depth 或测试时 mask 的情况下估计 query pose。
方法输入与输出
| 项目 | 内容(本站整理) |
|---|---|
| 推理输入 | 单张 query RGB;同一目标的多视角 reference RGB 及其已知位姿;query / reference 的相机内参。建库还需确定目标的粗中心和归一化尺度。 |
| 最终输出 | query 中目标物体相对于相机的旋转 与平移 ;检测框、参考视角选择和 pose residual 是内部步骤。 |
| 必要条件 | 不需目标 CAD、深度或 query GT mask;需要已标定位姿的参考图库。平移的物理尺度取决于参考坐标系和归一化的尺度标定,不由一张 RGB 自动确定。 |
2.1 论文图表导读
| 图表 | 作用 | 粗读建议 |
|---|---|---|
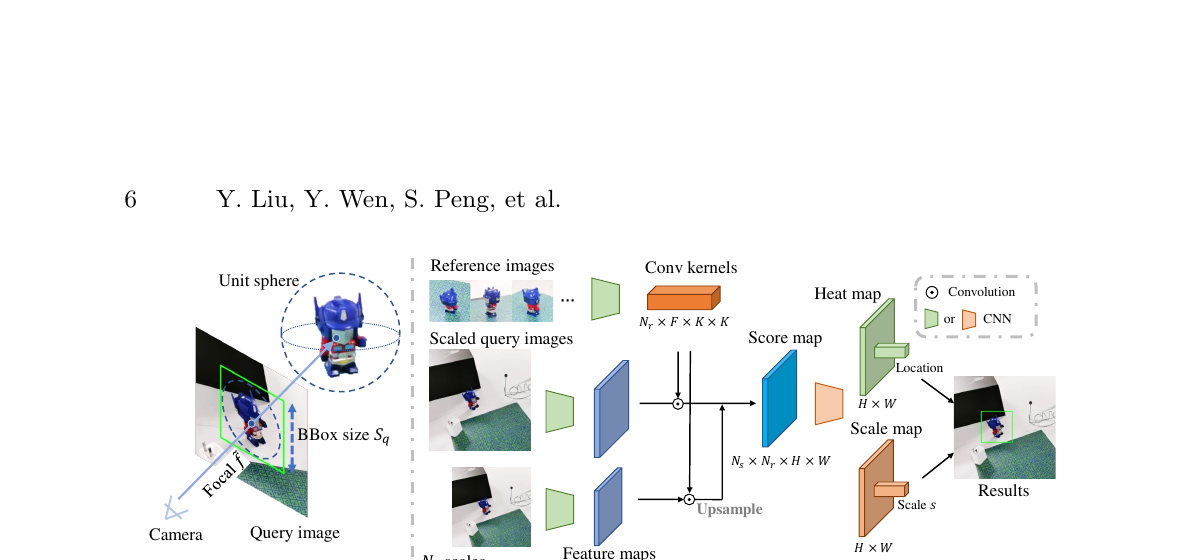
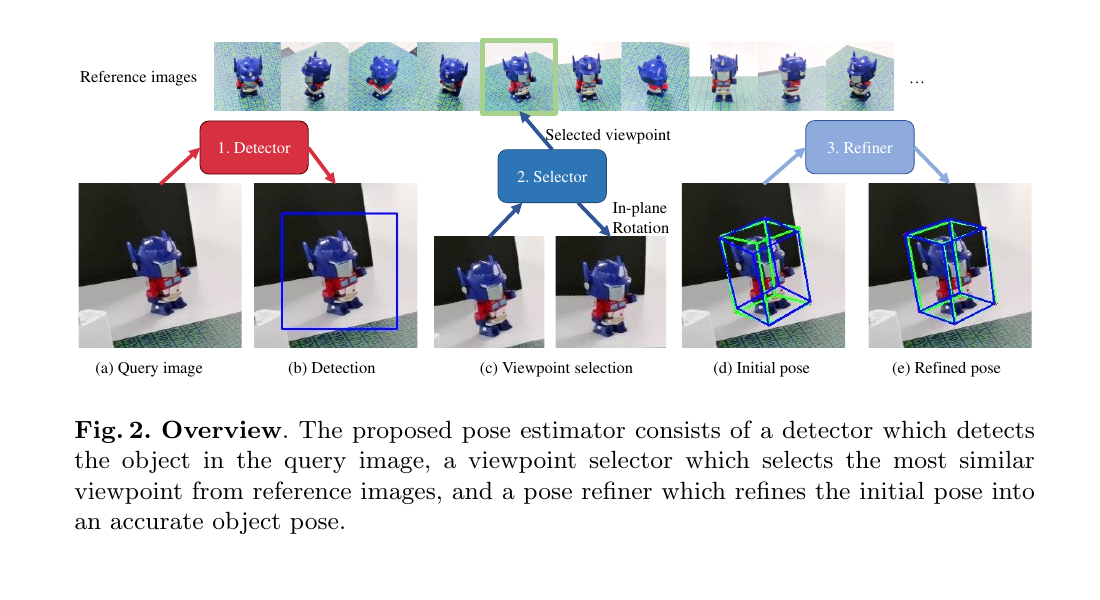
| Figure 2 | 三阶段总览:检测、选视角、细化 | 先建立完整 pipeline |
| Figure 4 | 相关检测器如何从物体框尺度推深度 | 理解其 translation 来源和脆弱处 |
| Figure 6 | 用多参考图构建 3D feature volume 做细化 | 这是区别于 render-and-compare 的关键 |
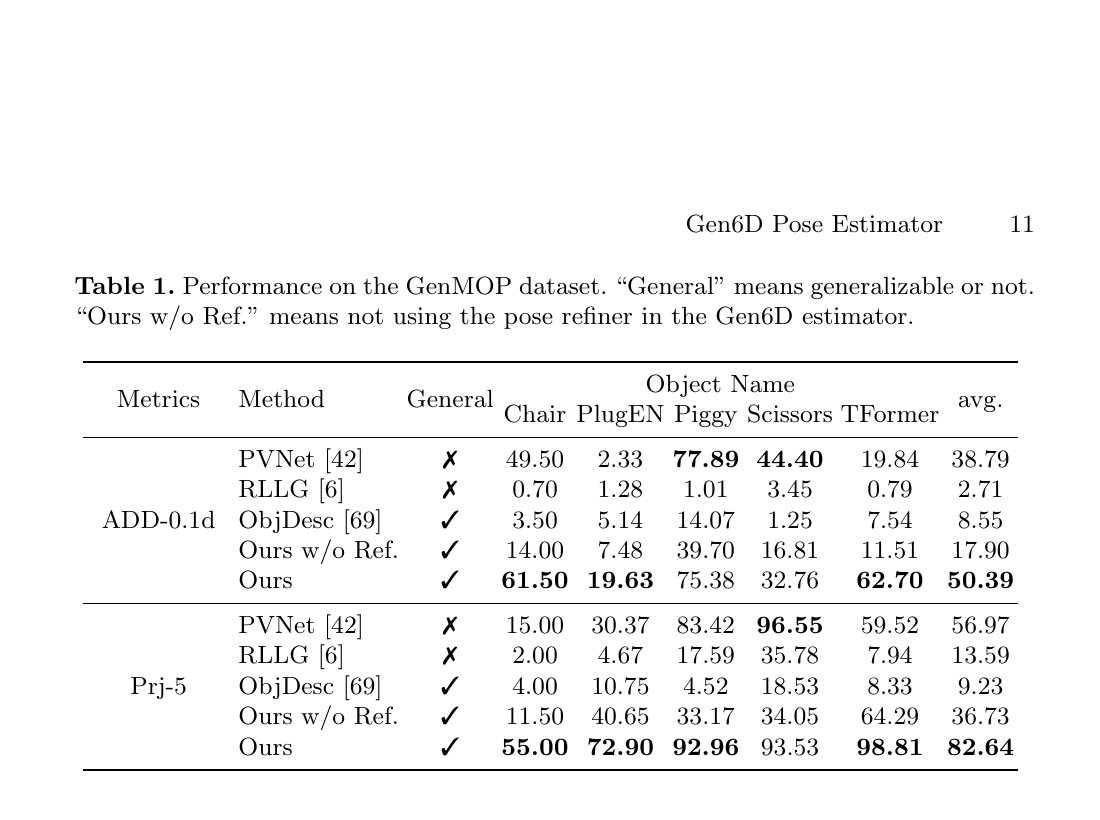
| Table 1 | GenMOP 主结果 | 看 generalizable 方法在未见物体上的收益 |
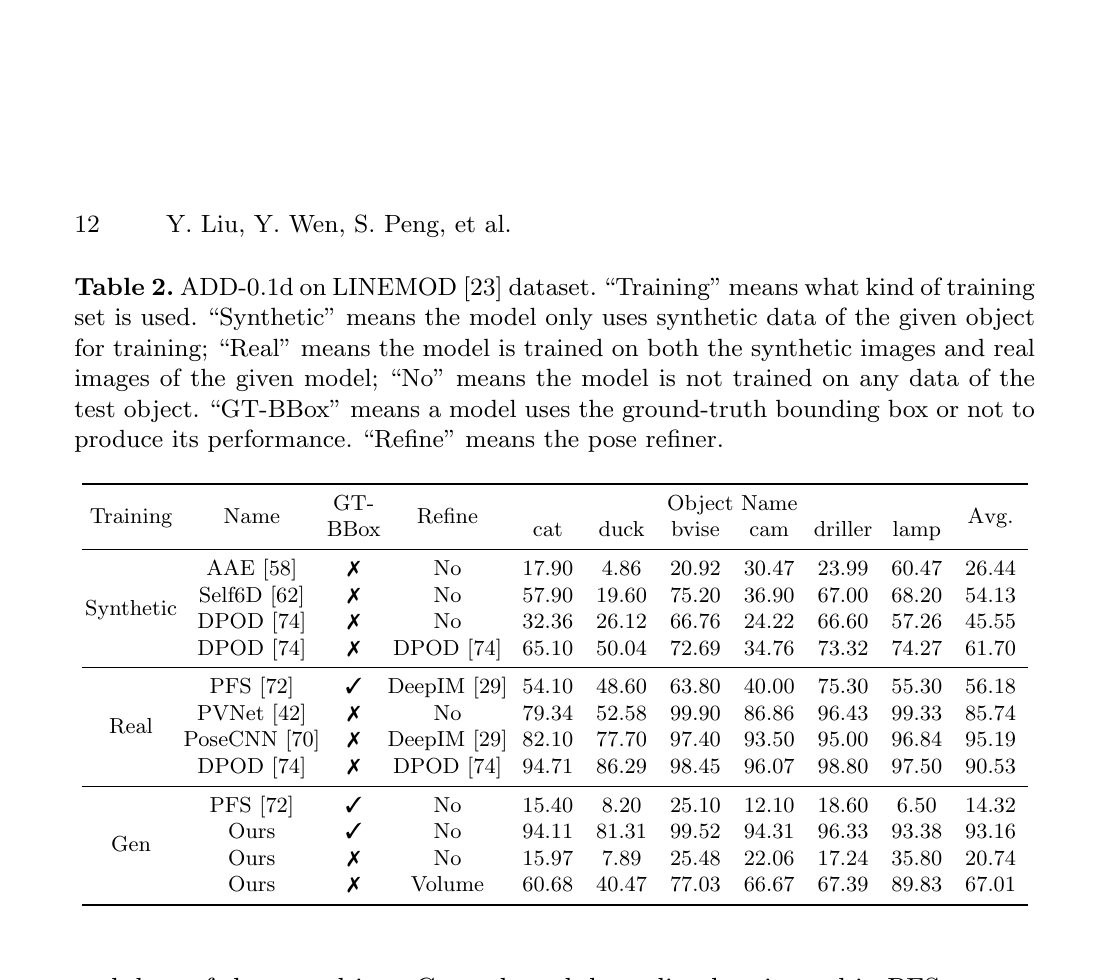
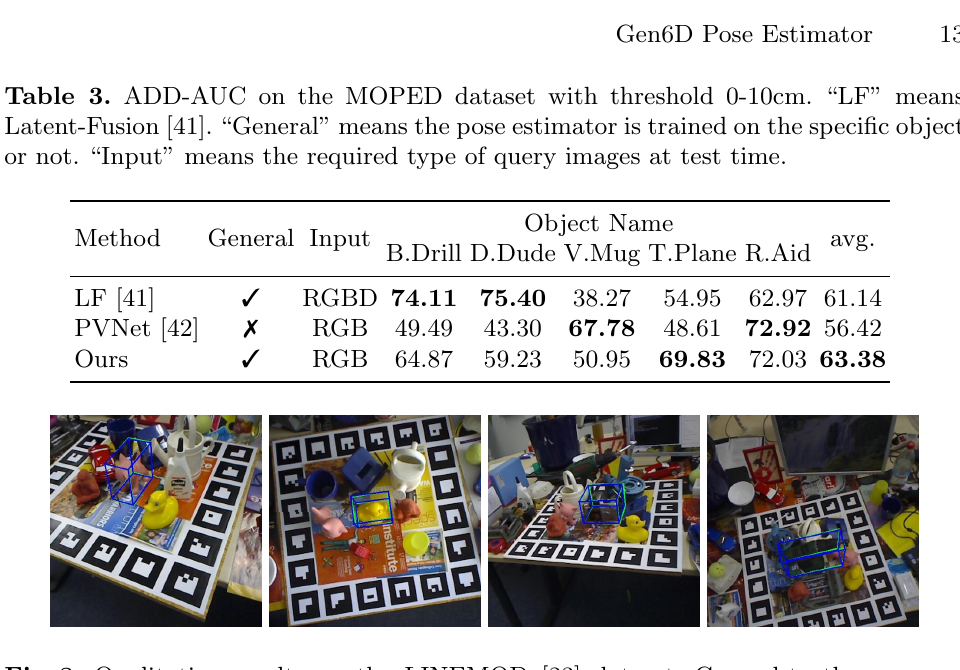
| Table 2 / 3 | LINEMOD 与 MOPED | 注意 GT box 与 RGBD baseline 的设置差异 |
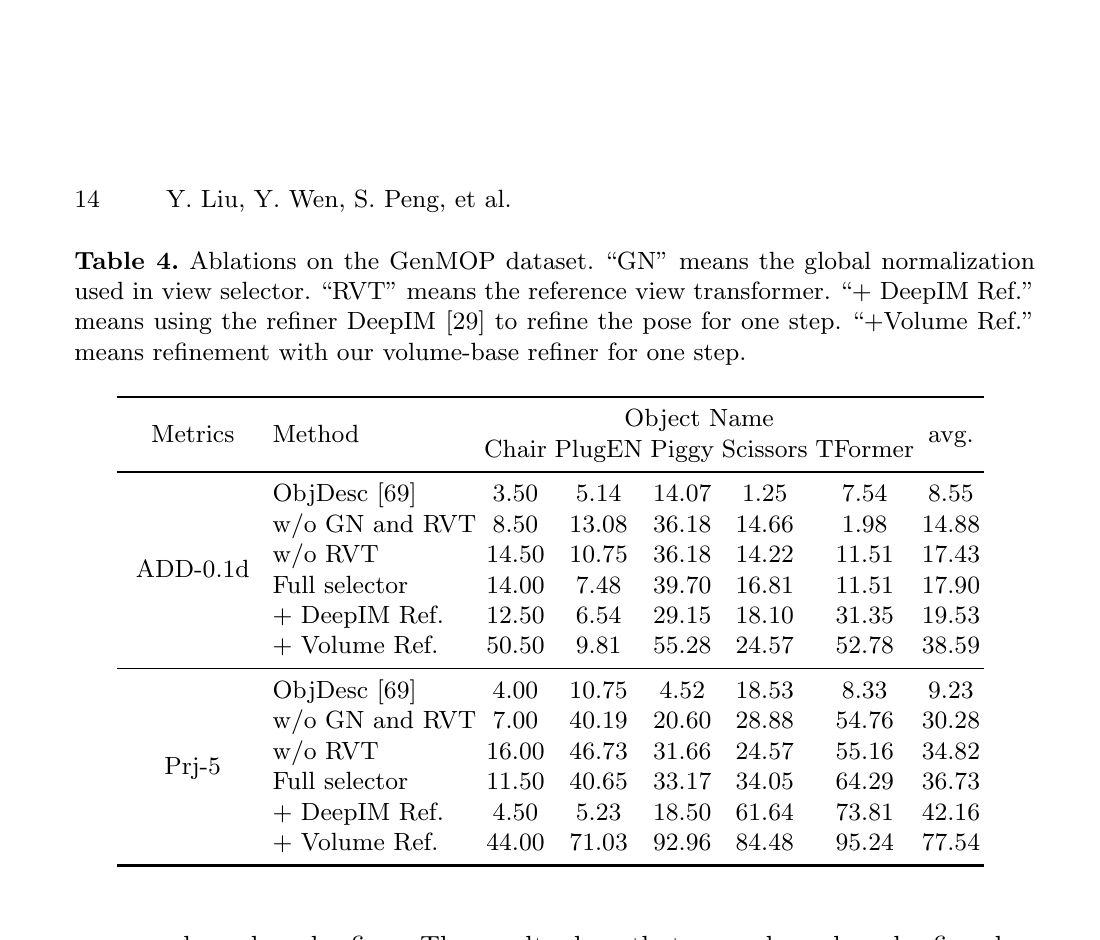
| Table 4 | selector / refiner 消融 | 验证 global normalization、transformer 和 volume refiner |
3. 问题设定
- 任务:instance-level generalizable object pose estimation,不针对某个特定实例重新训练,而是在训练未见过的物体上估计 6D pose。
- 输入:
- query RGB image;
- 同一物体的 张 reference RGB images;
- 每张 reference image 已知的相机 / 物体 pose 与相机内参。
- 输出:query 物体相对于相机的旋转 与平移 。
- 不需要:CAD model、query depth、query object mask。
- 实际前提:reference images 的 pose 必须预先获得;论文用三角化或反投影粗估物体中心与尺度,并假设 reference views 对物体覆盖足够完整。
- 适用场景:可为新物体采集多张已标定参考图的 AR、机器人感知或快速建库场景。
4. 核心动机
- 传统 instance-specific 6D pose 通常依赖每个物体的 CAD、合成渲染或专门训练,无法直接迁移到新物体。
- 已有 model-free 路线往往还需要 depth 或 object mask;Gen6D 希望把推理输入降到 RGB + posed references。
- 稀疏 reference views 下,单纯 global image embedding 容易被 clutter background 干扰,也难区分相近视角;没有 CAD 又不能渲染新视角给常规 refinement 使用。
5. 方法概览
- 总体 pipeline:
- Detector:把所有 reference feature 当卷积核,在多尺度 query feature 上做相关,预测物体中心投影 与框尺度 ;据此得到初始平移。
- Viewpoint selector:逐像素比较 query crop 与每个 reference crop,结合 global normalization 和 reference-view transformer 选最近视角,并回归 in-plane rotation,给出初始旋转。
- Pose refiner:围绕初始 pose 选邻近 references,反投影其 2D features 成 3D volume;将 query features 也投进 volume,用 3D CNN 回归 pose residual,默认迭代 3 次。
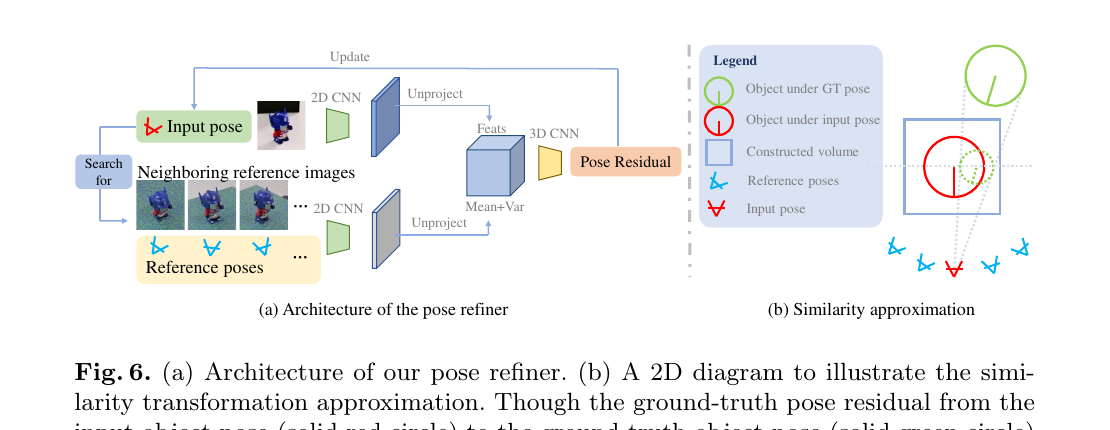
- 使用的基础模型 / 技术:VGG-11 feature extraction、correlation matching、global normalization、Transformer self-attention、2D/3D CNN、feature unprojection。
- training-free 还是需要训练:不是。训练一个共享的 detector、selector、refiner;但对新测试物体不 fine-tune。
6. 实验概览
- 数据集:新建的 GenMOP、MOPED、LINEMOD。
- 指标:ADD-0.1d、ADD-AUC、Prj-5;分别衡量 3D 点距离阈值成功率、0—10 cm AUC 与 5-pixel 投影成功率。
- 主要 baseline:ObjDesc、PVNet、RLLG、Pose-From-Shape、Latent-Fusion、DeepIM。
- 主要结果:
- GenMOP:Gen6D 的平均 ADD-0.1d / Prj-5 为 50.39 / 82.64,高于 ObjDesc 的 8.55 / 9.23,也高于用约 200 张 reference images 单物体训练的 PVNet 的 38.79 / 56.97。
- MOPED:RGB-only Gen6D 的 ADD-AUC 为 63.38,高于 RGBD 且需 mask / depth 的 Latent-Fusion(61.14)与 instance-specific PVNet(56.42)。
- LINEMOD:给 GT box 时可得 93.16 ADD-0.1d;使用自带 detector 而不 refine 时只有 20.74,接 volume refiner 后为 67.01,说明 depth / detection 是实际系统的主要瓶颈。
- 消融:full selector 后的一步 volume refinement 把 GenMOP ADD-0.1d 从 17.90 提升至 38.59,远强于以 selected reference 代替渲染图的 DeepIM refinement(19.53)。
7. 优缺点
优点
- 在 2022 年清晰地把「泛化、无 CAD、RGB-only」三件事结合起来,是后续 reference-based unseen pose 的重要 baseline。
- 3D feature volume 不需要 CAD rendering,且比只看两张 2D image 的 refiner 更有三维结构线索。
- 对额外 depth / mask 依赖低,给新物体不需要重新训练。
缺点 / 风险
- “model-free”不等于没有建库成本:新物体仍需多张带 pose的 reference images,实际通常要先跑 COLMAP / SfM 或其他标定流程。
- reference views 少或覆盖不均会明显退化:GenMOP 中从 128 views 减到 8 views,ADD-0.1d 从 51.30 降至 27.55;只覆盖半空间也从 50.39 降至 28.79。
- 物体框尺度决定深度,LINEMOD 的 detector 误差会被放大为深度误差;严重遮挡也不是其专门处理对象。
- 论文报告 540 x 960 输入在 RTX 2080Ti 上约 0.64 s,其中三轮 refinement 约占 0.5 s,离高帧率部署仍有距离。
8. 对我的启发
- 可以借鉴的点:以 reference-conditioned feature volume 替代 CAD render;在候选 reference 间共享相似度上下文的 global normalization / view transformer;把平移初始化和旋转选择解耦。
- 可以作为 baseline 吗:对 CAD-free、reference-based、unseen instance RGB pose 是必须加入的经典 baseline;对 BOP 的 seen-object CAD setting 不是直接同设定对比。
- 是否值得精读:值得,重点是 detector 的尺度到深度转换、selector 的跨 reference context、volume unprojection 与 similarity approximation。
- 后续需要查的问题:如何以现代表征替换 VGG / 早期 transformer,怎样降低 reference pose acquisition 成本,以及如何把开放词汇检测与遮挡恢复接到这一管线。