论文精读笔记:GenHOI: Generalized Hand-Object Pose Estimation with Occlusion Awareness
1. 基本信息
标题:GenHOI: Generalized Hand-Object Pose Estimation with Occlusion Awareness
作者:Hui Yang、Wei Sun、Jian Liu、Jian Xiao、Tao Xie、Hossein Rahmani、Ajmal Mian、Nicu Sebe、Gim Hee Lee
机构:NERC-RVC, Hunan University;National University of Singapore;Lancaster University;The University of Western Australia;University of Trento
年份 / 会议:ECCV 2026 Poster
论文版本:arXiv:2603.19013 v4 (本站核验版本修订于 2026-07-02)
正式条目:ECCV 2026 Poster 4706
代码 / 项目页:截至本站核验时,论文、arXiv 与 ECCV 页面均未给出公开实现或项目页
阅读模式:精读
阅读重点:所谓 generalized hand-object pose 的真实任务边界;RGB、文本与“预测点云”在训练 / 推理中的来源;手先验究竟怎样进入对象旋转和平移;遮挡与未见对象结论由哪些表格支持;作者的 SOTA 描述是否逐项成立。
2. 核心结论先行
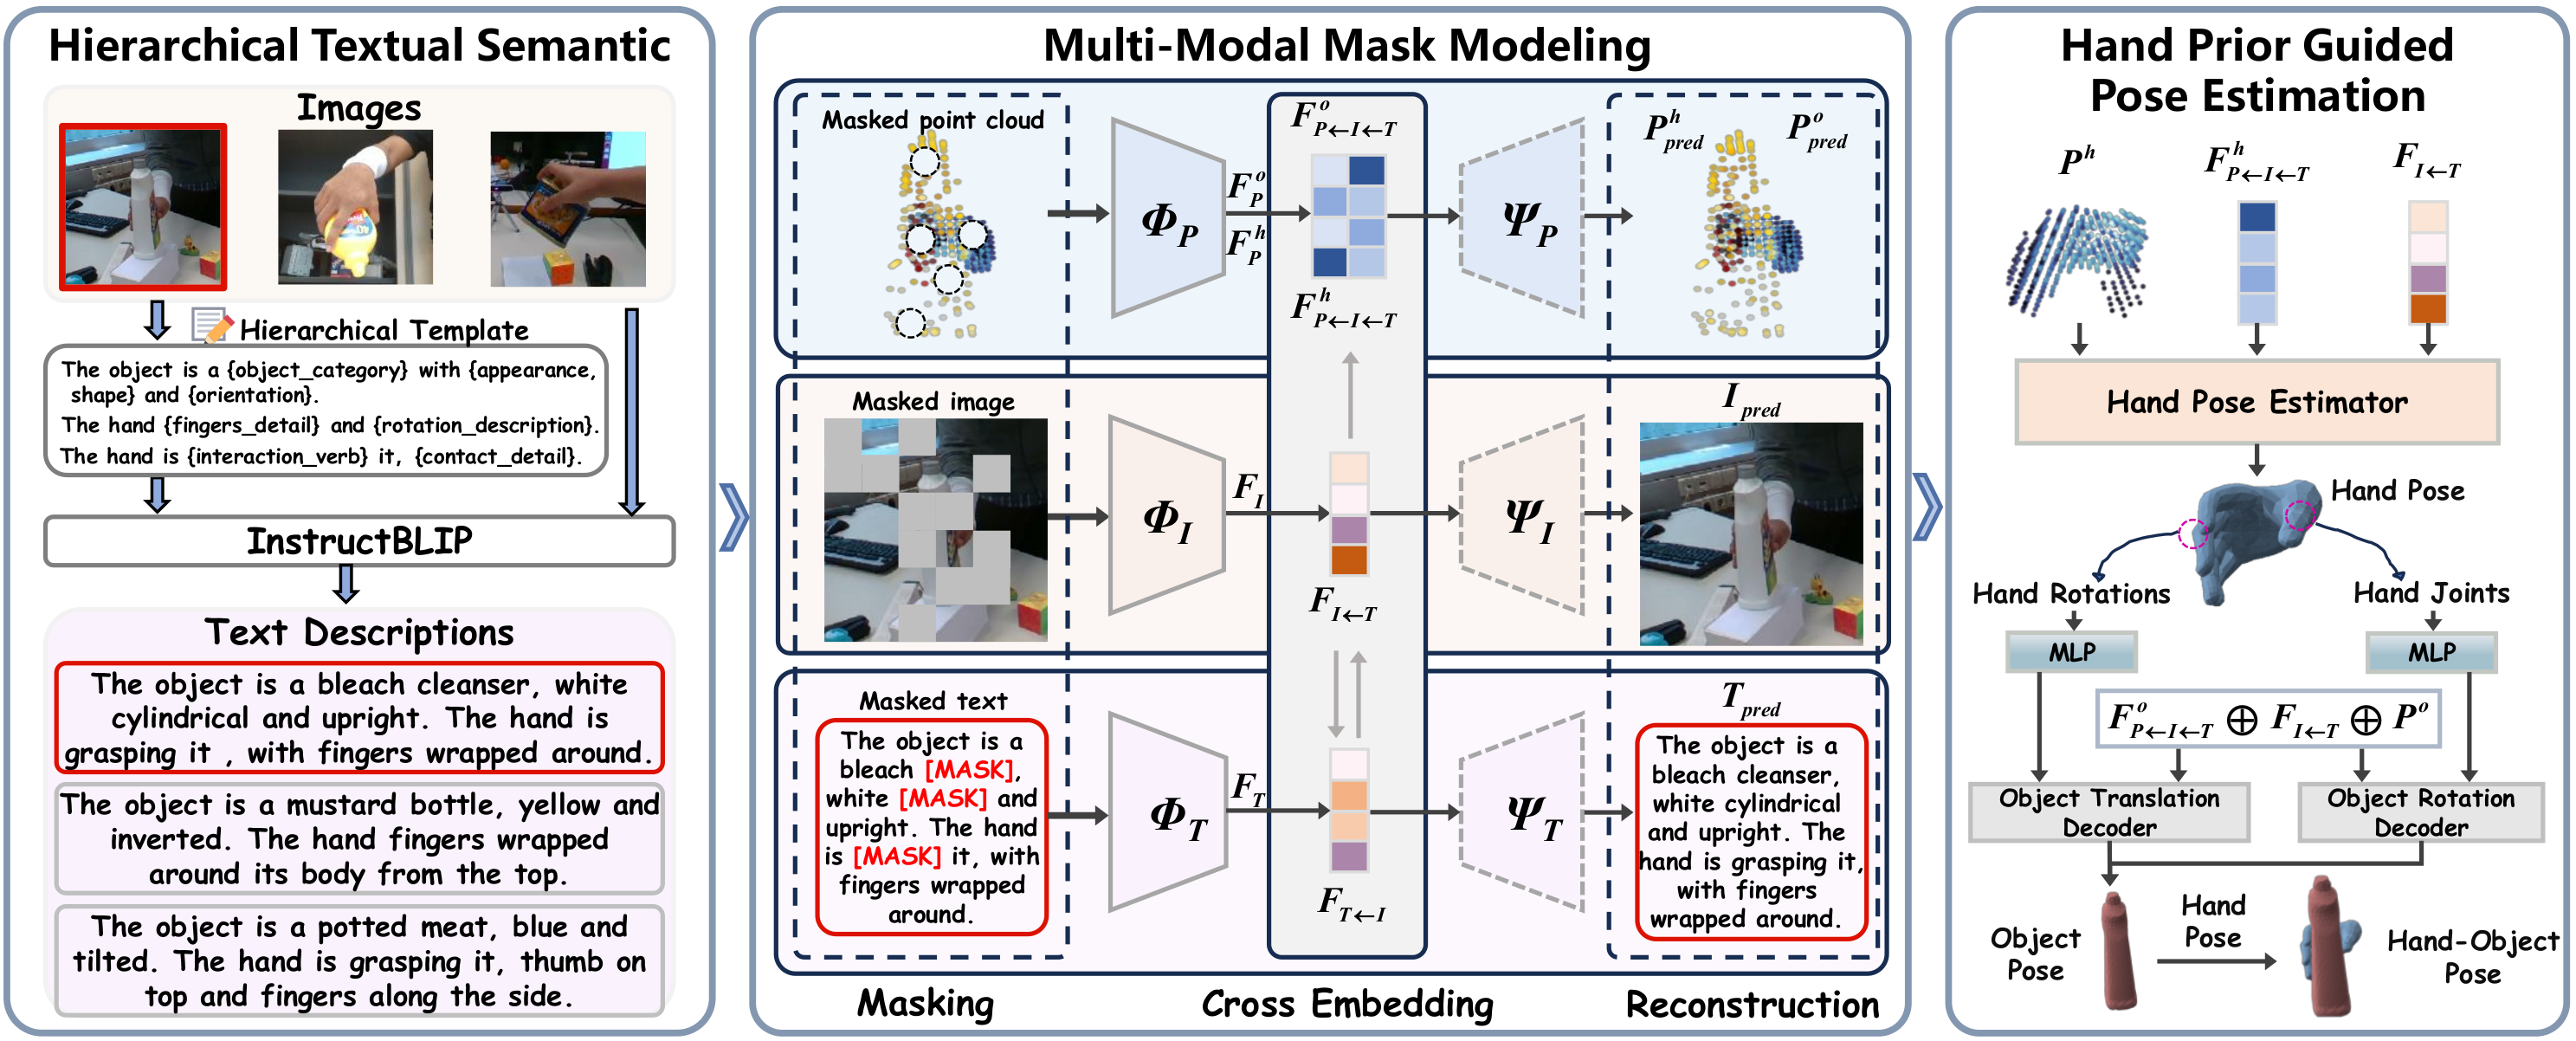
GenHOI 是单帧 RGB 手物联合 3D pose 方法。它先用 InstructBLIP 根据层次模板生成对象、手和交互描述,在训练期对图像、文本、手 / 物点云做三路掩码重建,并按 Text→Image→Point 的顺序建立跨模态表示;随后通过 SDF 聚合预测 MANO 手部参数,把 16 个手关节旋转送入对象 rotation head、21 个 3D 手关节送入 translation head,输出对象 R_obj 与 T_obj。
2.1 我的总体判断
这篇论文最扎实的部分是“模块—假设—消融”能够对应起来:
层次文本移除后,手部与对象指标同时退化;
三类 mask 分别移除后都有退化,适中 mask ratio 优于 0 或过强遮挡;
移除手旋转 / 关节先验对对象 ADD-0.5D 的影响明显大于对手部误差的影响,符合“手约束对象”这一设计目的;
补充材料主动给出完整遮挡失败案例,说明语言和手先验仍无法替代真实观测。
最强结果是 DexYCB S3 三个未见对象上的对象 pose:平均 ADD-0.5D 报告值 89.34,显著高于 UniHOPE 43.06;ADD-S 为 21.76 mm,而 HOISDF 为 84.04 mm。这个差距大到值得进一步复现,而不应只被当作普通的 1–3 点改进。
论文的证据边界也很明确:
generalized 主要由 DexYCB S3 的 3 个 held-out YCB objects 与 HO3Dv2 的 1 个 unseen object 支撑,不等于开放世界跨类别泛化;
occlusion-aware 主要来自训练增强、组件消融和手部遮挡分桶,缺少对象 pose 按遮挡率的 full-vs-ablation 完整闭环;
RGB-only 指外部传感器输入,但内部点云并非凭空存在:训练来自 GT mesh,推理来自图像引导的 voxel-grid sampling;
18 FPS 把文本预生成放到离线,不是包括 InstructBLIP 的端到端在线速度;
作者在 HO3Dv2 正文称“across all metrics”领先,但 PA-MJE 9.9 mm 实际不及 8.9 mm 的 HFL-Net / LCP;DexYCB S3 手部四项也都略逊于 UniHOPE。
因此,GenHOI 应被评价为:对象 pose 泛化结果非常强、设计思路有针对性,但任务规模、预处理、文本成本与复现透明度仍不足以支持无限外推的手物基础模型。
2.2 证据地图
论文主张 主要证据 证据强度 本站判断 未见对象泛化 DexYCB S3 Tables 1–2;HO3Dv2 Table 4 中等 数字很强,但只有 3+1 个未见 YCB 对象 遮挡鲁棒 DexYCB Table 3;主文 Table 6;补充 Tables C–G 中等 支持“与强 baseline 接近”和“mask 有效”,不支持完整遮挡已解决 层次语义有效 Table 6 文本消融;Supplement Table H / I 较强 有组件、模板和噪声三层证据;仍缺真实 caption 错误率分析 手先验帮助对象 Table 6 rows 6–7 较强 对象指标下降 4.99 / 6.43 点,手部指标仅小幅下降,方向一致 所有指标 SOTA DexYCB / HO3Dv2 主表 不成立 多项手部指标不是第一,正文存在过度表述 可实时部署 18 FPS、292 MB、5109 MB 较弱 文本离线生成,且“参数量 292 MB”单位表述错误
原论文 Figure 2:左侧从 RGB 和层次模板生成文本;中间以训练期掩码重建学习图像、文本与几何的互补表示;右侧先恢复手部,再将手旋转和关节位置分别用于对象旋转、平移。虚线框表示 masking / reconstruction 不在推理期执行。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 任务定义:先把“pose”说清楚
3.1 输入
论文抽象上写单张 RGB I∈R^(3×H×W),补充材料进一步说明:图像先围绕对象裁剪,再缩放为 224×224。这意味着方法默认已经知道目标对象的大致区域。正文没有给出 detector、box 来源与 box-noise 实验,所以不能把结果等价为“从任意完整场景 RGB 端到端找出对象并估计 pose”。
模型内部还有两种派生输入:
文本 T:InstructBLIP 根据图像和固定层次模板生成;
手 / 对象点云 P^h, P^o:训练时从真值网格采样,推理时从图像特征引导的 voxel grid 动态采样。
因此“RGB-only”描述的是外部传感器接口,不代表网络只处理二维 feature,也不代表训练不使用三维真值。
3.2 输出
手部输出是 MANO 参数:
θ∈R^(16×3):16 个关节的旋转参数;α∈R^10:手形状系数;经 MANO 恢复 21 个 3D hand joints J∈R^(21×3) 与手网格。
对象输出是:
R o b j ∈ R 3 × 3 , T o b j ∈ R 3 , R_{obj}\in\mathbb{R}^{3\times3},\qquad T_{obj}\in\mathbb{R}^{3}, R o bj ∈ R 3 × 3 , T o bj ∈ R 3 , 即完整旋转矩阵与三维平移。论文没有输出对象尺度,因此不是 NOCS 类 9DoF pose + size;也没有对象 mesh reconstruction head 作为最终任务,点云 reconstruction 是训练辅助目标。
3.3 坐标与对象协议
论文以 DexYCB / HO3Dv2 的 YCB object coordinate 和 evaluator 为准,但没有像 BOP 方法那样详细讨论 object-frame convention、对称集合、可见 mask 与检测阶段。对象误差采用 ADD-S、OME、OCE / MCE 等 hand-object 文献常用协议。
这里有两个复现风险:
ADD-0.5D 在正文被定义为 ADD 小于 50% object diameter 的预测比例,但 Table 1 又写成 mAP / AUC of ADD-0.5D,术语不统一;对称物体是否对每项指标都用 closest-point 或对称等价旋转,正文没有逐项展开,只能沿官方 benchmark evaluator 实现核验。
3.4 与本站 object pose 主线的关系
它输出对象 6D pose,因此值得收录;但方法将手部状态作为必要上下文,任务、数据与指标均不是 object-only。本站把它作为 ECCV 2026 扩展阅读而不计入 14 篇核心 object-pose 数量,避免以下错误比较:
与 BOP 中输入 CAD + RGB-D 的任意物体方法直接比较;
与类别级 NOCS 9DoF pose + size 方法直接比较;
把手部 MJE 与 object-only 方法的 ADD / BOP AR 混在一个排行榜;
把单帧交互 crop 的结果外推到完整场景多对象检测。
4. 研究脉络与真正的新意
手物联合 pose 方法通常有两条路线:直接回归手与对象参数,或先找手 / 物 keypoints 再恢复姿态。直接回归容易依赖外观;keypoint 路线在遮挡时丢失对应。HOISDF 等工作已经把隐式几何 / SDF 用于手物联合建模,UniHOPE 则专门处理手遮挡。
GenHOI 没有替换 MANO、SDF 或直接 regression 的基本框架,而是增加三类先验:
语义先验 :语言提供类别、外观、方向、手指与接触关系;缺失信息训练 :通过跨模态 mask / reconstruction 让模型不只记可见局部;结构先验 :手的拓扑和动作范围比任意对象形状稳定,用手状态限制对象 pose。
这里真正可迁移的思想不是“用一个 VLM 就能解决遮挡”,而是把不同先验安排到不同层级:语言先对齐视觉,再指导内部几何;手 pose 先估计,再作为对象 pose 的显式输入。它比简单把 CLIP token 拼接到最后一层更有结构,但也把错误传播链拉长了。
5. 完整 pipeline
5.1 Step 0:对象 crop 与两套几何来源
补充材料只说 crop around the object,没有说明训练 / 测试 box 是 GT、由哪个 detector 提供,或 margin 如何设定。复现时至少需要固定:
box 来源与扩张比例;
resize 后是否保持长宽比;
hand 超出 object box 时如何处理;
相机内参与坐标是否随 crop / resize 更新;
同一 box 是否提供给比较方法。
训练点云直接从 GT hand / object meshes 采样,因而具有理想表面支持;推理按 HOISDF / occlusion-aware 先前方法,从 voxel grid 上根据图像 feature 动态选择 3D points。正文明确说 inference 不需要 GT meshes,但没有给出 voxel 范围、采样阈值、点的初始坐标来源与单独误差统计,这会是复现中最难补齐的部分之一。
5.2 Step 1:构造层次 prompt
模板由三段组成:
T = [ s o , s h , s i ] . \mathcal T = [s_o, s_h, s_i]. T = [ s o , s h , s i ] .
s_o:the object is a {object_category} with a {shape, appearance}, and {orientation_description};s_h:the hand {fingers_detail} and {rotation_description};s_i:the hand is {interaction_verb} it, {contact_detail}。
把 I 与 T_template 交给生成器 G:
T = G ( I , T ) . T=\mathcal G(I,\mathcal T). T = G ( I , T ) . 层次化的意义在于分别编码“对象是什么 / 朝哪边”“手怎么弯 / 怎么转”“两者怎样接触”,不只提供一个 YCB class name。Supplement Table H 支持这种设计:
模板配置 MJE ↓ ADD-0.5D ↑ object only 14.52 88.56 hand only 13.98 87.15 interaction only 13.82 89.27 去掉 YCB category tokens 13.45 90.22 full template 13.42 90.44
interaction-only 的对象指标高于 object-only / hand-only,说明关系描述确实有价值;去掉显式类别 token 几乎不变,说明增益不是简单把 GT class ID 泄漏给 pose head。不过 full template 对 PA-MJE / PA-V-PE 并非逐项最好:无 category token 时 5.78 / 5.61,full 为 5.81 / 5.63。这种极小差异不改变总体结论,但提醒我们不要把“所有子指标都由 full 最优”写成事实。
5.3 Step 2:图像目标中心掩码
图像 mask 由 hand-object 区域与背景区域共同组成:
M I = M h o ( ⌊ α N I ⌋ ) ∪ M b g ( N I − ⌊ α N I ⌋ ) , M_I=M_{ho}(\lfloor\alpha N_I\rfloor)\cup M_{bg}(N_I-\lfloor\alpha N_I\rfloor), M I = M h o (⌊ α N I ⌋) ∪ M b g ( N I − ⌊ α N I ⌋) , I ~ = ( 1 − M I ) ⊙ I + M I ⊙ N ( 0 , σ 2 ) . \tilde I=(1-M_I)\odot I + M_I\odot\mathcal N(0,\sigma^2). I ~ = ( 1 − M I ) ⊙ I + M I ⊙ N ( 0 , σ 2 ) . 最终配置 N_I=12, α=50%。它没有只把对象框随机打洞,而是保留一部分背景 mask,以防模型只在前景局部学习一种固定遮挡模式。
Supplement Table D 给出明显的倒 U 型:
0%:MJE 15.33,ADD-0.5D 87.65;
25%:14.15 / 88.17;
50%:13.42 / 90.44;
75%:15.48 / 87.95;
100%:16.75 / 85.68;
整个 bounding box 全遮:24.86 / 73.21。
这支持“适度模拟缺失有益”,同时直接否定“越遮越能学会完整遮挡”的朴素想法。训练增强仍需要足够可见结构作为条件。
5.4 Step 3:点云局部掩码
手点云划分为 K 个局部 patch,对随机索引集合 K^h 置零;对象点云同理。最终设置:
N_H=600 hand points;N_O=200 object points;K=64 groups;β=30% masked groups。
Supplement Table F:0 / 30 / 50 / 70 / 100% point mask 的 ADD-0.5D 为 87.90 / 90.44 / 82.23 / 71.19 / 54.93。高比例时几何支路崩溃很快,说明该模块学习的是带缺口的几何补全,而不是从纯文本 / 图像独立重建任意三维结构。
5.5 Step 4:文本 token 掩码
对长度 L 的描述随机选择 token positions,将其替换为 [MASK]。最终 γ=50%。Supplement Table E 的 0 / 25 / 50 / 75 / 100% 对象指标为 88.12 / 88.75 / 90.44 / 84.05 / 79.21。50% 最好,高比例同样破坏上下文。
5.6 Step 5:编码、跨模态顺序与重建
三路 encoder 输出:
image feature F_I∈R^(H_I×W_I×768);
point feature F_P∈R^(N_P×768);
text feature F_T∈R^(L_T×512)。
先做视觉 query 对文本 key / value 的 cross-attention:
F I ← T = Softmax ( Q I K T ⊤ d ) V T , F_{I\leftarrow T}=\operatorname{Softmax}\left(\frac{Q_IK_T^\top}{\sqrt d}\right)V_T, F I ← T = Softmax ( d Q I K T ⊤ ) V T , 并对称得到 F_(T←I)。之后:
ψ_I(F_(I←T)) 重建图像;ψ_T(F_(T←I)) 重建文本;语义增强视觉再与手 / 对象 point features cross-attention;
ψ_P 重建手 / 物点云。
为什么不是先 text-to-point?作者认为文本是抽象语义,point feature 是局部几何,中间缺少视觉 grounding。Supplement Table G 支持该顺序:
融合顺序 MJE ↓ ADD-0.5D ↑ Text→Point→Image 14.27 87.18 Text→Image 与 Text→Point 并行 13.76 88.76 Text→Image→Point 13.42 90.44
需要指出,论文公式中个别下标出现 F_(P←I←S) 与 F_(P←I←T) 混用,S 没有在这一段定义,像是排版 / 符号笔误。复现应以 Figure 2 和文字所述 Text→Image→Point 为准,而不能机械照抄每个下标。
5.7 Step 6:SDF 引导的手部估计
对 hand points 做 Fourier positional encoding,与语义增强视觉特征和原坐标拼接:
S D F h = M L P S D F ( γ ( P h ) ⊕ F I ← T ⊕ P h ) . SDF_h=MLP_{SDF}(\gamma(P_h)\oplus F_{I\leftarrow T}\oplus P_h). S D F h = M L P S D F ( γ ( P h ) ⊕ F I ← T ⊕ P h ) . 对象 SDF_o 同理。SDF 权重让聚合更关注 surface-near points。聚合特征经 hand Transformer / MLP 回归:
( { θ i } i = 1 16 , α ) = M L P h ( T r a n s f o r m e r h ( F a g g h ) ) . (\{\theta_i\}_{i=1}^{16},\alpha)=MLP_h(Transformer_h(F^h_{agg})). ({ θ i } i = 1 16 , α ) = M L P h ( T r an s f or m e r h ( F a g g h )) . 这里的手先验不是预先输入 GT hand pose,而是模型先根据当前图像 / 几何预测,再提供给对象 head。因此它避免了推理期 GT hand dependency,却引入显式 error propagation:手的旋转或 3D joints 错,物体旋转 / 平移会跟着错。
5.8 Step 7:手先验引导对象 pose
对象特征 F^o_agg 分别与两种手信息融合:
R o b j = M L P R ( F a g g o ⊕ P o o l ( ϕ r o t ( { θ i } 1 16 ) ) ) , R_{obj}=MLP_R\left(F^o_{agg}\oplus Pool(\phi_{rot}(\{\theta_i\}_{1}^{16}))\right), R o bj = M L P R ( F a g g o ⊕ P oo l ( ϕ r o t ({ θ i } 1 16 )) ) , T o b j = M L P T ( F a g g o ⊕ P o o l ( ϕ p o s ( J ) ) ) . T_{obj}=MLP_T\left(F^o_{agg}\oplus Pool(\phi_{pos}(J))\right). T o bj = M L P T ( F a g g o ⊕ P oo l ( ϕ p os ( J )) ) . 这个分工具有几何直觉:
手关节旋转编码抓握姿态、指向和局部接触拓扑,更适合约束对象 orientation;
3D hand joints 提供空间位置与尺度关系,更直接约束对象 translation。
它仍是 learned regression,而非利用接触方程、碰撞约束或 differentiable rendering 显式求解。因而“hand prior”更准确地说是可学习的条件特征,不是硬物理约束。
5.9 Step 8:联合损失
L = λ 1 L r e c + λ 2 L t e x t + λ 3 L p c + λ 4 L m a n o + λ 5 L o b j + λ 6 L S D F + λ 7 L o t h e r s . \mathcal L=\lambda_1L_{rec}+\lambda_2L_{text}+\lambda_3L_{pc}
+\lambda_4L_{mano}+\lambda_5L_{obj}+\lambda_6L_{SDF}+\lambda_7L_{others}. L = λ 1 L r ec + λ 2 L t e x t + λ 3 L p c + λ 4 L man o + λ 5 L o bj + λ 6 L S D F + λ 7 L o t h er s . 前六个权重均为 1,λ7 按 HOISDF 设置。图像重建、点云重建、SDF、MANO 和 object pose 用 L1;文本用 token cross-entropy;L_others 直接引用 HOISDF 的 task-specific constraints。论文没有在正文把 L_others 完整展开,这是独立复现必须回查 HOISDF 实现的依赖。
6. 训练与推理流程拆解
6.1 训练
根据对象区域裁剪 RGB 至 224×224;
用 GT hand / object meshes 采样 600 / 200 points;
由 InstructBLIP 填充层次模板,并加入文本扰动;
对图像、点云和文本分别施加 50% target allocation、30% groups、50% tokens 的 mask;
按 Text→Image→Point 做跨模态融合与三路重建;
预测 hand / object SDF,聚合表面特征;
回归 MANO 与 hand joints;
把 hand rotations / joints 注入 object heads;
用七组损失联合优化。
训练设置:PyTorch、单张 RTX 4090、Adam、batch size 24、初始学习率 1e-4、每 5 epochs 乘 0.7,两个数据集均训练 60 epochs。
6.2 推理
推理不再 mask,也不执行 reconstruction loss。论文描述的实际路径是:
读取 object-centered RGB;
取得预生成层次文本;
用 image-guided voxel sampling 形成 hand / object geometric points;
执行跨模态融合、SDF、hand pose 与 object pose heads;
输出 MANO 与 [R_obj,T_obj]。
速度报告必须注明文本离线:18 FPS 不包含 InstructBLIP 的生成过程。若真实系统每帧都重新生成长文本,吞吐与延迟将明显不同;若对视频只生成一次,又需要定义文本何时更新以及如何处理交互变化。论文是单帧评测,没有回答这一部署选择。
6.3 模型规模表述
补充材料写“parameter count remains moderate at 292 MB”。这是单位混淆:参数个数应以 M / B parameters 表示,MB 更像权重文件占用。本站因此记录为“约 292 MB 模型规模”,不改写为 292M parameters。另报告显存约 5109 MB,但缺少输入 batch、精度模式和是否包含离线 VLM 的详细口径。
7. 数据、划分与泛化含义
7.1 DexYCB
DexYCB 有 582K images、1000+ sequences、10 subjects 和 20 YCB objects。
S0:8 人训练、2 人测试;测试 subject 与 interaction patterns 未见,但对象见过。
S3:15 个对象训练,3 个对象留出;未见对象为 gelatin_box、bleach_cleanser、wood_block。
S3 主表跟随 UniHOPE,只评 hand-object interaction frames。
Table 6 ablation 明确使用 S3 split full 的全部 frames。
最后一点解释了为什么 full ablation 的完整模型 ADD-0.5D 是 90.44,而主结果平均为 89.34:两者评测子集不同,不应当作同一 protocol 下的重复实验差异。
7.2 HO3Dv2
HO3Dv2 有 77K images、68 sequences、10 subjects 和 10 YCB objects。官方 test 中只有一个 unseen object 019 pitcher base,作者向 evaluation server 提交结果。
这个设置能证明方法不完全依赖每个训练对象,但单个对象不足以支撑广义“cross-category”统计稳定性。特别是文本生成器很可能认识日常 pitcher 类别,模型在真正罕见类别、工业件或非 YCB shape 上的表现仍未知。
7.3 指标
手 / 网格:MJE、PA-MJE、ST-MJE、V-PE / MME、J / V-AUC、F@5、F@15 及 Procrustes-aligned variants。
对象:
OCE:object center error;
MCE:mean corner error;
OME:object mesh error;
ADD-S:最近点平均距离,适合有对称歧义的表面距离;
ADD-0.5D:正文定义为 ADD 小于对象直径 50% 的预测比例。
0.5D 是相对宽松阈值,且 Table 1 又称其 AUC / mAP。因而最可信的对象大幅提升证据不是只看 89.34,而是同时看 Table 2 的 ADD-S 21.76 mm;两个不同口径都指向明显改善。
8. 主结果逐表审阅
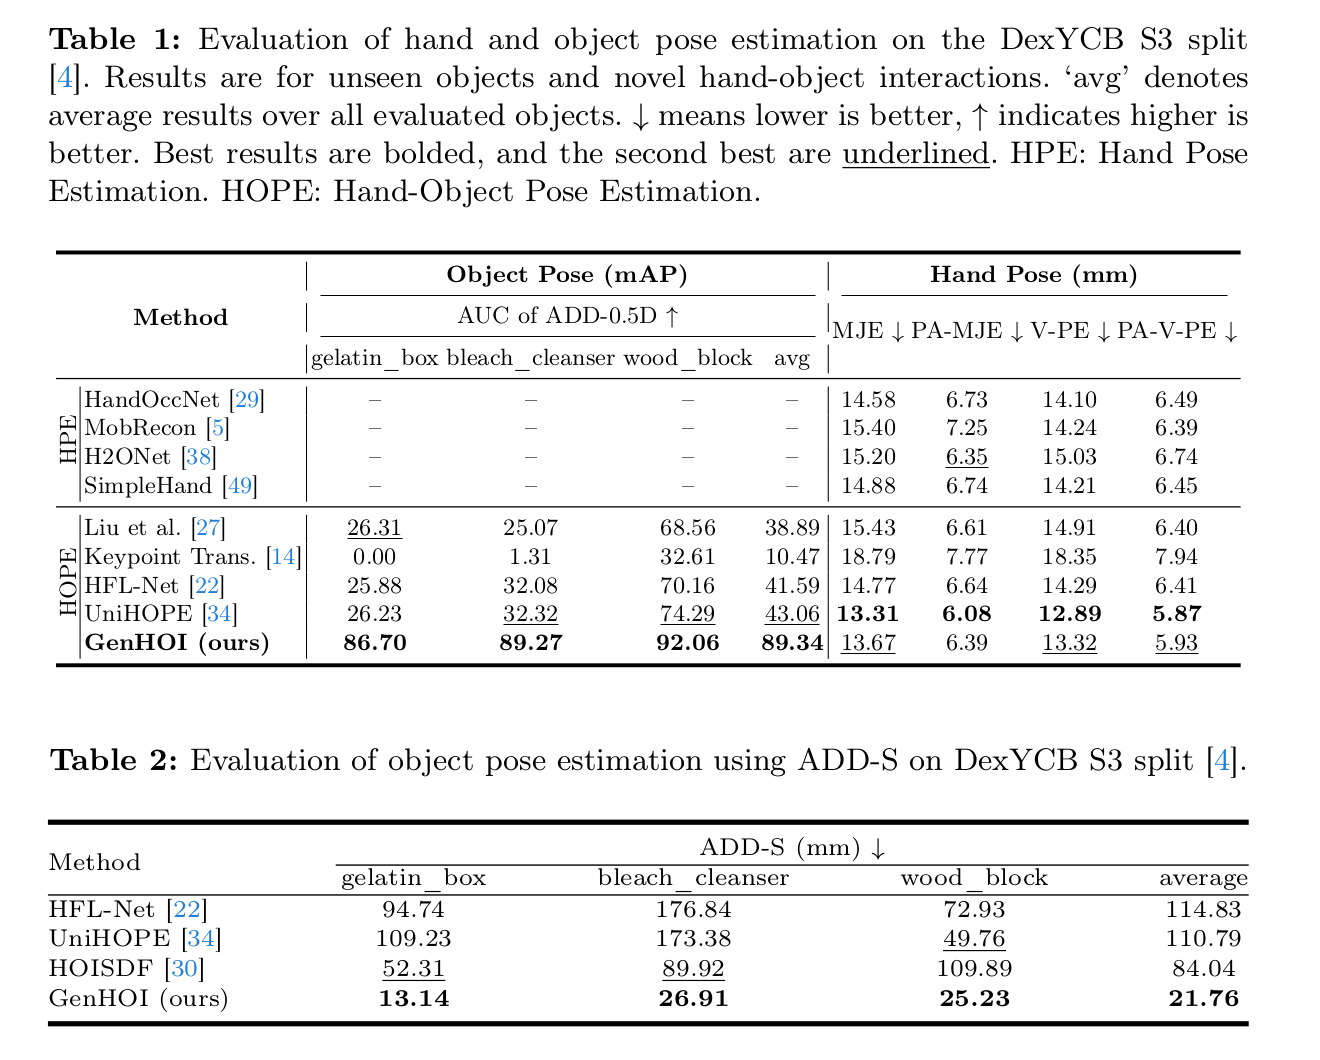
原论文 Tables 1–2:对象 ADD-0.5D 与 ADD-S 都显示 GenHOI 的巨大优势;同一表也清楚显示 UniHOPE 的四项手部指标略优,故正确表述是“对象明显领先、手部接近最强方法”。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
8.1 DexYCB S3 对象 pose
ADD-0.5D:
方法 gelatin_box bleach_cleanser wood_block avg Liu et al. 26.31 25.07 68.56 38.89 HFL-Net 25.88 32.08 70.16 41.59 UniHOPE 26.23 32.32 74.29 43.06 GenHOI 86.70 89.27 92.06 89.34
ADD-S:
方法 gelatin_box bleach_cleanser wood_block avg ↓ HFL-Net 94.74 176.84 72.93 114.83 mm UniHOPE 109.23 173.38 49.76 110.79 mm HOISDF 52.31 89.92 109.89 84.04 mm GenHOI 13.14 26.91 25.23 21.76 mm
两个表的方向一致,尤其 bleach_cleanser 从 89.92 / 173.38 mm 降到 26.91 mm。这支持新模块对对象 pose 有实质作用。但差距远大于常见同框架增量,需要优先核验以下公平性:
是否所有 baseline 都按相同 S3 interaction-frame subset 重新训练 / 评测;
未见对象 mesh / category token / crop 是否对所有方法同等可用;
ADD-0.5D 的 AUC / mAP 实现是否完全一致;
predicted point-cloud pipeline 是否沿用 HOISDF 预训练或额外监督;
文本是否离线使用了 test image 本身,而 baseline 没有等价外部预训练先验。
这不是说结果不可信,而是当前无代码时,表格只能证明“论文报告了大幅提升”,尚不能证明每个来源已经被独立复现。
8.2 DexYCB S3 手部 pose
方法 MJE ↓ PA-MJE ↓ V-PE ↓ PA-V-PE ↓ UniHOPE 13.31 6.08 12.89 5.87 GenHOI 13.67 6.39 13.32 5.93
GenHOI 四项均第二或接近第二。论文正文用“competitive hand pose accuracy”是准确的;摘要泛称 hand-object SOTA 时则需要结合对象 / 手部分开理解。
8.3 遮挡分桶
在 25–50% 遮挡,UniHOPE 的 14.59 / 6.39 / 14.13 / 6.17 全部优于 GenHOI 14.75 / 6.49 / 14.36 / 6.23。
在 50–75% 遮挡:
GenHOI J-PE 16.18、PA-V 6.25 更好;
UniHOPE PA-J-PE 6.51、V-PE 15.78 更好。
在 75–100% 遮挡:
GenHOI J-PE 26.28、PA-J-PE 7.55 更好;
UniHOPE V-PE 25.51、PA-V 7.40 更好。
这证明重遮挡时没有明显崩溃,相对专门带 hand-occlusion removal 的 UniHOPE 很接近;但它不是统一统治所有遮挡指标。更遗憾的是主文 Table 3 只有手部指标,没有对象 ADD-S / OME 按遮挡率分桶,而论文创新的重要目标恰恰是手先验帮助被遮挡对象。
8.4 HO3Dv2
unseen 019 pitcher base 的 ADD-0.5D:HFL-Net 24.1、HOISDF 88.4、GenHOI 92.7。相对 HOISDF 是 4.3 点提升,而非 DexYCB S3 那种翻倍,说明泛化优势会随数据 / 对象改变。
seen-object Table 5:
指标 GenHOI 表中最优对照 是否最好 MJE 21.3 HOISDF 23.6 是 ST-MJE 21.1 HOISDF 22.8 是 PA-MJE 9.9 HFL-Net / LCP 8.9 否 OME 35.9 HOISDF 48.5 是 ADD-S 13.4 HOISDF 17.8 是
因此“lowest hand and object pose errors across all metrics”不成立。更准确的结论是:未对齐的 hand error 与两个 object errors 最好,刚体 / Procrustes 对齐后的 hand pose 仍落后 1.0 mm。
8.5 DexYCB S0 补充结果
Table A:GenHOI 的 MJE 9.83、PA-MJE 5.12、OCE 17.2、MCE 25.1、ADD-S 12.3 mm,均优于表中可比较数字。Table B 的 aligned 与 unaligned hand mesh 多数最好;J-AUC 80.7 与 HOISDF 80.7 并列。
S0 说明方法在 seen objects 上也不只为 S3 特化。但 S0 与 S3 的对象集合、frame selection 和训练 protocol 不同,不能用 S0 数字替代 S3 泛化论证。
9. 消融:哪些模块真的贡献最大
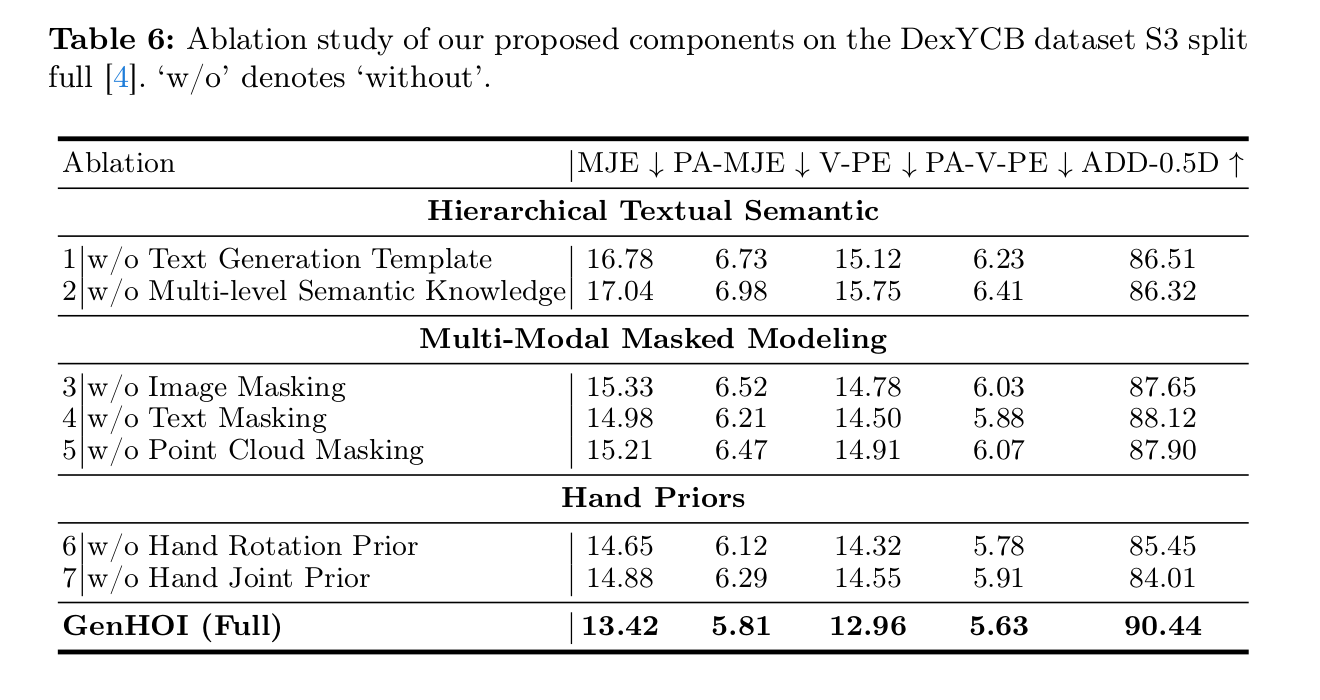
原论文 Table 6:完整模型与七种移除配置在 DexYCB S3 full 上的对照。手先验移除对对象 ADD-0.5D 的影响最大,而层次语义移除同时明显伤害手与物;三类 mask 的贡献方向一致。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
完整模型:MJE 13.42、PA-MJE 5.81、V-PE 12.96、PA-V-PE 5.63、ADD-0.5D 90.44。
9.1 文本组件
w/o text generation template:16.78 / 6.73 / 15.12 / 6.23 / 86.51;
w/o multi-level semantic knowledge:17.04 / 6.98 / 15.75 / 6.41 / 86.32。
MJE 退化 3.36–3.62 mm,比单独移除任何一类 mask 或 hand prior 更大。说明“结构化语义”对手部也有较强贡献,而不是只服务对象类别识别。
不过这里的 baseline 定义仍需代码确认:w/o Text Generation Template 与 w/o Multi-level Semantic Knowledge 分别保留哪些自由文本、encoder 和 attention,正文没有用伪代码精确列出。若一个配置移除完整文本生成,另一个只去掉分层结构,它们并不是正交因素。
9.2 三类 mask
相对 full:
去 image masking:MJE +1.91 mm,ADD -2.79;
去 text masking:MJE +1.56 mm,ADD -2.32;
去 point masking:MJE +1.79 mm,ADD -2.54。
三者幅度接近,image 最大。更完整的 ratio tables 显示 0-mask 不等于没有对应模态,而是保留 encoder / fusion、只取消 masking training;因此这些表衡量的是自监督破坏—重建策略,而不是 image / text / point modality 的存在性。
9.3 手先验
去 hand rotation prior:MJE +1.23 mm,ADD -4.99;
去 hand joint prior:MJE +1.46 mm,ADD -6.43。
对象指标下降远大于手部,这与 rotation / translation heads 的设计一致。3D joint prior 比 rotation prior 对 ADD-0.5D 更重要,可能因为 ADD 同时高度受 translation 影响;论文没有把 rotation error 与 translation error 拆开,因此无法进一步判断两条支路是否分别只改善对应分量。
9.4 遮挡条件下的组件消融
Supplement Table C 按 Table 6 的编号 1–7,给出三个遮挡区间的手部 + ADD 数字。例如 75–100% 遮挡时:
去文本模板 / 多层语义:ADD 78.70 / 78.10;
去 image / text / point mask:80.65 / 81.45 / 80.95;
去 hand rotation / joint prior:77.40 / 75.85。
趋势仍显示 hand prior 对对象最重要。但 Table C 没有 GenHOI Full 行,无法知道 full model 在同一遮挡分桶的对象 ADD,也无法从该表计算精确 drop。作者文字称“consistent drops”,逻辑上依赖 Table 6 的全帧 baseline,而不是 Table C 自身完全闭环。
9.5 文本与点云噪声
Supplement Table I:
w/o text noise:MJE 14.55、ADD 89.12;
w/o point-cloud noise:14.41、88.53;
full noise:13.42、90.44。
这说明训练扰动有助于缓解 InstructBLIP 描述不稳定与理想 GT-mesh points 到推理 voxel samples 的 gap。但它没有用真实 VLM 错误标注做分桶,也没有报告换另一 VLM、手工修正文本或完全无文本的端到端成本收益。
10. 失败案例:完整遮挡仍是不可观测问题
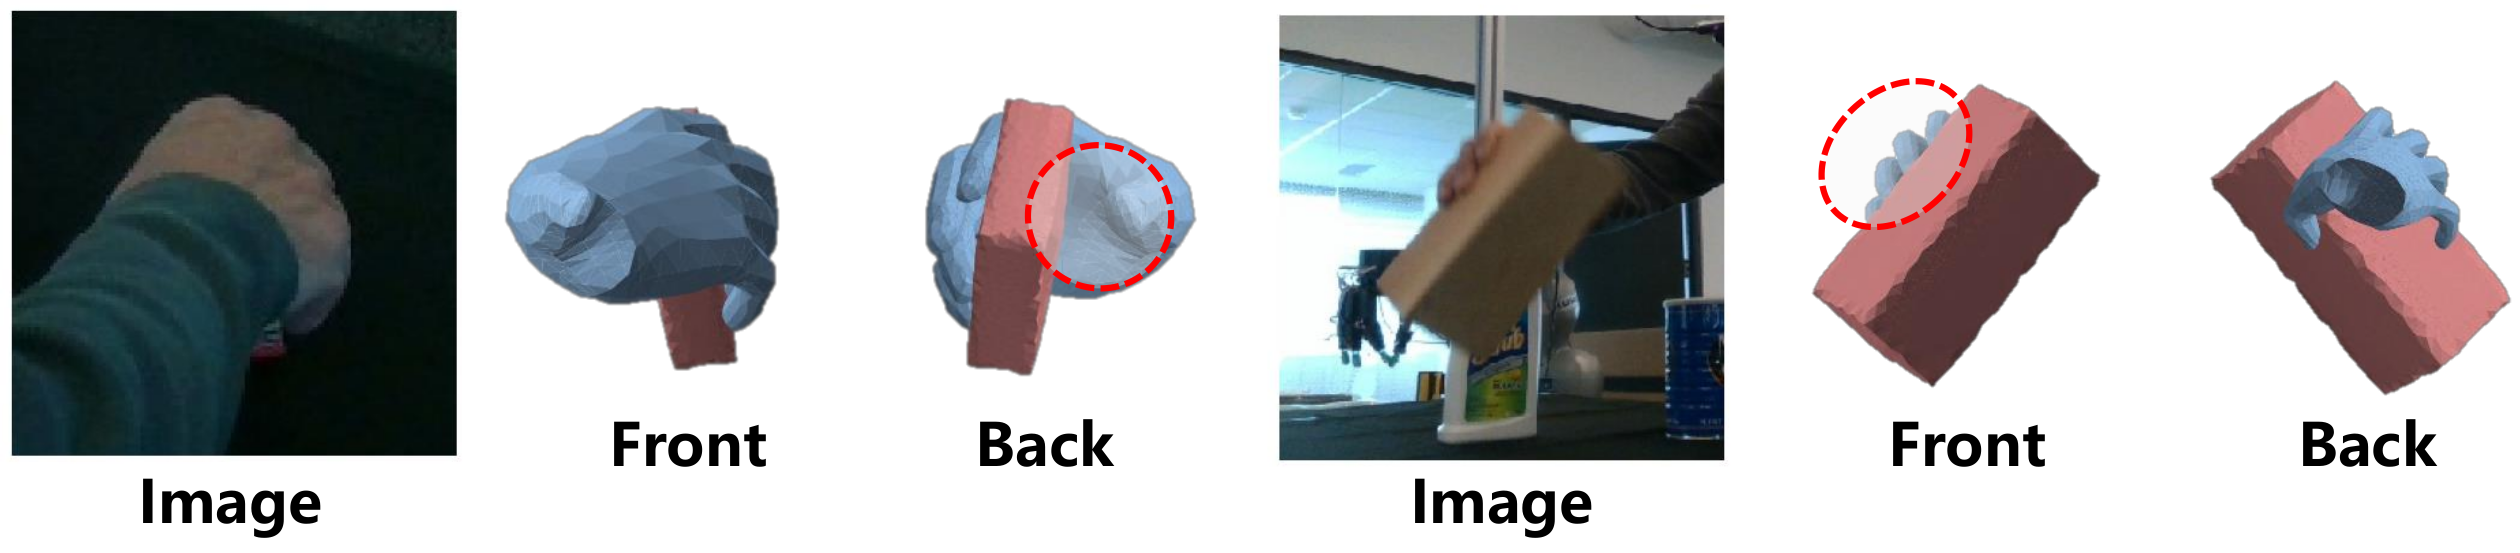
原论文补充材料 Figure C:左例手 / 物外观都缺失较多,右例对象大面积被手遮住;预测 mesh 在红圈处出现不合理接触或相对方向。作者将极端遮挡列为主要限制,并提出未来加入时序、物理 / 运动约束与多视角。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
mask training 让网络学会“从剩余上下文补缺”,但如果对象完全不可见,单帧问题可能有多个符合手形与语言的 pose。此时:
VLM 文本很可能复述可见手势,无法提供被遮对象的精确 metric pose;
hand joints 只能定义一组可行接触关系,无法唯一决定物体绕对称轴的旋转;
predicted point cloud 也由同一 RGB 派生,没有增加独立测量;
所有模态的错误可能相关,而不是独立互补。
作者提出的未来方向是合理的:利用前序 interaction frames 的 temporal cues、物理与运动约束、第三人称 + 第一人称多视角数据和 feature fusion。更进一步,还可显式输出多峰 pose distribution,而不是在不可观测时强制回归单一旋转。
11. 隐含假设与部署风险
11.1 对象区域已知
方法从 object-centered crop 开始。真实系统若 detector box 漏掉手指或对象末端,层次文本、voxel sampling 和 pose head 会同时受影响。没有 box-noise / detector AP 条件实验,端到端性能未知。
11.2 手一定提供有用约束
训练数据主要是单手抓握 YCB objects。若是:
手仅靠近但未接触;
两手同时操作;
物体柔性 / 可动;
工具通过中间部件接触;
手 pose 本身因手套、运动模糊或肤色域差而错误;
手先验可能变成错误条件。论文没有 hand-prior confidence gate,也没有在低置信度时退化为 object-only head。
11.3 语言不是独立传感器
文本由同一 RGB 生成,因此其信息大多是经过 VLM 压缩的图像语义,而非额外观测。它的价值在于预训练知识与结构化表达,但也可能把 VLM 的类别、方向与接触偏差引入 pose。去掉 category token 的消融缓解显式泄漏担忧,却不排除 InstructBLIP 根据外观认出 YCB 类别。
11.4 训练与推理点云不同源
GT mesh points 具有完整、干净、准确表面;voxel points 来自图像特征推断。noise augmentation 只能近似这种 gap。更强证据应包括:
GT points、predicted points 与不使用 points 的同表;
sampling recall / precision 对 pose error 的曲线;
不同遮挡率和对象材质下 point quality;
将训练也切换到 predicted points 的一致性实验。
11.5 泛化对象数量小
三种 DexYCB held-out objects 与一个 HO3Dv2 unseen object 都来自 YCB 日常物品。不能据此推断到长尾工业件、透明物、无纹理对称件或任意开放词汇对象。
11.6 极大提升尚无独立复现
没有代码、配置、caption cache、voxel sampling 细节与完整 evaluator。尤其 DexYCB S3 ADD-S 从 84.04 降到 21.76 mm,需要复现者优先核验 object frame、scale、mesh、symmetry 和 subset。
12. 复现清单
12.1 数据与预处理
获取 DexYCB S0 / S3 和 HO3Dv2 官方 split;
固定只评 interaction frames 还是 S3 full,并在文件名 / 表题中区分;
确认三个 S3 held-out objects 与 019 pitcher base;
记录 object crop 的 box 来源、margin、resize、坐标变换;
准备 hand / object meshes、MANO labels、object pose 与相机参数;
明确对象对称与 ADD-S evaluator。
12.2 文本生成
固定 InstructBLIP checkpoint、prompt template 与 decoding 参数;
将每帧生成文本缓存,确保不同实验使用同一文本;
分开报告离线 caption cost 与在线 pose FPS;
统计 object category、orientation、finger / contact slots 的错误率;
做无文本、GT template fields、自动文本和扰动文本四组对照。
12.3 几何支路
训练采样 hand 600 / object 200 points;
推理实现 image-guided voxel sampling;
固定 voxel volume、resolution、threshold 与坐标系;
验证 predicted points 与 GT mesh points 的尺度一致;
单独报告 point sampling 误差和耗时。
12.4 模型与优化
图像 / 点云 / 文本 feature dims 为 768 / 768 / 512;
image masks 12,目标区域占比 50%;
text mask 50%;point groups 64、mask 30%;
按 Text→Image→Point 顺序实现 cross-attention;
实现 SDF aggregation、MANO head、rotation-hand-prior 与 translation-joint-prior;
前六项 loss weight 为 1,回查 HOISDF 的 L_others 与 λ7;
Adam、batch 24、60 epochs、LR 1e-4、每 5 epochs ×0.7。
12.5 必须复现的 sanity checks
DexYCB S3 interaction-frame Table 1 / 2;
S3 full Table 6,确认 90.44 与主表 89.34 的 subset 差异;
去 hand joint prior 时 ADD-0.5D 是否降到约 84.01;
去 category tokens 是否仍接近 full;
predicted vs GT point cloud 的 pose gap;
端到端包含 InstructBLIP 的真实延迟;
用同一 crop、mesh、evaluator 复跑 HOISDF / UniHOPE;
HO3Dv2 PA-MJE 排名,避免重复“all metrics”错误。
13. 可改进方向
13.1 把语言从离线描述改成可校验结构
当前自由文本既昂贵又可能含糊。可以把三层模板变成结构化 slots,并输出每个 slot 的置信度:对象类别、主轴朝向、可见手指、接触面、抓握类型。pose head 可按置信度 gating,低置信文本不强制注入。
13.2 引入 hand-prior uncertainty
对象 head 目前直接使用预测 hand rotations / joints。更稳妥的方法是同时输出 hand covariance 或多个 hand hypotheses,并对对象 pose 做 uncertainty propagation。若手部不可靠,则自动增加 object-visual branch 权重。
13.3 时序与物理一致性
利用前序可见帧可把完整遮挡从单帧不可观测改成 tracking:
保持 object identity 与上一帧 pose posterior;
加入 SE(3) motion prior;
用手—物接触和穿透损失筛选候选;
在重新出现时做 render / geometry consistency correction。
13.4 多假设对象 pose
对称或完整遮挡时,单一 R_obj 回归会平均多个可行解。可用 SO(3) distribution、diffusion / flow matching 或离散 rotation hypotheses,报告 calibration 与 recall,而不只给 point estimate。
13.5 缩小 train–test geometry gap
训练早期用 GT mesh points,随后逐步混入 predicted voxel points,或用 teacher–student consistency 对齐两种几何。还可显式监督 voxel point confidence,过滤不可靠采样。
13.6 更强泛化评测
应增加:
跨数据集训练 / 测试;
非 YCB、工业、透明 / 反光和强对称物体;
不同 detector / crop noise;
双手、非抓握、工具间接接触;
VLM checkpoint 与文本错误分桶;
对象 pose 按遮挡率而非只看 hand metrics;
included-caption 与 no-caption 的完整延迟 / 能耗比较。
14. 作者声称与本站结论对照
项目 作者表述 本站更谨慎的结论 generalized unseen objects and novel interactions 在两个 YCB 系数据的 3+1 个未见对象上验证,范围有限 occlusion-aware masked modeling + hand priors support severe occlusion 重遮挡手部表现与 UniHOPE 接近,完整遮挡仍失败 SOTA abstract / conclusion 泛称 SOTA 对象多数指标最好;DexYCB S3 手部四项不是最好,HO3Dv2 PA-MJE 也不是最好 RGB input single RGB image 外部是 RGB,但训练用 GT mesh points,推理内部动态采样 point cloud practical runtime 18 FPS 仅 pose pipeline 且 text generated offline;端到端 VLM 延迟未知 moderate parameter count 292 MB 这是存储单位,不是参数个数;不能写成 292M parameters
15. 最终评价
优点
语言、视觉、几何和手结构的连接位置清楚,不是简单 feature concatenation。
对象 rotation 与 translation 分别接入 hand rotations / positions,设计与物理直觉对应。
DexYCB S3 同时给相对阈值和毫米 ADD-S,大幅对象提升并非只由单一指标支撑。
主文和补充材料包含组件、mask ratio、fusion order、template、noise、遮挡分桶与失败案例,实验层次较完整。
明确声明 mask / reconstruction 只在训练期,避免把辅助任务误当成推理成本。
缺点
对象 crop、voxel sampling、L_others 和 evaluator 细节不足,代码未公开。
generalized 只在少量 held-out YCB objects 上验证,缺少跨数据集开放类别证据。
18 FPS 排除文本生成,端到端部署成本不透明。
训练点云来自 GT mesh,推理点云来自图像采样,关键域差距缺少直接对照。
object pose 的遮挡分桶不完整;Supplement Table C 又缺 full row。
正文存在 all metrics 与 Table 5 冲突、292 MB 被称参数量、ADD-0.5D 的 mAP / AUC / threshold terminology 混用等表述问题。
对 6D pose 研究者的启发
GenHOI 最值得借鉴的是:在有交互结构时,不要只把手当遮挡物;手本身是一个稳定、可预测、与对象接触的几何参照。这个思想可以扩展到机器人夹爪、容器、支撑面或装配治具。但真正稳健的系统应同时估计先验置信度、保留多峰对象 pose,并在先验错误时能够退化回独立对象视觉证据。
是否推荐
做 hand-object pose / HOI reconstruction:推荐精读,尤其关注 Table 6 和训练 / 推理点云差异。
做 standard object-only 6D pose:作为交互先验、遮挡训练与语言融合的扩展阅读,不宜直接当同协议 SOTA。
做机器人操作:有启发,但当前没有闭环抓取、时序、物理一致性或真实机器人系统验证。
做复现:应优先等待 / 索取代码;若自行实现,先复核 crop、voxel sampling、caption cache 和 ADD evaluator,再讨论表中巨大差距。