论文精读笔记:GS-Pose: Generalizable Segmentation-Based 6D Object Pose Estimation With 3D Gaussian Splatting
1. 基本信息
2. 一句话定位
GS-Pose 将「新对象的实例级 6D pose」拆成可验证的三段:少量有位姿 reference RGB 产生对象语义、旋转感知描述和 3DGS;query 侧先定位、再检索初始化,最后以可微渲染做 pose refinement。它不是 CAD-free 的无准备方案,而是以 reference capture 取代 CAD 的对象接入方案。
2.1 论文图表导读
| 图表 | 它回答什么 | 阅读重点 |
|---|
| Figure 1 | 新对象如何从 reference views 进入在线 pose pipeline | 三份对象表示分别服务检测、初始化、细化,而非重复堆叠 |
| Table 2 | LINEMOD 上是否真的提升 pose | 要区分无外部 detector 与使用 YOLOv5 的两行,不能混读 |
| Table 3 | refinement 的增益是否独立存在 | OnePose-LowTexture 从 init 到 refined 的差值最直接说明 GS-Refiner 的作用 |
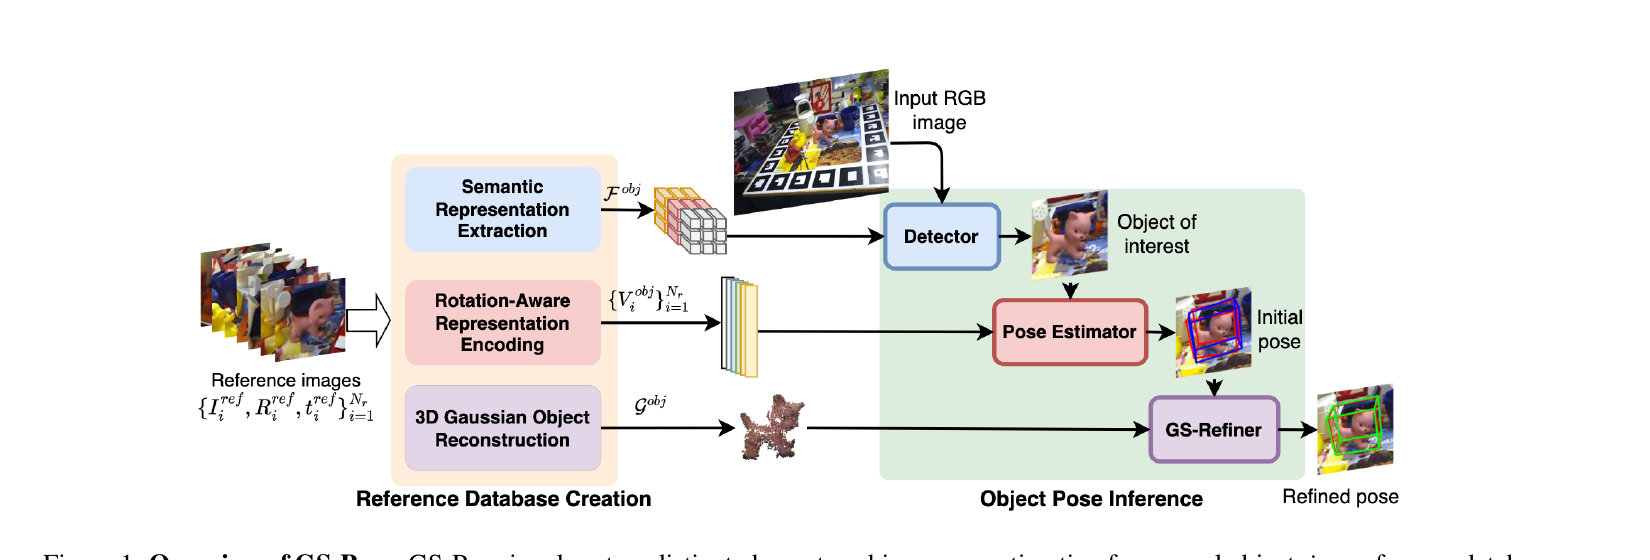 原论文 Figure 1:离线对象库创建与在线对象位姿推理。来源:arXiv PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
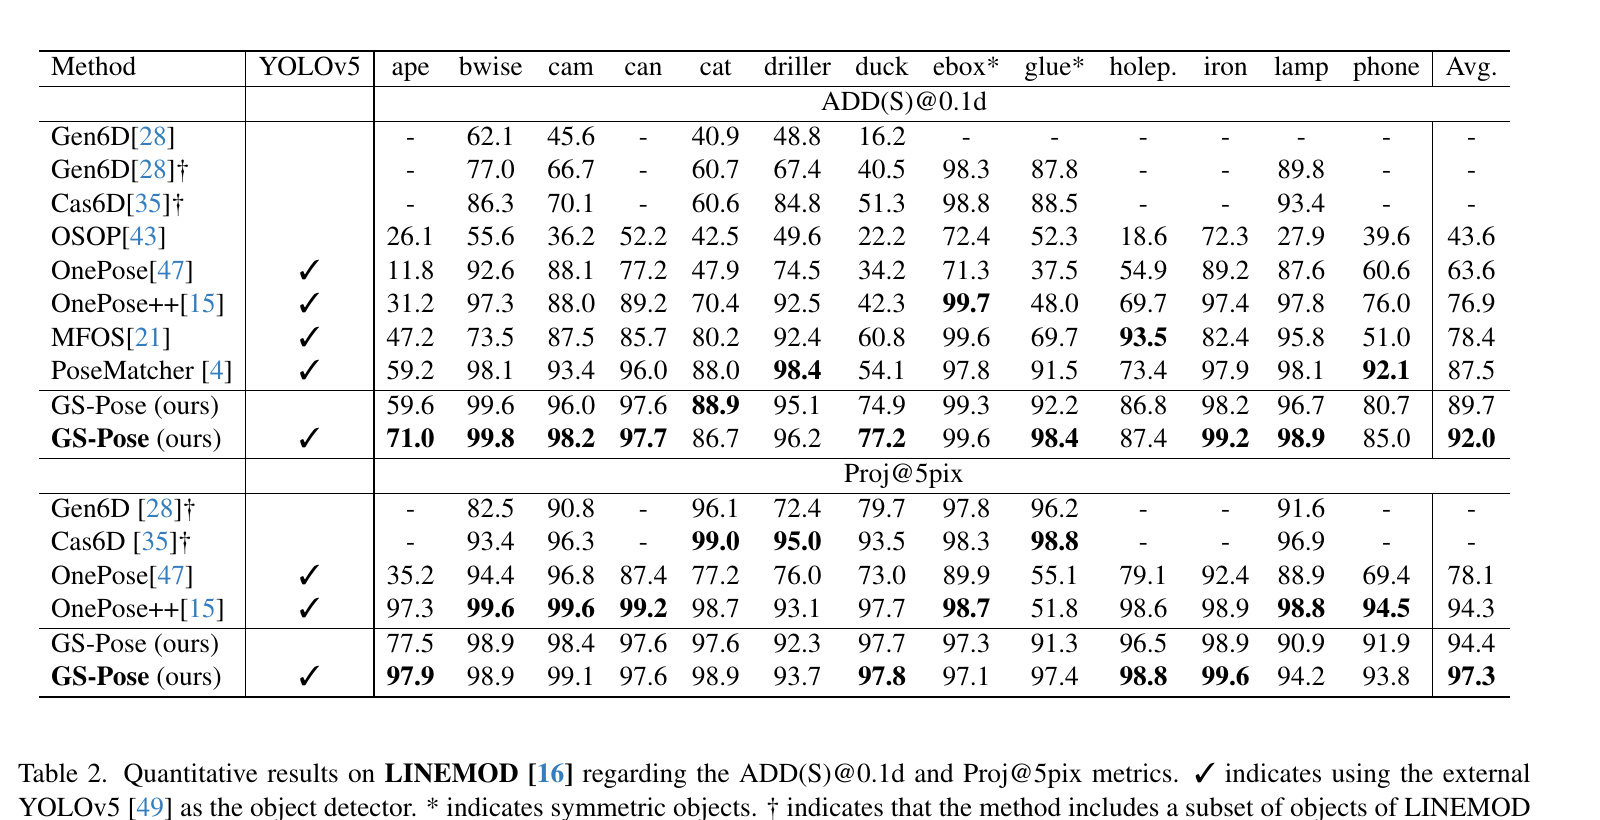 原论文 Table 2:LINEMOD 的 ADD(S)@0.1d 与 Proj@5pix 结果;勾选项表示采用外部 YOLOv5 检测器。来源:arXiv PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
- 输入:每个新物体的一组 object-centric reference RGB {Iiref}、对应相机内外参,以及在线 query RGB。论文在实验中将参考图与 query 图都视作已知相机模型下的图像。
- 输出:query 中的 2D object localization / mask 与 object-to-camera 的 6D pose;没有提供检测框时,系统自己完成 detection,提供 detector 时则从框内估计 pose。
- 核心假设:离线允许为对象采集带位姿的多视图图像,并建立 3D Gaussian representation;推理阶段有足够清晰的目标区域供分割和细化。
- 不该如何理解:它不是 category-level zero-shot pose,也不是任意网络图片上的“一键无模型定位”。它避免的是为每个对象重新训练 pose network 或准备 CAD,不是避免对象资料采集。
4. 研究动机与脉络
作者把 existing generalizable pose 分成三类弱点:直接 pose regression 在未见对象上的外观变化下不稳;2D–3D correspondence 方法需要可靠、可重建的几何对应;通常的 render-and-compare refinement 又依赖 CAD。GS-Pose 的路线是在「每对象的少量 posed RGB」里同时提取三种互补表征。
我的判断是,这个拆分有清晰的工程含义:检测失败时,不应责怪 pose refiner;初始旋转错到很远时,rendering gradient 也无从修正。论文因此没有把 3DGS 当作万能特征,而是把它留给最需要像素级可见性的一步。
5. 方法详解
5.1 离线对象库:三份表示、三种职责
| 表示 | 如何取得 | 在线作用 | 不解决什么 |
|---|
| 对象语义表示 Fobj | Co-Segmenter 从 reference images 提取 | detector / object segmenter | 不给出完整 3D pose |
| 旋转感知向量 {Viobj} | 对每个 reference view 编码 | nearest-view retrieval,给 rotation 初值 | 对平移只提供间接帮助 |
| Gaussian Object Gobj | 用 reference captures 重建 3DGS | GS-Refiner 的 differentiable rendering | 不能替代目标定位 |
在线时,query 的语义特征先与 Fobj 匹配得到目标区域;rotation-aware encoder 与 reference embedding 检索最相近的视角。平移初值由 query / reference mask 的中心和尺度关系估计。作者没有把初始值称为终点,而是将其送进 GS-Refiner。
5.2 GS-Refiner:为什么适合放在最后
GS-Refiner 将当前 pose 下 Gobj 的渲染与 query 图像、mask 对齐,通过梯度更新 pose。高斯渲染提供密集颜色、透明度与可见性信号,比只对稀疏 2D–3D correspondences 做 PnP 更适合细化。
但这是局部优化器:它依赖 retrieval 给到合理的 rotation basin,也依赖 segmentation 能够把背景从目标损失中排除。其收益因此应与 initializer 一起读,而不能单独宣称 3DGS 已解决 global pose search。
5.3 训练与速度口径
论文以 Adam、batch size 2、RTX3090 训练 100,000 steps;Nk=8、Ngs=400。作者报告 detector 约 0.16 s、initialization 约 0.01 s、refiner 约 0.96 s / image。这个拆分提示了部署权衡:在追求更强精度时,refinement 是主要成本,而不是 retrieval。
6. 实验分析
6.1 数据集、指标与公平比较
- LINEMOD:报告 ADD(S)@0.1d 和 Proj@5pix;ADD(S) 用于处理对称物体,阈值与对象直径相关。
- OnePose-LowTexture:关注低纹理实例,在论文中用 ADD(S)@0.1d 比较 initial / refined pose。
- 2D localization:以 mAP@[0.5:0.95] 分别评价 mask 与 mask-induced bbox。
Table 2 的两行 GS-Pose 不能直接合并:不使用 YOLOv5 时平均 ADD(S) 89.7、Proj 94.4;使用外部 YOLOv5 时为 92.0 / 97.3。后者包含更强的检测前端,适合衡量完整系统上限;前者更能说明自身 segmentation-based detector 与 pose stage 的组合能力。
6.2 主要结果与可解释收益
| 设置 | 关键数值 | 应如何解读 |
|---|
| LINEMOD,GS-Pose | ADD(S) 89.7;Proj 94.4 | 内置检测器下的 pose 系统结果 |
| LINEMOD,+ YOLOv5 | ADD(S) 92.0;Proj 97.3 | 把更强检测供给带来的系统增益与 pose 本体分开看 |
| OnePose-LowTexture init | 70.6 | retrieval / mask-based initializer 的平均水平 |
| OnePose-LowTexture refined | 92.1 | refinement 增加 21.5 points,是主要直接证据 |
| 2D localization | mask 72.85;bbox 80.54 mAP | 前端仍有明显错误空间 |
参考视角数的消融也很重要:论文报告 32 张 reference images 时约 74.5,180 张时约 90.86。这说明所谓“少量 reference”仍有 coverage trade-off;少参考、强自遮挡的物体不能从主结果中直接推断为稳定。
6.3 作者主张与我的核验
- 作者主张:3DGS-based refinement 对 novel-object pose 有效。证据:低纹理数据上 init 70.6 → refined 92.1,支持该主张。
- 作者主张:无需 CAD 即可泛化。需限定:成立于“不使用 CAD / per-object pose training”,但参考外参和对象 3DGS 仍是强对象先验。
- 我的分析:LINEMOD 上的 detector 口径、训练对象子集和外部 YOLO 都会改变系统总分,因此跨论文比较时应优先核对 detector、reference protocol 与是否用 GT box。
7. 失败模式、局限与可复现性
- 分割崩溃:细长件、低对比或背景混淆会污染 mask;后续 translation initialization 与 rendering loss 都失去可靠区域。
- 视角覆盖不足:retrieval 只能在 reference view manifold 内找近邻,严重背面遮挡或未采集方向会扩大初始化误差。
- 算力与时延:每图约一秒的 refinement 适用于离线或低频场景,不是毫秒级机器人闭环。
- 可复现清单:需准备 posed reference captures、标定、对象裁剪 / mask 质量;公开代码存在,但不同对象采集质量比网络超参数更可能主导结果。
8. 对 6D pose 研究的启发
- 可把对象接入拆为显式的 reference acquisition、表示构建、在线 verification 三个测试点。
- 可以研究用 uncertainty 决定是否触发 costly rendering refinement,而非每帧固定迭代。
- 对低纹理对象,稳定的 segmentation / silhouette 可能比增强局部 RGB descriptor 更决定 pose 成败;值得将 mask confidence 纳入 pose optimizer 的权重。
