Reading Notes
粗读 / 精读
已生成 src/paper-notes/hand-held-objects-reconstruction-3dv2026/coarse.md
论文粗读笔记
用于快速判断论文定位、问题设定、核心方法、实验结论和是否值得精读。
论文粗读笔记:Reconstructing Hand-Held Objects in 3D from Images and Videos
1. 基本信息
- 作者 / 机构:Jane Wu、Georgios Pavlakos、Georgia Gkioxari、Jitendra Malik;UC Berkeley、UT Austin、Caltech。
- 年份 / 会议:2026 / 3DV。
- 论文链接:OpenReview;arXiv PDF;项目页。
- 阅读模式:粗读。
2. 一句话定位
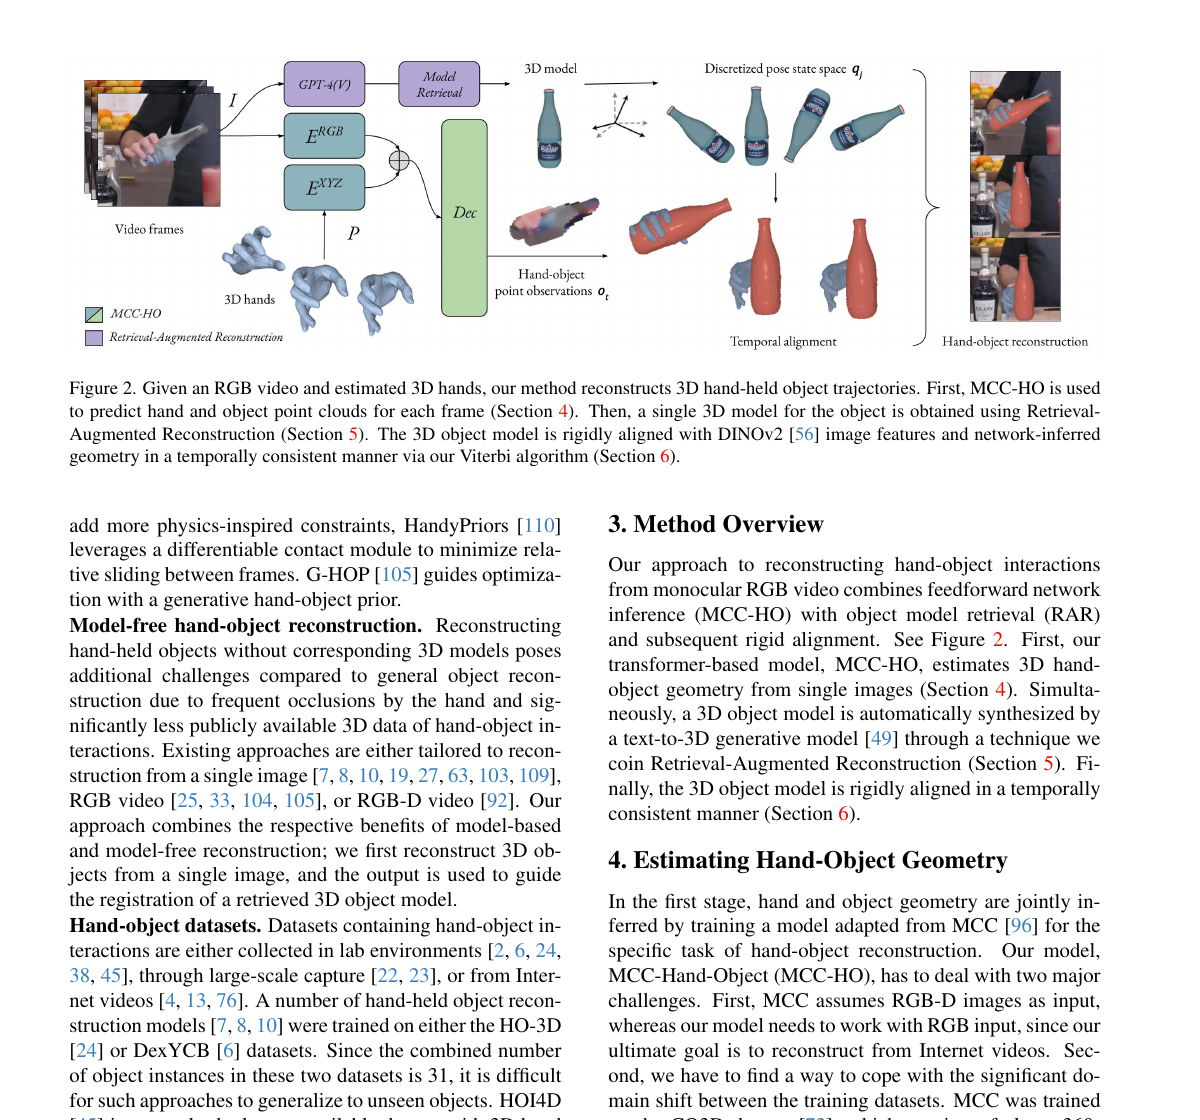
该工作以推断的 3D hand 为尺度 / 位置锚点,用 MCC-HO 从单图重建手持对象,再由 Retrieval-Augmented Reconstruction (RAR) 检索 3D asset 并做跨帧 rigid alignment。
3. 问题设定
- 输入:单张 RGB 或 RGB video,以及预估 3D hand;RAR 还使用 VLM、text-to-3D / object asset。
- 输出:手物几何,及 video 中统一、时序一致的对象模型与变换。
- 难点:手遮挡、对象像素极少、目标 shape long-tail;它不是针对固定 CAD 的 BOP pose estimator。
4. 方法概览
- MCC-HO 以 RGB 与 3D hand 预测 hand-object geometry。
- VLM 识别 / 检索与观测匹配的 3D object model,RAR 让模型与 MCC-HO / 图像刚体对齐。
- 3D hand 既缩小 geometry ambiguity,也让跨帧 object scale / location 可对齐。
5. 实验概览
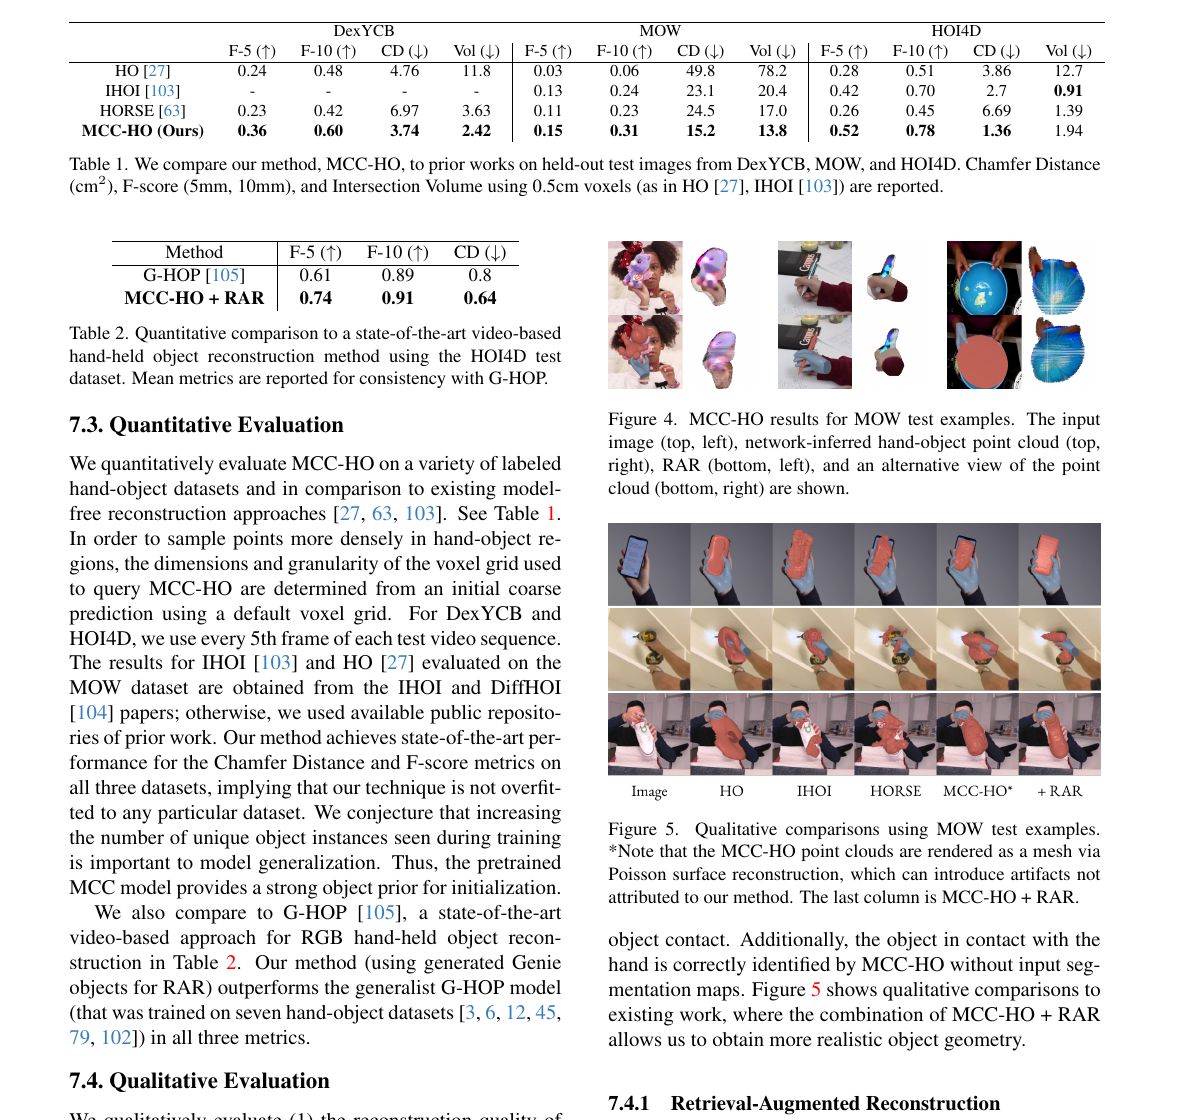
- 数据集:DexYCB、MOW、HOI4D;并在无标签 100DOH 展示。
- 单帧 MCC-HO 在 MOW 的 F5 / F10 / CD 为 0.15 / 0.31 / 15.2,优于 IHOI 的 0.13 / 0.24 / 23.1。
- HOI4D video:MCC-HO+RAR 的 F5 / F10 / CD 为 0.74 / 0.91 / 0.64,优于 G-HOP 的 0.61 / 0.89 / 0.8。
6. 优缺点与启发
优点
- 手部不是噪声,而是 object location / scale 的强条件;RAR 使单图局部几何升级为可复用对象资产。
缺点 / 风险
- 依赖 3D hand、VLM retrieval 与生成 asset 的质量;检索错类别时 rigid alignment 无法补救。
- pose 被 joint reconstruction 指标间接衡量,不能和标准 6D pose AR 直接比较。
7. 值得精读的点
消融中无 hand 的 MOW CD 从 15.2 升至 71.6,是一个非常强的证据:在交互场景里,显式手部几何可以比更大 object prior 更关键。