HOC-Search 精读
1. 从“检索后对齐”改成“边检索边对齐”
扫描场景里的 CAD annotation 通常需要回答三个耦合问题:这是哪一类对象、数据库中哪个 CAD 最像、CAD 应以什么尺度和 pose 放进场景。若初始 3D box 有偏差,先固定 pose 再穷举 CAD 会把真正模型打低分;若对每个 CAD 都做 pose refinement,计算又不可接受。HOC-Search 的核心是把 refinement 只花在搜索过程中的高价值候选上。
2. 目标函数和 HOC-Tree
论文比较多种 CAD–scan 相似度后,采用由渲染深度与轮廓/mask 构成的 render-and-compare objective。它直接测量“这个 CAD 以当前 pose 渲染后能否解释扫描”,比只比较全局 shape embedding 更贴近最终任务,但单次评估更贵。
数据库先以 ShapeGF 等 embedding 做层次 k-means;上层节点代表形状簇,叶节点对应具体 CAD。类别和离散方向可作为 property nodes 插入树中。每个内部节点用 centroid CAD 代表其子树,从而以少量渲染比较判断哪一支更值得展开。
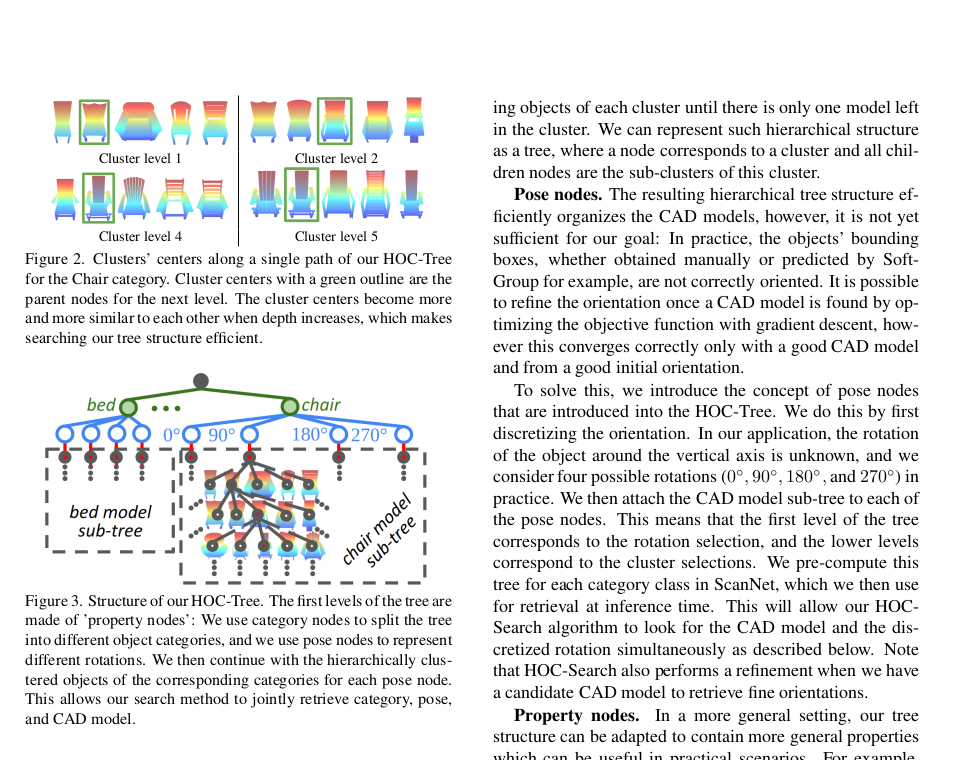 树不保证早期 centroid 一定代表所有子模型,因此纯 greedy 容易走错;MCTS 能回访上层并探索其他分支。来源:原论文 Figure 2–3;版权归原作者及 3DV 2024 出版方所有,本站仅作学术解读。
3. MCTS 与 pose refinement
每次迭代经过 selection、expansion/evaluation、update。节点价值由其已评估后代的 render-and-compare 分数更新;node locking 避免重复遍历已经穷尽的子树。若当前候选刷新最好分数,系统对 9DoF 变换(translation、rotation、scale)做局部梯度优化,再用优化后目标更新结果。
这种结构的关键是预算可调:200/400/600/800 次迭代对应约 44.7×/22.3×/14.9×/11.1× 加速,用户可在准确率与延迟之间选择。
4. 实验拆解
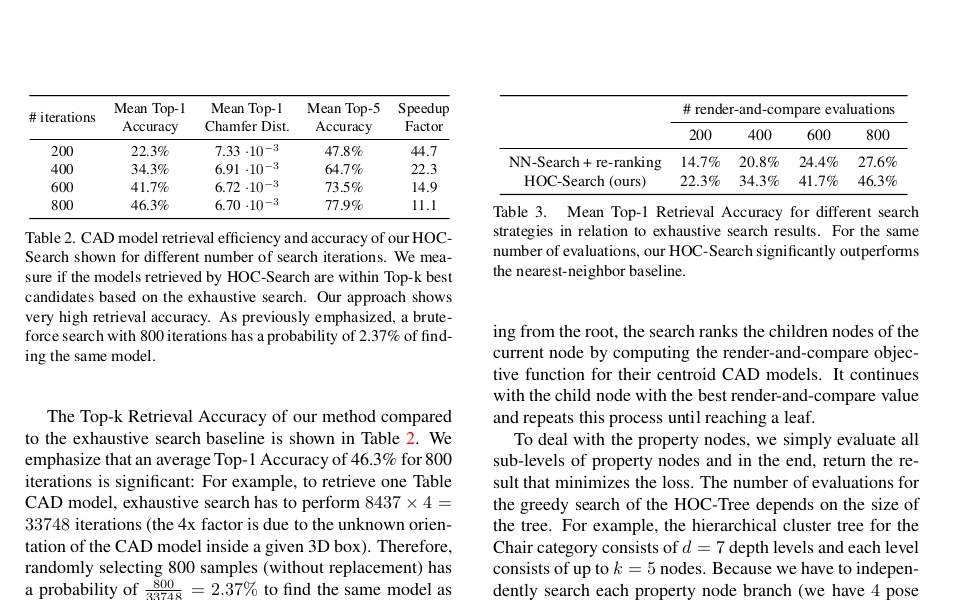 800 次时 Top-1/Top-5 为 46.3%/77.9%;同预算下 HOC-Search Top-1 远高于 nearest-neighbor re-ranking 的 27.6%。来源:原论文 Table 2–3;版权归原作者及 3DV 2024 出版方所有,本站仅作学术解读。
“46.3% Top-1”看起来不高,但它以穷举结果为参照:Table 类有 8,437 个 CAD × 4 个方向,随机抽 800 个命中穷举最优仅约 2.37%。更重要的是 Top-5 已为 77.9%,且候选与真值的 Chamfer 接近。
自动 pipeline 使用 SoftGroup 生成 3D instance boxes。此时穷举 render-and-compare 因固定错误 pose,Chamfer 为 14.59×10⁻³;HOC-Search 800 次 + refinement 为 13.72×10⁻³,同时 11.1× 加速。说明搜索和对齐的耦合不只是省时间,也能修正“穷举但 pose 固定”的目标错配。
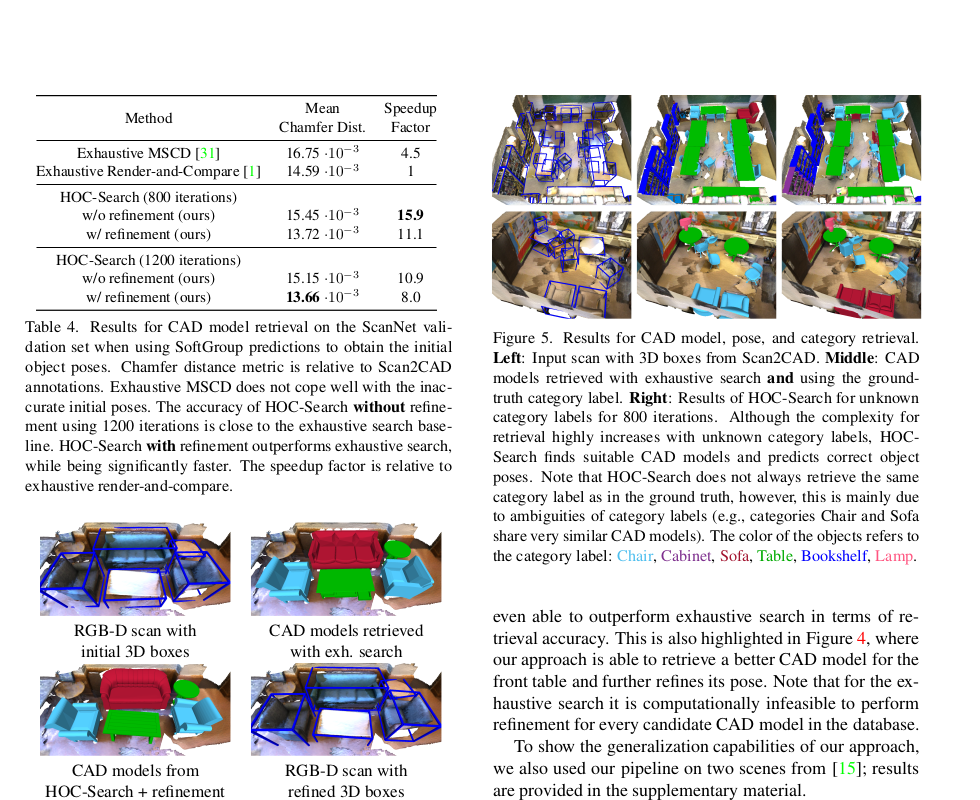 初始框不准时,联合 refinement 可让最终模型更贴合扫描;类别未知实验以 800 次替代约 96,216 次比较。来源:原论文 Figure 4–5、Table 4;版权归原作者及 3DV 2024 出版方所有,本站仅作学术解读。
5. 局限
- 数据库中必须存在几何相近 CAD;检索不能生成缺失形状。
- centroid 代表性不足时,MCTS 仍可能在预算耗尽前错过优质叶节点。
- Chair/Sofa 等类别是语义定义而非纯几何,几何目标可能检索“形状对、标签错”的结果。
- 输入是 RGB-D scan + 近似 3D box,和单帧 RGB object pose 的传感器成本不同。
- refinement 只对少量优质候选做,速度收益依赖 render-and-compare 与优化实现。
6. 我的判断
HOC-Search 的工程价值在于把一个昂贵但可信的评分器变成可预算搜索。今天若用可微渲染、基础模型特征或生成式 CAD 检索替换原评分/数据库,HOC-Tree + 有限候选 refinement 的思路仍适用。它也是一个提醒:在模型与 pose 强耦合时,“先识别、后对齐”未必是正确分解。
