论文精读笔记:HOGSA: Bimanual Hand-Object Interaction Understanding with 3D Gaussian Splatting Based Data Augmentation
1. 基本信息
- 作者 / 机构:Wentian Qu 等;中国科学院自动化研究所、国科大、Google。
- 年份 / 会议:2025 / AAAI。
- 论文页 · 官方 PDF · 项目页
- 阅读模式:精读。
2. 一句话定位
HOGSA 的目标不是从单图直接输出 pose,而是用可控、较高保真的 3DGS 生成数据来补足双手–物体交互中的 pose、viewpoint 和遮挡覆盖,并验证这些数据能提升下游 interaction pose / motion baseline。
2.1 论文图表导读
| 图表 | 阅读重点 |
|---|
| 方法页 | mesh-based 3DGS、SRM 与 bimanual pose optimization 的职责应分开理解 |
| Figure 5 | 观察生成数据是否覆盖原始训练集缺失的手势 / 视角,而不仅是“图像更好看” |
| Table 1–4 | 下游任务收益、render quality 和 SRM / POM 消融共同构成证据链 |
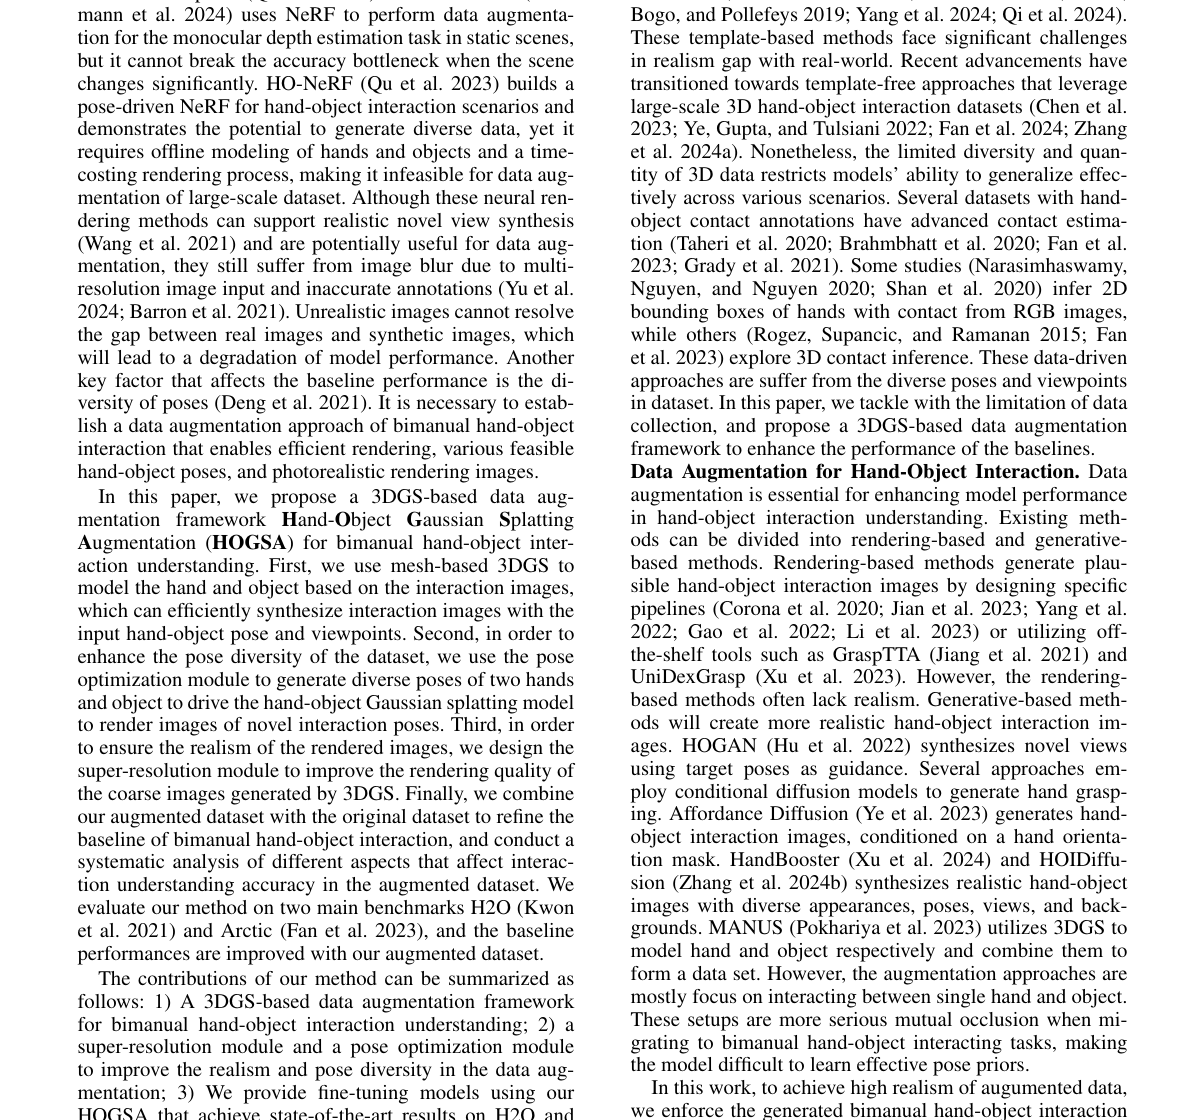 原论文 HOGSA 方法所在页局部。来源:AAAI 官方 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
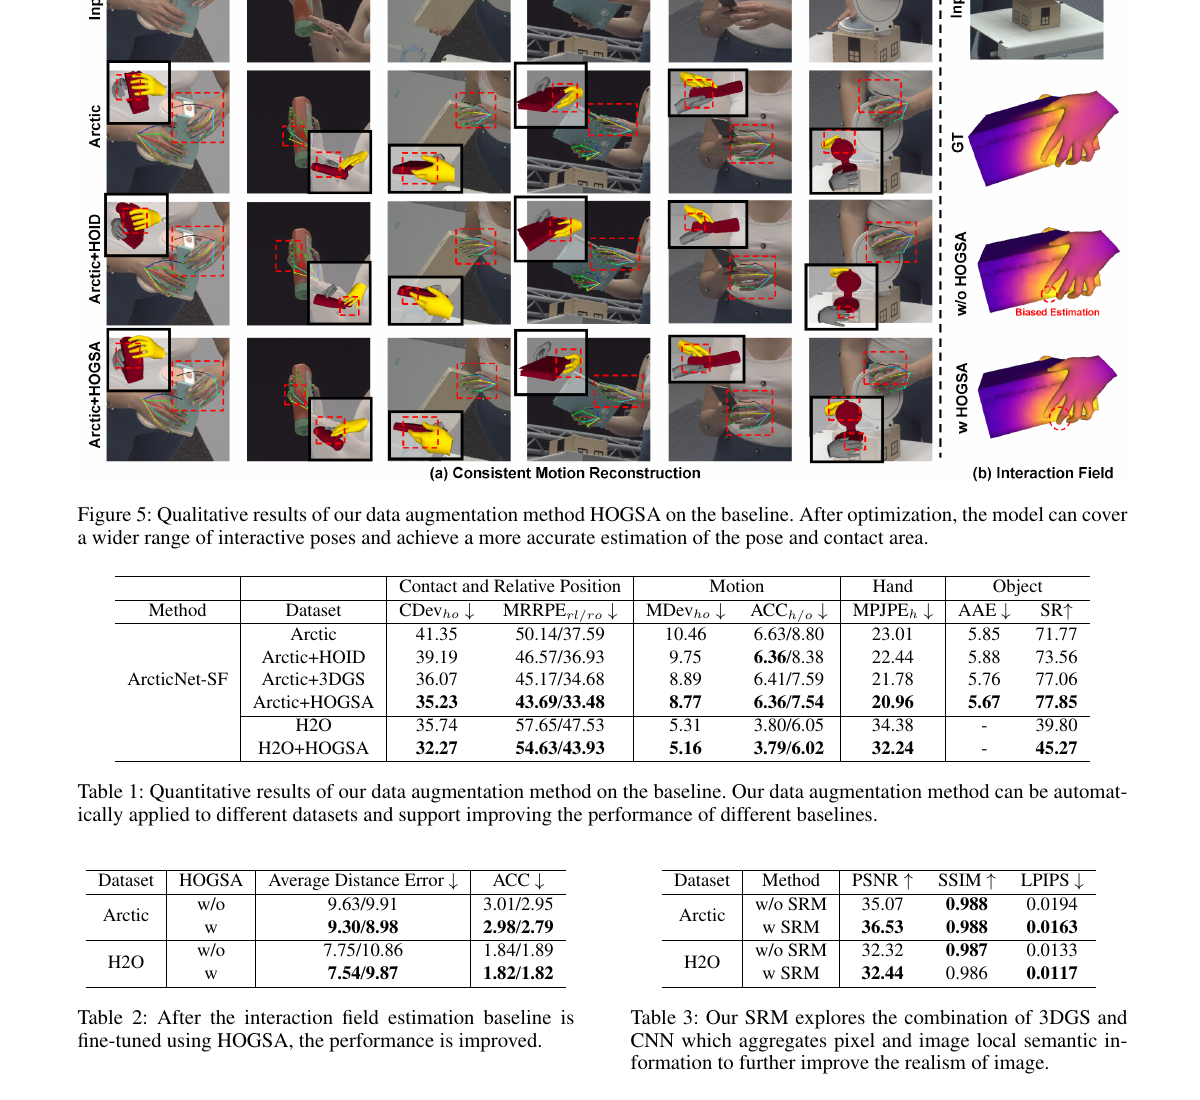 原论文下游数据增强结果页面局部。来源:AAAI 官方 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题边界
- 双手操作中,手、物体和接触区域会相互遮挡,真实标注数据很难均匀覆盖所有抓取与相对运动。
- 常规 3DGS 可能出现点漂移、局部空洞与渲染模糊;直接把此类合成图加入训练可能扩大 domain gap。
- HOGSA 的输入是 hand-object capture / 重建序列和必要的几何约束,输出是扩增图像与标注;它是 pose 学习的数据侧工作。
4. 方法拆解
| 模块 | 功能 | 下游意义 |
|---|
| Mesh-based 3DGS | 用 mesh 约束 Gaussian splats | 降少无效漂点与手物边界的几何失真 |
| SRM | 3DGS + CNN 的超分辨率模块 | 修复物体纹理、手部褶皱等可被下游网络利用的局部细节 |
| Bimanual POM | 从双手 joints 优化抓取 pose / 视角 | 扩大可行交互构型,不只是复制原帧 |
| Rendered augmentation | 合成新 RGB 与对应 annotation | 送入 ArcticNet-SF、InterField-SF 等 baseline 再训练 |
论文生成了 ARCTIC 的 82 个 HOGS model 和约 170 万新图像(约 +113%);H2O 的 24 个 HOGS model 和约 70 万新图像(约 +175%)。这说明它偏向重数据生产,而不是一次训练即可部署的轻量模块。
5. 实验与数值
| 下游 / 数据 | 原始训练 | 加 HOGSA | 阅读方式 |
|---|
| ARCTIC, ArcticNet-SF | MPJPE 23.01;SR 71.77 | MPJPE 20.96;SR 77.85 | 同时改善手部误差与 object success rate |
| H2O, ArcticNet-SF | MPJPE 34.38;SR 39.80 | MPJPE 32.24;SR 45.27 | 增益更直接表现在 object success rate |
| ARCTIC render | PSNR 35.07 → 36.53;LPIPS 0.0194 → 0.0163 | 加 SRM 后 | SSIM 近似不变,质量收益主要体现在 PSNR / perceptual distance |
消融中,ARCTIC 的 Full(SRM+POM)比去掉 SRM 或 POM 都好:Full 的 CDev 为 35.23、MPJPE 20.96、SR 77.85。这支持“渲染逼真度”和“姿态分布”必须同时改善,而不能只解决其中一个。
6. 批判性分析与启发
优点:把 data diversity 和 rendering fidelity 分开消融;同时报告下游交互、接触、手部和物体相关指标;对双手遮挡场景有明确针对性。
局限:需要 capture / reconstruction / mesh 相关条件,数据制造成本不低;虽然速度报告为每张 0.06 s,但不包含前期 HOGS 重建与数据管线;对于新物体类别、不同相机和大幅材质变化的泛化仍待验证。
启发:pose 系统遇到数据覆盖问题时,合成数据不应只做 photorealism,也应显式优化 pose / contact 的分布;部署前最好按“真实 + 合成”分开报告,以确认收益不是只来自训练集近似重复。
