论文精读笔记:Towards in-the-wild Egocentric 3D Hand-Object Pose Estimation
1. 基本信息
标题:Towards in-the-wild Egocentric 3D Hand-Object Pose Estimation
方法 / 数据:HOPformer / EPIC-Contact
作者:Siddhant Bansal、Zhifan Zhu、Shashank Tripathi、Jiahe Zhao、Michael J. Black、Dima Damen
机构:University of Bristol;Max Planck Institute for Intelligent Systems, Tübingen
年份 / 会议:ECCV 2026 Poster
核验全文:arXiv:2606.30598 v1 (提交于 2026-06-29,主文与补充材料共 43 页)
正式条目:ECCV 2026 Poster 3943
项目 / 实现:项目页 ;HOPformer ;EC-fit
数据 / 权重:EPIC-Contact dataset ;HOPformer models
阅读模式:精读
阅读重点:EPIC-Contact 的 3D 标注究竟有多少人工 / 优化 / 传播成分;HOPformer 如何用手先验约束对象 pose;成功率、接触误差与所谓 fully automatic 的评价协议;公开 checkpoint 的尺度偏差是否影响论文结论。
2. 核心结论先行
HOPformer 将第一人称单图中的对象表示设为 query、左右手 WiLoR 表示设为 memory,通过 12 层 self-attention + hand-object cross-attention 逐步修正对象 token,再联合回归双手 MANO、对象 R/T、可选 articulation 和对象类别。EPIC-Contact 则把稳定抓握视频中的少量人工双射接触,通过 EC-fit 与手部运动传播扩成 2,272 clips / 62.3K frames 的野外监督。
2.1 总体评价
这篇论文有两个相互支撑的贡献:
数据贡献不是简单“把 RGB 视频跑一遍伪标签” 。标注者在细分 MANO 上画接触,用最多 6 次点击把区域级接触轴转到对象表面,EC-fit 再结合 contact、occlusion-aware silhouette、penetration 和 hand regularization 联合拟合。作者对接触一致性、VLM 尺度、EC-fit pose、penetration 以及 noisy-label training 都给了定量检查。模型贡献有明确的反事实证据 。Concat + MLP、generic hand features、no self-attention、no aggregation、浅 decoder 都显著退化。性能不是只靠把 DINOv2 ViT-G 换大,而与“对象 token 反复读取 pose-specialized hand prior”的结构直接相关。
但论文最容易被误读的也有四点:
摘要“nearly doubles / 75%”不是相对最强 baseline 的同一口径。对最强 JointTransformer,SR@0.05 提升约 69.3%,CDev 降 31.2%;接近摘要数字的是对 ArcticNet-SF 的 80.6% 成功率相对提升与 78.0% CDev 降幅。
EPIC 主表 pose 使用 oracle object mesh;对象 classifier 准确率只有 52.9%。所谓 fully automatic 表只保留分类正确样本,不能代表完整测试集。
EPIC 的 SR 是去 root 后、symmetry-aware 的对象顶点成功率;大多数指标描述相对几何或 root-aligned shape / orientation,不足以验证完整相机空间 translation。
官方仓库披露 epic_epoch125.ckpt 有约 1.28× 投影尺度与约 0.78×绝对深度偏差。主表按其协议可复现且不受影响,但绝对 pose 部署要额外校准,不能用 Table 2 直接背书。
综合来看,HOPformer / EPIC-Contact 是一篇数据链路与模型设计都较完整的第一人称手物联合 pose 工作 ;它的 strongest evidence 是“在固定类别 / mesh pool 下,手先验改善相对姿态、接触与 root-aligned object pose”,而不是开放世界 CAD-free 绝对 6D pose。
2.2 主张—证据地图
主张 主要证据 证据强度 本站判断 EPIC-Contact 可提供野外 3D 监督 κ、30-object 尺度核验、ARCTIC 20% EC-fit 模拟、penetration、noisy-label training 中等偏强 检查维度较完整;但 propagation 与小样本尺度验证仍有限 手先验提升对象 pose Table 3 的 WiLoR / cross-attention / decoder 消融 强(ARCTIC 内) 结构与指标变化吻合;EPIC 未逐模块消融 在野外接近翻倍、CDev 降 75% Table 2 有条件成立 需指定 ArcticNet-SF;对最强 JointTransformer 不是这个幅度 可 fully automatic inference Cls 52.9%;Supplement Table 7 correct-class subset 弱到中等 分类正确时 pose 可用,但完整测试集近半错分类没有统一 pose score 预测完整 object pose R_o∈R^6, T_o∈R^3 输出;MRRPE / SR 等部分成立 网络确实回归 R/T;EPIC 主指标与 checkpoint issue 未验证可靠绝对深度 可扩展到更多对象 ARCTIC 3/6/9/11 classes 初步 只到 11 类;EPIC 仍 9 类,作者也把更大规模留作未来工作
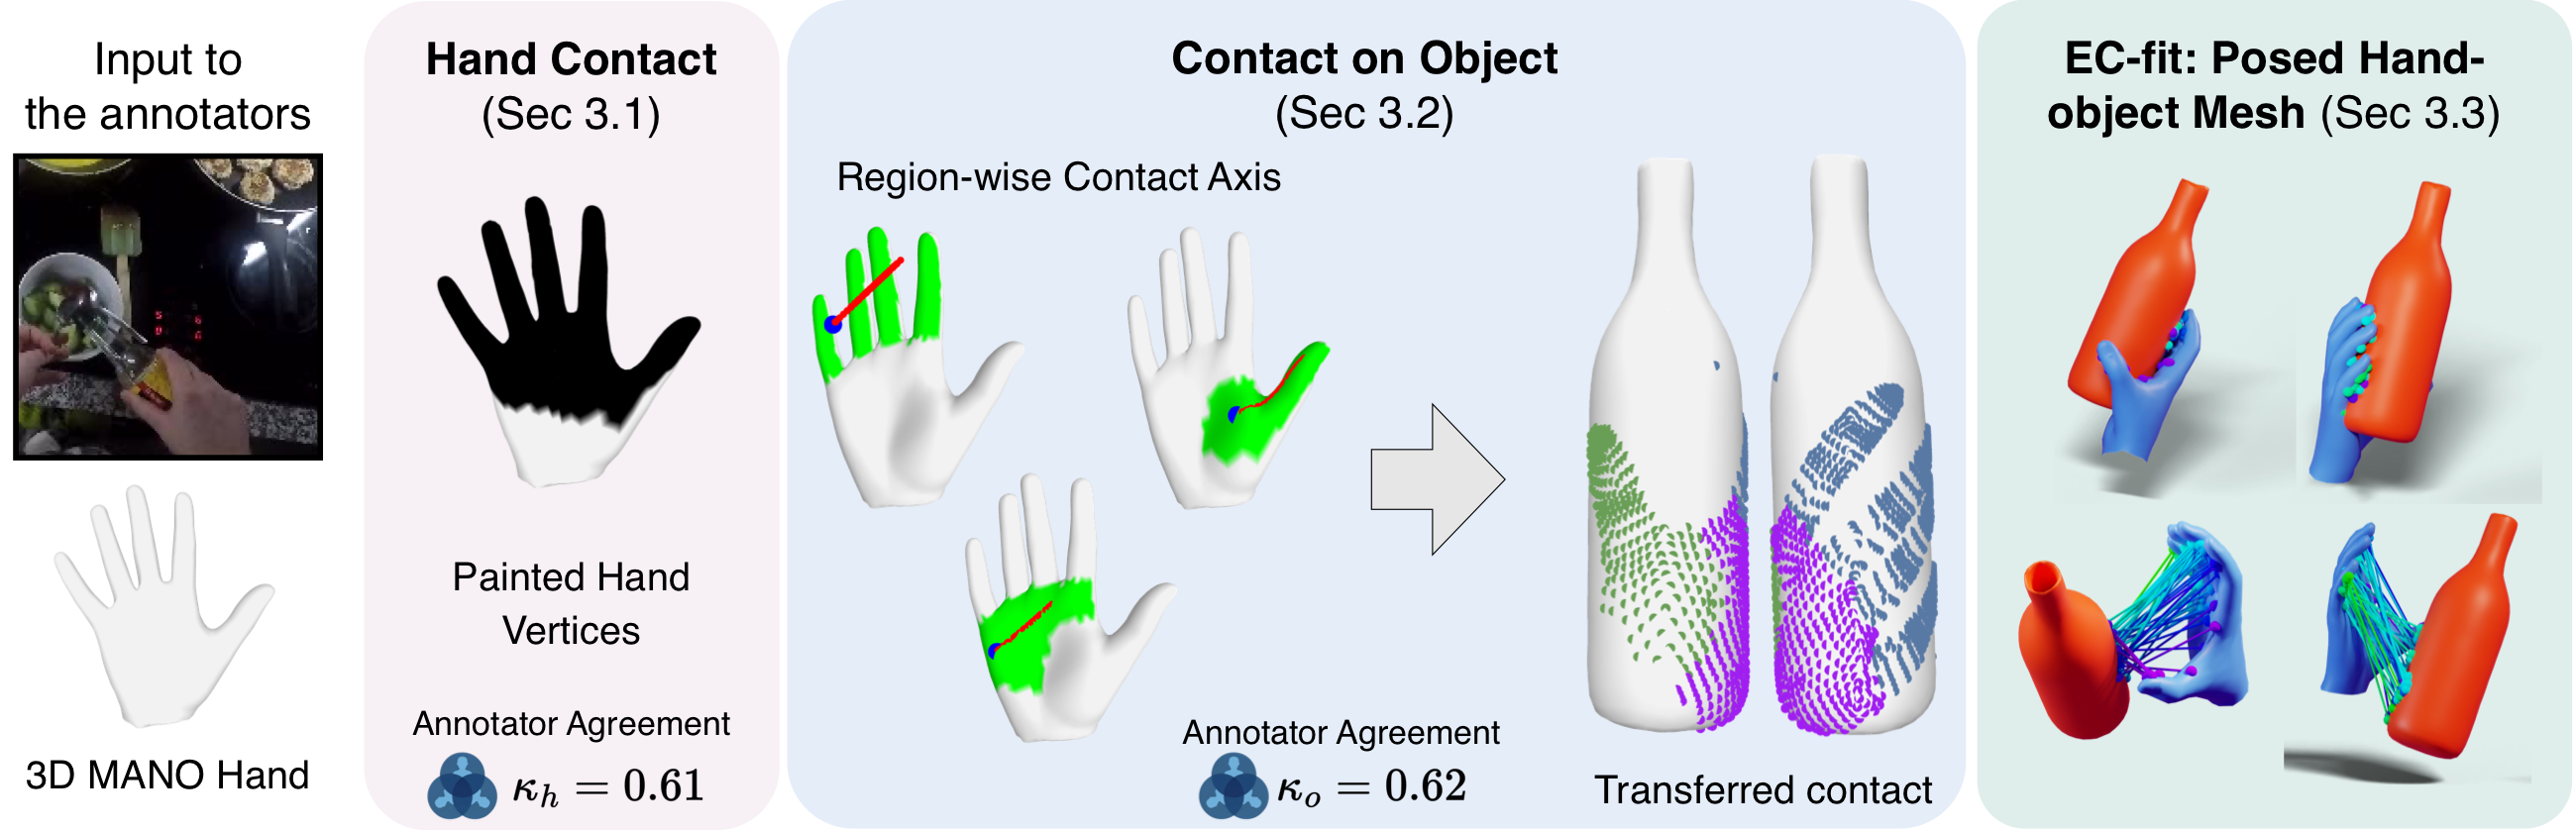
原论文 Figure 2:人工绘制 hand contact,以 region-wise contact axis 建立手—物双射,再用 EC-fit 把接触、mask 与 penetration 约束变成 posed meshes。它是 human-in-the-loop optimisation pipeline,而不是纯自动伪标签。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 任务定义与坐标协议
3.1 外部输入与内部表示
HOPformer 的外部输入是单张第一人称 RGB hand-object interaction image。整体场景图像送入 DINOv2 object encoder;左右手局部图送入 WiLoR hand encoder。公开 README 说明无需额外下载 WiLoR detector.pt,因为 HOPformer 自己准备 hand crops;但论文没有把手检测、对象检测或 box noise 作为独立评价变量。因此它应理解为“给定交互画面做联合 pose”,而不是已经完成完整场景 detection-to-pose 闭环。
模型处理三种实体:右手 r、左手 l、对象 o。EPIC-Contact 每个 sequence 只有一只手,所以 hand–hand MRRPE 无效;ARCTIC 则包含双手与 articulated object。
3.2 输出参数
每只手用 MANO 表示:
Θ h = { θ h , β h } , H ( Θ h ) ∈ R 778 × 3 , \Theta_h=\{\theta_h,\beta_h\},\qquad
H(\Theta_h)\in\mathbb{R}^{778\times3}, Θ h = { θ h , β h } , H ( Θ h ) ∈ R 778 × 3 , 其中 θ∈R^48 包含 global orientation,β∈R^10 表示 shape。对象 pose 为:
ω o = { R o , T o , a o } , \omega_o=\{R_o,T_o,a_o\}, ω o = { R o , T o , a o } ,
R_o∈R^6:连续 6D rotation representation,最终转为旋转矩阵;T_o∈R^3:对象 translation;a_o∈R:存在 articulated object 时的一维关节角。
给定类别 c 的 mesh O_c,输出 posed mesh O_c(ω)。因此网络确实回归旋转和平移,但几何来自预定义 model pool M,不是从图像重建。
3.3 known category、novel instance 与 oracle mesh
问题设定写的是“one object out of a set of known categories”。ARCTIC train / validation 共享同一批 11 个对象实例;EPIC-Contact test 则含已知 9 类中的新实例。后者比 same-instance 更难,却仍不等于 unseen-category / open-vocabulary pose。
分类 head 从 DINOv2 object feature 预测 c,按类别从 M 取 mesh。为和 ArcticNet-SF、JointTransformer 公平比较,Table 2 的 pose 结果使用 oracle class / oracle mesh;分类准确率作为 Cls=52.9% 另列。这个协议意味着主表回答的是:如果 mesh 身份正确,pose head 能做到多好? 它没有回答错误 mesh 选择后系统整体能否成功。
3.4 与标准 6D object pose 的差异
没有 BOP 的 detection AP、VSD / MSSD / MSPD 组合,也不评完整场景多实例召回。
EPIC SR 先移除 object root,再用 closest equivalent vertex 处理对称,因此偏向 orientation / root-aligned shape consistency。
CDev、MRRPE、MDev 把手作为参照,强调 hand-object relative geometry。
articulated angle 与 MANO 指标属于交互重建任务,不可和 object-only ADD(-S) 排行榜直接横比。
本站将它放在 ECCV 2026 扩展收录,而不计入 14 篇 object-pose 核心论文,原因正是对象 pose 只是联合 hand-object reconstruction 的一部分。
4.1 为什么选择 stable grasp clips
数据来自 EPIC-Grasps / EPIC-Kitchens:真实厨房、头戴相机、背景杂乱、对象常被手或其他物体遮挡,并包含透明 glass / bottle。EPIC-Grasps 已提供 stable grasp temporal segments,即同一片段内手与对象的接触顶点集合基本不变。这使作者能够:
只在中心帧人工判断接触;
拟合中心帧的 hand-relative object pose;
用逐帧 WiLoR hand pose 把对象传播到整个 clip。
代价是标签不再逐帧独立。作者明确承认 hand-side 错误、camera placement jump 与 WiLoR jitter 会污染传播,并发布 per-frame confidence 供过滤。论文指标多为 relative / root-aligned,因此对全局传播噪声不敏感,这既是合理设计,也意味着这些指标不能完整测量相机空间绝对质量。
4.2 数据规模与长尾
总计 2,272 clips、62.3K frames、9 类:
类别 clips 占比(约) pan 492 21.7% plate 437 19.2% bowl 396 17.4% bottle 286 12.6% glass 211 9.3% mug 160 7.0% cup 121 5.3% can 97 4.3% saucepan 72 3.2%
前三类约占 58%,saucepan 只有 72 clips,存在明显类别不平衡。划分为 2,035 train videos 与 237 test videos,按 unique videos 抽取 10%,保持 hand side / category distribution;同一视频不跨 split。Supplement 只明确视频互斥,没有报告厨房、参与者或具体物体 identity 的更严格 group split,因此“novel instances”应沿作者协议理解,不宜扩大为跨环境独立同分布证明。
标准 MANO 只有 778 顶点,作者均匀细分到 3,106 顶点,以更精细表示指腹、掌心等小接触区域。标注 UI 同时播放完整 stable-grasp clip并显示可旋转的 canonical hand mesh;标注者被要求推断视频中不可见的接触,而不仅涂当前帧可见区域。
12 名 annotators 在 10 个 clips 上得到 κ_h=0.61,对比 DECO 的 0.65。这个 Fleiss’ kappa 支持“不同人能大致稳定识别接触区域”,但样本仅 10 clips,且 0.61 仍允许显著边界差异。它不是每条数据的置信区间。
仅有 hand contact mask 不足以恢复对象 pose,因为需要知道每个 hand vertex 对应对象表面的哪一点。作者沿 ContactEdit 用 contact axis 参数化区域,并把手拆成 thumb、four fingers、palm 三组:
每组 axis 有 2 DoF,由起点和方向两次点击确定;
最多三条 axis,也就是每 clip 最多 6 clicks;
WiLoR pose 用于估计 fingers spacing;
axis transfer 后可为每个 hand contact vertex 找到唯一 object surface correspondence。
4 名 annotators 在 10 段视频上的对象对应一致性 κ_o=0.62。这一步比仅标前景 mask 信息更强,但也会把类别 mesh 与真实实例形状差异转化成 correspondence bias。
4.5 VLM object scaling
原 EPIC-Grasps mesh 每类有固定尺度,真实 pan、bottle、glass 大小与比例却不同。作者给 Gemini 2.5 设计 class-specific prompt,例如 pan 同时预测不含柄的直径与含柄总长、glass 预测上下直径与高度,再按多个 degree-of-scale 非均匀缩放 template mesh。
验证集是覆盖 9 类的 30 个实物尺寸:
absolute MAE 0.94 cm;
relative error 5.9%;
82.5% 被测 dimensions 落在真实尺寸 ±10%。
这个结果说明 VLM 尺度不是完全随意,但仍有三重边界:样本仅 30 个;部分真值通过识别同品牌商品并量同款获得;剩余约 17.5% dimension 超出 ±10%。后续 contact transfer、pose translation 与 projected mesh 都继承尺度误差。
4.6 EC-fit 优化
中心帧手 pose 由 WiLoR 初始化 Θ_0。对象旋转采用 6D representation,并用随机 pose + category-aware pose prior 多初值搜索。首先最小化双射接触:
L c o n = 1 ∣ C ∣ ∑ ( h i , o i ) ∈ C ∥ h i − o i ∥ 2 . L_{con}=\frac{1}{|\mathcal C|}\sum_{(h_i,o_i)\in\mathcal C}\|h_i-o_i\|_2. L co n = ∣ C ∣ 1 ( h i , o i ) ∈ C ∑ ∥ h i − o i ∥ 2 . 接着做 image-guided refinement:
L_om:只对非遮挡区域比较 rendered object mask 与 VISOR object mask;L_p:约束 hand-object penetration;L_hm:对齐 rendered hand mask;L_reg=||Θ-Θ_0||²:避免 MANO 偏离 WiLoR 初始化过多;保留 L_con,交替 / 联合更新 hand 与 object。
作者最后人工复核并纠错。所以 EPIC-Contact 的 3D pose 是“人工接触 + 已知 mesh + 多先验优化 + 人工复核”的结果,不应叫纯人工 MoCap ground truth,也不应叫无需人工的 pseudo label。
4.7 标注质量审计
作者在 ARCTIC 20% train subset、37,051 frames 上丢弃 object GT,只保留模拟 contact annotation,再跑 EC-fit:
配置 Pose L2 ↓ MRRPE ↓ CDev ↓ contact alignment only 5.0 mm 9.6 mm 7.0 mm full EC-fit 1.9 mm 8.0 mm 12.2 mm
完整 pipeline 大幅改善 vertex pose 与相对 root,却牺牲 contact distance。原因是 image mask / pose 对齐会与“让指定接触顶点极近”发生冲突。它提醒使用者:EC-fit 标签是多目标折中,不是每项物理量同时最优。
penetration 对比:
数据 volume ↓ max depth ↓ ARCTIC MoCap 7.24 cm³ 0.80 cm EPIC-Contact 20.9 cm³ 0.79 cm
最大深度几乎相同,但 EPIC volume 是 2.89 倍。论文“comparable”只适合 depth,不能扩大到 volume。好消息是,在 ARCTIC subset 上用 EC-fit labels 训练 HOPformer,相对用 GT 训练的 CDev 40.9→41.1、MRRPE 35.6/37.3→35.7/37.0、SR 71.9→71.8,变化很小;这直接支持“当前量级的标签噪声对训练影响有限”。
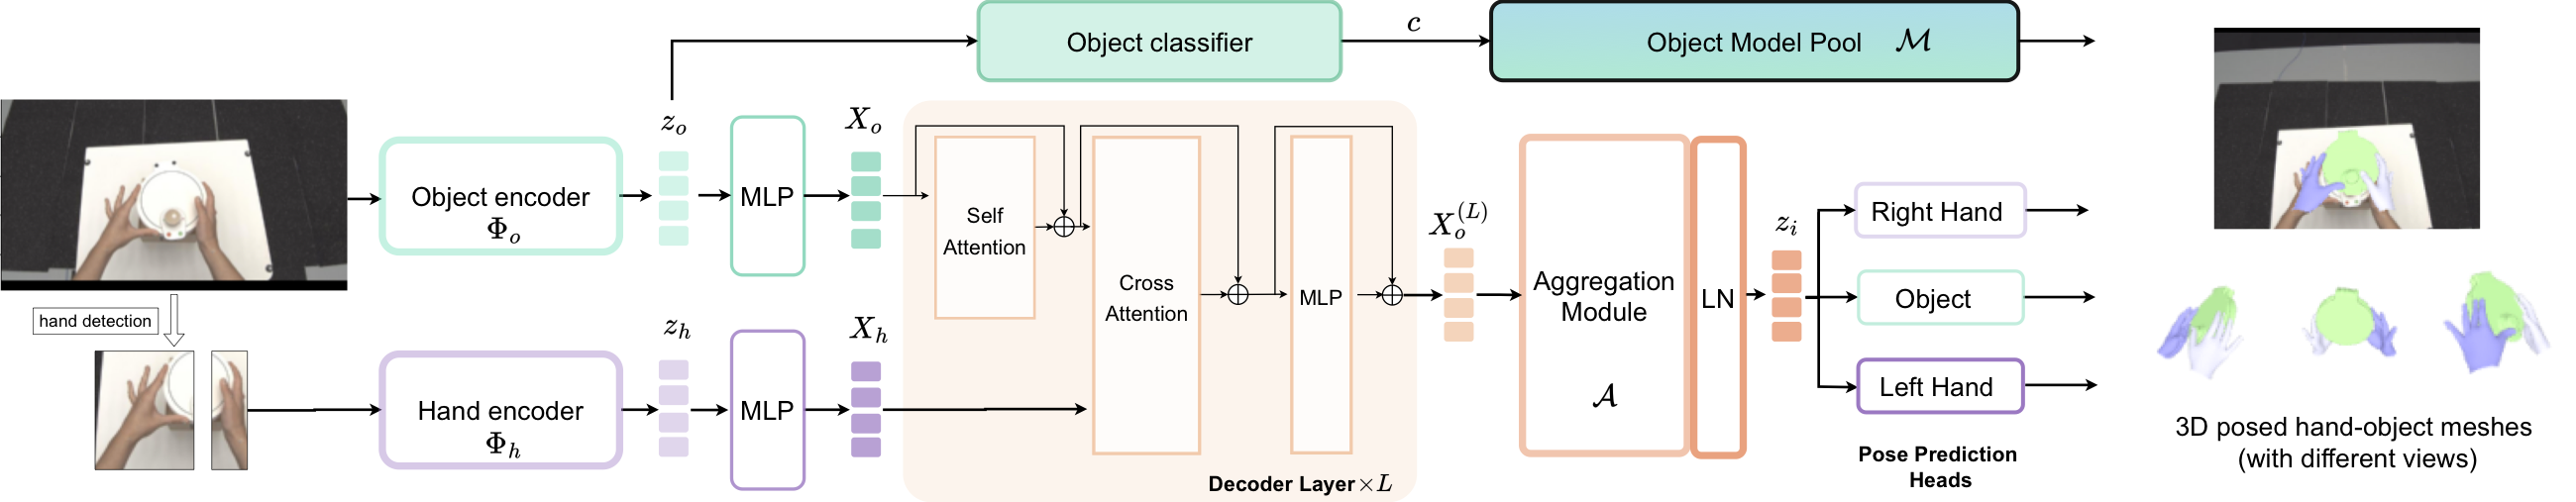
原论文 Figure 4:HOPformer 不是把手 / 物特征一次性拼接,而是让对象 token 在每层先 self-attend,再 cross-attend 左右手 pose token;聚合后的 39 个 token 分别服务于左右手和对象 heads。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
5.1 为什么对象是 query、手是 memory
DINOv2 ViT-G object encoder Φ_o 输出维度 1,536 的 generic object tokens z_o;WiLoR Φ_h 为左右手 crop 输出维度 1,280 的 pose-specialized tokens z_h。线性映射后:
X o = W o z o , X h = W h z h . X_o=W_oz_o,\qquad X_h=W_hz_h. X o = W o z o , X h = W h z h . 作者的假设不是“手和对象同等可靠”,而是野外 hand foundation model 已经比 joint hand-object model 更稳,因此应让手作为 condition。每层 decoder 对对象表示执行:
object self-attention:聚合对象局部与全局视觉线索;
hand-object cross-attention:对象 query 读取 hand key / value;
position-wise FFN:更新每个 token。
第 l 层 cross-attention 为:
CA ( X o l − 1 , X h ) = Softmax ( ( X o l − 1 W Q l ) ( X h W K l ) T d k ) ( X h W V l ) . \operatorname{CA}(X_o^{l-1},X_h)=
\operatorname{Softmax}\left(\frac{(X_o^{l-1}W_Q^l)(X_hW_K^l)^T}{\sqrt{d_k}}\right)(X_hW_V^l). CA ( X o l − 1 , X h ) = Softmax ( d k ( X o l − 1 W Q l ) ( X h W K l ) T ) ( X h W V l ) . 它不是显式 contact solver:attention 不保证对应真实接触顶点,也没有在推理时强制无碰撞。物理一致性主要由训练中的 CDev interaction loss 学得。
5.2 12 层迭代与 aggregation
最终 decoder output 与初始对象序列做 residual,再聚合:
z i = LayerNorm ( A ( X o L + X o ) ) . z_i=\operatorname{LayerNorm}(A(X_o^{L}+X_o)). z i = LayerNorm ( A ( X o L + X o )) . 补充材料说明 A 是 MLP,把 256 object tokens 映射成 39 task tokens:
tokens 1–16:right MANO joint pose / global orientation;
token 17:right root;token 18:right shape;
tokens 19–36:left hand 对应输出;
最后 3 tokens:object pose / articulation。
这种 learnable routing 比固定截取 token 更有效:无 aggregation 时 SR@0.05 82.4→74.0、CDev 31.9→40.4。
5.3 Object class 与 model pool
pose decoder 本身不硬编码某个对象几何,但要把 R/T/a 变成 mesh,必须知道 O_c。分类 head直接读取 z_o 预测 c,再从 M 取 mesh。这个“pose regression 与 identity classification 解耦”对 ARCTIC 很有效(Cls 99.5%),到 EPIC 新实例只有 52.9%,成为系统瓶颈。
这也解释为什么它不是 CAD-free:mesh 不作为每帧显式输入,并不等于系统无需 mesh;它只是把 mesh lookup 藏在类别预测之后。Supplement 对 HOLD-Net、G-HOP、SAM 3D 的定性比较显示当前 CAD-free reconstruction 在透明 / 重遮挡对象上常生成错形状,但这些方法是视频重建或不同任务,没有统一定量协议,不能据此得出 HOPformer 普遍优于所有 CAD-free 方法。
5.4 Loss 设计
每只手:
L h = λ 2 D L 2 D + λ 3 D L 3 D + λ θ L θ + λ β L β + λ T L T . L_h=\lambda_{2D}L_{2D}+\lambda_{3D}L_{3D}+\lambda_\theta L_\theta+\lambda_\beta L_\beta+\lambda_TL_T. L h = λ 2 D L 2 D + λ 3 D L 3 D + λ θ L θ + λ β L β + λ T L T . 对象:
L o = λ 3 D L 3 D + λ 2 D L 2 D + λ T L T + λ c L c + λ ω L ω . L_o=\lambda_{3D}L_{3D}+\lambda_{2D}L_{2D}+\lambda_TL_T+\lambda_cL_c+\lambda_\omega L_\omega. L o = λ 3 D L 3 D + λ 2 D L 2 D + λ T L T + λ c L c + λ ω L ω . 接触帧增加 L_int,分别约束 right-object 与 left-object CDev。总损失 L=L_r+L_l+L_o+L_int。除 object rotation 使用 geodesic loss、classification 使用相应分类目标外,正文称其余主要为 MSE。
所有 λ 默认 1,但 hand 2D 为 5、right / object 3D 为 5、hand pose / left 3D 为 10、hand shape / class 为 0.001。左右手 3D 权重写法不完全对称,复现应以公开 config 为准,而不是只按正文一句话重建。
5.5 Weak-perspective translation
网络不直接在完整透视模型下优化 metric translation,而是回归 weak-perspective camera parameters,再用固定 focal 转 translation:ARCTIC 1,000、EPIC 5,000(论文 supplement 的训练 convention)。这种设计继承 ArcticNet 系列,便于 root-relative hand-object reconstruction,但会把 focal / crop scaling convention 的不一致直接变成 absolute depth bias;官方仓库的 EPIC known issue 正发生在这里。
6. 训练流程与数据依赖
6.1 三阶段训练链
ARCTIC exocentric pretraining:8 个外部视角,总 batch 256(4×GH200,每 GPU 64),25 epochs;LR 先从 1e-7 warm up 到 5e-5,再 cosine decay。
ARCTIC egocentric fine-tuning:从 p1 checkpoint 初始化,总 batch 128,每 GPU 32,最多 30 epochs,peak LR 3e-5,early stopping。
EPIC-Contact fine-tuning:从 ARCTIC egocentric checkpoint 初始化,相同 batch / LR 口径,最多 125 epochs。
DINOv2 backbone 冻结;公开实现要求 Python 3.10、PyTorch 2.5.1、CUDA 12.6,并需要手工修改 smplx 让模型返回 21 hand joints。WiLoR code 已 vendored,但仍要单独获取 non-commercial weights 与 MANO assets。
6.2 “in-the-wild”不是只用野外数据训练
Table 4 是关键:
EPIC training CDev ↓ MRRPEro ↓ MDev ↓ MPJPE ↓ SR@0.05 ↑ SR@0.1 ↑ scratch 24.4 99.5 19.5 54.8 3.9 24.2 ARCTIC init 20.7 65.8 11.4 19.9 29.8 69.7
成功率从 3.9% 到 29.8%,手 MPJPE 从 54.8 降到 19.9 mm,说明 2.1M-frame ARCTIC MoCap pretraining 是决定性因素。EPIC-Contact 当前规模足以 fine-tune / benchmark,但尚不足以从零学出同等模型。这不削弱数据集价值,却限制“只靠 scalable contact annotation 即可摆脱 lab data”的外推。
7. 指标定义:为什么不能只看一个 SR
7.1 手—物相对几何
CDev (mm) :对应 hand-object contact vertex pairs 的平均距离。EPIC symmetry-aware 版本改为对接触手顶点找 predicted object mesh 最近点,因此对 surface sliding 更宽容。MRRPE rl / ro (mm) :right–left hand root 与 right hand–object root 的相对位置误差。EPIC 每段只有一只手,rl 无效。MDev (mm) :stable-contact window 中手与固定对象局部 patch 的逐帧运动差异;对称版本允许等价初始化,但若接触点随时间滑动仍会惩罚。ACC h/o :手 / 物顶点 acceleration difference。EPIC object 部分做 symmetric nearest-vertex matching。
这些指标主要回答“手和对象是否彼此位置合理、接触是否稳定”,不是单独对象相机 pose 的完整评价。
7.2 手与对象
MPJPE :21 hand joints root-aligned 3D error。AAE :articulated object average articulation error,仅 ARCTIC 有意义。SR@0.05 / 0.1 :移除 object root 后,顶点落在 object diameter 5% / 10% 距离内的比例。EPIC 用 closest GT vertex,等价于 ADD-S 风格 symmetry-aware protocol。Cls :object class accuracy,与 pose 指标分开报告。
因为 SR 去 root,translation 的绝对偏差不会进入;MRRPEro 测 hand-object relative root,也无法单独识别整个 hand-object scene 沿 camera z 的共同尺度偏差。这正是 EPIC checkpoint absolute-depth issue 不影响 Table 2 的原因。
7.3 ACC 的时间单位问题
论文表头写 m/s²,但 EPIC clips 混合 native fps 且有 dropped frames。公开 evaluator 固定按 15 fps 计算,官方 README 明确要求只把它理解为 relative smoothness score。跨数据或真实物理运动比较时,不能把 2.5 / 4.1 当作精确 SI acceleration error。
8. 主结果审计
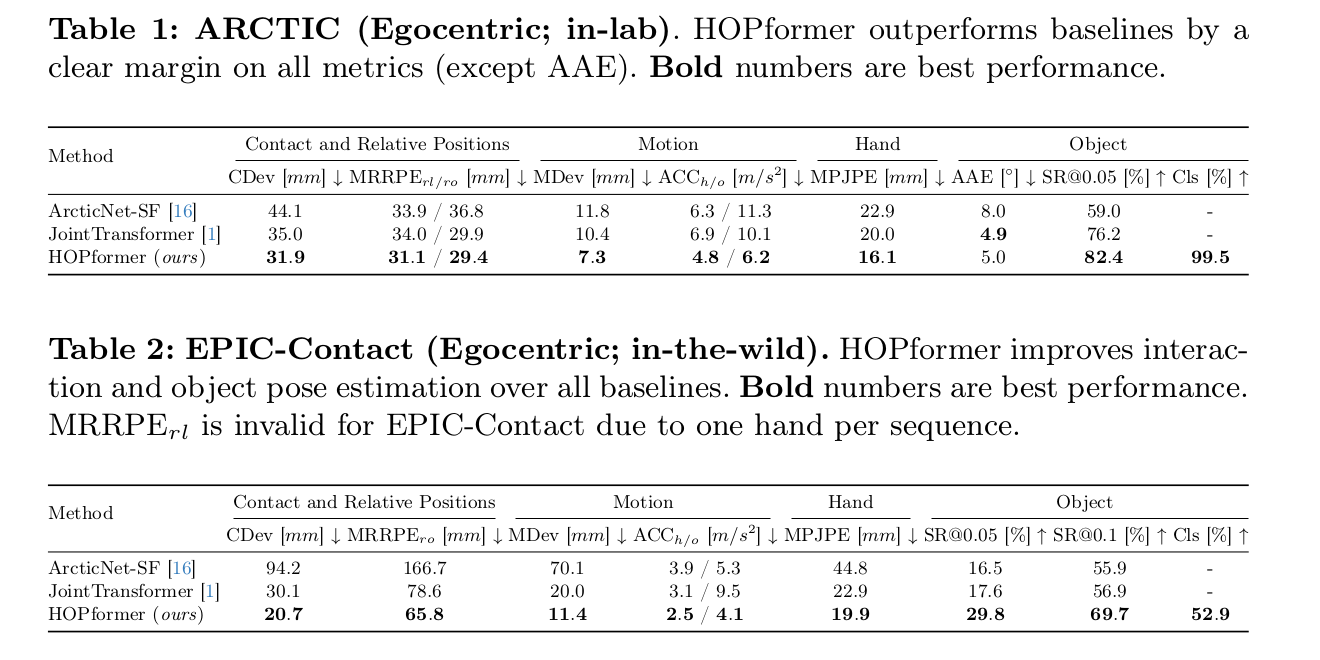
原论文 Tables 1–2:两表的对象 SR 都是 root-aligned,但 EPIC 进一步使用 symmetry-aware 版本;EPIC pose 行使用 oracle mesh,而 52.9% 是独立分类准确率。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
8.1 ARCTIC egocentric
指标 ArcticNet-SF JointTransformer HOPformer 对最强 baseline CDev ↓ 44.1 35.0 31.9 -3.1 mm / -8.9% MRRPE rl / ro ↓ 33.9 / 36.8 34.0 / 29.9 31.1 / 29.4 -2.9 / -0.5 mm MDev ↓ 11.8 10.4 7.3 -3.1 mm / -29.8% ACC h/o ↓ 6.3 / 11.3 6.9 / 10.1 4.8 / 6.2 均改善 MPJPE ↓ 22.9 20.0 16.1 -3.9 mm / -19.5% AAE ↓ 8.0 4.9 5.0 +0.1°,非最佳 SR@0.05 ↑ 59.0 76.2 82.4 +6.2 points
论文正文准确地说“除 AAE 外都最好”。由于同一批 ARCTIC objects 跨 train / validation,这张表主要验证 architecture 和 in-distribution interaction modeling,而不是新实例 / 新类别泛化。
指标 ArcticNet-SF JointTransformer HOPformer 对 JointTransformer CDev ↓ 94.2 30.1 20.7 -9.4 mm / -31.2% MRRPEro ↓ 166.7 78.6 65.8 -12.8 mm / -16.3% MDev ↓ 70.1 20.0 11.4 -8.6 mm / -43.0% ACC h/o ↓ 3.9 / 5.3 3.1 / 9.5 2.5 / 4.1 均改善 MPJPE ↓ 44.8 22.9 19.9 -3.0 mm / -13.1% SR@0.05 ↑ 16.5 17.6 29.8 +12.2 points / 1.69× SR@0.1 ↑ 55.9 56.9 69.7 +12.8 points Cls ↑ — — 52.9 无 baseline
“对象成功率明显提高”成立;“已经很高”不成立。严格 5% threshold 下 29.8% 仍意味着多数样本失败。10% threshold 的 69.7% 也显示结果对容差很敏感。
8.3 headline 的 baseline 选择
摘要写“nearly doubles the success rate while reducing contact deviation by 75%”,没有紧邻说明 baseline。按 Table 2:
对 ArcticNet-SF:SR 16.5→29.8,1.806×;CDev 94.2→20.7,下降 78.0%,与摘要近似。
对 JointTransformer:SR 17.6→29.8,1.693×;CDev 30.1→20.7,下降 31.2%。
而正文明确称 JointTransformer 是“same backbone / best direct comparison”。所以专题页不应只复述摘要的 75%,必须同时给出 strongest-baseline 口径。
8.4 oracle mesh 与 correct-class subset
Table 2 用 oracle mesh。Supplement Table 7:
范围 CDev MRRPEro MDev MPJPE SR@0.05 SR@0.1 complete data,oracle class 20.7 65.8 11.4 19.9 29.8 69.7 only correctly classified subset 20.2 64.5 11.4 18.4 30.4 68.4
子集略容易,数字相近并不意外。分类错误时作者因 topology 不同而不计算 pose,约 47.1% 样本因此没有进入“自动 pose”分数。要评价完整系统,更合适的指标应把 wrong-class 视作 failure,或用跨 mesh surface matching / detection-pose AP;论文没有给出。
9. 消融与因果证据
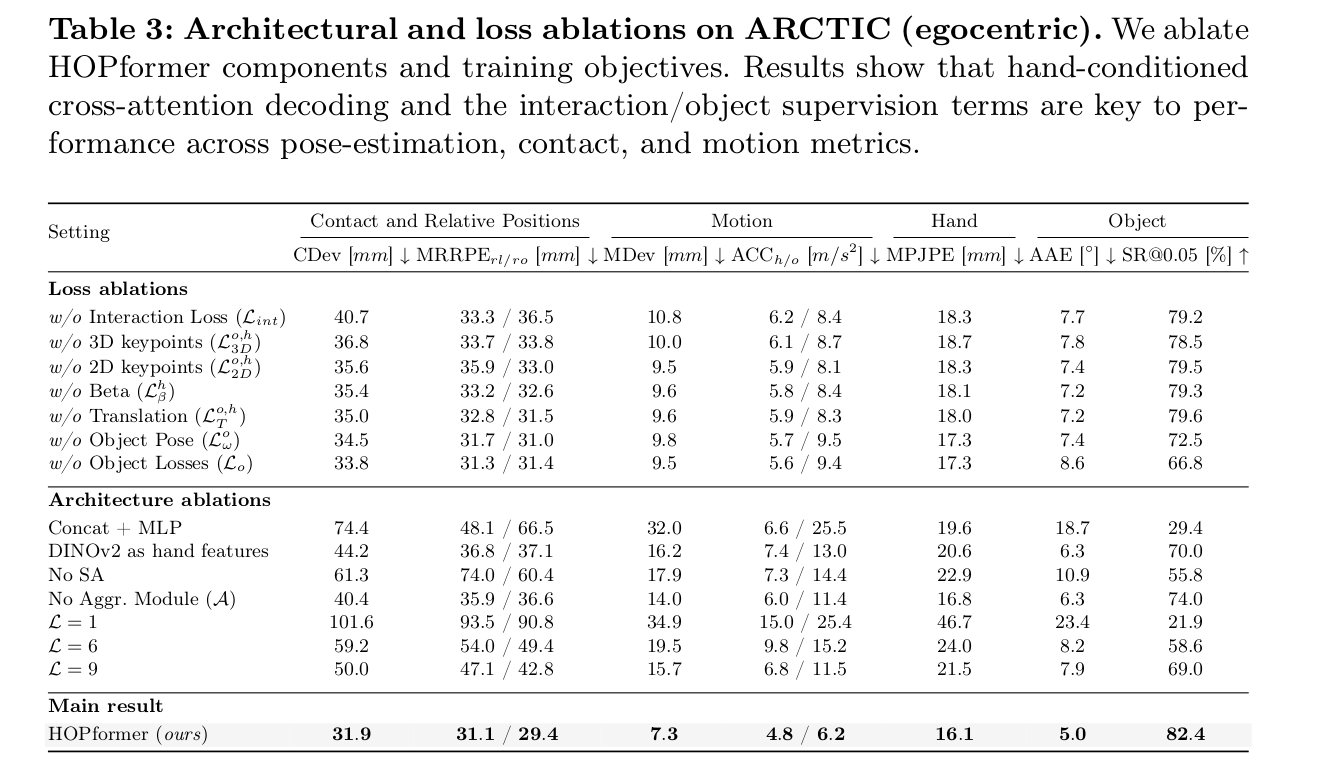
原论文 Table 3:所有消融在有 MoCap 真值的 ARCTIC egocentric split 完成。最强反事实是 concat + MLP、no self-attention 与浅层 decoder 的大幅退化。来源:arXiv 。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
9.1 Interaction 与 object supervision
无 L_int:CDev 31.9→40.7、MDev 7.3→10.8,而 SR 82.4→79.2;interaction loss 主要改善接触 / 运动物理一致性,而非只刷 pose metric。
无 L_oω:SR 82.4→72.5;无全部 L_o:66.8,AAE 5.0→8.6,说明对象直接监督不可被 hand prior 替代。
无 3D keypoints:MPJPE 16.1→18.7,是 hand accuracy 的最大 loss ablation。
9.2 Cross-attention 不是普通融合
Concat + MLP 使用相同 backbone,却得到 CDev 74.4、MDev 32.0、SR 29.4。相对 full model 下降 53 points,说明“逐层 query–memory interaction”确实是主贡献,不只是多加参数 head。但论文没有给出 concat baseline 的严格 parameter / FLOP matched 细节;部分差距也可能来自 optimization capacity。
9.3 Pose-specialized hand prior
把 WiLoR token 换成 DINOv2 hand crop token:MPJPE 16.1→20.6、CDev 31.9→44.2、SR 82.4→70.0。手本身更差、对象也同步更差,支持 error propagation 与 positive conditioning 两面性:高质量 hand prior 能帮对象,错误 hand prior 同样会误导对象。
9.4 深度与计算量
decoder L=1/6/9/12 的 SR 为 21.9 / 58.6 / 69.0 / 82.4;CDev 101.6 / 59.2 / 50.0 / 31.9。性能随深度持续改善,未出现轻量饱和点。论文的 1.83B parameters 与 1.157 TFLOPs 因而不是偶然副作用,而是达到主结果的组成部分。
9.5 泛化消融缺口
所有 loss / architecture ablation 都在 ARCTIC。EPIC 主结果表明完整模型能迁移,但没有回答:
在 EPIC 上去掉 WiLoR 是否仍有同等幅度?
contact loss 对 noisy EC-fit labels 是否可能过拟合?
transparent / reflective classes 分别受益多少?
9 类中哪类 classifier 最容易错、错分类如何影响可用性?
这些问题决定“手先验为何帮助 in-the-wild”,目前仍靠从 ARCTIC 反事实向 EPIC 外推。
10. 官方仓库已知问题:尺度与绝对深度
截至 2026-08-23,HOPformer 官方 README 的 Known issues 记录了 EPIC checkpoint projection-scale bias:
EPIC weak-perspective target 构造用 height-scaled f_y=2333.33;
hand / object head 解码用 average focal 1822.40;
比例 2333.33/1822.40≈1.28,所以 projected meshes 中位尺度约 1.28×;
absolute depth 中位数约为 GT 的 0.78×。
官方 issue 的 correction sweep 没找到无代价的 inference-only correction。一个 shared-scene translation workaround 可恢复中位 projection scale / depth,但平均 2D hand-joint error 增加约 3.4 px。ARCTIC 用 square inputs,f_x=f_y,不受影响。
10.1 为什么论文数字仍可复现
Table 2 主要指标是:
root-aligned hand MPJPE;
hand-object relative root MRRPE;
root-removed object SR;
hand-object contact / motion relative metrics。
共享 scene scale / depth bias 不会直接改变这些 root-aligned / relative 量;baseline 也使用同一 convention。仓库发布 prediction dumps 和 reference aggregate JSON,可精确复现 Table 2。因此正确表述不是“论文结果无效”,而是:
论文比较仍能支持 HOPformer 相对 baseline 的 interaction / root-aligned pose 改进;但发布 EPIC checkpoint 的绝对相机深度与投影尺度存在已知偏差,主表没有覆盖这一部署维度。
10.2 对 6D pose 读者的实际影响
标准机器人抓取、AR overlay 或 camera-frame object pose 往往需要 metric T=[x,y,z]。如果只复现 Table 2,会漏掉 z 与投影尺度问题。实际使用至少应:
用 camera-space translation / ADD(-S)(不去 root)单独验证;
检查 crop resize 后的 intrinsics 与 focal convention;
报 2D reprojection、absolute depth、relative hand-object geometry 三组指标;
不把 workaround 后的 pose 和原论文主表混成同一 checkpoint 口径。
11. 失败案例与局限
11.1 数据侧
人工标注每个 centre frame 约 3–4 分钟,2.3K clips 仍是有成本的数据工程,不是无限扩展。
单帧标注传播到 clip;低 confidence 可过滤,但论文没有给出按 confidence 分桶的 pose / training 曲线。
30-object scale validation 太小,且 VLM 非均匀缩放可能生成现实中不完全刚性的 template 形变。
EPIC penetration volume 明显高于 ARCTIC;最大深度接近不能掩盖接触区域更广的 interpenetration。
类别严重不平衡,最少 saucepan 72 clips、最多 pan 492 clips。
11.2 方法侧
fixed model pool:mesh retrieval 是系统必要步骤,未知类别 / 错 mesh 时 pose 未定义。
EPIC classifier 只有 52.9%,主表没有把这个前端瓶颈乘入最终成功率。
强 hand prior 可能压过物体视觉。论文 failure case 中 plate 被倾向估成平放,显示 dataset prior 可产生 plausible but wrong pose。
单帧模型没有利用视频中真实 temporal evidence,尽管数据与 MDev 本身是时序的。
EPIC 只验证单手 rigid objects;野外双手、关节物体留作未来工作。
1.83B / 1.157 TFLOPs / GH200 profiling 距移动 AR/机器人端侧较远。
11.3 结论侧
“SOTA”只针对论文重训的 ArcticNet-SF、JointTransformer 和给定 protocol;并非与所有 hand-object / CAD-free 方法统一定量比较。
“in-the-wild”描述数据来源与场景复杂度,不代表 open-world categories。
“fully automatic”需要加限定:classification correct subset,而非完整测试集。
“success rate”是 root-aligned、diameter-normalized vertex metric,不是完整系统任务成功率或抓取成功率。
12. 计算、开放资源与许可
12.1 Profiling
单个 NVIDIA GH200 120GB、batch 1、输入预载 GPU,30 warmup + 300 timed iterations、显式 CUDA synchronization:
parameters:1.83B;
FLOPs:1.157 TFLOPs / sample;
peak allocated memory:7.01 GiB;
latency P50 / P95:106.63 / 165.89 ms;
throughput:9.12 samples/s。
这比 EC-fit / optimisation baselines 的 >10 s 快两个数量级,但不是完整数据加载、检测、可视化或通信延迟;也不能把 9.12 FPS 直接外推到消费级 GPU。
12.2 复现材料
公开仓库包含:
ARCTIC / EPIC training、prediction extraction 与 evaluator;
p1 / p2 / EPIC checkpoints;
ARCTIC p2 与 EPIC per-sample prediction dumps;
reference aggregate metric JSON 与各列 key 映射;
环境 pin 和数据目录规范。
这比只放 inference demo 的开源更扎实。但 EPIC dataset、models 与 prediction dumps 是 gated;ARCTIC、MANO、WiLoR 都需各自申请或下载,完整 reproduction 仍有多重依赖。
12.3 许可边界
HOPformer code:CC BY-NC 4.0;
EPIC-Contact 与 checkpoints:CC BY-NC 4.0、gated;
vendored WiLoR code:CC BY-NC-ND 4.0;
WiLoR weights、MANO、ARCTIC:保留各自 non-commercial terms。
因此“代码公开”不等于可商用,也不意味着可自由修改 / 再分发所有依赖。用于产品前必须逐项做 license review。
13. 复现与改进建议
13.1 最小可信复现
先下载官方 EPIC prediction dump,运行 evaluator 对齐 Table 2,确认 metric keys:cdev_sym/ho、mdev_sym/h、adds_success/0.05、mrrpe/r/o、mpjpe/ra/h、obj_cls_acc。
用发布 checkpoint 重跑同一 split,确认 FP precision、crop / focal 与 data version。
额外计算 absolute depth、camera-space ADD-S 与 2D reprojection,显式重现 known issue。
分别报告 oracle mesh、correct-class subset 和“wrong class counted as failure”的全量系统指标。
按 object class、occlusion、transparency、confidence 与 VLM scale error 分桶。
13.2 值得继续做的研究方向
mesh uncertainty :不要在 classifier argmax 后硬取一个 mesh,可对 top-k classes / shapes 联合维护 pose hypotheses。absolute geometry calibration :把 intrinsics-aware perspective translation 与 crop transform 写进模型 / loss,避免 weak-perspective focal convention 漂移。时序模型 :利用 stable grasp video 的真实运动和 contact invariance,而不是只把时间用于 metric 与标签传播。contact uncertainty :把 κ、propagation confidence 与 EC-fit residual 变成 per-vertex / per-frame loss weights。CAD-free bridge :在可靠 mesh pool 与纯生成之间加入 retrieval + deformation / category shape basis,处理新实例几何差异。更多类别与双手野外数据 :当前 9 类单手 EPIC 是起点,不足以支撑 household-scale open-world hand-object pose。
14. 最终评价
论文真正成立的结论
在 ARCTIC 同实例受控环境中,hand-conditioned deep decoder 明显优于两条重训 baseline,除 AAE 外所有主指标最好。
在 EPIC-Contact 已知类别新实例上,给定正确 mesh 时,HOPformer 对最强 baseline 的 CDev、MDev、MPJPE 与 root-aligned SR 均明显改善。
接触标注 + EC-fit 能以较低人工交互构建可用于训练的野外 3D hand-object 数据,且在 ARCTIC 模拟中 noisy labels 与 GT training 的结果接近。
cross-attention、WiLoR hand prior、self-attention、aggregation 与 decoder depth 都有方向一致的消融支持。
仍未成立的更大结论
不是 open-category、CAD-free 或任意对象 pose;
没有证明完整测试集 fully automatic pose,因为 Cls 只有 52.9%;
没有凭 Table 2 证明绝对 camera-space 6D translation;
没有证明移动端实时或大规模类别扩展;
没有逐项证明 EPIC 上的增益来自哪一个 architecture component。
对 6D object pose 研究者而言,这篇论文最有价值的启发是:手不是纯遮挡,而是一个可学习的几何条件;但一旦把手、mesh identity、weak-perspective camera 和接触指标引入系统,就必须把 oracle 条件、相对坐标与绝对 pose 分开报告。