论文精读笔记:HRDexDB: A Paired Human-Robot Dataset for Cross-Embodiment Dexterous Grasping
1. 基本信息
2. 一句话定位
HRDexDB 用统一的 23 视角采集空间,把自然人手抓取与四种机器人灵巧手的语义对应抓取配成 2.1K 条序列;它以 3D 手部、对象 6D 位姿、机器人状态、触觉和成功标签为共同接口,使“人类抓取意图如何跨形态迁移”与“交互遮挡下如何做几何感知”可以在同一数据资源上研究。
方法输入与输出
HRDexDB 的主产物是数据集,没有一个涵盖所有实验的统一在线输入输出。以下按采集系统和下游方法分别列出。
| 项目 | 内容(本站整理) |
|---|
| 采集输入 | 23 路同步 RGB、相机标定、物体 CAD、MANO / 机器人运动学,以及配对抓取过程中的机器人关节状态、适用平台的触觉记录。 |
| 最终输出 | 对齐的图像序列、3D 手部 / 机器人状态、物体刚体位姿、触觉与成功标签,以及人类-机器人抓取配对关系;这不是直接生成机器人控制动作的策略。 |
| 训练输入 | 接触迁移基线使用配对的人手 / 机器人抓取表示和物体点云;检索基线使用配对的手-物体几何。感知基线使用相应图像观测及标注,不能将采集时全部传感器默认视为模型输入。 |
| 训练目标 | 接触迁移监督机器人逐点 contact / part maps;检索以对比学习对齐配对 embedding;手部与对象感知分别监督各自的 3D 输出。数据采集流程本身不对应一个统一训练 loss。 |
| 推理输入 | 接触迁移读取人类 contact / part maps 与物体点云;检索读取人手-物体抓取几何和候选库;感知推理条件随具体 baseline 而定。 |
| 推理输出 | 迁移模型给出机器人 contact / part maps,检索模型给出候选排序;最终可执行抓取还需要 CEDex / BODex 等优化后端,不能归给接触预测网络。 |
| 输出细节 | 物体 pose 是标定空间中的刚体变换,使用前须依据数据文件约定核对相机 / 全局坐标及长度单位。接触概率是 N 个物体点上的标量,part map 按目标手部位编码;不同模态不能混为一个 6D 向量。 |
| 必要条件 | 多视角、CAD 与运动学主要是高质量采集标注依赖;测试时允许哪些模态由任务协议决定。人机配对表达抓取意图对应,不保证逐帧关节轨迹相同。 |
依据:论文采集系统与 Section 4 下游任务。
2.1 论文图表导读
| 图表 | 内容 | 阅读重点 |
|---|
| Figure 1 | 数据集总览 | 100 个物体、5 种 embodiment、23 个 RGB 视角与多模态标注共同构成数据价值 |
| Table 1 | HOI / ROI / HROI 数据集比较 | HRDexDB 的差异点是人机配对、灵巧机器人手、物体 6D pose、触觉和密集多视角同时存在 |
| Figure 2 | 采集与重建流水线 | 3D 手和对象位姿依赖多视角与预训练模型组合,不是简单传感器直读 |
| Figure 3、Table 2 | 接触图迁移 | 直接套人手接触图并不可靠,robot-specific contact representation 在真实抓取上收益更大 |
| Figure 4、Tables 3—4 | 跨形态抓取检索 | 检索既测配对识别,也作为 BODex 优化初值;top-1 与 top-5 存在精度—覆盖权衡 |
| Tables 5—6 | 3D 手部估计 | HRDexDB 比 FreiHAND 更具挑战,且少量混入训练集能提供互补信号 |
| Tables 7—8 | 对象 6D 位姿 | 所有方法在机器人抓取帧上退化;HRDexDB 微调 MegaPose refiner 后可改善独立机器人环境 |
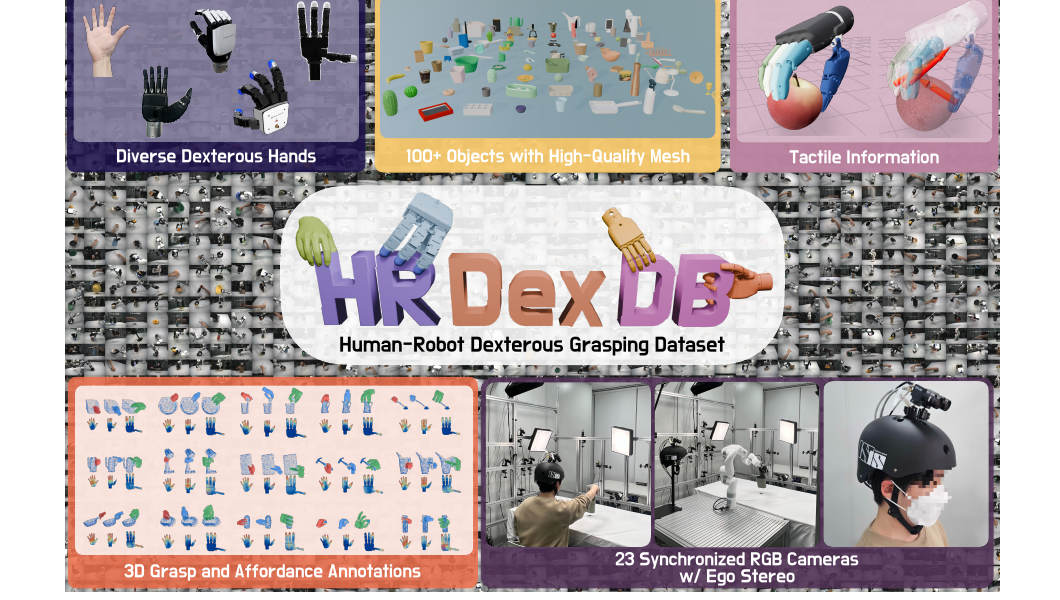 原论文 Figure 1:多种人手 / 机器人手、100 个物体、触觉、3D 抓取标注和 23 路同步 RGB 视角的总体设计。来源:arXiv v2 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
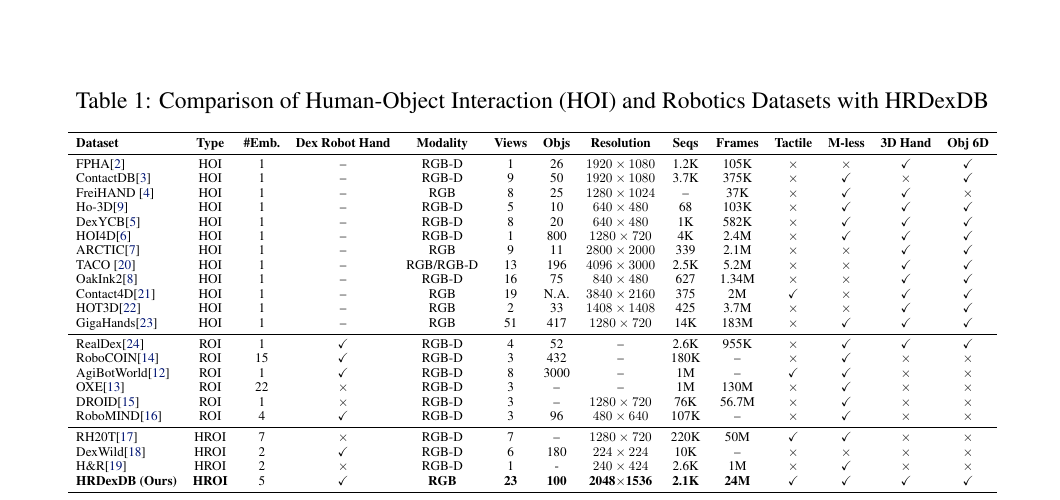 原论文 Table 1:HRDexDB 与 HOI、ROI、HROI 数据集在 embodiment、灵巧机器人手、视角、对象数、序列、帧数、触觉、无标记采集、3D 手和对象 6D 位姿上的比较。来源:arXiv v2 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
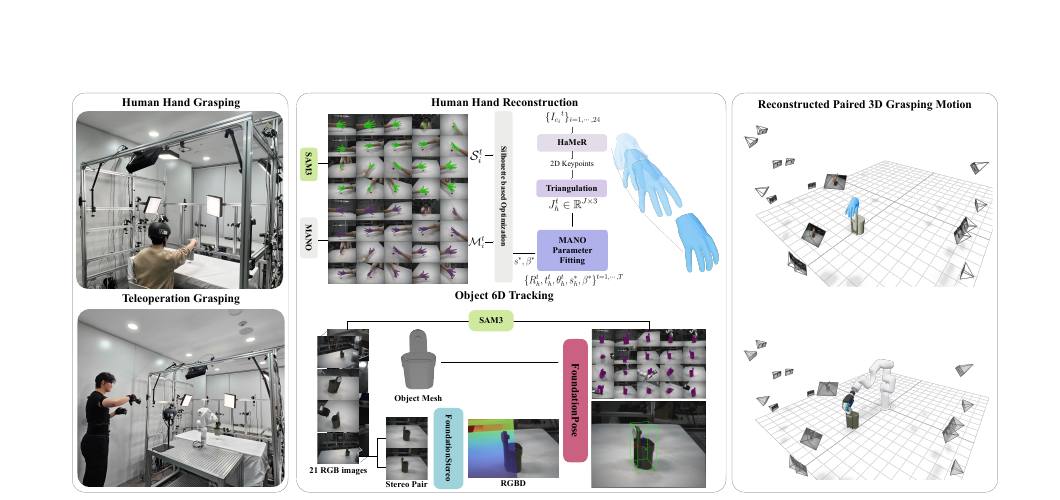 原论文 Figure 2:左侧为自然人手与机器人遥操作采集,中间为人手 MANO 重建和对象 6D tracking,右侧是在统一标定空间恢复的配对 3D 抓取运动。来源:arXiv v2 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定:这里的 paired 到底是什么
3.1 五种 embodiment
HRDexDB 覆盖人手以及四种机器人灵巧手:
- Allegro Hand V4
- Allegro Hand V5 Plus
- Inspire Hand RH56DFTP
- Inspire Hand RH56F1
它们的自由度、指节长度、可达接触区域、关节限制和传感器都不同。直接把人手 MANO pose retarget 到机器人关节通常会产生穿模、不可达或抓取不稳,因此数据集不把“姿态一模一样”当配对标准。
3.2 语义配对协议
每个配对样本分两阶段采集:
- 人类在给定物体上执行自然抓取;
- 遥操作员观察人类抓取,再控制目标机器人手完成语义对应的抓取。
配对保留的是抓取意图与功能,例如“从杯身侧面稳定握持”,而不是要求相同的关节轨迹或逐点接触。这个选择是合理的:形态不同意味着严格运动学同构通常不存在。但它也限定了监督强度,论文无法从配对标签本身回答两个动作在何种数学意义上“功能等价”。
3.3 每条序列的信号
可以把人类序列概括为:
H={It1:23, θtMANO, TO→C,t, y}t=1T,
机器人序列概括为:
R={It1:23, qt, TO→C,t, Ft, y}t=1T.
其中 It1:23 是 21 个外部相机与 2 个第一视角相机的同步 RGB,θMANO 是人手姿态,qt 是机器人关节状态,TO→C,t∈SE(3) 是对象到相机 / 全局标定空间的刚体变换,Ft 是平台可用时的触觉,y 是成功 / 失败标签。
4. 采集系统
4.1 多视角与第一视角
- 三侧相机架放置 21 个标定外部 RGB 相机。
- 人类使用定制双目头盔获取 egocentric stereo。
- 机器人使用 over-the-shoulder 双目视角,尽量接近操作主体观察方式。
- RGB 分辨率为 2048 × 1536;Table 1 报告总计约 24M 帧。
外部多视角主要服务于重建与高质量标注,第一视角则让数据可以用于更接近部署条件的感知 / 策略研究。两者不能混成一个输入协议:若模型只使用 ego RGB,不能把外部 21 视角带来的标注质量当作测试时可用信息。
4.2 机器人遥操作
论文使用 Xsens 惯性动捕服与 MANUS 手套采集操作者上肢和手部动作,再映射到机器人。遥操作员不是机械复制人类示范,而是在目标机器人运动学和接触能力下重新实现抓取意图。
这带来两个效果:
- 配对样本保留 embodiment-specific adaptation,适合学习跨形态表示;
- 操作者经验会进入数据分布,成功样本并非独立于遥操作策略。
4.3 数据规模如何理解
| 统计项 | 数值 | 含义 |
|---|
| objects | 100 | 固定对象实例,配有高质量 mesh / CAD |
| sequences | 约 2.1K | 人类与机器人抓取序列合计 |
| embodiments | 5 | 1 种人手 + 4 种机器人手 |
| RGB views | 23 | 21 个外部 + 2 个第一视角 |
| frames | 约 24M | 多视角展开后的图像帧总量 |
“24M 帧”包含同一时刻的多相机观测,因此不能等价为 24M 个独立动作状态。训练 / 划分时应按 sequence、object 和 paired episode 分组,避免把同一时刻的相邻视角拆进训练集与测试集造成泄漏。
5. 标注与重建链路
5.1 人手 3D 重建
- HaMeR 在每个视角估计 2D 手部关键点;
- 利用相机标定做多视角三角化,得到 3D joints;
- 优化 MANO pose,使投影关键点与三角化结果对齐;
- 通过 SAM3 手部 mask 的轮廓对齐估计 subject-specific shape;
- 使用时序滤波减少逐帧抖动。
优势是无标记、不会让实体 marker 干扰自然接触;代价是 HaMeR、SAM3、三角化和 MANO 模型误差会串联。特别是在指尖被物体长期遮挡时,输出受模型先验影响,而不仅是图像证据。
5.2 对象 6D 位姿
对象位姿流水线为:
- 在指定双目相机对上用 FoundationStereo 预测深度;
- 用 SAM3 获取对象 mask;
- 将对象 CAD、RGB-D 和 mask 送入 FoundationPose,完成首帧全局 registration 与后续 tracking;
- 把 mesh 按当前 TO→C 渲染到全部标定视角;
- 最小化多视角 silhouette mismatch,减少单视角跟踪漂移。
一个抽象的跨视角精修目标是:
Lsil(T)=v=1∑21d(Πv(TMO), Mv),
其中 MO 是对象 mesh,Πv 是第 v 个相机投影,Mv 是对象轮廓,d 是轮廓不一致度。多视角约束能过滤单视角遮挡歧义,但依然依赖 CAD 尺度、mask 质量、双目深度和 FoundationPose 初始化。
证据边界:论文提供的是 object 6D pose annotations,并展示其下游有效性;它没有报告与外部光学动捕、机器人末端标定物或人工逐帧复核相比的绝对位姿误差。因此本站不把这些标签表述为独立测量、计量级 ground truth。
6. 下游一:人到机器人接触图迁移
直接把人手接触区域作为机器人抓取目标,忽略了手掌尺寸、手指数量、可达空间和关节限制。作者为物体点云预测:
- 接触概率 C;
- 接触部位分布 P;
- 针对 Inspire-F1 和 Allegro-V5 的 robot-specific target maps。
对象特征由 PointNet++ 提取;接触概率使用加权 L1,部位图使用交叉熵。预测得到的机器人接触图再交给固定的 CEDex 物理感知优化器合成抓取。
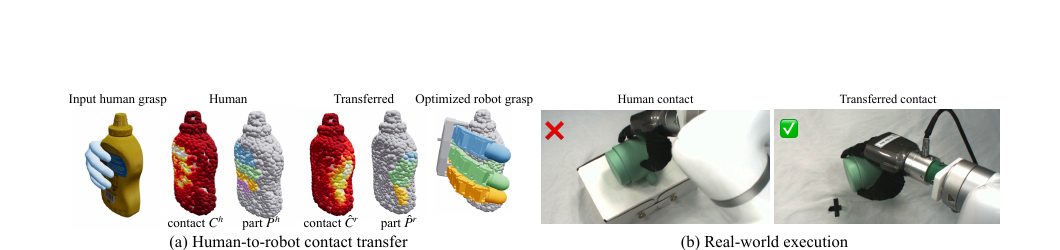 原论文 Figure 3:把人手 contact / part maps 转换为机器人形态对应的接触图,并作为 grasp optimization 目标;右侧展示直接使用人类接触失败、迁移后成功的真实案例。来源:arXiv v2 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
| 接触目标 | Inspire sim / real | Allegro sim / real |
|---|
| Human-Contact | 54.6 / 66.7 | 60.2 / 63.3 |
| Transferred | 55.6 / 73.3 | 65.8 / 80.0 |
仿真提升较小,真实 Allegro 提升最明显,为 16.7 个百分点。这个结果支持“接触表示需适配机器人形态”,但真实试验量为 Inspire 60 次、Allegro 30 次,置信区间和对象级分解没有在主表中展开,不能把一次总体比例当作普遍成功率。
7. 下游二:跨 embodiment 抓取检索
作者构建 CLIP 风格的多分支点云检索模型:人手、Inspire-F1、Allegro-V5 各有独立编码器,对象使用共享编码器;对应的人—物 / 机器人—物抓取被投影到共享空间,并以对称 contrastive loss 拉近。
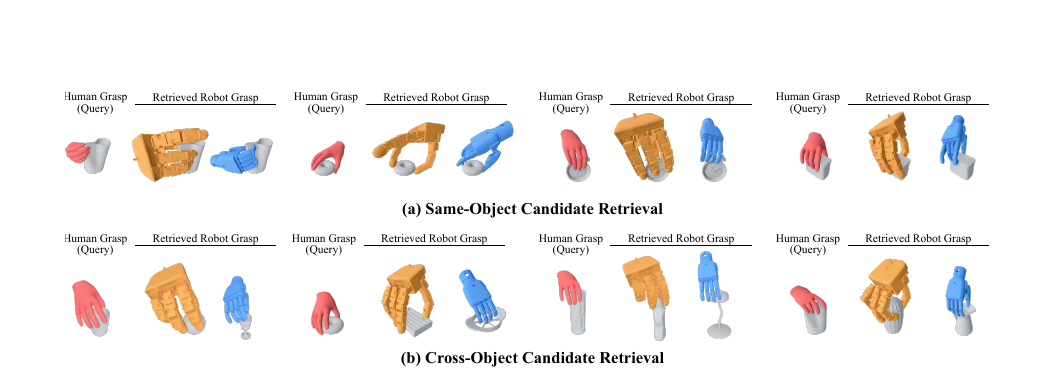 原论文 Figure 4:以人手—物体抓取为 query,从同对象或跨对象候选中检索 Inspire 与 Allegro 抓取。橙色与蓝色分别表示两种机器人手。来源:arXiv v2 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
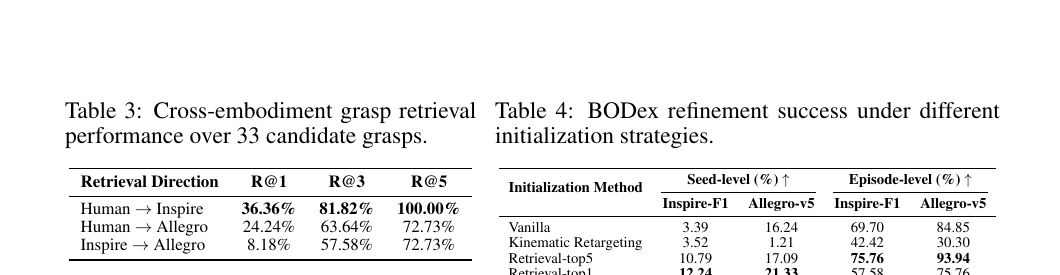 原论文 Tables 3--4:左侧是在 33 个候选抓取上的 R@1 / R@3 / R@5,右侧比较 Vanilla、运动学 retargeting、检索 top-5 与 top-1 作为 BODex 初始化时的 seed / episode 成功率。来源:arXiv v2 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
| 检索方向 | R@1 | R@3 | R@5 |
|---|
| Human → Inspire | 36.36% | 81.82% | 100.00% |
| Human → Allegro | 24.24% | 63.64% | 72.73% |
| Inspire → Allegro | 8.18% | 57.58% | 72.73% |
这不是常规图像检索的大候选库,而是 33 个候选抓取。R@5 很高仍可能对应 top-1 排序不稳定;Inspire → Allegro 的 R@1 仅 8.18%,说明两个机器人形态之间也没有天然共享表示。
检索结果随后用于 BODex refinement,测试 7 个 unseen objects、33 个 episodes、每 episode 50 个优化 seeds:
Retrieval-top1 的 seed-level 成功率最高:Inspire 12.24%,Allegro 21.33%;Retrieval-top5 的 episode-level 成功率最高:Inspire 75.76%,Allegro 93.94%。
top-1 是更强的单个先验,top-5 则用多样性提高至少一次成功的覆盖率。这是一个清晰的 precision—coverage trade-off。
8. 下游三:3D 手部姿态基准
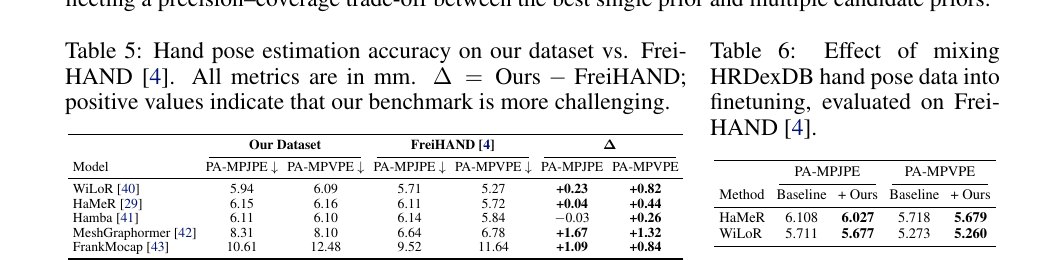 原论文 Tables 5--6:左侧比较五种手部重建方法在 HRDexDB 与 FreiHAND 上的 PA-MPJPE / PA-MPVPE;右侧是在 2.7M 样本微调集合中加入 6K 个 HRDexDB 样本后,于 FreiHAND 上的结果。单位均为 mm。来源:arXiv v2 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
| 模型 | HRDexDB PA-MPJPE / PA-MPVPE | FreiHAND | 差值 |
|---|
| WiLoR | 5.94 / 6.09 | 5.71 / 5.27 | +0.23 / +0.82 |
| HaMeR | 6.15 / 6.16 | 6.11 / 5.72 | +0.04 / +0.44 |
| Hamba | 6.11 / 6.10 | 6.14 / 5.84 | -0.03 / +0.26 |
| MeshGraphormer | 8.31 / 8.10 | 6.64 / 6.78 | +1.67 / +1.32 |
| FrankMocap | 10.61 / 12.48 | 9.52 / 11.64 | +1.09 / +0.84 |
整体上 HRDexDB 更难,尤其是 mesh vertex error;这符合交互遮挡、物体接触和复杂手形的设定。作者再把 6K 个 HRDexDB 样本混入约 2.7M 样本的组合微调集:
- HaMeR:PA-MPJPE 6.108 → 6.027,PA-MPVPE 5.718 → 5.679;
- WiLoR:PA-MPJPE 5.711 → 5.677,PA-MPVPE 5.273 → 5.260。
提升很小但方向一致,说明数据可能提供互补交互信号。由于新增样本只占组合训练集很小比例,这张表更适合作为“有用性提示”,不是完整的数据 scaling study。
9. 下游四:人手 / 机器人抓取下的对象 6D 位姿
论文给所有方法相同的 RGB + SAM3 mask + camera intrinsics + CAD 输入,并采用 BOP 风格评估。FoundPose、GigaPose、PicoPose 负责初始定位;带 refinement 的变体把前 5 个粗候选交给 MegaPose。
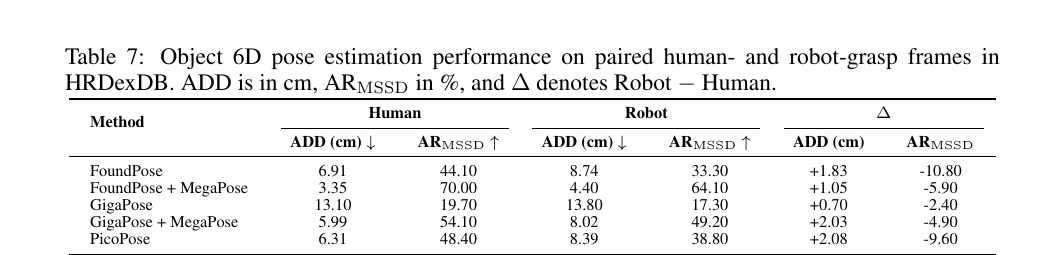 原论文 Table 7:FoundPose、GigaPose、PicoPose 及 MegaPose refinement 变体在配对人手 / 机器人抓取帧上的 ADD 与 AR_MSSD。差值为 Robot − Human。来源:arXiv v2 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
| 方法 | Human ADD ↓ / AR_MSSD ↑ | Robot ADD ↓ / AR_MSSD ↑ | Robot 退化 |
|---|
| FoundPose | 6.91 / 44.10 | 8.74 / 33.30 | +1.83 cm / -10.80 |
| FoundPose + MegaPose | 3.35 / 70.00 | 4.40 / 64.10 | +1.05 cm / -5.90 |
| GigaPose | 13.10 / 19.70 | 13.80 / 17.30 | +0.70 cm / -2.40 |
| GigaPose + MegaPose | 5.99 / 54.10 | 8.02 / 49.20 | +2.03 cm / -4.90 |
| PicoPose | 6.31 / 48.40 | 8.39 / 38.80 | +2.08 cm / -9.60 |
所有方法都在机器人抓取帧下降。论文解释为刚性机器人指节和指尖会覆盖对象边缘,也会产生与物体类似的结构。配对协议让这类 domain gap 能在相同物体与相似抓取意图下比较,比在人 / 机器人两个无关数据集上测更有解释力。
作者还用 100K 个 GSO synthetic samples 与 5.3K 个 HRDexDB robot-grasp annotations 微调 MegaPose refiner,并在与 HRDexDB 分离的 OmniRobotHome 环境上测试:
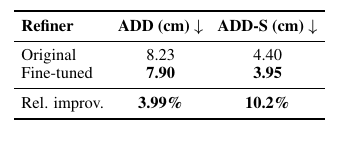 原论文 Table 8:MegaPose refiner 在加入 HRDexDB 机器人抓取标注后,OmniRobotHome 上 ADD 从 8.23 cm 降至 7.90 cm,ADD-S 从 4.40 cm 降至 3.95 cm。来源:arXiv v2 PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
ADD 相对改善 3.99%,ADD-S 相对改善 10.2%。独立环境评测比在 HRDexDB 内部微调 / 测试更有说服力;不过它仍是 refiner adaptation,不代表检测、分割、粗位姿和时序追踪的端到端系统都得到同等增益。
10. 贡献与证据是否匹配
| 主张 | 论文证据 | 判断 |
|---|
| 提供大规模配对人机灵巧抓取数据 | 100 objects、2.1K sequences、24M frames、5 embodiments | 充分;但帧数包含多视角展开,独立动作状态少于 24M |
| 支持跨形态抓取迁移 | 接触图迁移真实实验、检索与 BODex 初始化 | 有效的 proof of concept;平台、对象与真实试验量仍有限 |
| 支持交互中心的 3D 感知研究 | 手部 pose benchmark、对象 6D pose benchmark | 充分展示任务可行性;标注绝对精度仍需外部审计 |
| 机器人手比人手造成更难的位姿条件 | 五种方法在人 / 机器人配对帧上的一致退化 | 证据较强;最好进一步按遮挡率、对象材质和机器人手型分层 |
| 数据可改善外部机器人域 | OmniRobotHome 上微调 MegaPose refiner | 有支持,但当前只验证一个 refiner 与一个外部系统 |
11. 优点
- 配对单位选得合理:用语义对应替代不成立的关节一一映射,为不同形态保留可执行空间。
- 采集与下游接口统一:相机标定、对象 CAD、对象位姿、人手 / 机器人状态让同一序列可用于操作和感知。
- 不回避机器人域难点:位姿基准直接量化机器人刚性手结构带来的遮挡差距。
- benchmark 跨层次:从 contact target、retrieval representation 到 3D hand / object perception,说明数据不是只服务单一网络。
- 开放资源较完整:项目、代码与公开数据仓库降低复现门槛。
12. 局限与潜在失败
- 触觉异质且不对称:触觉仅在机器人侧存在,不同手型的传感器布局和量程不同,难以直接训练统一 tactile encoder。
- 配对仅为语义级:没有逐时刻接触对应、严格 phase alignment 或统一功能等价度量;学习到的“对应”可能包含遥操作员偏好。
- 标注模型依赖强:SAM3、HaMeR、FoundationStereo、FoundationPose 的系统偏差可能进入标签。用这些标签评测相近模型时还需警惕 teacher-induced bias。
- 对象与环境规模有限:100 个对象、受控相机棚、以抓取为主,尚未覆盖 1000 级对象、动态环境和多阶段功能操作;论文将扩展到 1000 个对象列为未来方向。
- 下载和训练成本高:完整多视角 RGB 为 TB 级;工程上需要按 modality / object / sequence 分片,而不是默认全量复制。
- 切分泄漏风险:相邻视角、同一 episode、人机配对样本和同对象轨迹高度相关,随机逐帧 split 会严重高估泛化。
- 真实成功率样本有限:接触迁移的真实试验只覆盖两个机器人手和几十次试验,需要对象级置信区间和更多重复。
13. 对 6D 位姿研究的具体启发
13.1 从 object-centric benchmark 转向 interaction-centric benchmark
传统 BOP 风格数据多是桌面、遮挡或 clutter;HRDexDB 的对象正在被手抓住,遮挡结构与对象运动存在强耦合。机器人手的几何甚至会形成“像对象一样”的刚性边缘,因此常规 mask-conditioned pose estimator 仍会发生系统性误判。
13.2 可以利用的额外条件
- 机器人关节状态:已知 robot kinematics 时,可渲染机器人手并显式建模 occlusion,而不是把手当未知遮挡物。
- 配对人类序列:人手帧位姿更容易时,可作为同对象、相似意图下的几何先验或 teacher。
- 时序:抓取前对象暴露较多,抓取后遮挡严重;可把 pre-grasp pose 和运动连续性用于 tracking / refinement。
- 触觉:触点可约束对象表面与手指相对位置,与视觉 silhouette / depth residual 互补。
- 多视角标注、单视角部署:训练时用 21 视角提供一致监督,测试时只用 ego 或单外部视角,是自然的 privileged-information 设定。
13.3 值得补做的评测
- 按 visible ratio、手型、对象对称性、材质和接触区域分桶报告 pose;
- 用外部独立测量系统抽样验证 object pose annotation;
- 比较已知 robot-hand mesh / joint state 对遮挡建模的真实增益;
- 严格 object-held-out、operator-held-out 与 embodiment-held-out 切分;
- 区分 first-frame global localization、后续 tracking 与失跟重初始化。
14. 使用建议
- 先只下载 metadata、mesh 与低频 / 少视角子集,核验坐标系、单位、时间戳和对象 ID。
- 数据划分以 paired episode 为最小不可拆单位,并把关联的人类 / 机器人序列放在同一 split。
- 若研究 unseen-object generalization,再做 object-level held-out;不要只做 frame-level random split。
- 对对象位姿标签做跨视角 reprojection、mesh scale 与连续性检查,训练前过滤明显漂移段。
- 报告模型推理时实际使用的模态,避免把标注阶段的 21 视角写成部署阶段输入。
- 数据采用非商业许可,发布模型或衍生数据前核查许可兼容性。
15. 总结
HRDexDB 的真正贡献不是“又一个更大的抓取数据集”,而是建立了一个可以同时问两类问题的配对接口:
- 操作侧:人类抓取意图如何转移到不同机器人形态;
- 感知侧:同一物体在不同手型遮挡下,3D 手部和对象 6D 位姿为何退化、如何适配。
它的多视角标注链路和四类 benchmark 让这两个方向有了可执行起点。最需要保持谨慎的地方,是不要把语义配对理解成严格轨迹对应,也不要把模型流水线生成的 6D annotations 无条件视为独立测量真值。对研究者而言,这份数据最有价值的使用方式,是显式利用人机配对、机器人几何、时序与触觉,而不是只把 24M RGB 帧加入常规训练集。
