论文精读笔记:InstantPose: Zero-Shot Instance-Level 6D Pose Estimation From a Single View
1. 核心判断
论文:IEEE RA-L
发表关系:RA-L Vol. 10 No. 6(2025)论文,同时在 ICRA 2026 展示。站内只建一个 canonical 详情页,并从 ICRA 2026 年度专题链接到此页。
核心问题:FoundationPose / GigaPose 等新物体方法通常假设准确 CAD、完整扫描或若干张带 pose 的 support image;若现场只有一张无位姿 RGB reference,单视图重建出的残缺 mesh 是否仍足以支撑 6D pose?
核心回答:用 LRM 提供粗几何 / 纹理,不直接相信它的绝对尺度;再依靠 DINOv2 reference-query correspondence、query depth 和 scale-aware Umeyama refinement 恢复 pose。
我的判断:InstantPose 的贡献不是单视图重建本身,而是把“不完美重建资产”接到一个对尺度与几何噪声更宽容的 pose pipeline。36.83 AR 说明它在这个严格 onboarding 条件下优于所测基线,但 3.9 s 推理和 query-depth 依赖距离实时开放世界感知仍有明显距离。
2. 一句话定位
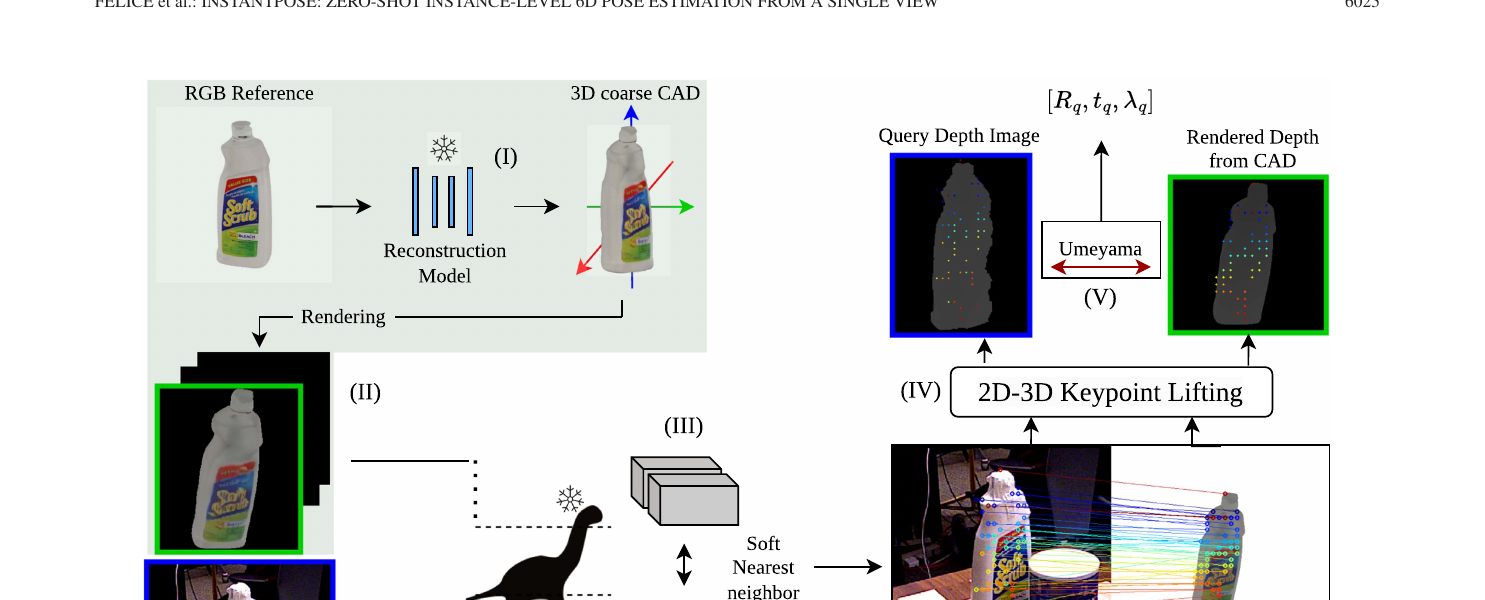
InstantPose 把一张无位姿照片变成临时对象资产:InstantMesh 造模型,400 个渲染视角提供 pose-indexed reference,DINOv2 建立像素对应,RANSAC–Umeyama 在双侧深度上同时修正 pose 与模型尺度。
2.1 图表导读
图表 应该看什么 Figure 2 单张 reference 不是直接与 query 做相对 pose,而是先重建、渲染成带 pose 的模板库。 Algorithm 1 refinement 同时估计 R , t , λ R,t,\lambda R , t , λ Table II–III 整体 AR 与对象级结果;10 个第一名不等于 21 个对象全部领先。 Figure 3、Table IV reference viewpoint → mesh quality → pose accuracy 的因果链。 Figure 5–6 抓取是可用性例证,实验性质是定性 open-loop,而非大规模 manipulation benchmark。
原论文 Figure 2:reference 先经 InstantMesh 建模并渲染模板;query 与最佳模板通过 DINOv2 特征匹配,再由双侧深度构造 3D 对应。来源:InstantPose 原论文 。图片版权归 IEEE 与论文作者所有,本站仅作学术解读展示。
3. 问题设定与“single view”的准确含义
输入包括:
一张没有相机 pose 的对象 RGB reference;
测试时一张包含对象的 RGB-D query;
query 相机内参;
预训练对象检测 / 分割、InstantMesh 与 DINOv2。
输出是 query 相机坐标中的对象 6D pose,并额外估计一个统一 scale λ \lambda λ
这里的 single view 指对象接入只需一张 reference ,而不是推理只用 RGB:query 端需要 depth。模型也会从生成 mesh 离线渲染 400 个视角,因此算法内部仍拥有多模板覆盖,只是这些模板不是现场采集并标 pose 的真实图像。
4. 单视图 onboarding
InstantMesh 从一张 RGB 生成带纹理 mesh。单图天然缺少背面、凹槽和尺度信息,输出常有:
不可见区域被先验“脑补”,几何与真实对象不一致;
细柄、孔洞、薄片等结构消失;
纹理被拉伸或复制;
模型没有可靠 metric scale 和统一 canonical orientation。
InstantPose 并不试图在 onboarding 阶段完全消除这些问题。它从生成 mesh 渲染 400 个 RGB / depth 模板,并记录每个模板的虚拟相机 pose。模板库将无位姿 reference 转换成“覆盖较广、姿态已知但几何有噪声”的中间资产。
这与直接把生成 mesh 交给 FoundationPose 的差别是:后者按准确 CAD 设计,render-and-compare 对几何误差和尺度误差更敏感;InstantPose 后续用局部语义特征和相似变换去吸收部分模型误差。
5. 模板检索与循环软最近邻
对 query I q I_q I q I r I_r I r F q , F r F_q,F_r F q , F r x q x_q x q
在 reference feature map 中找最相近位置 x ˉ r \bar x_r x ˉ r
再从 x ˉ r \bar x_r x ˉ r x ˉ q \bar x_q x ˉ q
用 ∥ x q − x ˉ q ∥ 2 \|x_q-\bar x_q\|_2 ∥ x q − x ˉ q ∥ 2
选择距离小的 correspondence。
同样的 soft nearest-neighbor 还用于给 400 个模板排序,先选出外观 / 视角接近者,再做更细匹配。DINOv2 的类别 / 部件语义比纯 RGB 纹理更能容忍生成 mesh 与真实图像的域差异。
风险也集中在这里:soft NN 是论文报告的主要耗时;若对象大面积重复纹理、强反光或准对称,feature match 会集中到错误的等价区域。mug 的细把手只有少量对应,而大面积圆柱杯身主导匹配,就是典型失败机制。
6. 从 2D 匹配到 scale-aware pose
模板像素 x r x_r x r D r D_r D r X r X_r X r x q x_q x q D q D_q D q X q X_q X q
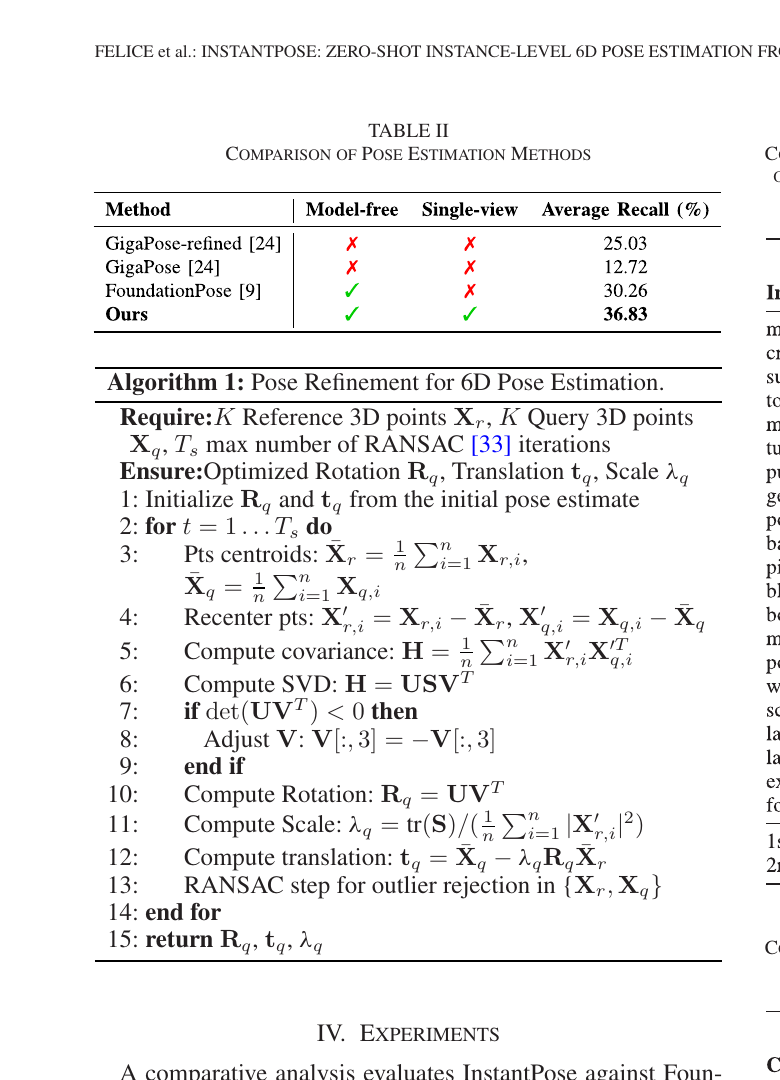
原论文 Algorithm 1:对中心化 3D 对应做 SVD,检查反射,再计算统一尺度与平移;RANSAC 反复剔除错误 DINO 对应。来源:InstantPose 原论文 。图片版权归 IEEE 与论文作者所有,本站仅作学术解读展示。
每次 RANSAC hypothesis 中,算法计算:
H = 1 n ∑ i X r , i ′ X q , i ′ ⊤ = U S V ⊤ , H=\frac{1}{n}\sum_i X'_{r,i}{X'_{q,i}}^\top=USV^\top, H = n 1 i ∑ X r , i ′ X q , i ′ ⊤ = U S V ⊤ , R = U V ⊤ , λ = t r ( S ) 1 n ∑ i ∥ X r , i ′ ∥ 2 , t = X ˉ q − λ R X ˉ r . R=UV^\top,\qquad
\lambda=\frac{\mathrm{tr}(S)}{\frac{1}{n}\sum_i\|X'_{r,i}\|^2},\qquad
t=\bar X_q-\lambda R\bar X_r. R = U V ⊤ , λ = n 1 ∑ i ∥ X r , i ′ ∥ 2 tr ( S ) , t = X ˉ q − λ R X ˉ r . 若 det ( U V ⊤ ) < 0 \det(UV^\top)<0 det ( U V ⊤ ) < 0 λ \lambda λ
7. 比较协议
论文在 YCB-V 上使用 BOP 的 VSD、MSSD、MSPD,并把三者 average recall 再平均。为比较 FoundationPose、GigaPose / GigaPose-refined,作者把同一个生成的噪声 mesh 交给基线,而不是给它们真值 CAD。
这个协议更符合论文问题,但仍有两点需注意:
FoundationPose 和 GigaPose 本身不估计生成模型的 scale,实验前需手动把 mesh 调到正确大小;InstantPose 在 refinement 中自动估 λ \lambda λ
为按 YCB-V canonical frame 评测,所有生成资产都需评测用对齐;作者说明现实应用不必先对 canonical orientation,但 benchmark 仍需要。
因此 Table II 证明的是“面对单视图生成 mesh 时,InstantPose 这一适配方案更鲁棒”,不是“在标准真值 CAD setting 下全面超过 FoundationPose”。
8. 定量结果
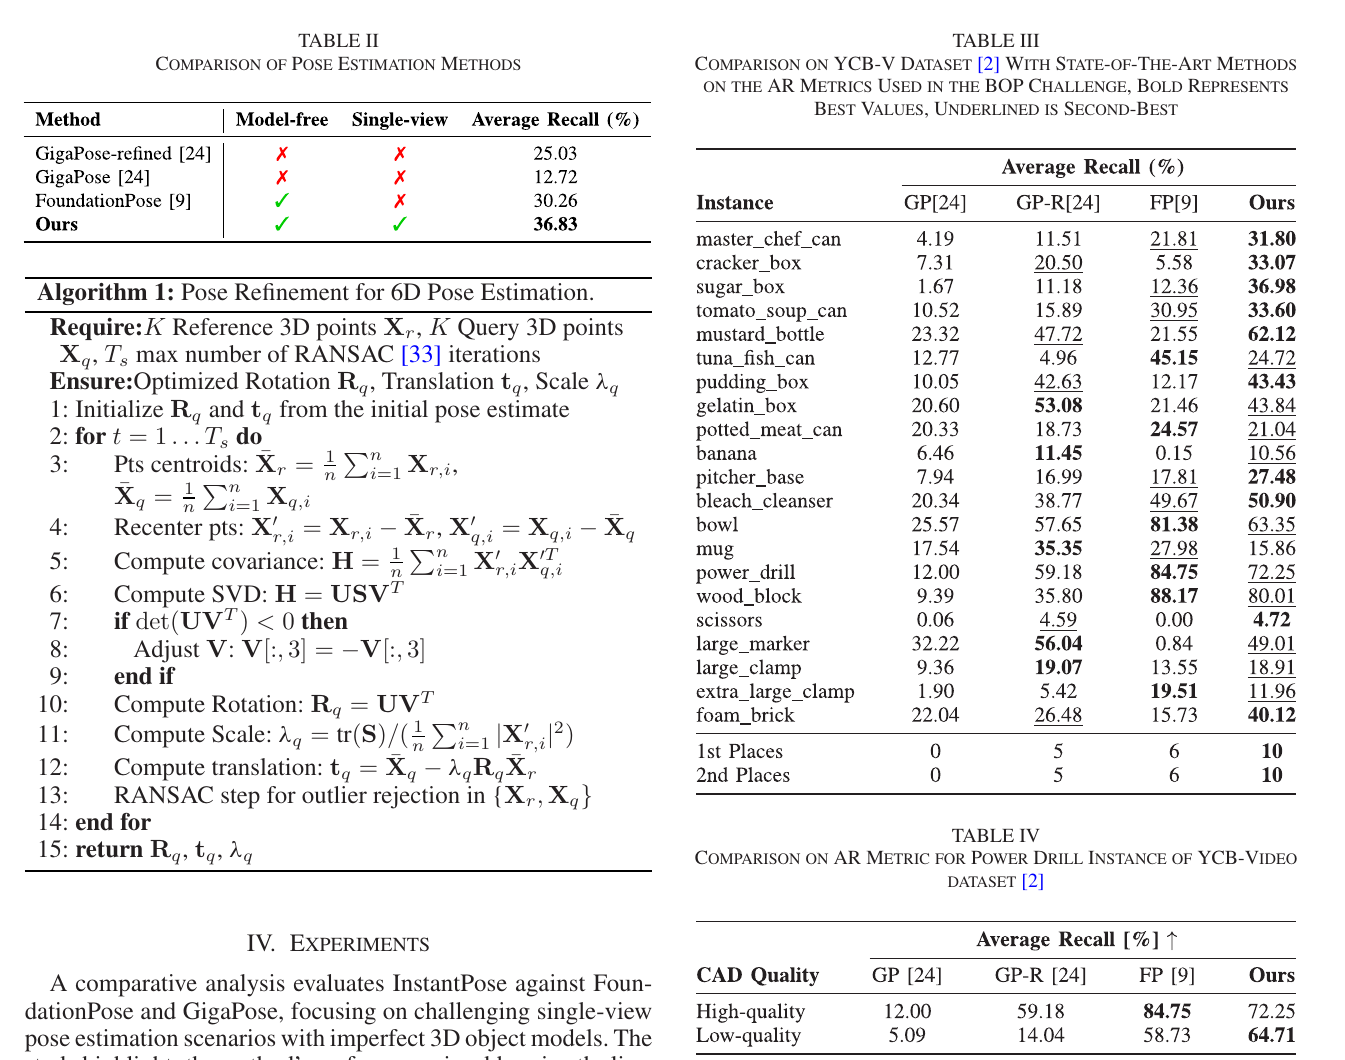
原论文 Table II–IV:GigaPose-refined、GigaPose、FoundationPose 和 InstantPose 接收同一生成 mesh;Table IV 进一步更换 power drill 的单图重建视角。来源:InstantPose 原论文 。图片版权归 IEEE 与论文作者所有,本站仅作学术解读展示。
8.1 整体 AR
方法 Model-free Single-view onboarding YCB-V AR GigaPose-refined 否 否 25.03 GigaPose 否 否 12.72 FoundationPose 是(此表所用生成模型条件) 否 30.26 InstantPose 是 是 36.83
表中 model-free / single-view 的勾选是作者对原方法能力的归类;基线在本实验中被强行接到生成 mesh,并不意味着其原始论文设置完全相同。InstantPose 相对 FoundationPose 高 6.57 AR,说明 scale-aware correspondence refinement 能缓冲噪声模型。
8.2 对象级差异
21 个对象中,InstantPose 有 10 个第一、10 个第二。优势对象包括 sugar box 36.98、mustard bottle 62.12、bleach cleanser 50.90、foam brick 40.12;但在 tuna fish can、bowl、mug、power drill、wood block 等对象上 FoundationPose 或 GigaPose-refined 更好。
对象差异与 mesh 质量 / 对称结构一致:准确重建出的 power drill 上,FoundationPose 可充分利用几何;把手细小的 mug 则因对应主要落在圆柱主体而产生绕轴歧义。不能把 aggregate AR 上升解释为每个对象都更稳。
8.3 重建视角敏感性
power drill 用高质量 mesh 时:
GigaPose 12.00
GigaPose-refined 59.18
FoundationPose 84.75
InstantPose 72.25
换成低质量 mesh:
GigaPose 5.09
GigaPose-refined 14.04
FoundationPose 58.73
InstantPose 64.71
InstantPose 下降 7.54 点,约 10.4% 相对降幅;论文正文将其概括为约 8% performance loss,而基线最大下降约 45 个百分点 / 显著更高相对幅度。准确说法应以表中绝对值为准:InstantPose 在好 mesh 上不是最好,但对 mesh 退化最稳。
9. 速度与系统成本
在 NVIDIA A4500:
InstantPose pose inference:约 3.9 s;
FoundationPose:约 1.8 s;
GigaPose:约 8 s。
作者指出 soft nearest-neighbor 是主要瓶颈。还需注意 3.9 s 是否含首次 InstantMesh reconstruction / 400 模板渲染:论文表述为 pose estimation inference,onboarding 资产生成应单独计时。一个公平系统报告应分成:
新对象首次接入:重建 + 模板渲染;
每帧 query:检测 / mask、DINO feature、模板检索、SNN、RANSAC;
后续多 query 是否复用 mesh 与模板 feature。
当前版本适合“先观察新对象,几秒后开始工作”,还不适合高帧率 tracking。
10. 机器人抓取证据
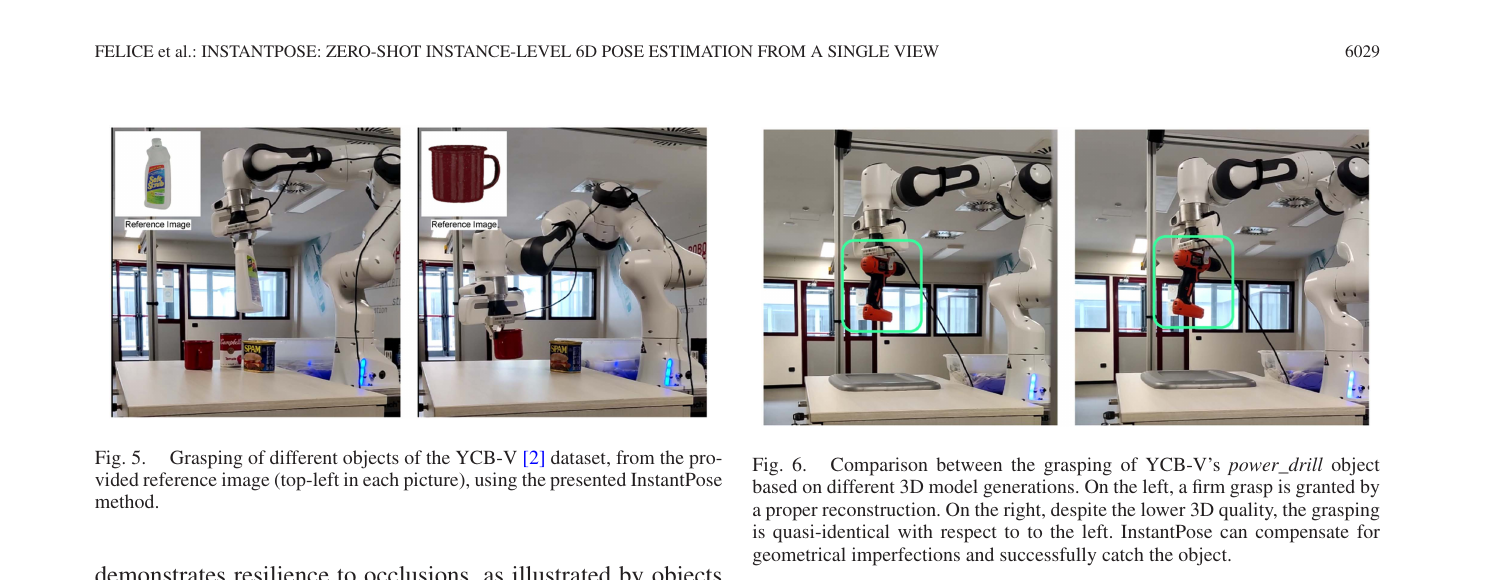
原论文 Figure 5–6:由一张 reference 生成对象资产后,用估计 pose 做 Franka open-loop grasp;power drill 在高 / 低质量 mesh 下都被抓起。该部分是定性可行性展示,不是统计抓取成功率实验。来源:InstantPose 原论文 。图片版权归 IEEE 与论文作者所有,本站仅作学术解读展示。
作者根据重建 mesh 的 3D bounding box 选抓取点,再将估计 pose 转为机器人笛卡尔运动。多对象、遮挡和两种 power-drill mesh 条件下都有成功案例。这验证 pose 的误差量级至少在展示样例中可用于抓取,也说明沿圆柱对称轴的旋转误差未必影响任务。
但实验没有给试验次数、对象级 success rate、失败分布或闭环纠错,抓取策略也不是论文重点。正确结论是“展示了 task utility”,而不是“证明了稳定抓取性能”。
11. 作者声称与我的判断
作者声称 我的判断 一张无位姿 reference 即可接入新对象 成立;query 端仍需 RGB-D、检测 / mask 与内参。 优于所比较 SOTA 在统一生成 mesh 的 YCB-V 协议上 aggregate AR 最好;不代表真值 CAD 标准协议也胜过 FoundationPose。 对重建噪声鲁棒 Table IV 证据直接;仅深入分析一个 power drill 和两种视角,覆盖仍有限。 可用于真实抓取 定性案例支持可行性,缺少统计实验。
12. 复现清单与局限
固定 InstantMesh、DINOv2、Grounding-SAM 版本,保存原始 reference、生成 mesh 和 400 个相机姿态。
区分 mesh 坐标、模板相机坐标、query 相机坐标和 YCB canonical frame。
验证 λ \lambda λ
SNN correspondence 要同时可视化 cycle distance、深度有效率和 RANSAC inlier,而不只看最终 box。
对称对象应按 BOP symmetry-aware metric 评测;机器人任务还应另报 task-aware success。
重做 Table IV 时选择多个对象、多个 reference azimuth / elevation,才能得到真正的 viewpoint sensitivity 曲线。
heavy occlusion、准对称、弱纹理和薄结构是主要失败源;单视图生成器若遗漏关键部件,后端无法凭 query 恢复 reference 里不存在的几何。
论文未提供可核验的完整官方代码,因此目前“可复现性”主要依赖方法描述与外部组件,站内不标为开源完成。
InstantPose 展示了一条很现实的折中:不等待完美 CAD,而把 foundation reconstruction 当成带噪声的启动先验;随后让真实 RGB-D query 决定尺度和对齐。它把 onboarding 成本降得很低,但下一步必须解决推理延迟、对 reference viewpoint 的敏感性,以及更系统的操作任务评测。