论文精读笔记:InterTrack: Tracking Human Object Interaction without Object Templates
1. 基本信息
2. 一句话定位
InterTrack 以单目视频中的粗人–物点云为起点,通过人体 correspondence、人体条件下的对象旋转预测、共享 canonical object shape 和 contact refinement,将各帧独立的重建拼成模板自由、时间一致的人–物交互轨迹。
2.1 论文图表导读
| 图表 | 内容 | 阅读重点 |
|---|
| Figure 2 | CorrAE、TOPNet、joint contact refinement 的完整链路 | 人体与对象不是独立跟踪,人体状态进入对象 rotation prediction |
| Table 1 | BEHAVE / InterCap 的 template-free F-score@1 cm | 要对比 HDM 与 Ours、synthetic-only 与 full training 两种训练量 |
| Table 2 | 使用模板时的 CHORE、VisTracker 对照 | 说明 template-free 版本与 template-setting 的边界不同 |
| Table 3–5 | TOPNet、joint optimization、CorrAE 消融 | 验证时序与 correspondence 是否真的必要 |
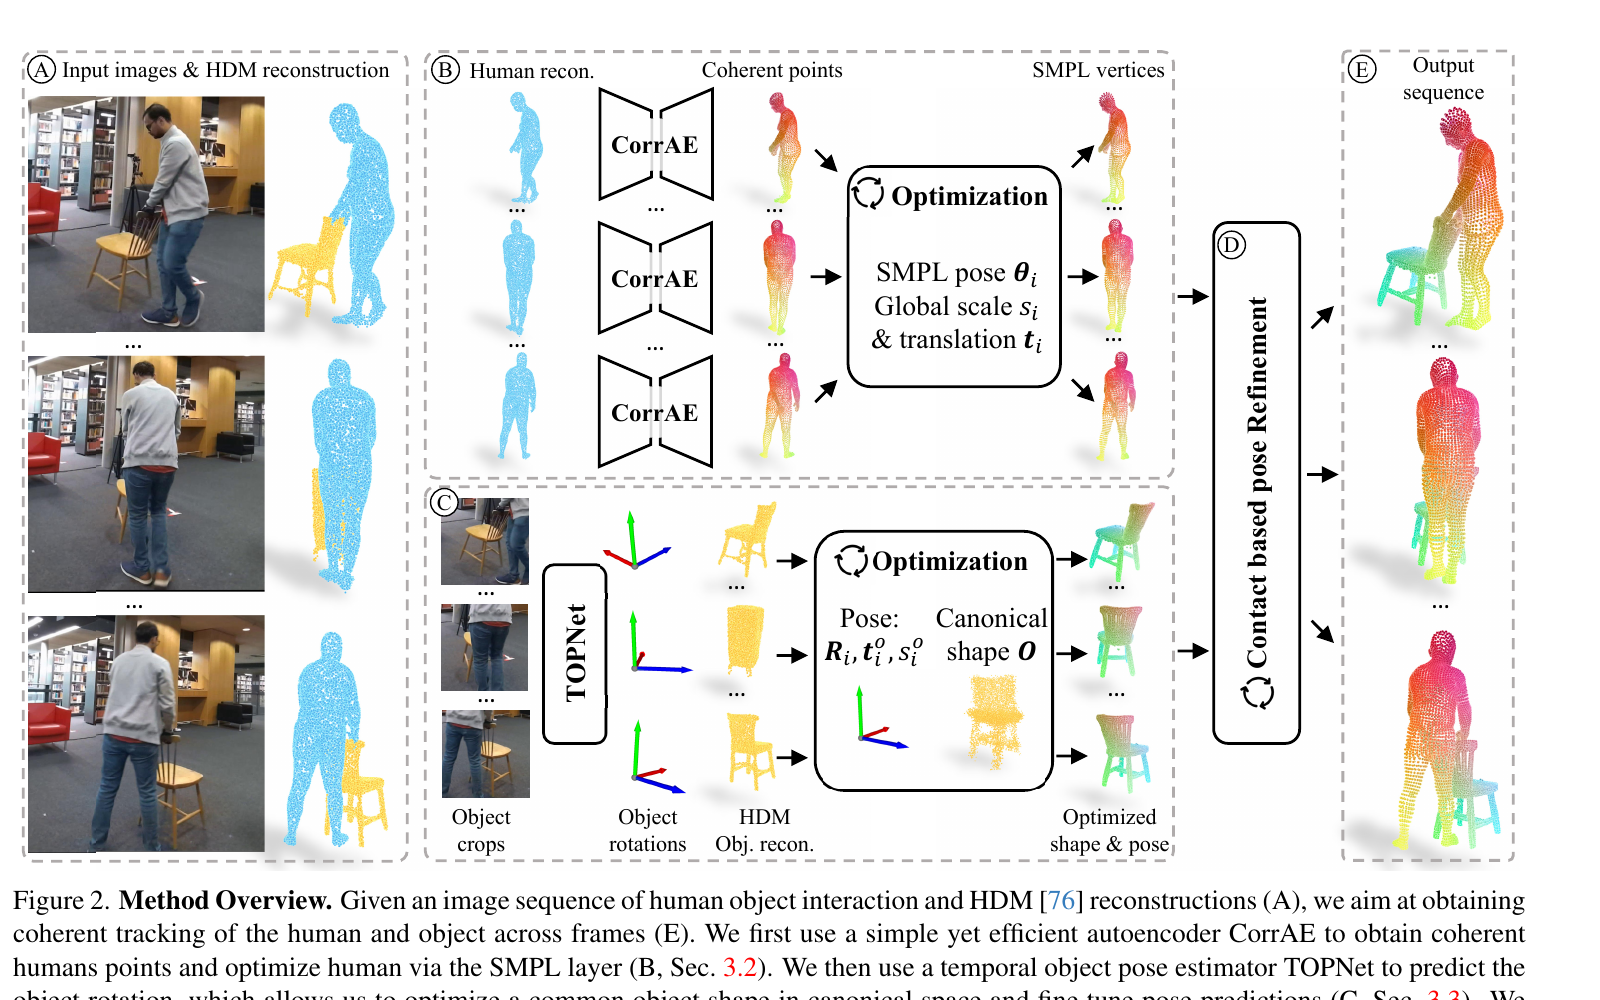 原论文 Figure 2:从 HDM reconstruction、CorrAE 与 TOPNet 到接触约束联合优化的流程。来源:arXiv PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
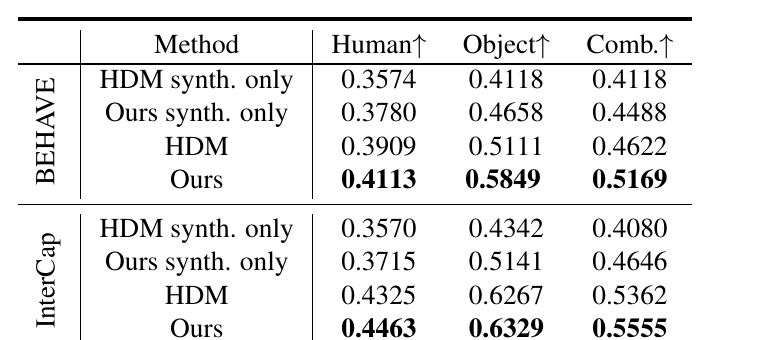 原论文 Table 1:template-free 方法在 BEHAVE 与 InterCap 上的 F-score@1 cm。来源:arXiv PDF。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与边界
- 输入为单目 RGB 人–物交互序列。论文先通过 HDM 得到每帧人体 / 对象的粗 point reconstruction,再取人、物 crop 和视觉特征。
- 输出为全序列一致的人体 SMPL 参数、对象 canonical shape O、每帧对象 Ri,ti,si,以及 contact-aware refinement 后的状态。
- “without object templates” 指不在测试时给已知 CAD object mesh;但并不等于无任何先验:人体使用 SMPL,视觉使用 DINOv2,粗人–物几何依赖 HDM,类别训练使用 ProciGen-Video 与真实数据。
- 主指标是 reconstruction F-score,并非独立标注的旋转 / 平移误差。因此对象 pose 的改善主要由更一致的 shape / surface 提供支持。
4. 关键难点与思路
HDM 类 image-based reconstruction 可给每帧点云,却缺少时间对应,且遮挡时会改变对象局部形状、尺度甚至朝向。InterTrack 的解法不是强行让各帧点云点对点配准,而是:人体先对到 canonical SMPL vertex;对象先预测 rotation,再把 object points 反向归到同一个 canonical shape;最后用接触把两条轨迹联动。
我的判断是,该分解在“人是结构化、物是刚体”的 HOI 数据上很有意义;代价是人体先验和对象刚体假设决定了它的适用域。
5. 方法详解
5.1 CorrAE:让人体点云可跨帧比较
CorrAE 使用 PVCNN encoder 和 MLP,将每帧 HDM human point cloud 映射到有序的 SMPL vertex correspondence。随后不直接平滑 latent,而是优化每帧 SMPL pose θi、scale si、translation ti,目标包含 Chamfer distance、SMPL pose prior 与二阶加速度平滑。论文报告 CorrAE 约 2.553 s / image,而传统非刚体 ICP 对照约 72.322 s / image。
5.2 TOPNet 与共享对象形状
TOPNet 输入 DINOv2 object crop feature、人体 pose / joint / velocity、人体–对象的可见性信息,使用 transformer 在时间窗内预测 object rotations。给定 Ri 后,系统将每帧粗 object reconstruction 转到 canonical coordinate,联合优化单一形状 O 及逐帧 translation、scale。这样遮挡帧不再被迫独自决定“物体长什么样”。
5.3 接触联合优化
最后的 joint contact-based refinement 同时调整人体与对象 pose,约束接触关系与时间连续性。它的作用是解决仅有视觉重建时的人–物穿插或接触漂移;不过 contact 并非无条件真值,快速滑动、软接触和错误接触检测都可能使该项过强。
| 模块 | 主要变量 | 作用 | 失败时的表现 |
|---|
| CorrAE + SMPL fit | θi,si,ti | 人体跨帧稳定、可解释 | 人体点云错配会传给对象条件 |
| TOPNet | Ri | 用时序与人体信号估 rotation | 对象完全遮挡或类别外观域外时漂移 |
| canonical shape optimization | O,ti,si | 以全序列补全单帧缺失形状 | 非刚体 / 形变对象违反共享 shape 假设 |
| contact refinement | 人–物状态 | 抑制互穿,保持交互关系 | 接触假设错时会过约束 |
6. 数据与实验分析
6.1 ProciGen-Video 的角色
论文从 BEHAVE / InterCap 的交互动作与 ShapeNet、Objaverse、ABO 的 object shapes 组合,构建 ProciGen-Video:约 10 小时、8477 sequences、约 2M images、10 个 object categories。它用于先训练 CorrAE / TOPNet,再在真实数据上微调。作者还把 BEHAVE 的 66 个测试序列(约 51k images)和 InterCap 的 15 个测试序列(约 2k images)作为评测。
该合成数据不是单纯扩容:它让对象旋转在 canonical space 有可学习的 category-level 对应。但其 domain gap 仍由 full-training 与 synthetic-only 的差距反映。
6.2 主结果
| 数据集 | 训练 | 方法 | Human F-sc ↑ | Object F-sc ↑ | Combined ↑ |
|---|
| BEHAVE | synthetic only | HDM | 0.3574 | 0.4118 | 0.4118 |
| BEHAVE | synthetic only | InterTrack | 0.3780 | 0.4658 | 0.4488 |
| BEHAVE | full | HDM | 0.3909 | 0.5111 | 0.4622 |
| BEHAVE | full | InterTrack | 0.4113 | 0.5849 | 0.5169 |
| InterCap | full | HDM | 0.4325 | 0.6267 | 0.5362 |
| InterCap | full | InterTrack | 0.4463 | 0.6329 | 0.5555 |
两个观察应同时保留:第一,InterTrack 相对 HDM 在两数据集、两训练条件都提升,支持“时序与联合优化有用”;第二,synthetic-only 仍显著低于 full training,说明合成 ProciGen-Video 没有消除真实视频域差。
6.3 主张与证据边界
- 作者主张:无需对象 template 仍可稳定跟踪。 Table 1 的 template-free 对照直接支持,且在 object F-score 上提升明显。
- 作者主张:人体能帮助对象。 TOPNet 输入人体 dynamics、接触 refinement 的消融共同支持,但这并不证明任意 HOI 都需要同样强的 SMPL 先验。
- 我的分析:F-score 不是 pose metric。 更高 F-score 可以来自更好 canonical shape、scale 或渲染补全;若要用于抓取或 AR,应补报 rotation / translation 和 contact error 的独立标注评测。
7. 局限与失败模式
- 上游 HDM reconstruction 是关键依赖;低质点云或 scale drift 会让后续 optimization 做“错误一致化”。
- 目标主要为刚体、单人与单物;多物体、多人、软体、铰接物体未在主设定覆盖。
- 对象类别与 BEHAVE / InterCap 的重叠决定了大部分 generalization;“template-free”不应被误读为无需数据先验。
- 计算上包含 HDM、SMPL fitting、Transformer 和 test-time joint optimization,适合离线视频分析而非低延迟 tracker。
8. 对 object pose 的启发
- 将人体从遮挡噪声升级为 pose condition(速度、接触、可见性)很值得在 manipulation 视频里探索。
- 共享 canonical object shape 可以把 temporal tracking 变成几何对齐问题,但应配合类别不确定性或可变形性检测。
- 建议下一步加入 pose-specific benchmark、object symmetry handling 与对 HDM / segmentation 噪声的逐级消融。
