论文精读笔记:Industrial Plenoptic Dataset
1. 核心判断
IPD 的核心问题是:传统 6D pose benchmark 把 10% object diameter 作为正确阈值,在 50–100 cm 距离评测;工业装配则可能要求 150–200 cm 距离下、99% recall 时小于 3 mm 的最大几何偏差。若 ground truth 本身有 2–5 mm 误差,就无法可信地区分两个亚毫米级算法。
作者的解决方案分两部分:
- 以同一物理场景、13 台多模态相机、4 exposures、3 lighting conditions 提供 co-evaluation 数据;
- 用 Robot Consistency 从跨机器人姿态预测的自一致性估计模型误差,减少对人工 pose ground truth 精度的依赖。
这使 IPD 更像“视觉系统设计平台”,而不是只用于训练单一模型的数据集。
2. 为什么 ADD 不够
ADD 计算所有 mesh vertices 的平均距离:
ADD(Tp,Tg)=∣V∣1v∈V∑∥Tpv−Tgv∥2.
平均值依赖 mesh sampling,也可能掩盖局部最大偏差。工业 peg-in-hole 中,只要任一部位越过公差就可能失败,因此论文使用:
MVD(Tp,Tg)=v∈Vmax∥Tpv−Tgv∥2.
MVD 是 ADD 的上界。实验中的 true positive 阈值仍设为 10 mm + 10°,而论文愿景是向 3 mm / 99% recall 推进;当前表格不代表已达到最终工业要求。
3. Robot Consistency 推导
固定相机坐标系 C、机器人基坐标系 R、gripper G、对象 O。已知 hand-eye transform TCR 与每个机器人姿态 TRGi,网络预测 TCOi,pred。
把每次预测变换到 gripper frame:
T^GOi=TGRiTRCTCOi,pred.
因为对象刚性固定在 gripper 上,所有 T^GOi 应围绕同一常量。用 Fréchet mean 估计:
TGO⋆=argμ∈SE(3)mini=1∑Nρ2(μ,T^GOi),
其中 translation 取 sample mean,rotation 用 quaternion averaging。再把 TGO⋆ 投回各相机观测,计算 MVD:
Erc=N1i∑d(TCOi,pred,TCRTRGiTGO⋆).
估计 TGO⋆ 会少掉一些自由度,有限样本下有偏;论文证明在独立、无偏和温和条件下,其平移与旋转估计一致,收敛率为 N−1/2。对某些与 camera frame 固定相关的 bias,球面均匀视角还可互相抵消。
4. 合成验证
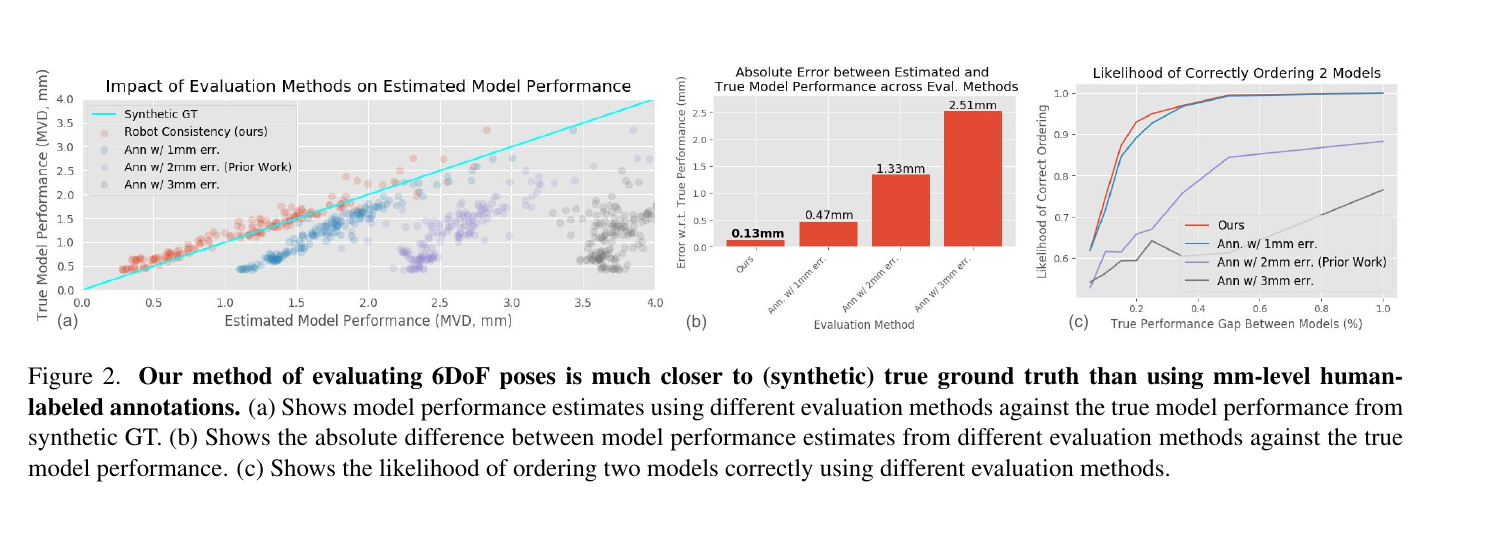 原论文 Figure 2:左图比较估计误差与真实误差,中图是绝对差,右图是正确排序两种模型的概率;Robot Consistency 在高精度区比 1–3 mm 抖动标注更接近真值。来源:CVPR 2024 正式论文;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
合成集包含 20 个 physical-scene analogues、每 scene 10 个实例、30 viewpoints、4 个 5MP cameras;作者训练 24 个不同 backbone / convergence level 的 keypoint models,并比较:
- 真值;
- Robot Consistency;
- 注入 1 / 2 / 3 mm MVD jitter 的“人工标注”。
Robot Consistency 对真实误差的平均绝对差为 0.13 mm,1 mm jitter annotation 为 0.47 mm。人工标注还会在模型越准时越高估误差,正好破坏高精度区的模型排序。
但这仍是合成验证。现实中的 robot calibration、hand-eye calibration、热漂移与结构形变会成为新误差源,不能把 0.13 mm 直接视为真实 IPD 的 ground-truth accuracy。
5. 数据采集系统
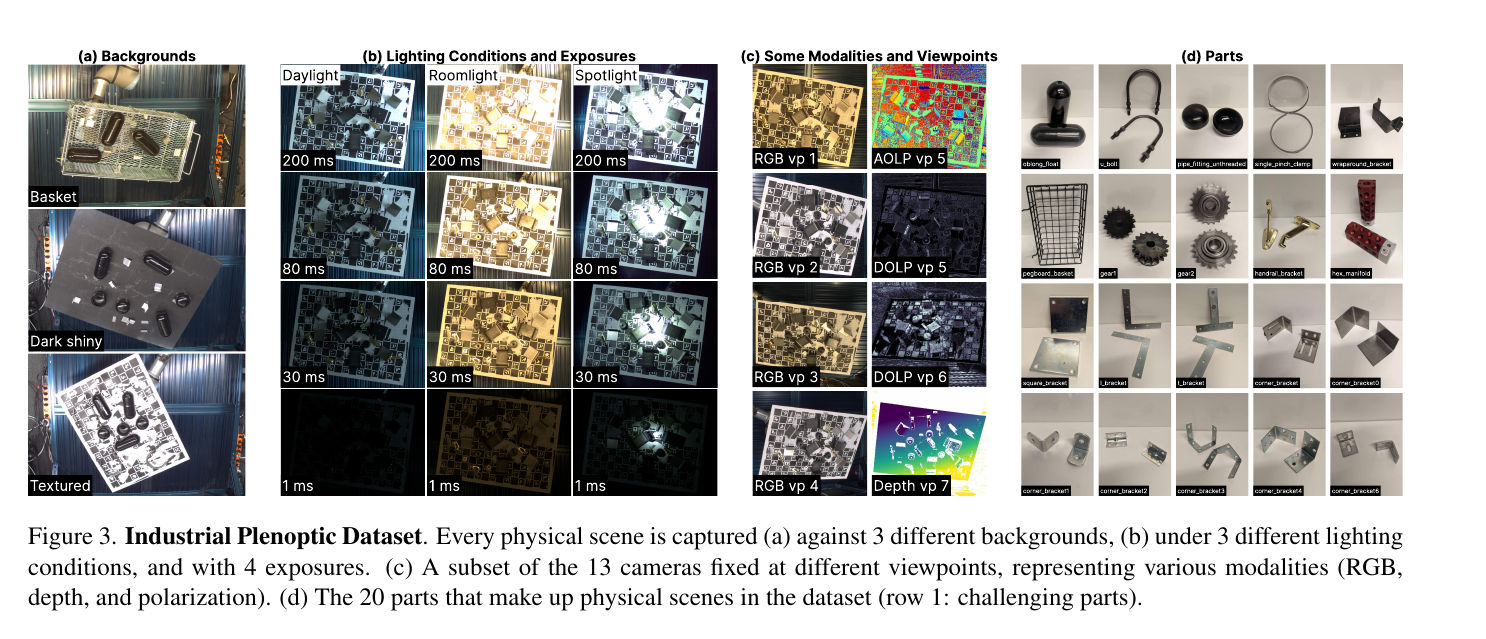 原论文 Figure 3。左到右依次是背景、照明与曝光、相机模态 / 视角、20 个零件;每个物理 scene 在相同机器人轨迹下重复采集,便于受控对照。来源:CVPR 2024 正式论文;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
相机
- 3× Basler-LR,1920×1200 RGB;
- 5× Basler-HR,2592×1944 RGB;
- 4× FLIR-MonoP,2448×2048 grayscale + polarization;
- 1× Photoneo,2064×1544 RGB-D,2 m 距离约 500 μm depth accuracy。
多相机 baseline 为 10 cm–1 m。UR5e 经过 kinematic calibration,relative pose accuracy 小于 100 μm。每个物理 scene 采 30 robot configurations,pitch / roll 变化至 30°、yaw 覆盖 360°,XYZ 工作范围约 1 m × 1 m × 0.5 m。
光照与曝光
- 1 / 30 / 80 / 200 ms;
- roomlight 约 1,000–2,000 lux;
- spotlight 同时包含约 100 lux 暗区与 100,000 lux 亮区;
- daylight 受窗口方向与天气影响。
Photoneo 给 12-bit HDR image;RGB / polarization cameras 保留多曝光,便于在相同 scene 上研究 exposure fusion。
6. Co-evaluation 结果
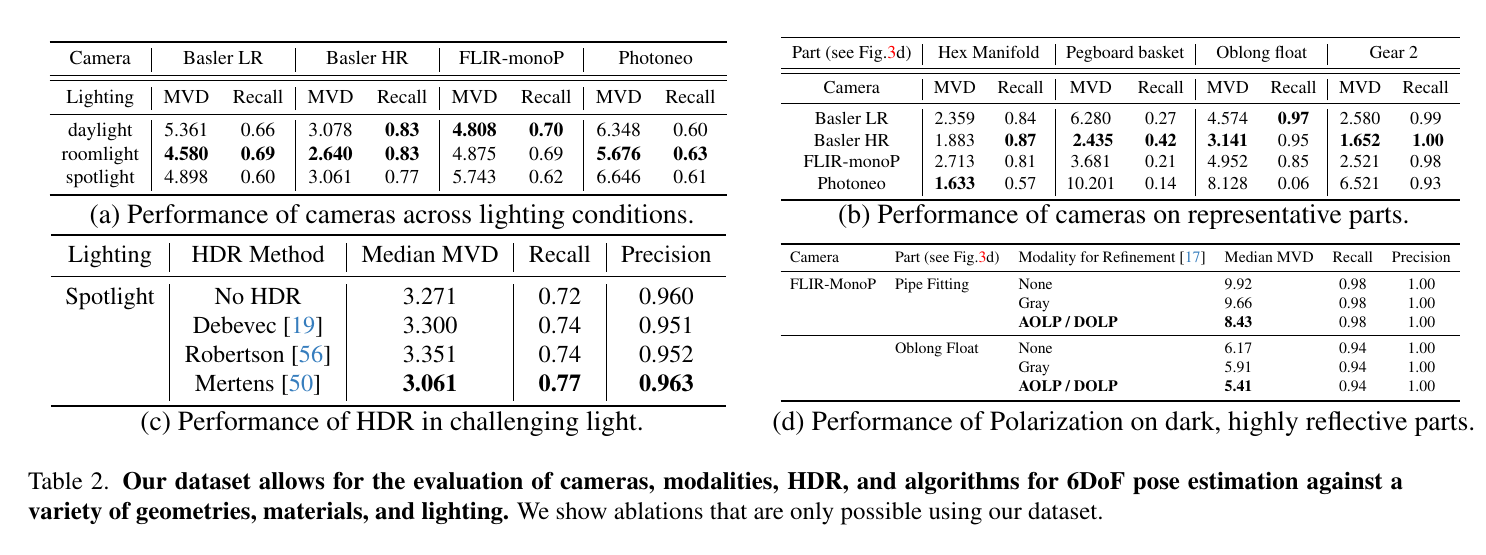 原论文 Table 2。四个子表分别固定其他变量,比较 lighting×camera、part×camera、HDR algorithm 和 polarization refinement。来源:CVPR 2024 正式论文;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
Camera × lighting
| 相机 | Daylight MVD / R | Roomlight MVD / R | Spotlight MVD / R |
|---|
| Basler-LR | 5.361 / .66 | 4.580 / .69 | 4.898 / .60 |
| Basler-HR | 3.078 / .83 | 2.640 / .83 | 3.061 / .77 |
| FLIR-MonoP | 4.808 / .70 | 4.875 / .69 | 5.743 / .62 |
| Photoneo | 6.348 / .60 | 5.676 / .63 | 6.646 / .61 |
Photoneo 并非总是最好。spotlight 的红 / 近红外环境干扰 structured-light laser;暗反光物体也可能不把激光反回相机。高分辨率 multi-view RGB 在总体上最稳。
HDR
spotlight + Basler-HR:
| 方法 | Median MVD | Recall | Precision |
|---|
| No HDR | 3.271 | .72 | .960 |
| Debevec | 3.300 | .74 | .951 |
| Robertson | 3.351 | .74 | .952 |
| Mertens | 3.061 | .77 | .963 |
HDR 不是必然改善:Debevec / Robertson 的 MVD 比 no-HDR 略差,只有 Mertens 同时改善 MVD、recall 和 precision。
Polarization
对 dark reflective objects:
- Pipe fitting:无 refinement 9.92,gray 9.66,AOLP/DOLP 8.43 mm;
- Oblong float:6.17,5.91,5.41 mm。
主要收益来自 angle / degree of linear polarization 提供暗背景上的边缘对比,并非 polarization 直接输出 pose。
7. 最难零件
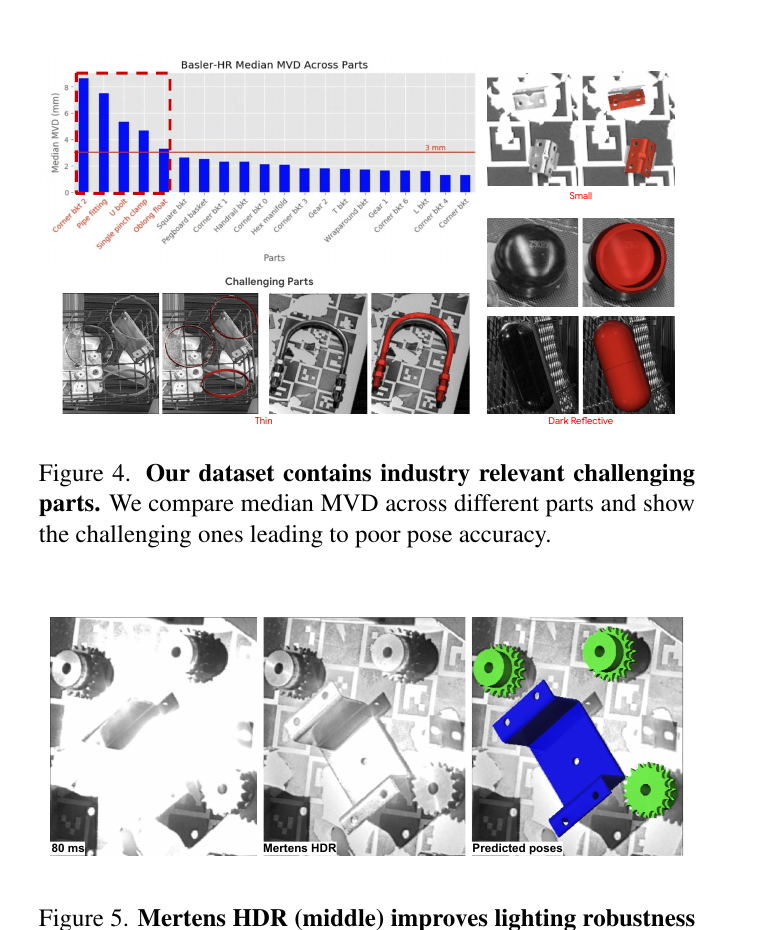 原论文 Figure 4–5:按 Basler-HR 的 MVD 排序后,最难零件集中为 thin、small、dark reflective;下方展示 Mertens exposure fusion 保留亮暗区域并改善 pose。来源:CVPR 2024 正式论文;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
典型失败机制:
- thin structures:depth / edge sampling 不完整;
- small parts:150–200 cm 距离下像素占比太低;
- dark reflective:RGB 动态范围与 structured-light return 同时恶化;
- spotlight:同一对象局部过曝与欠曝并存;
- geometry-poor:对称或缺少 keypoint discrimination。
这说明工业 pose 性能不能只按算法平均,而应按 sensor × material × geometry × lighting 条件切片。
8. 实验 pose pipeline
主实验共享:
- Mask R-CNN detection;
- HRNet-style 2D keypoint heatmap;
- RGB multi-view 用 re-projection minimization / PnP;
- structured light 使用 point registration / ICP;
- 可选 grayscale 或 AOLP/DOLP edge refinement;
- NVISII / BlenderProc 风格合成训练数据。
因此 Table 2 是受控系统消融,不是比较最新 pose backbones。IPD 的长期价值在于允许研究者替换算法,同时保留相同相机、场景与照明。
9. 局限与使用注意
- Robot Consistency 无法自动发现所有共享系统偏差;若每个视角都以相同方式偏移,预测仍可能“很一致但不准确”。
- 理论假设独立预测、无偏或特定 camera-frame bias,现实网络误差可能相关。
- 评测依赖高质量 robot kinematics 与 hand-eye calibration。
- Semi-automated annotations 仍用于实例 correspondence grouping,并非完全无标注。
- 数据是 moderate clutter,不覆盖重遮挡多实例 bin-picking。
- 20 个零件与单一工作站限制材质、机器人和工厂域多样性。
- 目前 true positive 采用 10 mm / 10°,与愿景中的 3 mm / 99% recall 有距离。
- 多相机 rig 成本高,单相机部署者应按 camera subset 使用而非直接照搬。
10. 最终评价
IPD 最重要的不是规模,而是实验变量设计:它让 camera、baseline、resolution、depth、polarization、exposure fusion 与 pose algorithm 在同一物理 scene 上可控比较。Robot Consistency 又提供了一个面对“评测真值不够准”时非常实用的替代路线。
它并没有证明工业 6DoF 已达到 3 mm / 99% recall,反而清楚显示 spotlight、thin、small 和 dark reflective parts 仍显著失败。对工业研究,IPD 的正确用法是做系统 co-design 和条件化误差分析,而不只是再报一个全局平均分。
