Reading Notes
粗读 / 精读
已生成 src/paper-notes/itaco-3dv2026/coarse.md
论文粗读笔记
用于快速判断论文定位、问题设定、核心方法、实验结论和是否值得精读。
论文粗读笔记:iTACO: Interactable Digital Twins of Articulated Objects from Casually Captured RGBD Videos
1. 基本信息
- 作者 / 机构:Weikun Peng、Jun Lv、Cewu Lu、Manolis Savva;Simon Fraser University、上海交通大学。
- 年份 / 会议:2026 / 3DV。
- 论文链接:OpenReview;arXiv PDF;项目页。
- 阅读模式:粗读。
2. 一句话定位
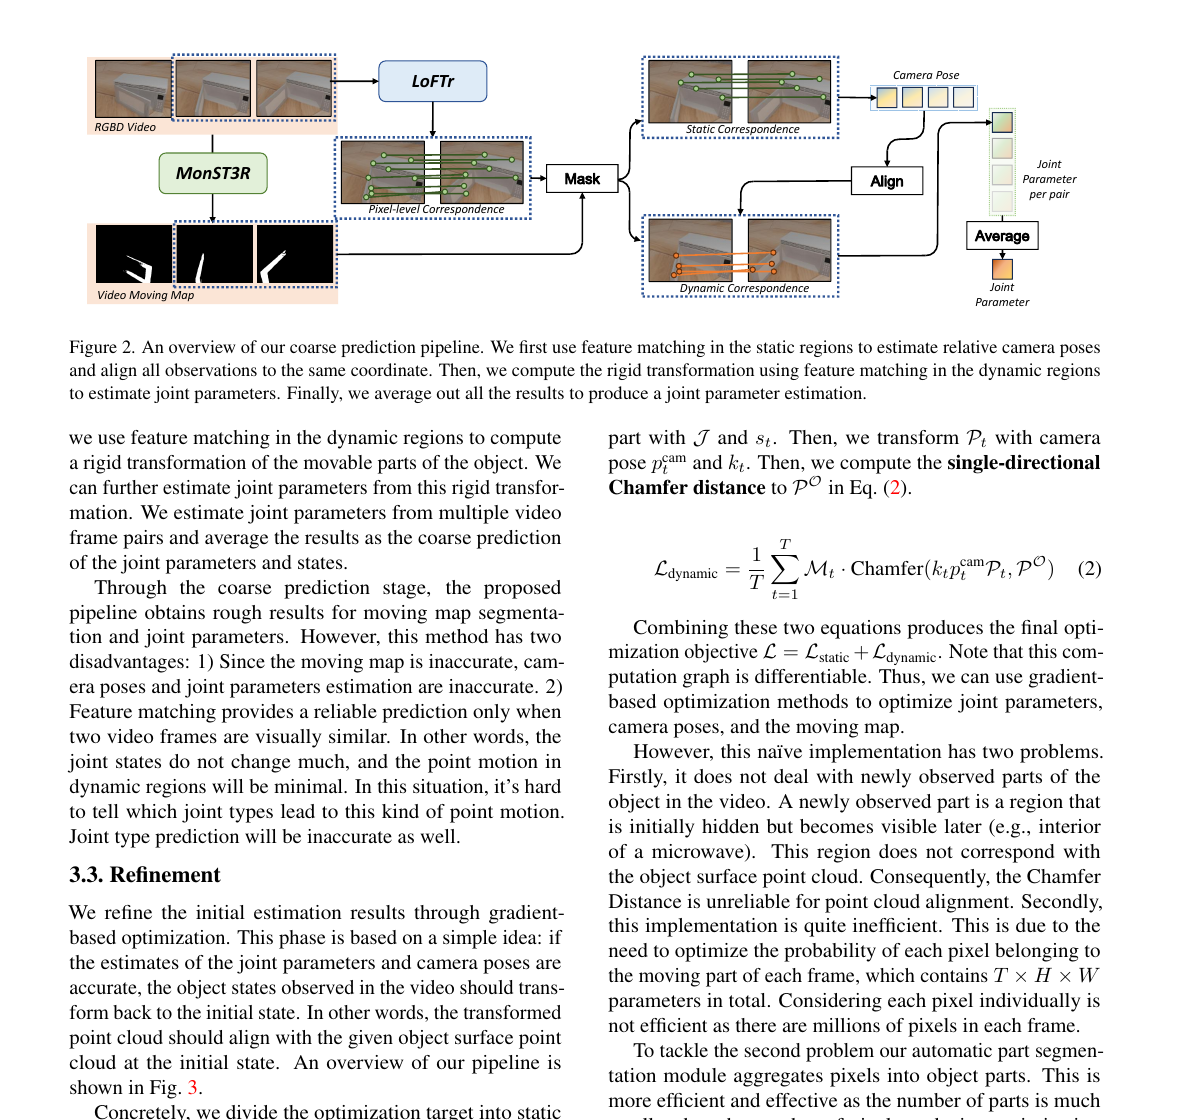
iTACO 面向“人手持相机随手拍”的动态 RGB-D video:先由静态 / 动态 correspondence 获得 camera pose、part motion 与 coarse joint,再以 differentiable refinement 和自动 part segmentation 恢复 articulated object 的 joint parameters 与数字孪生。
3. 问题设定
- 输入:casually captured dynamic RGB-D video,camera 和 object 都会运动且常被手遮挡。
- 输出:movable-part segmentation、revolute / prismatic joint type、axis、position、state,以及 object geometry。
- 不假设精心标定、多视角 turntable 或静态相机;但仍依赖 depth、static-region match 与上游 mask。
4. 方法概览
- LoFTR 在静态区域匹配,估计相对 camera pose 并统一各帧坐标。
- 动态区域的 correspondence 推出 object part 的 rigid transform,汇总为 coarse joint parameters。
- 以 moving-part segmentation 聚合像素后做可微 global refinement,联合优化 camera pose、moving map 和 joint parameters。
5. 实验概览
- 新数据集:784 videos、284 objects、11 categories,约为已有同类数据 20 倍。
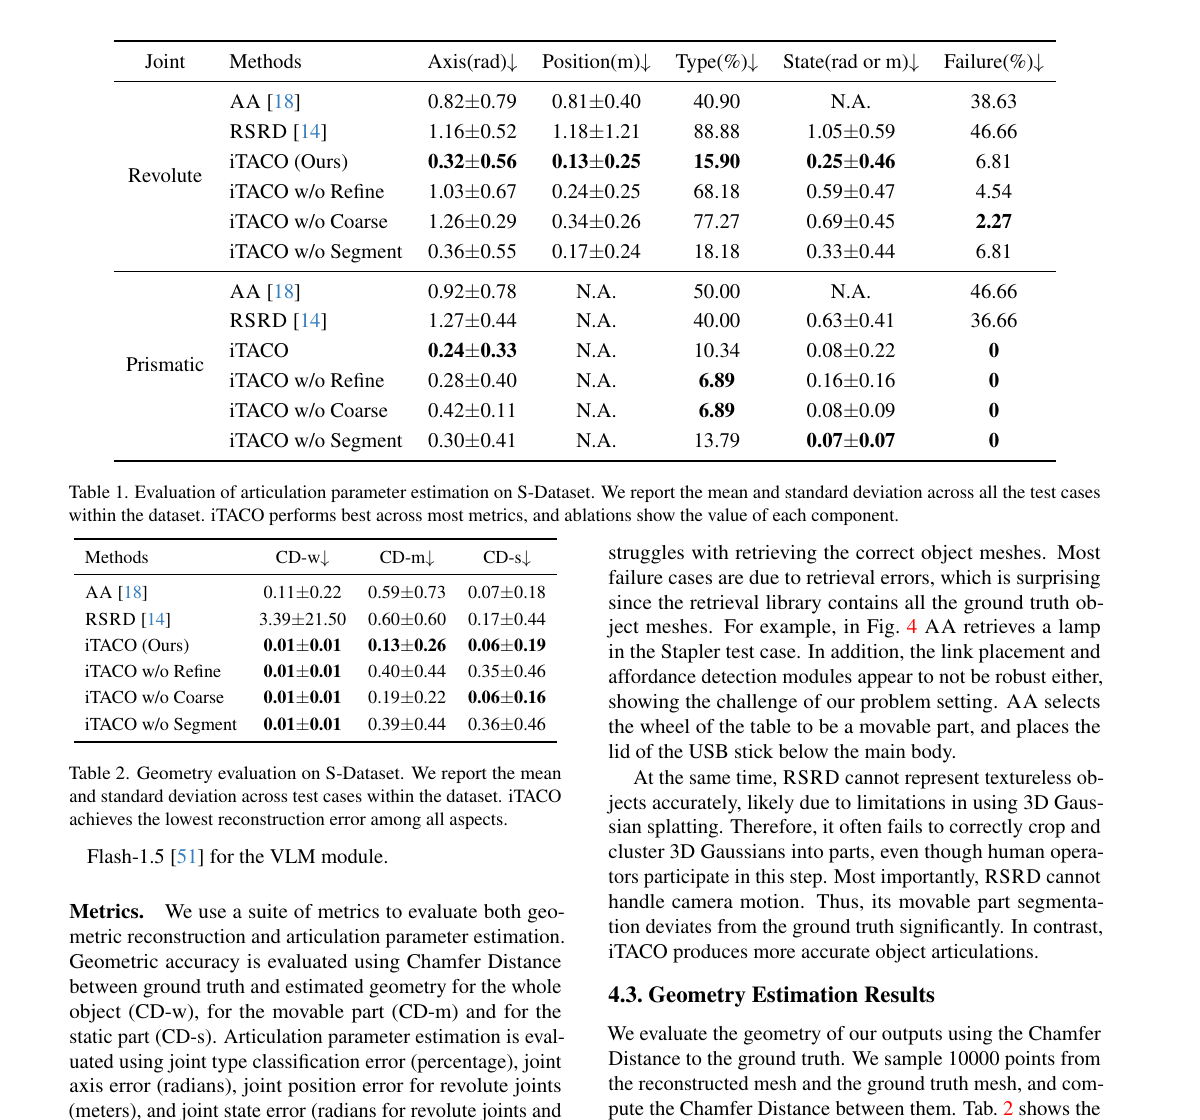
- S-Dataset 的 revolute joint:axis / position / type / state / failure = 0.32 rad / 0.13 m / 15.90% / 0.25 rad / 6.81%。
- iTACO 的 moving-part CD 为 0.13;去 refinement 升至 0.40,去 segmentation 升至 0.39。
6. 优缺点与启发
优点
- 直面 simultaneous camera-object motion,是 smartphone data acquisition 更真实的设定。
- 先 coarse 再 refine,且将 part segmentation 放入优化变量而非纯前处理。
缺点 / 风险
- textureless object、错分部件、被遮挡的新可见区域会破坏 matching;不重建对象内部。
- 需要 RGB-D,且耗费是 per-video reconstruction,不是实时单帧 pose。
7. 值得精读的点
revolute joint 去掉 coarse stage 后 type error 达 77.27%,说明 refinement 不能从无结构初值中自动恢复复杂 articulation。