1. 核心判断
2. 一句话定位
用 keyframes 离线式 mapping 得到冻结 KV cache,在线 query frame 只做 cache cross-attention,从而以接近线性成本实现 object / scene pose tracking。
2.1 论文图表导读
| 图表 | 精读问题 |
|---|
| Figure 2 | mapping 和 tracking 的输入、输出与缓存生命周期是什么? |
| Figure 3 | object-level tracking 为什么比 camera tracking 更难? |
| Table 1 | 不同场景 benchmark 的精度与 FPS 是否一致? |
| keyframe ablation | keyframe 数量、角度阈值与内存开销的折中是什么? |
| failure cases | 缓存错误、遮挡和长期回访时是否出现漂移? |
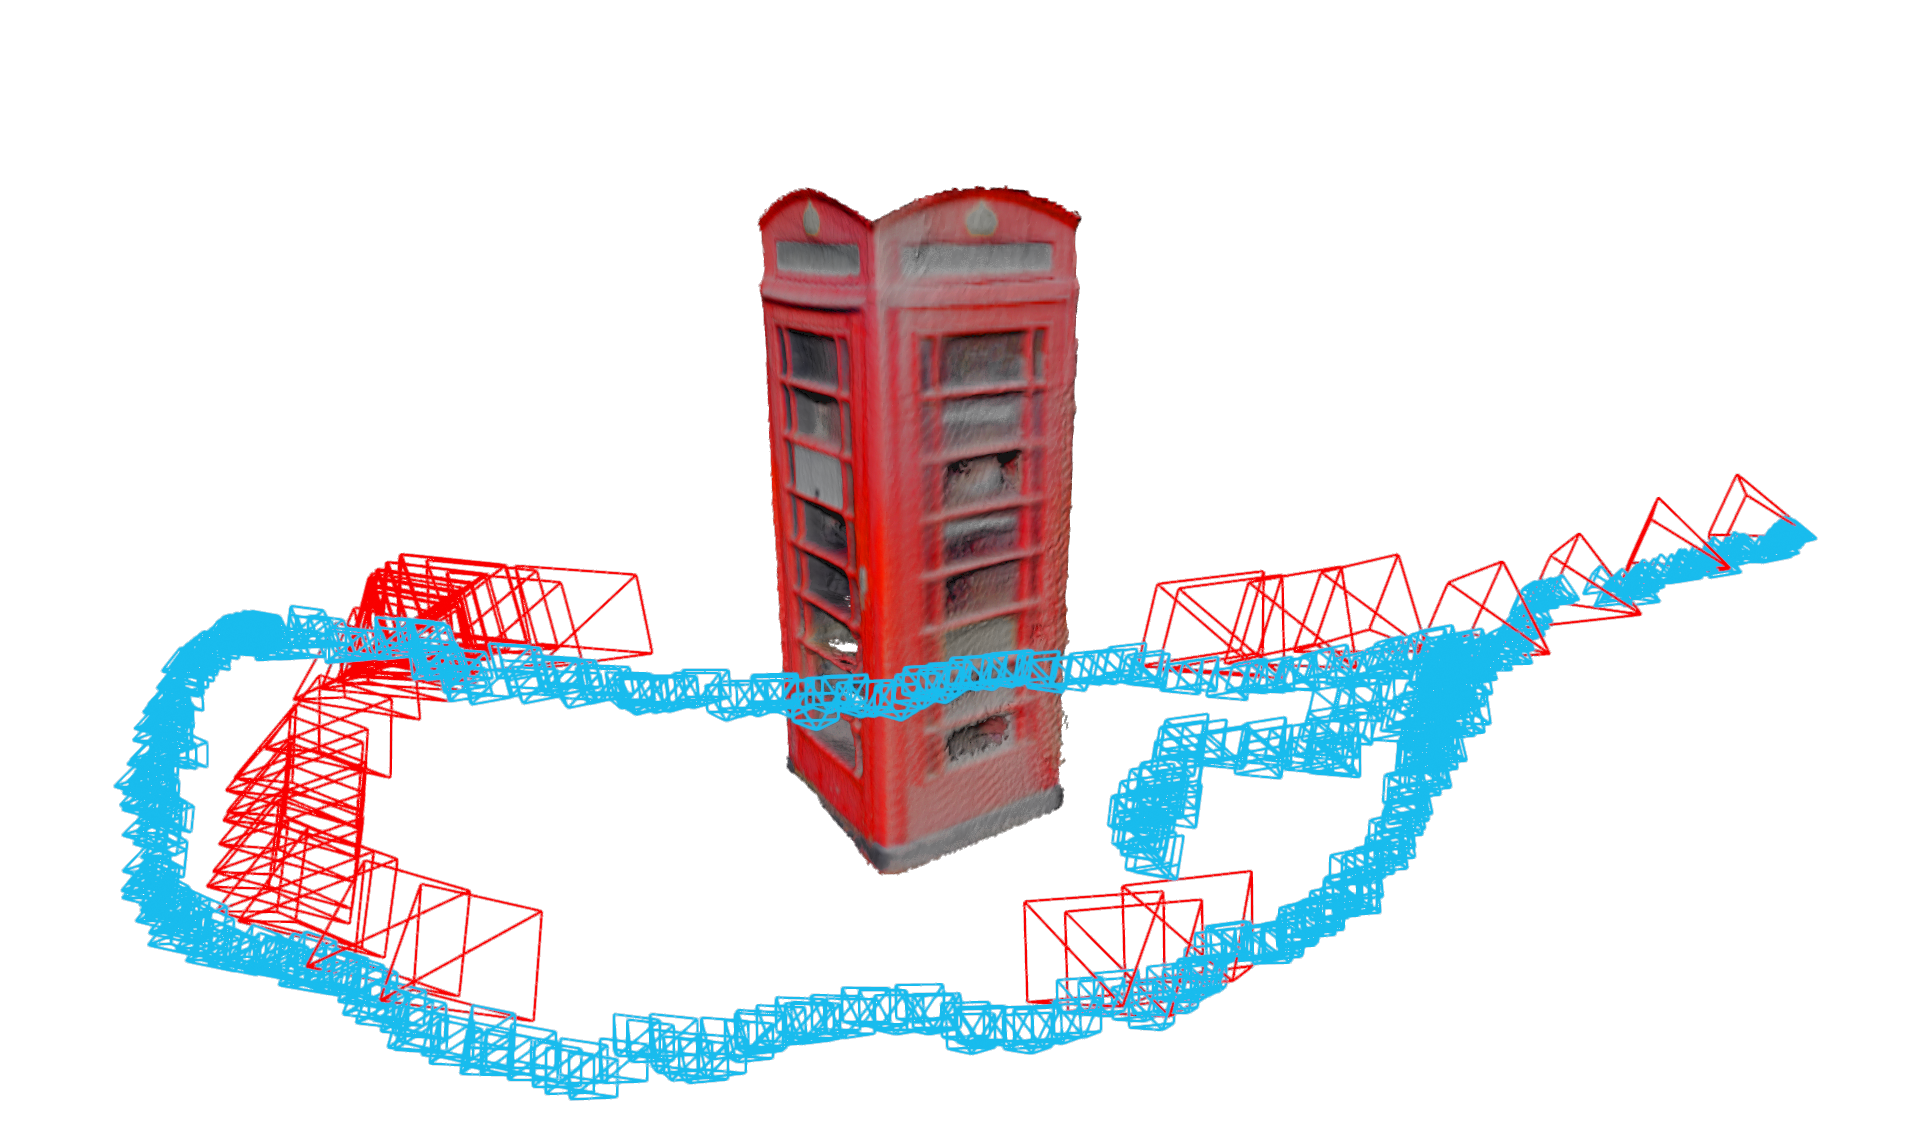 原论文图表中的相关区域:KV-Tracker 用 keyframes 建图,在线帧通过缓存表示进行 tracking。来源:项目页 / CVF Open Access。图片版权归论文作者及出版方所有,本站仅作论文解读展示。
3. 问题设定与任务边界
- 多视角 Transformer 输入 N 帧时,全局 attention 对 token 数量呈平方复杂度;在线视频若每次加入新帧重算会迅速不可用。
- KV-Tracker 在 mapping 阶段保留一组 keyframes 的 key/value,tracking 阶段以当前 frame 的 query 访问它们。
- tracking frame 不修改缓存,因此不会因错误观测导致 catastrophic forgetting 或 representation drift。
- object-level 模式可在无 depth、无 CAD、无 object prior 的情况下从视频扫描中在线重建物体和追踪其相对 pose。
4. 研究脉络
- DUSt3R / MASt3R / VGGT / π³ 等多视角模型具有强几何先验,但原生更适合离线 batch input。
- CUT3R、StreamingVGGT 等模型通过训练状态更新支持流式输入;KV-Tracker 选择在不重新训练的前提下缓存已有模型的 attention state。
- 这条路线与 SLAM 的 keyframe memory 相似,但记忆不是手工地图,而是 foundation model 的 KV representation。
5. 研究动机
- 多视角网络的全局观察能力对回访和闭环很有帮助,简单递归状态却容易漂移。
- 重新运行所有 keyframes 计算正确但太慢;只保留最近帧又会丢失全局结构。
- global attention 的 key/value 已经编码历史观察,可以作为中间层缓存。
- keyframe 选择控制覆盖率和 memory growth,角度阈值是精度—效率的直接旋钮。
6. 方法详解
6.1 Mapping
- 从输入 RGB stream 中根据视角变化自动挑选 keyframes。
- 对 keyframe buffer 运行完整多视角网络,预测 camera poses、local point maps 和 confidence。
- 缓存每个 global self-attention block 的 K/V pairs;这组 K/V 代表已有场景 / 物体的全局上下文。
6.2 Tracking
- 新的 frame 经过 token encoder,query token 与缓存 key/value 做 cross-attention。
- 关闭不必要的 point map / confidence decoding head,只输出实时 tracking 需要的 camera / object pose。
- 当前 tracking frame 不写回缓存,只有满足 keyframe criterion 时才重新 mapping 并更新 memory。
6.3 Object tracking
- 物体级模式以分割 mask 选出 object crop,跟踪相对于 object map 的相机 / 物体 pose。
- 少于约 50–60 个 keyframes 通常足以表达一个被扫描物体的几何覆盖,但场景大小与视角变化会改变这一数字。
7. 实验分析
7.1 数据与指标
- scene-level:TUM RGB-D、7-Scenes、Arctic;object-level:OnePose 等。
- 评估 camera / object trajectory、pose accuracy、tracking drift 和 runtime。
- 论文在 RTX 4090 上报告 tracking 约 27 FPS,整体高帧率接近 30 FPS。
7.2 结果解读
- 相比对每个新帧重新计算已知 key/value,缓存带来最多约 15 倍加速。
- key/value cache 允许相机回到先前视角时重新定位,不像只依赖局部递归状态那样容易累积漂移。
- object tracking 比 scene camera tracking 更难,因为物体相对相机可能快速移动、旋转且可见区域更少;论文仍展示了无 CAD、无 depth 的 on-the-fly reconstruction。
7.3 工程折中
- keyframe 太少:全局 coverage 不足,回访和遮挡时会失败。
- keyframe 太多:cache memory 线性增大,cross-attention 和 decoder 变慢。
- threshold-based insertion 让系统能在 coverage 与 memory 之间自动折中,但不同场景可能需要不同阈值。
8. 批判性分析
- 优势:不改模型、不训练、不依赖新数据,复用现成 multi-view foundation model 的中间表示。
- 限制:缓存不是严格可优化的显式地图,若 mapping 阶段错误,后续 tracking 可能持续继承错误。
- 新物体 pose 边界:无 CAD、无 depth 的优势很强,但 object identity / mask 仍需要前端分割或用户提供。
- 长期运行:内存增长、动态场景变化和新物体进入需要 cache eviction / multiple maps 策略。
9. 对我的研究的启发
- object pose pipeline 可以缓存 correspondence feature、Gaussian feature 或 foundation token,而不是每帧重建。
- “只读 tracking memory + 受控 keyframe 更新”适合和 uncertainty trigger 结合:不确定时才增加关键帧。
- 对多物体,可为每个 object 维护独立 KV cache,同时共享 backbone 计算。
10. 待解决问题
- 如何让 cache 支持动态物体与场景变化而不引入漂移?
- 如何从 KV representation 直接输出可校准的 pose covariance?
- 如何在嵌入式硬件上压缩 key/value 并保持 long-term relocalization?
11. 精读补充:缓存带来的速度—地图质量折中
11.1 机制
KV-Tracker 基于 π³ 一类带 global self-attention 的多视角重建网络。mapping 阶段从 keyframes 得到 point maps 与 global attention K/V;tracking 阶段的新帧只与 cache 做 cross-attention,不再重新对所有历史帧计算 global attention。keyframe 由 azimuth / elevation 变化阈值控制,当前协议约为 10°;普通 tracking frame 不写入 cache,因此 memory 的语义稳定性更好。
11.2 相机 tracking 的精确数字
TUM RGB-D ATE RMSE 平均为 Point3R 0.331 m、CUT3R 0.272 m、TTT3R 0.132 m、DPVO 0.095 m、KV-Tracker 0.098 m;在 8 个场景中赢下 6 个,teddy 场景 0.057 m 对 TTT3R 的 0.214 m。7-Scenes 平均为 Point3R 0.439、CUT3R 0.205、TTT3R 0.143、KV-Tracker 0.059 m,赢下 7/7 场景。
KV-Tracker 的追踪速度约 27 FPS;相较每次重算 attention 的方案最高约 15× 加速。Table 3 的平均 FPS 对比为 Point3R 5、CUT3R 17、TTT3R 17、Ours 27。
11.3 object tracking 的边界
OnePose 上,Ours@518 + 2D bbox 在 1cm/1°、3cm/3°、5cm/5° 的 recall 为 5.3 / 69.3 / 92.9,16 FPS;OnePose++ 为 51.1 / 80.8 / 87.7,11 FPS。OnePose Low Texture 上同一配置为 12.1 / 80.0 / 94.4。结论不是“完全超过 offline map”:严格 1cm / 1° 仍明显落后,但 coarse tracking 更快且不需要预先完整重建。
11.4 作者声称与我的分析
| 作者声称 | 我的判断 |
|---|
| KV cache 可以让 foundation model 实时化 | 27 FPS 与 attention ablation 支持,但 cache memory 随 keyframe 数增长。 |
| 无 depth / CAD 也能做 object tracking | 输入端使用 propagated segmentation mask;object identity 与 mask 仍是前端先验。 |
| 在线重建可以接近 offline map | 5cm / 5° coarse recall 接近或超过 baseline,但高精度阈值说明 coverage 和初始化仍不足。 |
12. 复现与扩展
必须记录 keyframe 阈值、cache token 数、输入分辨率、mask 来源、object-level / scene-level 模式和 fallback 机制。建议加入 cache eviction、对象变化检测、KV 压缩和 uncertainty-triggered keyframe;对多物体则为每个物体维护独立 cache,并共享 image backbone。
