论文精读笔记:MatchU
1. 核心判断
MatchU 的核心不是“再做一个 RGB-D fusion network”,而是处理 unseen-object 3D matching 中一个内在冲突:
为了跨新对象和新姿态泛化,局部 3D descriptor 应尽量 rotation-invariant ;
但旋转不变会让几何相似的多个表面点变得难以区分,尤其是平面、圆柱、对称件和重复结构;
RGB 纹理能消歧,却与 CAD point、scene depth point 不在同一采样域,也没有天然逐点对应。
MatchU 的答案是在 coarse latent space 内双向融合 CAD geometry、scene geometry 与 image texture,再让 RGB latent matching 引导 3D descriptor 学习。最终仍由显式 correspondence、RANSAC 与可选 ICP 求 pose。这种设计使单假设版本在五个 BOP 数据集达到 50.5 mean AR、0.07 s;同时,去掉 RGB 后 AR 降到 39.6,证明纹理不是装饰性输入。
2. 任务边界
输入:
目标 CAD 点云 P P P
RGB crop K K K
由 depth crop 反投影的场景点云 Q Q Q
相机内参和对象定位结果。
输出是 CAD 到相机坐标系的绝对变换 T = [ R ∣ t ] ∈ S E ( 3 ) T=[R|t]\in SE(3) T = [ R ∣ t ] ∈ S E ( 3 )
训练使用 MegaPose 提供的 GSO synthetic set:
850 个对象、约 800k rendered images 用于训练;
94 个不重叠对象、约 200k images 用于验证。
测试使用 LM-O、T-LESS、TUD-L、IC-BIN、YCB-V,所有模型均与训练对象不重叠。
3. Fuse–Describe–Match
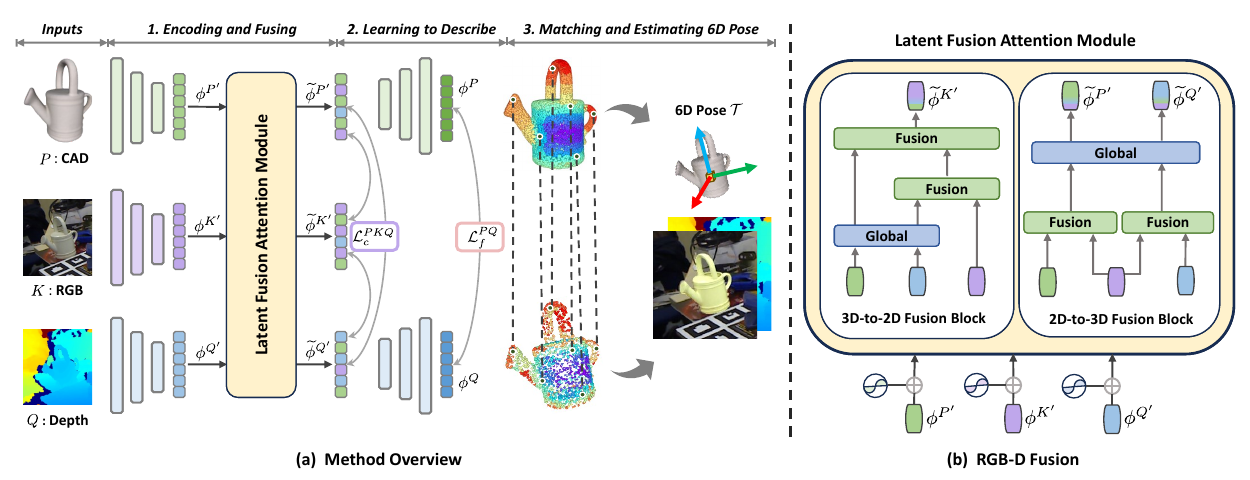
原论文 Figure 2。左侧是完整 Fuse–Describe–Match 流程,右侧展开 3D→2D 与 2D→3D latent fusion blocks。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
3.1 三路编码
CAD P P P Q Q Q
RGB K K K H / 8 × W / 8 H/8\times W/8 H /8 × W /8
3.2 Latent Fusion Attention
模块包含两个方向:
3D→2D:把 CAD / depth 几何信息注入 image feature;
2D→3D:把 image texture 注入 CAD / depth descriptors。
各 block 交替使用 latent fusion transformer 与 global transformer。关键点是 fusion 发生在 pose-agnostic latent space,而不是要求原始 CAD 点与图像 pixel 预先对齐;这使模型在尚未知 pose 时也能交换模态信息。
3.3 两级匹配监督
Bridged Coarse-level Matching loss L c P K Q \mathcal L_c^{PKQ} L c P K Q P P P Q Q Q L f P Q \mathcal L_f^{PQ} L f P Q
“bridged”的意义是:颜色不是在末端简单拼接,而是参与决定哪些旋转不变几何特征应当可区分。
4. 从描述子到 pose
推理时,MatchU 对 CAD descriptors ϕ P \phi^P ϕ P ϕ Q \phi^Q ϕ Q κ = 128 \kappa=128 κ = 128 s = 64 s=64 s = 64
单假设 Fast 模式用 RANSAC 从对应中直接求 T T T
3D verification:变换后 CAD 与 lifted depth 的点到点距离;
RGB verification:把 hypothesis render 到图像后评估外观一致性。
最终取平均分最高者。可选 ICP 再使用 depth 细化。因此论文声称的“without expensive rendering”主要描述 descriptor matching 路线;Accurate verification 仍包含 render-based scoring,ICP 版本也不再是纯单次匹配。
5. BOP 主结果与协议拆分
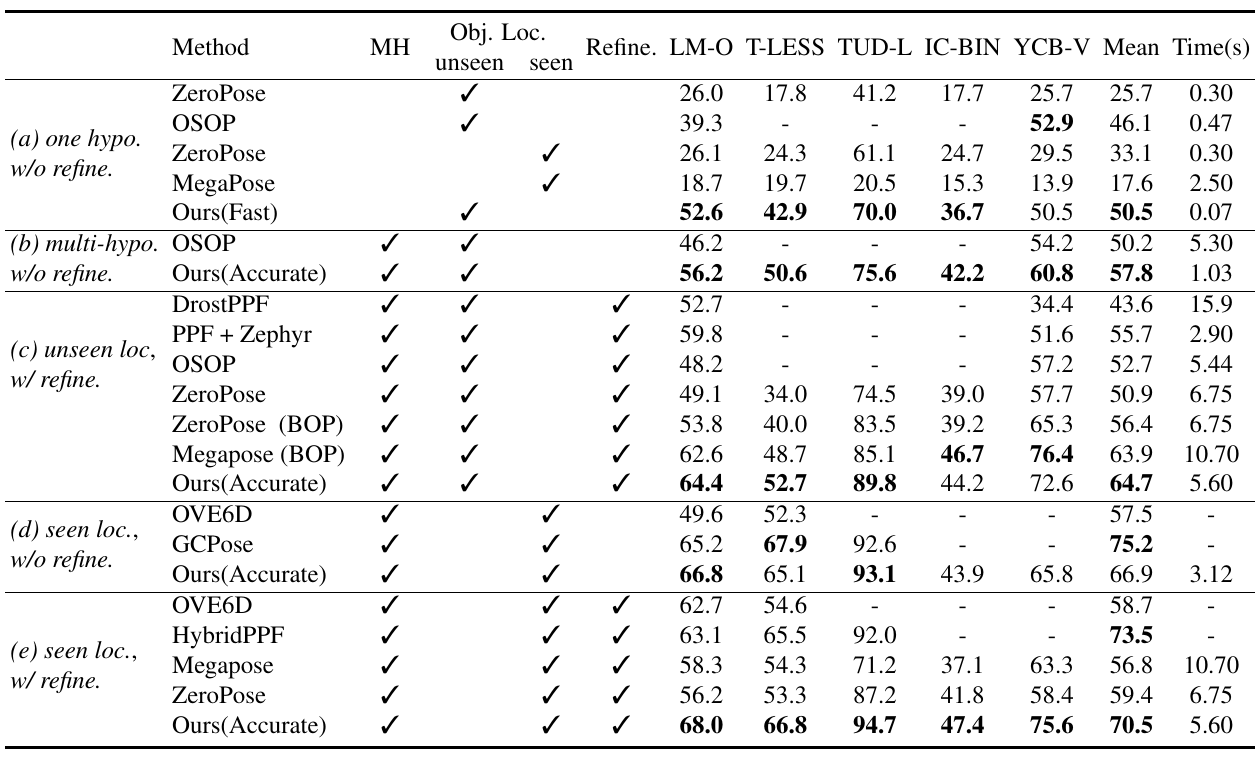
原论文 Table 1。MH、Obj. Loc. unseen / seen、Refine 三列共同定义比较协议;只有同一分组内才是公平横比。来源:CVPR 2024 正式论文 ;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
设定 LM-O T-LESS TUD-L IC-BIN YCB-V Mean 时间 Fast,1 hypothesis,无 refine,unseen locator 52.6 42.9 70.0 36.7 50.5 50.5 0.07 s Accurate,20 hypotheses,无 refine,unseen locator 56.2 50.6 75.6 42.2 60.8 57.8 1.03 s Accurate,unseen locator + ICP 64.4 52.7 89.8 44.2 72.6 64.7 5.60 s Accurate,seen locator + ICP 68.0 66.8 94.7 47.4 75.6 70.5 5.60 s
解读:
1→20 hypotheses 带来 7.3 AR,但耗时约增 15 倍;准确率与实时性的主要旋钮就是 hypothesis count。
ICP 让 unseen-locator 57.8→64.7,说明 descriptor matching 的初始 pose 尚有大量可由 depth alignment 修正的残差。
locator 从 unseen 换成 seen,再加 ICP,可达 70.5;这不是 MatchU descriptor 单独带来的提升。
IC-BIN 始终是弱项,完整 unseen setting 仅 44.2,反映少物体、遮挡与局部几何退化的组合难度。
6. 对称、纹理与 ADD
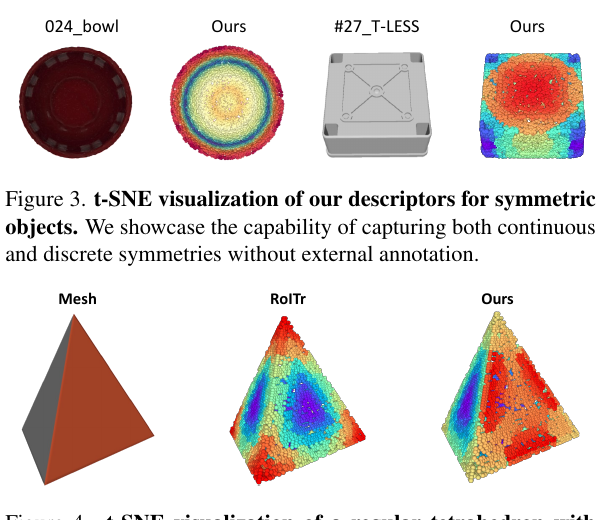
原论文 Figure 3–4:旋转不变 descriptors 能形成连续 / 离散对称结构;在四面体几何相同但一面带颜色时,MatchU 又能利用 RGB 将该面区分出来。来源:CVPR 2024 正式论文 ;图片版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
这里有一条容易被忽略的设计逻辑:descriptor 并不是“越 rotation-invariant 越好”。对完全无纹理的对称面,等价 descriptor 是正确归纳偏置;对几何对称但纹理不对称的面,仍输出相同 descriptor 就会丢掉有效信息。MatchU 试图让网络依输入内容决定何时保持对称、何时用颜色破除对称。
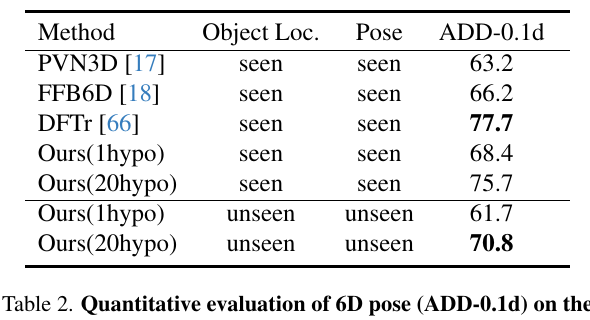
原论文 Table 2:即便训练未见测试对象,MatchU 的 1 / 20 hypotheses ADD-0.1d 为 61.7 / 70.8;后者接近 seen-object DFTr 的 77.7。来源:CVPR 2024 正式论文 ;表格版权归论文作者及 IEEE/CVF 所有,本站仅作论文解读展示。
LM-O 上:
unseen object / unseen locator:1 hypothesis 61.7,20 hypotheses 70.8 ;
seen object / seen locator:1 hypothesis 68.4,20 hypotheses 75.7;
DFTr seen-object baseline:77.7。
20 hypotheses 将 unseen 与 seen 的差距压到 4.9 points,但协议仍包含 CAD、RGB-D 和对象 crop,不能解释为完全开放世界零样本。
7. 消融与因果证据
论文 BOP-5 消融:
版本 Mean AR 无 BCM loss 48.1 无 RGB input 39.6 RoITr + RGB initialization 42.6 完整 Fast 50.5
最强证据是去掉 RGB 的 -10.9 AR:纯 rotation-invariant geometry 在测试对象上确有严重歧义。仅把 RGB 用于初始化 RoITr 只能恢复到 42.6,说明收益来自跨模态共同学习 descriptor,而不是额外颜色通道本身。
hypothesis 数量从 1 增到 20 时 AR 52.6→56.2,100 时约 58.2,继续增加几乎饱和。correspondence samples 增多会提高 hypothesis recall,但最终 AR 不同步线性增长;错误对应的质量比数量更重要。
8. 与相邻路线的关系
对 MegaPose / GenFlow:这些方法通过 render-and-compare 在 pose space 搜索或细化;MatchU 先在 descriptor correspondence space 求 pose,Accurate 模式再用 render verification。
对 GigaPose:二者都支持新 CAD;GigaPose 是 RGB 模板检索 + 单 patch correspondence,MatchU 依赖 depth 并做 3D–3D matching。
对 HiPose:HiPose 是 seen-object、object-specific binary surface code;MatchU 的 descriptor 训练跨对象共享,目标是 unseen CAD。
对 Oryon:Oryon 是无 CAD、文本指定的双场景相对 pose;MatchU 用 CAD + 单场景输出 absolute pose。
9. 局限与复现检查
必须有 metric CAD、可靠 depth 与 camera intrinsics;
完整 pipeline 依赖 object localization,unseen locator 的误差不能被 descriptor 完全吸收;
Fast 只是一条速度档位,不能把 0.07 s 与 64.7 AR 同时作为同一配置;
多 hypothesis 的 RGB verification 需要 renderer;ICP 额外引入深度噪声敏感性;
训练依赖约 1M GSO renders,规模化成本被移到通用预训练;
对连续对称对象,BOP symmetry-aware metric 与 ADD-0.1d 的含义不同;
复现时应固定 κ = 128 \kappa=128 κ = 128 s = 64 s=64 s = 64
必须分别报告 descriptor-only、multi-hypothesis 和 ICP 三档时间。
10. 最终评价
MatchU 最有价值的结论是:unseen-object 3D descriptor 不应只追求几何不变性,还要允许观测纹理在需要时打破几何等价类。 50.5→39.6 的 RGB 消融、单假设 0.07 s 与多假设 57.8 AR 的速度—精度曲线,都支持这一判断。
它不是无模型的通用 pose foundation model;CAD、depth、locator 与合成预训练仍是明确依赖。但在“给定新 CAD,怎样避免逐对象重训并快速得到可靠 RGB-D pose”这一工程问题上,MatchU 给出了结构清楚、可分档部署、并有较完整消融支撑的答案。